
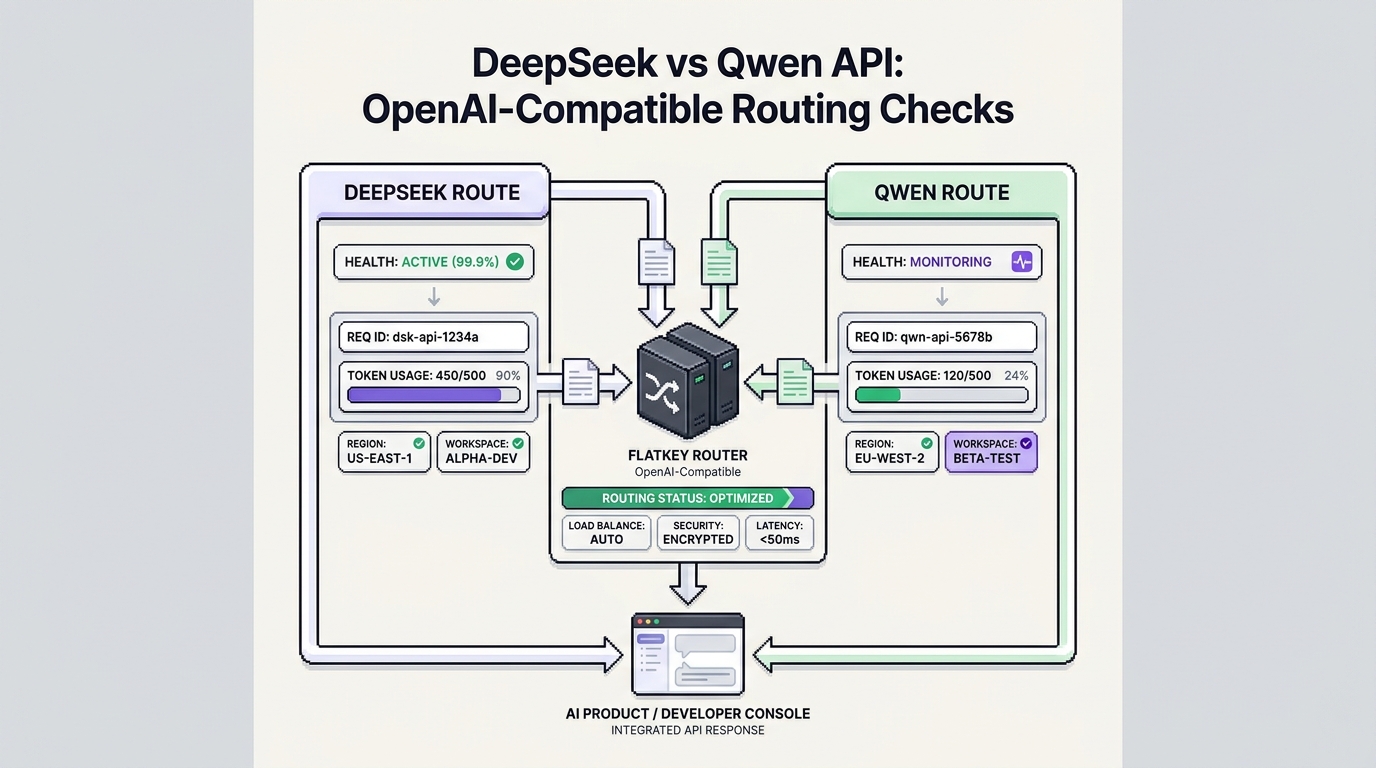
A questão DeepSeek vs Qwen API: Verificações de roteamento compatíveis com OpenAI não é apenas uma comparação de modelos. Para uma equipe de produção, é uma questão de prontidão de rota: qual família de endpoint seu cliente chama, qual conta possui a chave, qual ID de modelo está atual, quais recursos se comportam como seu analisador espera e onde você pode inspecionar o uso depois que o tráfego mudar.
Esse enquadramento importa porque ambos os provedores podem parecer familiares na camada do SDK. A DeepSeek documenta uma superfície de API compatível com OpenAI com https://api.deepseek.com como a URL base no formato OpenAI. O Alibaba Cloud Model Studio documenta acesso Qwen compatível com OpenAI, mas sua URL base pode depender da região e do workspace. Se você usar Flatkey, sua aplicação pode manter a estrutura do SDK OpenAI e apontar para https://router.flatkey.ai/v1, mas ainda assim você precisa verificar a rota exata do DeepSeek ou do Qwen antes de chamá-la de pronta para produção.
Use este guia DeepSeek vs Qwen API: Verificações de roteamento compatíveis com OpenAI como uma lista de verificação prática antes de alternar cargas de trabalho, adicionar fallback ou padronizar um gateway compartilhado.
Resposta rápida: verificações de roteamento da DeepSeek vs Qwen API
| Escolha de rota | Prefira quando | Verifique antes do lançamento |
|---|---|---|
| API DeepSeek direta | Você precisa do comportamento nativo da DeepSeek, dos IDs de modelo atuais da DeepSeek e de um endpoint focado e compatível com OpenAI. | URL base, ID do modelo, ciclo de vida do alias, saída JSON, chamadas de ferramenta, streaming, suporte a visão, comprimento de contexto, concorrência, tratamento de 429 e unidades de preço. |
| API Qwen direta via Model Studio | Você já opera dentro do Alibaba Cloud, precisa das famílias de modelos Qwen ou deve controlar diretamente a configuração de região e workspace. | Endpoint da região, domínio específico do workspace, chave de API vinculada à região, família Qwen selecionada, compatibilidade com ferramenta/streaming, níveis de token, regras de cache e erros de autenticação. |
| Rota do gateway Flatkey | Você quer uma chave, uma URL base compatível com OpenAI, revisão de uso compartilhada e roteamento mais simples em várias famílias de modelos. | Linha de modelo atual do Flatkey, família de endpoint, integridade da rota, log da solicitação, campos de token/custo, passagem de recursos, política de fallback e rota de reversão. |
A resposta prática para DeepSeek vs Qwen API: Verificações de roteamento compatíveis com OpenAI é muitas vezes híbrida. Use rotas diretas do provedor quando precisar de controles específicos do provedor que ainda não comprovou por meio de um gateway. Use Flatkey quando o problema operacional maior for chaves de provedores espalhadas, faturamento fragmentado e mudanças repetidas de SDK entre equipes ou agentes.
Fatos do provedor a verificar primeiro
Comece toda revisão de DeepSeek vs Qwen API: Verificações de roteamento compatíveis com OpenAI com a documentação atual do provedor, e não com uma lista antiga de modelos.
A DeepSeek atualmente documenta que sua API usa um formato compatível com OpenAI e Anthropic. Sua documentação da primeira chamada lista https://api.deepseek.com para chamadas no formato OpenAI e https://api.deepseek.com/anthropic para chamadas no formato Anthropic. Sua atual tabela de modelos e preços lista deepseek-flash e deepseek-v4-pro como as linhas ativas, com versões de modelo, suporte a recursos, comprimento de contexto, saída máxima e limites de concorrência na mesma página.
A nota de ciclo de vida da DeepSeek é importante: nomes legados como deepseek-v4-flash e deepseek-v4-flash-vision-exp ainda são aceitos, mas a DeepSeek diz que esses nomes descontinuados são atendidos pelo novo modelo Flash e cobrados com o preço do Flash. Se o seu código, política de gateway ou planilha de avaliação ainda usa um alias antigo, atualize a verificação de roteamento antes de comparar os resultados.
O Qwen via Alibaba Cloud Model Studio parte de um contrato diferente. O Model Studio diz que os modelos Qwen suportam interfaces compatíveis com OpenAI e que o código OpenAI existente pode ser migrado alterando a chave de API, a URL base e o nome do modelo. Mas a mesma documentação vincula a URL base à região e, para várias regiões, a um domínio específico do workspace. Ela também diz que uma chave de API do Model Studio fica vinculada à região em que foi criada; chamar o endpoint de outra região com essa chave pode retornar um erro de autenticação HTTP 401.
Essa é a diferença central. Com a DeepSeek, a primeira pergunta geralmente é "qual ID de modelo DeepSeek atual e qual modo de recurso?" Com o Qwen, a primeira pergunta costuma ser "qual região, domínio do workspace, chave de API e família de modelo?"
Compatível com OpenAI não significa idêntico
A expressão "OpenAI-compatible" é um acelerador de migração. Não é uma promessa de que todo endpoint, campo, stream, erro ou caso extremo de chamada de ferramenta se comporte de forma idêntica.
| Verificação | Rota direta DeepSeek | Rota direta Qwen | Rota Flatkey |
|---|---|---|---|
| Base URL | A base URL no formato OpenAI é https://api.deepseek.com. |
A base URL no modo compatível varia por região e pode incluir {WorkspaceId}. |
A base URL compatível com OpenAI é https://router.flatkey.ai/v1. |
| Endpoint de chat | Exemplos diretos de cURL usam /chat/completions. |
Exemplos no modo compatível usam /chat/completions. |
O tráfego compatível com OpenAI usa /v1/chat/completions. |
| IDs de modelo | A documentação atual se concentra em deepseek-flash e deepseek-v4-pro; nomes legados do Flash são aceitos, mas mapeados adiante. |
A documentação atual mostra linhas do Qwen como qwen3.8-max, qwen3.7-plus e qwen3.8-flash, com comportamento específico da família. |
Use o ID de modelo exato visível no diretório de modelos da Flatkey ou na rota da conta. |
| Streaming | Teste chunks em streaming, esperas ociosas, cancelamento e tratamento final de uso. | Exemplos do Model Studio mostram stream=True e stream_options={"include_usage": True}. |
Confirme se o parser do seu SDK lida com chunks e uso final através do gateway. |
| Chamadas de ferramenta | DeepSeek documenta chamadas de ferramenta como um recurso suportado para as linhas atuais. | O Model Studio documenta function calling, mas também observa que tools não pode ser usado simultaneamente com stream=True na seção de parâmetros compatíveis com OpenAI. |
Execute um teste real de chamada de ferramenta antes de um agente depender da rota. |
| Saída JSON | DeepSeek lista suporte a saída JSON para as linhas atuais. | Os parâmetros compatíveis com Qwen incluem formatação de resposta e notas de suporte específicas do modelo. | Teste o parsing de schema, o comportamento de JSON inválido e o fallback. |
| Visão/áudio | A tabela da DeepSeek marca suporte a visão para deepseek-flash e não para deepseek-v4-pro. |
O Model Studio lista Qwen-VL e Qwen-Omni como famílias de modelos suportadas, mas diz que Qwen-Audio não suporta o protocolo compatível com OpenAI e deve usar DashScope. | Não assuma paridade multimodal a partir de um teste de chat de texto. |
| Capacidade/erros | A DeepSeek documenta concorrência no nível da conta e HTTP 429 quando o limite é excedido. | Incompatibilidades de região/chave no Qwen podem retornar HTTP 401; cotas e limites de taxa devem ser testados por região/conta. | Registre classe do provedor, código de status, retry, motivo do fallback, latência, tokens e custo. |
Esta é a regra central de DeepSeek vs Qwen API: Verificações de roteamento compatíveis com OpenAI: prove a rota que você realmente vai executar, e não a que é implícita pelo nome do provedor.
Verificações de preço antes de comparar rotas
Uma rota pode ser compatível e ainda assim estar financeiramente errada para a carga de trabalho. Não compare DeepSeek vs Qwen API: Verificações de roteamento compatíveis com OpenAI com um único destaque de tokens de entrada.
A documentação atual de preços da DeepSeek cobra em unidades de um milhão de tokens e separa tokens de entrada com cache hit, tokens de entrada com cache miss e tokens de saída. Também distingue tarifas de pico e fora de pico e coloca limites de concorrência ao lado das linhas dos modelos. Sua documentação de limite de taxa diz que a concorrência é calculada no nível da conta e que o excesso de concorrência retorna HTTP 429. Isso torna a revisão de custos da DeepSeek simples apenas se seus logs separarem entrada, saída, comportamento de cache, duração da solicitação e taxa de 429.
O Model Studio diz que as chamadas à API de modelos são pagas conforme o uso por padrão e que seu documento de preços lista preços padrão, com promoções tratadas separadamente no console. Também afirma que alguns modelos usam preços em camadas com base no número total de tokens de entrada em uma única solicitação, e que o cache de contexto e os descontos em lote têm regras separadas. Isso significa que uma solicitação curta de chat, uma solicitação de recuperação de 100 mil tokens, uma solicitação repetida com contexto em cache e um job em lote podem pertencer a diferentes faixas de custo do Qwen.
Use esta tabela de normalização de custos antes de promover uma rota:
| Campo de custo | Por que isso muda a decisão | O que registrar |
|---|---|---|
| Tokens de entrada | Os níveis do Qwen e os tokens de entrada com cache miss da DeepSeek podem alterar o custo efetivo. | Tokens do prompt, nível de entrada, tokens de cache miss, ID do modelo. |
| Tokens em cache | Os descontos de cache só ajudam quando a carga de trabalho repete um contexto estável e a rota expõe evidências. | Tokens de cache hit, tokens de gravação de cache, política de cache, família da solicitação. |
| Tokens de saída | Respostas longas e saídas de raciocínio/thinking podem dominar a conta. | Tokens de conclusão, tokens de raciocínio/thinking se retornados, limite de saída. |
| Estado de pico/fora de pico ou promoção | Páginas públicas dos provedores podem separar preços padrão de promoções com base no horário ou no console. | Horário de cobrança, data da fonte do preço, proprietário da rota. |
| Custo de retry/fallback | Tentativas falhas e tentativas de fallback podem apagar a economia aparente de tokens. | Número de tentativas, motivo da retry, modelo de fallback, sinalizador de resposta aceita. |
Para a Flatkey, mantenha a mesma disciplina: verifique o diretório de modelos e a página de preços atuais e, em seguida, valide o uso no nível da solicitação nos logs. A menção pública de um modelo é útil para descoberta. Uma decisão de produção precisa de um teste de rota bem-sucedido e de um registro legível.
Lista de verificação da rota Flatkey
A Flatkey altera o fluxo operacional em torno de DeepSeek vs Qwen API: Verificações de roteamento compatíveis com OpenAI. Ela pode permitir que as equipes mantenham uma única superfície de cliente compatível com OpenAI, uma única chave Flatkey e uma única camada de revisão de uso entre modelos e ferramentas suportados. O quickstart da Flatkey mostra o caminho de solicitação compatível com OpenAI, e o guia do OpenAI SDK mostra a configuração do base_url. A Flatkey não deve ocultar requisitos específicos do provedor.
Use esta sequência antes que uma rota da Flatkey receba tráfego de produção:
- Abra o diretório atual do modelo Flatkey e pesquise o ID exato do modelo DeepSeek ou Qwen.
- Confirme que a família de endpoint é apropriada para a carga de trabalho, normalmente chat compatível com OpenAI para este artigo.
- Confirme que o modelo aparece na rota da conta atual, e não apenas em um artigo antigo ou captura de tela.
- Envie uma solicitação de chat simples por meio de
https://router.flatkey.ai/v1/chat/completions. - Envie a mesma solicitação simples pela rota direta do provedor quando você tiver credenciais diretas.
- Repita com streaming, uma chamada de ferramenta, um teste de saída JSON, uma amostra de contexto longo e um erro forçado.
- Salve o ID da solicitação, a classe do provedor, o ID do modelo, o código de status, a latência, os campos de uso, os campos de custo, o motivo do fallback, o proprietário da chave e o modelo de rollback.
Aqui está o teste mínimo de smoke do Flatkey:
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-verified-deepseek-or-qwen-model-id",
    "messages": [
      {
        "role": "user",
        "content": "Return one sentence confirming this route is alive."
      }
    ]
  }'
Se essa solicitação falhar com model-not-found, endpoint não suportado, HTTP 401, HTTP 429, timeout ou falha do parser, o teste ainda assim ajudou. Ele mostra que a conta, o ID do modelo, a família de endpoint, o escopo da chave, a cota ou a forma da solicitação precisam de correção antes que o tráfego real avance.
Verificações da rota DeepSeek
Use esta lista de verificação quando DeepSeek for a rota candidata:
| Check | Pass condition |
|---|---|
| Current model ID | The route uses deepseek-flash or deepseek-v4-pro, or the team has explicitly accepted DeepSeek's legacy-name mapping behavior. |
| Endpoint family | The app calls the intended DeepSeek endpoint family: OpenAI-format or Anthropic-format. |
| Feature support | JSON output, tool calls, Responses API, Anthropic API, beta prefix completion, FIM, and vision are tested only where the workload uses them. |
| Thinking/non-thinking behavior | The selected mode is explicit enough for evaluation and logging. |
| Concurrency | Account-level concurrency and per-user isolation behavior are understood; 429 handling is tested. |
| Long request behavior | Timeout, streaming, keep-alive, and max-output behavior are tested with real workload sizes. |
| Usage and cost | Input, output, cache hit/miss, peak/off-peak state, retries, and accepted response are logged. |
DeepSeek é o caminho mais limpo de provedor direto quando seu produto deseja o comportamento nativo do DeepSeek e as verificações de rota acima passam. Ele não é automaticamente mais seguro só porque a URL base é simples.
Verificações da rota Qwen
Use esta lista de verificação quando Qwen via Model Studio for a rota candidata:
| Verificação | Condição de aprovação |
|---|---|
| Região | A região permitida da carga de trabalho corresponde ao endpoint do Model Studio que você chama. |
| Domínio do workspace | {WorkspaceId} é substituído pelo ID real do workspace quando necessário, e domínios antigos/globais não são mantidos cegamente. |
| Localidade da chave de API | A chave de API foi criada na mesma região do endpoint; falhas por incompatibilidade de região são classificadas separadamente das falhas por chave inválida. |
| Família de modelo | A família de modelo Qwen selecionada suporta a forma da requisição, o comprimento de contexto e o modo de saída usados pelo seu aplicativo. |
| Comportamento de ferramentas e streaming | Chamadas de função e streaming são testados separadamente, especialmente porque a documentação do Model Studio observa que tools não pode ser usado simultaneamente com stream=True. |
| Protocolo multimodal | Qwen-VL, Qwen-Omni e Qwen-Audio são verificados por protocolo; Qwen-Audio não é tratado como uma rota de chat compatível com OpenAI. |
| Unidade de preço | Faixa de tokens de entrada, tokens de saída, cache de contexto, elegibilidade para desconto em lote e estado da promoção são registrados. |
Qwen costuma ser a rota direta mais forte quando a equipe já opera na Alibaba Cloud ou precisa do modelo de região/conta do Model Studio. Ele exige mais prova de configuração porque região, workspace e escopo da chave fazem parte do contrato da API.
Matriz de decisão
Use esta matriz quando um stakeholder pedir um vencedor.
| Área de decisão | Prefira a API DeepSeek | Prefira a API Qwen | Prefira Flatkey |
|---|---|---|---|
| Configuração direta | Você quer uma conta DeepSeek focada e a família de modelos atual da DeepSeek. | Você já usa o Alibaba Cloud Model Studio. | Você quer uma única base URL compatível com OpenAI para várias famílias de modelos. |
| Controle regional | Os controles diretos da conta DeepSeek são suficientes para a carga de trabalho. | Região, workspace e propriedade regional da chave de API importam. | Você quer política em nível de gateway, logs e propriedade compartilhada pela equipe. |
| Comportamento de ferramentas/JSON | As chamadas de ferramenta e a saída em JSON da DeepSeek passam nos testes do seu parser. | A chamada de função e a saída estruturada do Qwen passam nos testes do seu parser. | Os mesmos testes passam pela rota exata do Flatkey. |
| Roteamento multimodal | Você só precisa dos recursos da DeepSeek suportados pela linha selecionada. | Você precisa de Qwen-VL, Qwen-Omni ou outra família do Model Studio e verificou o protocolo dela. | Você quer comparar rotas de texto, imagem, vídeo ou ferramentas em uma única camada operacional. |
| Capacidade | A concorrência no nível da conta DeepSeek se encaixa na carga de trabalho. | As cotas do Model Studio e a saúde regional se encaixam na carga de trabalho. | Você quer uma política observável de retry/fallback entre provedores. |
| Revisão financeira | Os units de cache/pico/saída da DeepSeek são fáceis de modelar para a carga de trabalho. | Os níveis, cache, lote e preços do console do Qwen se encaixam na carga de trabalho. | O financeiro precisa de uma visão única de uso e de um único histórico de cobrança/recarregamento entre rotas. |
Não existe um vencedor universal de DeepSeek vs Qwen API: Verificações de roteamento compatíveis com OpenAI. Há uma rota que se adequa à carga de trabalho, à região, ao parser, ao modelo de custos e ao contrato operacional.
Plano de migração para equipes que já estão em produção
Mova-se em etapas para que a qualidade do modelo e a prontidão da rota permaneçam separadas.
- Estabeleça a linha de base da rota atual: salve IDs de modelo, prompts, expectativas do parser, latência, uso de tokens, classes de erro, custo e responsável.
- Reabra a documentação atual: verifique as páginas de modelo/preços, primeira chamada, recursos e limite de taxa da DeepSeek; verifique as páginas compatível com OpenAI, de modelo, preços e recursos da Qwen.
- Execute testes com provedor direto: use os mesmos prompts e parsers com a DeepSeek direta e a Qwen direta, se você tiver credenciais.
- Execute testes Flatkey após a consulta da rota: confirme que o modelo exato aparece na Flatkey e, então, teste por meio de
https://router.flatkey.ai/v1. - Compare o comportamento, não apenas as respostas: revise chunks, JSON de tool-call, validade da saída em JSON, erros de contexto, comportamento de 401/429, comportamento de timeout e campos de usage.
- Mova primeiro o tráfego de baixo risco: comece com ferramentas internas, jobs de avaliação, resumos em lote ou uma pequena fatia não crítica do produto.
- Promova após a leitura de retorno: não considere a migração concluída até que produto, plataforma e finanças possam inspecionar as mesmas evidências da rota.
Este plano em etapas evita um erro comum: declarar um modelo vencedor enquanto a própria rota ainda não foi comprovada.
Erros comuns
| Erro | Por que prejudica | Melhor verificação |
|---|---|---|
| Usar aliases antigos da DeepSeek sem verificar a data | O mapeamento de aliases pode ocultar mudanças de comportamento e confundir revisões de custo. | Verifique os nomes atuais dos modelos e o comportamento dos nomes legados antes da migração. |
| Tratar todos os endpoints da Qwen como um único endpoint | Região, domínio do workspace e localidade da API key podem determinar se a chamada funciona. | Registre a região do endpoint, o ID do workspace e a região da chave. |
| Comparar um único preço por token | cache hit, cache miss, comprimento da saída, modo de raciocínio, camadas de entrada, retries e promoções alteram o custo real. | Revise o custo por resposta aceita por carga de trabalho. |
| Assumir paridade de ferramentas | O formato do tool-call e o comportamento de streaming podem diferir por provedor e modelo. | Teste uma chamada real de ferramenta e uma execução com streaming por cada rota. |
| Publicar uma rota de gateway a partir de uma menção no catálogo | A descoberta pública do catálogo não é o mesmo que a prontidão da rota em nível de conta. | Execute um teste de rota ao vivo na Flatkey e salve a evidência da solicitação. |
Recomendação final
Para DeepSeek vs Qwen API: Verificações de roteamento compatíveis com OpenAI, comece com a verdade do provedor e termine com a evidência da rota.
Use a DeepSeek direta quando sua carga de trabalho se encaixar na família de modelos atual da DeepSeek, no endpoint compatível com OpenAI, no conjunto de recursos, nas unidades de preço e no comportamento de concorrência. Use a Qwen direta quando você precisar das famílias Qwen do Model Studio, endpoints regionais, domínios de workspace ou controles de conta da Alibaba Cloud. Use a Flatkey quando o problema maior for uma única chave, uma única URL base compatível com OpenAI, evidências de uso compartilhadas, revisão de quotas e faturamento unificado entre modelos.
O próximo passo não é um slogan. Verifique a documentação atual do provedor, confira o diretório de modelos e a página de preços da Flatkey, execute os testes de smoke acima e, então, obtenha uma chave da Flatkey quando estiver pronto para verificar um fluxo de DeepSeek vs Qwen API: Verificações de roteamento compatíveis com OpenAI por meio de um único gateway. Para trabalhos adjacentes de rollout, combine esta lista de verificação com o quickstart da API da Flatkey, o fluxo de trabalho de API unificada de IA, o guia de migração para alternativa da API da OpenAI, o roteamento regional de provedores de LLM e as métricas da API de roteamento de IA.
FAQ
DeepSeek vs Qwen API é apenas uma decisão de qualidade do modelo?
Não. DeepSeek vs Qwen API: Verificações de roteamento compatíveis com OpenAI também incluem formato do endpoint, aliases de modelo, região, workspace, localidade da chave de API, camadas de tokens, comportamento de cache, chamadas de ferramenta, saída JSON, comportamento do parser de streaming, limites de taxa, logs e evidências de faturamento.
Qual API é mais barata, DeepSeek ou Qwen?
Depende do modelo exato, comprimento do prompt, comprimento da saída, comportamento de cache, camada de tokens, modo de raciocínio, retries, rota e momento do faturamento. Use as páginas oficiais de preços atuais e seus logs reais de uso, em vez de copiar um vencedor estático.
Posso usar um SDK da OpenAI com ambos os provedores?
Sim. DeepSeek e Model Studio documentam o uso compatível com OpenAI, mas a URL base, os nomes dos modelos, os parâmetros extras, as ressalvas de recursos e a configuração da conta diferem. A Flatkey também suporta o padrão de SDK da OpenAI por meio de https://router.flatkey.ai/v1 para modelos compatíveis.
O roteamento compatível com OpenAI do Qwen suporta todas as famílias de modelos Qwen?
Não. A Alibaba Cloud Model Studio diz que os modelos compatíveis com OpenAI incluem os grandes modelos de linguagem Qwen, Qwen-VL, Qwen-Coder, Qwen-Omni, Qwen-Math, DeepSeek, Kimi, GLM e MiniMax, mas afirma separadamente que o Qwen-Audio não suporta o protocolo compatível com OpenAI e deve usar o DashScope em vez disso.
Qual é o primeiro teste da Flatkey para o roteamento DeepSeek vs Qwen API?
Comece com uma conclusão de chat simples por meio de https://router.flatkey.ai/v1 e, em seguida, verifique o ID do modelo, o status, os campos de uso, a unidade de preço, o streaming, as chamadas de ferramenta, a saída JSON, o comportamento de erro, o fallback e o caminho de rollback.


