
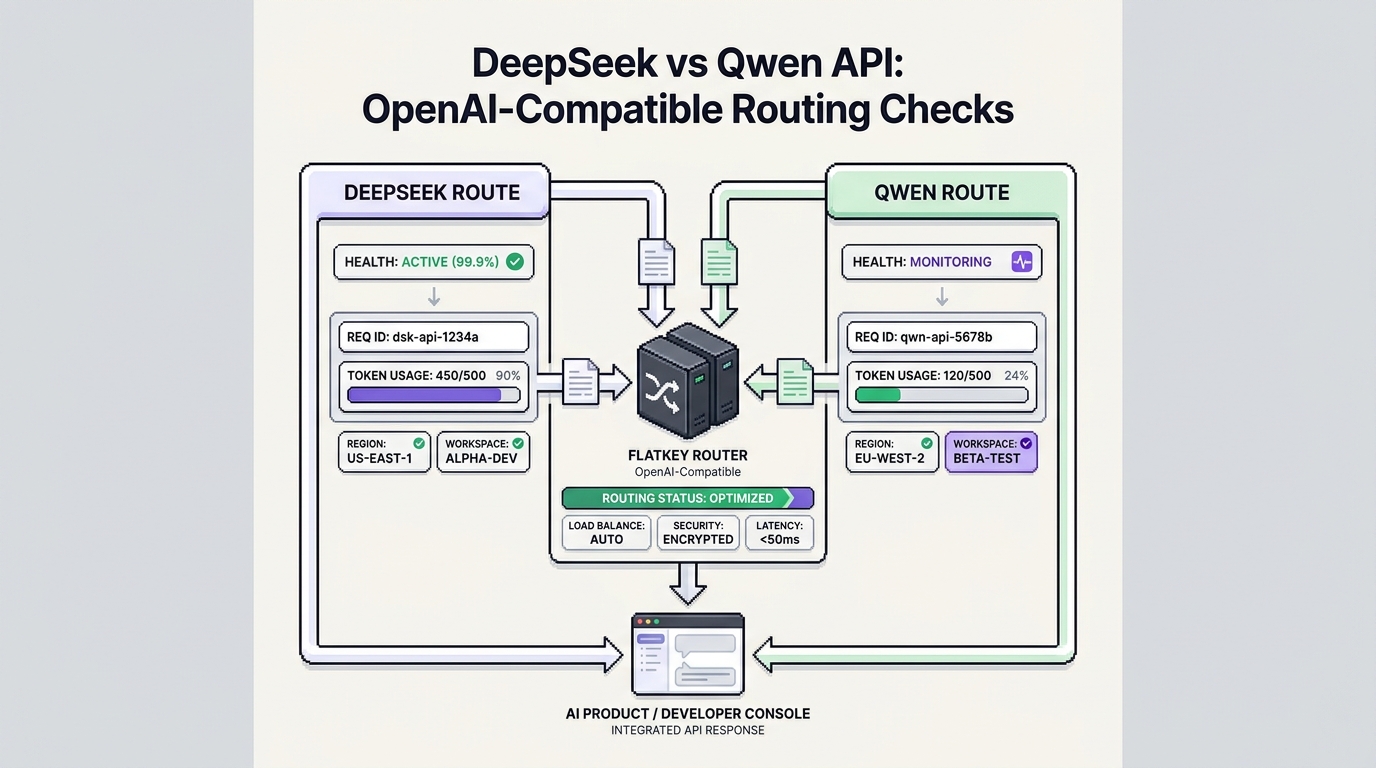
La pregunta DeepSeek vs Qwen API: comprobaciones de enrutamiento compatibles con OpenAI no es solo una comparación de modelos. Para un equipo de producción, es una pregunta de preparación de rutas: qué familia de endpoint llama su cliente, qué cuenta es propietaria de la clave, qué ID de modelo es el actual, qué funciones se comportan como espera su analizador y dónde puede inspeccionar el uso después de que el tráfico se mueva.
Ese encuadre importa porque ambos proveedores pueden parecer familiares a nivel de SDK. DeepSeek documenta una superficie de API compatible con OpenAI con https://api.deepseek.com como URL base en formato OpenAI. Alibaba Cloud Model Studio documenta el acceso a Qwen compatible con OpenAI, pero su URL base puede depender de la región y del espacio de trabajo. Si usa Flatkey, su aplicación puede mantener la forma del SDK de OpenAI y apuntar a https://router.flatkey.ai/v1, pero aun así necesita verificar la ruta exacta de DeepSeek o Qwen antes de considerarla lista para producción.
Use esta guía DeepSeek vs Qwen API: comprobaciones de enrutamiento compatibles con OpenAI como una lista de verificación práctica antes de cambiar cargas de trabajo, añadir fallback o estandarizar una pasarela compartida.
Respuesta rápida: comprobaciones de enrutamiento de la API DeepSeek vs Qwen
| Elección de ruta | Prefiérala cuando | Verificar antes del lanzamiento |
|---|---|---|
| API de DeepSeek directa | Necesita el comportamiento nativo de DeepSeek, los ID de modelo actuales de DeepSeek y un endpoint enfocado compatible con OpenAI. | URL base, ID de modelo, ciclo de vida del alias, salida JSON, llamadas a herramientas, streaming, soporte de visión, longitud de contexto, concurrencia, manejo de 429 y unidades de precios. |
| API de Qwen directa a través de Model Studio | Ya opera dentro de Alibaba Cloud, necesita familias de modelos Qwen o debe controlar directamente la configuración de región y espacio de trabajo. | Endpoint de región, dominio específico del espacio de trabajo, clave de API vinculada a la región, familia Qwen seleccionada, compatibilidad con herramientas/streaming, niveles de tokens, reglas de caché y errores de autenticación. |
| Ruta de pasarela Flatkey | Quiere una sola clave, una sola URL base compatible con OpenAI, revisión compartida del uso y un enrutamiento más simple entre múltiples familias de modelos. | Fila actual del modelo en Flatkey, familia del endpoint, estado de salud de la ruta, registro de solicitudes, campos de tokens/coste, paso de características, política de fallback y ruta de reversión. |
La respuesta práctica a DeepSeek vs Qwen API: comprobaciones de enrutamiento compatibles con OpenAI suele ser híbrida. Use rutas directas del proveedor cuando necesite controles específicos del proveedor que no haya probado a través de una pasarela. Use Flatkey cuando el problema operativo principal sean las claves dispersas de proveedores, la facturación fragmentada y los cambios repetidos del SDK entre equipos o agentes.
Datos del proveedor que comprobar primero
Comience cada revisión de DeepSeek vs Qwen API: comprobaciones de enrutamiento compatibles con OpenAI con la documentación actual del proveedor, no con una lista antigua de modelos.
DeepSeek documenta actualmente que su API utiliza un formato compatible con OpenAI y Anthropic. Su documentación de la primera llamada enumera https://api.deepseek.com para llamadas en formato OpenAI y https://api.deepseek.com/anthropic para llamadas en formato Anthropic. Su actual tabla de modelos y precios enumera deepseek-flash y deepseek-v4-pro como las filas activas, con versiones de modelo, compatibilidad con funciones, longitud de contexto, salida máxima y límites de concurrencia en la misma página.
La nota sobre el ciclo de vida de DeepSeek es importante: nombres heredados como deepseek-v4-flash y deepseek-v4-flash-vision-exp aún se aceptan, pero DeepSeek dice que esos nombres retirados son atendidos por el nuevo modelo Flash y facturados al precio de Flash. Si tu código, política de gateway o hoja de evaluación aún usa un alias antiguo, actualiza la comprobación de ruta antes de comparar resultados.
Qwen a través de Alibaba Cloud Model Studio parte de un contrato diferente. Model Studio indica que los modelos Qwen admiten interfaces compatibles con OpenAI y que el código OpenAI existente puede migrarse cambiando la clave de API, la URL base y el nombre del modelo. Pero la misma documentación vincula la URL base a la región y, para varias regiones, a un dominio específico del espacio de trabajo. También indica que una clave de API de Model Studio está vinculada a la región en la que se creó; llamar al endpoint de otra región con esa clave puede devolver un error de autenticación HTTP 401.
Ahí radica la diferencia principal. Con DeepSeek, la primera pregunta suele ser "¿qué ID de modelo DeepSeek actual y qué modo de funciones?" Con Qwen, la primera pregunta suele ser "¿qué región, dominio del espacio de trabajo, clave de API y familia de modelos?"
Compatible con OpenAI no significa idéntico
La frase "compatible con OpenAI" es un acelerador de migración. No es una promesa de que todos los endpoints, campos, flujos, errores o casos límite de llamadas a herramientas se comporten de manera idéntica.
| Verificación | Ruta directa de DeepSeek | Ruta directa de Qwen | Ruta de Flatkey |
|---|---|---|---|
| URL base | La URL base con formato OpenAI es https://api.deepseek.com. |
La URL base en modo compatible varía según la región y puede incluir {WorkspaceId}. |
La URL base compatible con OpenAI es https://router.flatkey.ai/v1. |
| Endpoint de chat | Los ejemplos directos con cURL usan /chat/completions. |
Los ejemplos en modo compatible usan /chat/completions. |
El tráfico compatible con OpenAI usa /v1/chat/completions. |
| ID de modelos | La documentación actual se centra en deepseek-flash y deepseek-v4-pro; se aceptan los nombres heredados de Flash, pero se asignan hacia adelante. |
La documentación actual muestra filas de Qwen como qwen3.8-max, qwen3.7-plus y qwen3.8-flash, con comportamiento específico de la familia. |
Usa el ID exacto del modelo visible en el directorio de modelos de Flatkey o en la ruta de la cuenta. |
| Streaming | Prueba fragmentos en streaming, esperas inactivas, cancelación y el manejo final del uso. | Los ejemplos de Model Studio muestran stream=True y stream_options={"include_usage": True}. |
Confirma que el analizador de tu SDK maneja los fragmentos y el uso final a través del gateway. |
| Llamadas a herramientas | DeepSeek documenta las llamadas a herramientas como una función compatible para las filas actuales. | Model Studio documenta la llamada a funciones, pero también indica que tools no se puede usar simultáneamente con stream=True en la sección de parámetros compatible con OpenAI. |
Ejecuta una prueba real de llamada a herramientas antes de que un agente dependa de la ruta. |
| Salida JSON | DeepSeek enumera soporte de salida JSON para las filas actuales. | Los parámetros compatibles con Qwen incluyen formato de respuesta y notas de soporte específicas del modelo. | Prueba el análisis de esquemas, el comportamiento de JSON inválido y el fallback. |
| Visión/audio | La tabla de DeepSeek marca soporte de visión para deepseek-flash y no para deepseek-v4-pro. |
Model Studio enumera a Qwen-VL y Qwen-Omni como familias de modelos compatibles, pero dice que Qwen-Audio no admite el protocolo compatible con OpenAI y debe usar DashScope. | No asumas paridad multimodal a partir de una prueba de chat de texto. |
| Capacidad/errores | DeepSeek documenta concurrencia a nivel de cuenta y HTTP 429 cuando se supera. | Las discrepancias entre región y clave de Qwen pueden devolver HTTP 401; las cuotas y los límites de velocidad deben probarse por región/cuenta. | Registra la clase de proveedor, el código de estado, el reintento, el motivo del fallback, la latencia, los tokens y el costo. |
Esta es la regla central de DeepSeek vs Qwen API: comprobaciones de enrutamiento compatibles con OpenAI: demuestra la ruta que realmente vas a ejecutar, no la que sugiere el nombre del proveedor.
Comprobaciones de precios antes de comparar rutas
Una ruta puede ser compatible y aun así ser financieramente incorrecta para la carga de trabajo. No compares DeepSeek vs Qwen API: comprobaciones de enrutamiento compatibles con OpenAI con un solo titular de tokens de entrada.
La documentación actual de precios de DeepSeek factura en unidades de un millón de tokens y separa los tokens de entrada con acierto de caché, los tokens de entrada con fallo de caché y los tokens de salida. También distingue entre tarifas de hora punta y hora valle, y coloca los límites de concurrencia junto a las filas de los modelos. Su documentación de límites de velocidad indica que la concurrencia se calcula a nivel de cuenta y que el exceso de concurrencia devuelve HTTP 429. Eso hace que la revisión de costes de DeepSeek sea sencilla solo si tus registros separan la entrada, la salida, el comportamiento de caché, la duración de la solicitud y la tasa de 429.
Model Studio dice que las llamadas a la API de modelos se pagan por uso de forma predeterminada y que su documento de precios enumera los precios estándar, con las promociones gestionadas por separado en la consola. También indica que algunos modelos usan precios escalonados basados en el número total de tokens de entrada en una sola solicitud, y que la caché de contexto y los descuentos por lotes tienen reglas aparte. Eso significa que una solicitud de chat breve, una solicitud de recuperación de 100K tokens, una solicitud repetida de contexto en caché y un trabajo por lotes pueden pertenecer a distintos tramos de coste de Qwen.
Utiliza esta tabla de normalización de costes antes de promocionar una ruta:
| Campo de coste | Por qué cambia la decisión | Qué registrar |
|---|---|---|
| Tokens de entrada | Los tramos de Qwen y los tokens de entrada con fallo de caché de DeepSeek pueden cambiar el coste efectivo. | Tokens del prompt, tramo de entrada, tokens de fallo de caché, ID del modelo. |
| Tokens en caché | Los descuentos de caché solo ayudan cuando la carga de trabajo repite un contexto estable y la ruta expone evidencia. | Tokens con acierto de caché, tokens de escritura en caché, política de caché, familia de solicitud. |
| Tokens de salida | Las respuestas largas y las salidas de razonamiento/pensamiento pueden dominar la factura. | Tokens de finalización, tokens de razonamiento/pensamiento si se devuelven, límite de salida. |
| Estado de hora punta/hora valle o promoción | Las páginas públicas del proveedor pueden separar los precios estándar de las promociones basadas en el tiempo o de la consola. | Hora de facturación, fecha de la fuente de precios, propietario de la ruta. |
| Coste de reintento/respaldo | Los intentos fallidos y los intentos de respaldo pueden anular los ahorros aparentes de tokens. | Número de intentos, motivo del reintento, modelo de respaldo, indicador de respuesta aceptada. |
Para Flatkey, mantén la misma disciplina: revisa el directorio de modelos y la página de precios actuales, y luego verifica el uso a nivel de solicitud en los registros. La mención pública de un modelo es útil para el descubrimiento. Una decisión de producción necesita una prueba de ruta exitosa y un libro mayor legible.
Lista de verificación de ruta de Flatkey
Flatkey cambia el flujo operativo en torno a DeepSeek vs Qwen API: comprobaciones de enrutamiento compatibles con OpenAI. Puede permitir que los equipos mantengan una sola superficie de cliente compatible con OpenAI, una sola clave de Flatkey y una sola capa de revisión de uso en todos los modelos y herramientas compatibles. La guía de inicio rápido de Flatkey muestra la ruta de solicitud compatible con OpenAI, y la guía del SDK de OpenAI muestra la configuración de base_url. Flatkey no debe ocultar los requisitos específicos de cada proveedor.
Utiliza esta secuencia antes de que una ruta de Flatkey reciba tráfico de producción:
- Abra el directorio actual del modelo Flatkey y busque el ID exacto del modelo DeepSeek o Qwen.
- Confirme que la familia de endpoint es apropiada para la carga de trabajo, normalmente chat compatible con OpenAI para este artículo.
- Confirme que el modelo aparece en la ruta de la cuenta actual, no solo en un artículo antiguo o una captura de pantalla.
- Envíe una solicitud de chat simple a través de
https://router.flatkey.ai/v1/chat/completions. - Envíe la misma solicitud simple a través de la ruta directa del proveedor cuando tenga credenciales directas.
- Repita con streaming, una llamada a herramienta, una prueba de salida JSON, una muestra de contexto largo y un error forzado.
- Guarde el ID de la solicitud, la clase del proveedor, el ID del modelo, el código de estado, la latencia, los campos de uso, los campos de costo, el motivo de fallback, el propietario de la clave y el modelo de rollback.
Esta es la prueba mínima de humo de Flatkey:
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-verified-deepseek-or-qwen-model-id",
    "messages": [
      {
        "role": "user",
        "content": "Devuelve una sola frase confirmando que esta ruta está activa."
      }
    ]
  }'
Si esa solicitud falla con modelo no encontrado, endpoint no compatible, HTTP 401, HTTP 429, tiempo de espera agotado o fallo del analizador, la prueba aun así fue útil. Le indica que la cuenta, el ID del modelo, la familia de endpoint, el alcance de la clave, la cuota o la forma de la solicitud necesitan corrección antes de que el tráfico real se mueva.
Comprobaciones de ruta de DeepSeek
Use esta lista de verificación cuando DeepSeek sea la ruta candidata:
| Comprobación | Condición para aprobar |
|---|---|
| ID de modelo actual | La ruta usa deepseek-flash o deepseek-v4-pro, o el equipo ha aceptado explícitamente el comportamiento de mapeo de nombres heredados de DeepSeek. |
| Familia de endpoint | La aplicación llama a la familia de endpoint de DeepSeek prevista: formato OpenAI o formato Anthropic. |
| Compatibilidad de funciones | La salida JSON, las llamadas a herramientas, la API de Responses, la API de Anthropic, la finalización con prefijo beta, FIM y visión solo se prueban donde la carga de trabajo las usa. |
| Comportamiento de thinking/no-thinking | El modo seleccionado es lo suficientemente explícito para la evaluación y el registro. |
| Concurrencia | Se comprenden la concurrencia a nivel de cuenta y el comportamiento de aislamiento por usuario; se prueba el manejo de 429. |
| Comportamiento de solicitudes largas | Se prueban el tiempo de espera, el streaming, keep-alive y el comportamiento de salida máxima con tamaños reales de carga de trabajo. |
| Uso y costo | Se registran la entrada, la salida, el acierto/fallo de caché, el estado de pico/fuera de pico, los reintentos y la respuesta aceptada. |
DeepSeek es la ruta directa del proveedor más limpia cuando su producto quiere comportamiento nativo de DeepSeek y las comprobaciones de ruta anteriores pasan. No es automáticamente más segura solo porque la URL base sea simple.
Comprobaciones de ruta de Qwen
Use esta lista de verificación cuando Qwen a través de Model Studio sea la ruta candidata:
| Verificación | Condición de aprobación |
|---|---|
| Región | La región permitida de la carga de trabajo coincide con el endpoint de Model Studio al que llamas. |
| Dominio del espacio de trabajo | {WorkspaceId} se reemplaza por el ID real del espacio de trabajo cuando corresponde, y los dominios antiguos o globales no se siguen usando a ciegas. |
| Localidad de la clave de API | La clave de API se creó en la misma región que el endpoint; los fallos por discrepancia de región se clasifican por separado de los fallos por clave no válida. |
| Familia de modelos | La familia de modelos Qwen seleccionada admite la forma de la solicitud, la longitud de contexto y el modo de salida que usa tu aplicación. |
| Comportamiento de herramientas y streaming | Las llamadas a funciones y el streaming se prueban por separado, especialmente porque Model Studio señala que tools no puede usarse simultáneamente con stream=True. |
| Protocolo multimodal | Qwen-VL, Qwen-Omni y Qwen-Audio se comprueban por protocolo; Qwen-Audio no se trata como una ruta de chat compatible con OpenAI. |
| Unidad de precio | Se registran el nivel de tokens de entrada, los tokens de salida, la caché de contexto, la elegibilidad para el descuento por lote y el estado de promoción. |
Qwen suele ser la ruta directa más sólida cuando el equipo ya opera en Alibaba Cloud o necesita el modelo de región/cuenta de Model Studio. Requiere más pruebas de configuración porque la región, el espacio de trabajo y el alcance de la clave forman parte del contrato de la API.
Matriz de decisión
Usa esta matriz cuando una parte interesada pida un ganador.
| Área de decisión | Prefiere la API de DeepSeek | Prefiere la API de Qwen | Prefiere Flatkey |
|---|---|---|---|
| Configuración directa | Quieres una cuenta centrada en DeepSeek y la familia de modelos actual de DeepSeek. | Ya usas Alibaba Cloud Model Studio. | Quieres una sola URL base compatible con OpenAI para varias familias de modelos. |
| Control regional | Los controles directos de la cuenta DeepSeek son suficientes para la carga de trabajo. | Importan la región, el espacio de trabajo y la propiedad regional de la clave de API. | Quieres políticas a nivel de gateway, registros y propiedad compartida del equipo. |
| Comportamiento de herramientas/JSON | Las llamadas a herramientas y la salida JSON de DeepSeek superan tus pruebas de analizador. | Las llamadas a funciones y la salida estructurada de Qwen superan tus pruebas de analizador. | Las mismas pruebas pasan a través de la ruta exacta de Flatkey. |
| Enrutamiento multimodal | Solo necesitas las funciones de DeepSeek admitidas por la fila seleccionada. | Necesitas Qwen-VL, Qwen-Omni u otra familia de Model Studio y ya has comprobado su protocolo. | Quieres comparar rutas de texto, imagen, video o herramientas en una sola capa operativa. |
| Capacidad | La concurrencia a nivel de cuenta de DeepSeek se adapta a la carga de trabajo. | Las cuotas de Model Studio y la salud regional se adaptan a la carga de trabajo. | Quieres una política observable de reintento/fallback entre proveedores. |
| Revisión financiera | Los tokens de caché/pico/salida de DeepSeek son fáciles de modelar para la carga de trabajo. | Los niveles, la caché, el lote y los precios de consola de Qwen se adaptan a la carga de trabajo. | Finanzas necesita una vista de uso y una trazabilidad de facturación/recarga en todas las rutas. |
No existe un ganador universal de DeepSeek vs Qwen API: comprobaciones de enrutamiento compatibles con OpenAI. Hay una ruta que se adapta a la carga de trabajo, la región, el parser, el modelo de costes y el contrato operativo.
Plan de migración para equipos que ya están en producción
Avanza por etapas para que la calidad del modelo y la preparación de la ruta permanezcan separadas.
- Establece la línea base de la ruta actual: guarda los IDs de modelo, los prompts, las expectativas del parser, la latencia, el uso de tokens, las clases de error, el coste y el responsable.
- Vuelve a abrir la documentación actual: consulta las páginas de DeepSeek sobre modelo/precios, primera llamada, funciones y límites de tasa; consulta las páginas de Qwen sobre compatibilidad con OpenAI, modelo, precios y funciones.
- Ejecuta pruebas con el proveedor directo: usa los mismos prompts y parsers contra DeepSeek directo y Qwen directo si tienes credenciales.
- Ejecuta pruebas de Flatkey después de la búsqueda de ruta: confirma que el modelo exacto aparece en Flatkey y luego prueba a través de
https://router.flatkey.ai/v1. - Compara el comportamiento, no solo las respuestas: revisa chunks, JSON de llamadas a herramientas, validez de la salida JSON, errores de contexto, comportamiento 401/429, comportamiento de timeouts y campos de uso.
- Mueve primero el tráfico de bajo riesgo: empieza con herramientas internas, trabajos de evaluación, resúmenes por lotes o una pequeña parte no crítica del producto.
- Promociona después de la verificación de lectura: no des por completada la migración hasta que producto, plataforma y finanzas puedan inspeccionar la misma evidencia de la ruta.
Este plan por etapas evita un error común: declarar ganador a un modelo mientras la ruta en sí todavía no está demostrada.
Errores comunes
| Error | Por qué perjudica | Mejor comprobación |
|---|---|---|
| Usar alias antiguos de DeepSeek sin comprobar la fecha | La asignación de alias puede ocultar cambios de comportamiento y confundir las revisiones de costes. | Verifica los nombres actuales de modelo y el comportamiento de los nombres heredados antes de migrar. |
| Tratar todos los endpoints de Qwen como si fueran uno solo | La región, el dominio del workspace y la localidad de la API key pueden decidir si la llamada funciona. | Registra la región del endpoint, el ID del workspace y la región de la clave. |
| Comparar un solo precio por token | El acierto de caché, el fallo de caché, la longitud de salida, el modo de pensamiento, los niveles de entrada, los reintentos y las promociones cambian el coste real. | Revisa el coste por respuesta aceptada según la carga de trabajo. |
| Asumir paridad de herramientas | La forma de las llamadas a herramientas y el comportamiento de streaming pueden diferir según el proveedor y el modelo. | Prueba una llamada real a una herramienta y una ejecución en streaming a través de cada ruta. |
| Publicar una ruta de gateway a partir de una mención en un catálogo | El descubrimiento en un catálogo público no es lo mismo que la preparación de la ruta a nivel de cuenta. | Ejecuta una prueba en vivo de la ruta de Flatkey y guarda la evidencia de la solicitud. |
Recomendación final
Para DeepSeek vs Qwen API: comprobaciones de enrutamiento compatibles con OpenAI, empieza con la verdad del proveedor y termina con la evidencia de la ruta.
Usa DeepSeek directo cuando tu carga de trabajo encaje con la familia de modelos actual de DeepSeek, el endpoint compatible con OpenAI, el conjunto de funciones, las unidades de precio y el comportamiento de concurrencia. Usa Qwen directo cuando necesites las familias Qwen de Model Studio, endpoints regionales, dominios de workspace o controles de cuenta de Alibaba Cloud. Usa Flatkey cuando el problema principal sea una sola clave, una sola base URL compatible con OpenAI, evidencia de uso compartida, revisión de cuotas y facturación unificada entre modelos.
El siguiente paso no es un eslogan. Revisa la documentación actual del proveedor, consulta el directorio de modelos y la página de precios de Flatkey, ejecuta las pruebas de humo anteriores y, cuando estés listo para verificar un flujo de trabajo de DeepSeek vs Qwen API: comprobaciones de enrutamiento compatibles con OpenAI a través de una sola pasarela, obtén una clave de Flatkey. Para trabajos de implementación adyacentes, combina esta lista de verificación con el inicio rápido de la API de Flatkey, el flujo de trabajo de la API unificada de IA, la guía de migración a una alternativa de la API de OpenAI, el enrutamiento regional de proveedores de LLM y las métricas de la API de enrutamiento de IA.
Preguntas frecuentes
¿DeepSeek vs Qwen API es solo una decisión sobre la calidad del modelo?
No. DeepSeek vs Qwen API: comprobaciones de enrutamiento compatibles con OpenAI también incluyen la forma del endpoint, los alias de modelo, la región, el espacio de trabajo, la localización de la clave de API, los niveles de tokens, el comportamiento de la caché, las llamadas a herramientas, la salida JSON, el comportamiento del analizador de streaming, los límites de tasa, los registros y las pruebas de facturación.
¿Cuál API es más barata, DeepSeek o Qwen?
Depende del modelo exacto, la longitud del prompt, la longitud de la salida, el comportamiento de la caché, el nivel de tokens, el modo de pensamiento, los reintentos, la ruta y el momento de facturación. Usa las páginas oficiales de precios actuales y tus registros reales de uso en lugar de copiar un ganador estático.
¿Puedo usar un SDK de OpenAI con ambos proveedores?
Sí. DeepSeek y Model Studio documentan el uso compatible con OpenAI, pero la URL base, los nombres de los modelos, los parámetros adicionales, las advertencias sobre funciones y la configuración de la cuenta difieren. Flatkey también admite el patrón del SDK de OpenAI a través de https://router.flatkey.ai/v1 para los modelos compatibles.
¿La ruta compatible con OpenAI de Qwen admite todas las familias de modelos de Qwen?
No. Alibaba Cloud Model Studio indica que los modelos compatibles con OpenAI incluyen los modelos de lenguaje grande Qwen, Qwen-VL, Qwen-Coder, Qwen-Omni, Qwen-Math, DeepSeek, Kimi, GLM y MiniMax, pero también señala por separado que Qwen-Audio no admite el protocolo compatible con OpenAI y debe usar DashScope en su lugar.
¿Cuál es la primera prueba de Flatkey para el enrutamiento de DeepSeek vs Qwen API?
Comienza con una completación de chat simple a través de https://router.flatkey.ai/v1, y luego verifica el ID del modelo, el estado, los campos de uso, la unidad de precios, el streaming, las llamadas a herramientas, la salida JSON, el comportamiento ante errores, la conmutación por error y la ruta de reversión.


