
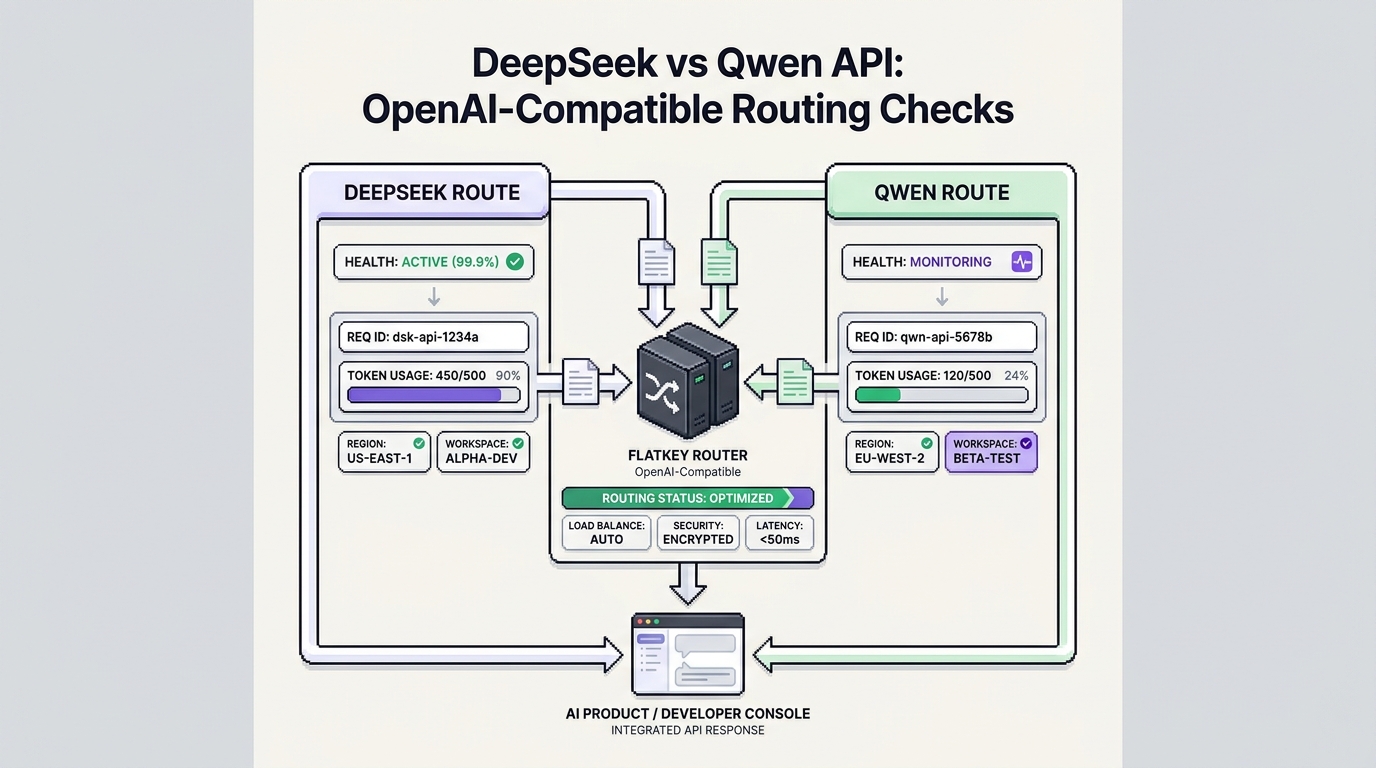
DeepSeek vs Qwen API:OpenAI 兼容路由检查 这个问题不仅仅是一个模型比较。对于生产团队来说,这更是一个路由就绪问题:你的客户端调用的是哪个端点族、密钥归哪个账号所有、当前使用的是哪个模型 ID、哪些功能表现符合解析器的预期,以及当流量迁移后你可以在哪里查看用量。
这种表述很重要,因为在 SDK 层面,两家提供商看起来都很熟悉。DeepSeek 文档提供了一个OpenAI 兼容的 API 接口,其 OpenAI 格式的基础 URL 为 https://api.deepseek.com。阿里云百炼文档提供了OpenAI 兼容的 Qwen 访问方式,但其基础 URL 可能取决于区域和工作区。如果你使用 Flatkey,你的应用可以保持 OpenAI SDK 的形态并指向 https://router.flatkey.ai/v1,但在把它称为生产就绪之前,你仍然需要验证具体的 DeepSeek 或 Qwen 路由。
在切换工作负载、添加回退或统一共享网关之前,请将这份 DeepSeek vs Qwen API:OpenAI 兼容路由检查 指南作为一份实用清单来使用。
快速回答:DeepSeek vs Qwen API 路由检查
| 路由选择 | 适合在以下情况下优先使用 | 上线前需要验证 |
|---|---|---|
| 直接使用 DeepSeek API | 你需要 DeepSeek 原生行为、DeepSeek 当前的模型 ID,以及一个聚焦的 OpenAI 兼容端点。 | 基础 URL、模型 ID、别名生命周期、JSON 输出、工具调用、流式传输、视觉支持、上下文长度、并发、429 处理以及计费单位。 |
| 通过阿里云百炼直接使用 Qwen API | 你已经在阿里云生态中运行,需要 Qwen 模型家族,或者必须直接控制区域和工作区配置。 | 区域端点、按工作区划分的域名、与区域绑定的 API 密钥、所选 Qwen 家族、工具/流式兼容性、Token 层级、缓存规则以及认证错误。 |
| Flatkey 网关路由 | 你想要一个密钥、一个 OpenAI 兼容基础 URL、统一的用量审查,以及跨多个模型家族更简单的路由。 | 当前 Flatkey 模型行、端点家族、路由健康状态、请求日志、Token/成本字段、功能透传、回退策略以及回滚路由。 |
实际的 DeepSeek vs Qwen API:OpenAI 兼容路由检查 答案往往是混合型的。当你需要尚未通过网关验证的、特定于提供商的控制时,使用直连提供商路由。当更大的运营问题是分散的提供商密钥、碎片化计费,以及团队或代理之间反复的 SDK 改动时,使用 Flatkey。
首先要检查的提供商事实
每次进行 DeepSeek vs Qwen API:OpenAI 兼容路由检查 审查时,都应从最新的提供商文档开始,而不是过时的模型列表。
DeepSeek 目前说明其 API 使用与 OpenAI 和 Anthropic 兼容的格式。其首次调用文档列出了针对 OpenAI 格式调用的 https://api.deepseek.com,以及针对 Anthropic 格式调用的 https://api.deepseek.com/anthropic。其当前的 模型与定价表将 deepseek-flash 和 deepseek-v4-pro 列为当前可用的行,并在同一页面显示模型版本、功能支持、上下文长度、最大输出和并发限制。
DeepSeek 的生命周期说明很重要:像 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 这样的旧名称仍然可以接受,但 DeepSeek 说明这些已退役名称会由更新的 Flash 模型提供服务,并按 Flash 价格计费。如果你的代码、网关策略或评估表仍在使用旧别名,那么在比较输出之前先更新路由检查。
通过阿里云 Model Studio 的 Qwen 起点则是另一份契约。Model Studio 说明 Qwen 模型支持 OpenAI 兼容接口,现有的 OpenAI 代码只需更改 API key、base URL 和模型名称即可迁移。但同一文档又将 base URL 与区域绑定,并且对多个区域还绑定到特定 workspace 域名。文档还说明,Model Studio API key 绑定于创建它的区域;使用该 key 调用其他区域的端点可能会返回 HTTP 401 身份验证错误。
这就是核心差异。对于 DeepSeek,首要问题通常是“当前是哪个 DeepSeek 模型 ID 和功能模式?”对于 Qwen,首要问题往往是“哪个区域、workspace 域名、API key 和模型家族?”
OpenAI 兼容并不意味着完全相同
“OpenAI-compatible” 这个说法是一种迁移加速器。它并不意味着每个端点、字段、流、错误或工具调用边缘情况都完全一致。
| 检查项 | DeepSeek 直连路由 | Qwen 直连路由 | Flatkey 路由 |
|---|---|---|---|
| Base URL | OpenAI 格式的 base URL 是 https://api.deepseek.com。 |
兼容模式的 base URL 因区域而异,可能包含 {WorkspaceId}。 |
OpenAI 兼容的 base URL 是 https://router.flatkey.ai/v1。 |
| Chat endpoint | 直接的 cURL 示例使用 /chat/completions。 |
兼容模式示例使用 /chat/completions。 |
OpenAI 兼容流量使用 /v1/chat/completions。 |
| Model IDs | 当前文档重点是 deepseek-flash 和 deepseek-v4-pro;旧版 Flash 名称仍被接受,但会映射到新名称。 |
当前文档显示了 Qwen 条目,例如 qwen3.8-max、qwen3.7-plus 和 qwen3.8-flash,并具有各家族特定行为。 |
使用 Flatkey 模型目录或账户路由中可见的准确 model ID。 |
| Streaming | 测试流式分块、空闲等待、取消,以及最终 usage 处理。 | Model Studio 示例显示 stream=True 和 stream_options={"include_usage": True}。 |
确认你的 SDK 解析器能够通过网关处理分块和最终 usage。 |
| Tool calls | DeepSeek 将工具调用文档化为当前条目支持的功能。 | Model Studio 文档说明了函数调用,但也指出在 OpenAI 兼容参数部分中,tools 不能与 stream=True 同时使用。 |
在 agent 依赖该路由之前,先运行真实的工具调用测试。 |
| JSON output | DeepSeek 列出了当前条目的 JSON 输出支持。 | Qwen 兼容参数包含响应格式设置以及模型特定支持说明。 | 测试 schema 解析、无效 JSON 行为和回退。 |
| Vision/audio | DeepSeek 的表格将 deepseek-flash 标记为支持视觉能力,而 deepseek-v4-pro 不支持。 |
Model Studio 将 Qwen-VL 和 Qwen-Omni 列为支持的模型家族,但说明 Qwen-Audio 不支持 OpenAI 兼容协议,应使用 DashScope。 | 不要仅凭文本聊天通过就假定多模态能力等同。 |
| Capacity/errors | DeepSeek 文档说明了账户级并发限制,以及超限时返回 HTTP 429。 | Qwen 的区域/密钥不匹配可能返回 HTTP 401;配额和限流应按区域/账户分别测试。 | 记录 provider class、状态码、重试、回退原因、延迟、tokens 和成本。 |
这就是核心的 DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks 规则:验证你实际会运行的路由,而不是由提供商名称暗示的路由。
在比较路由之前先做定价检查
一条路由可以是兼容的,但对工作负载而言仍可能在财务上不正确。不要用一个输入 token 标题来比较 DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks。
DeepSeek 当前的定价文档按一百万 token 为单位计费,并将缓存命中输入、缓存未命中输入和输出 token 分开计算。它还区分高峰与非高峰费率,并在模型行旁边标明并发限制。其 限流文档 说明并发是按账号级别计算的,超出并发会返回 HTTP 429。也就是说,只有当你的日志把输入、输出、缓存行为、请求持续时间以及 429 发生率分开记录时,DeepSeek 的成本审查才会足够直接。
Model Studio 说明模型 API 调用默认按量计费,而且其 定价文档 列出了标准价格,促销则在控制台中单独处理。它还指出,某些模型会根据单次请求中的输入 token 总数采用分层定价,而上下文缓存和批处理折扣有各自独立的规则。这意味着,一次简短的聊天请求、一次 100K token 的检索请求、一次带缓存的重复上下文请求,以及一个批处理作业,可能分别属于不同的 Qwen 成本区间。
在推广路由之前,请先使用这张成本归一化表:
| 成本字段 | 为什么它会改变决策 | 要记录什么 |
|---|---|---|
| 输入 token | Qwen 分层定价和 DeepSeek 的缓存未命中输入会改变实际成本。 | 提示词 token、输入档位、缓存未命中 token、模型 ID。 |
| 缓存 token | 只有当工作负载重复稳定上下文且路由能提供证据时,缓存折扣才有帮助。 | 缓存命中 token、缓存写入 token、缓存策略、请求类型。 |
| 输出 token | 长答案以及推理/思考输出可能占据账单的大头。 | 完成 token、如果返回则记录推理/思考 token、输出上限。 |
| 高峰/非高峰或促销状态 | 公开的提供商页面可能会将标准价格与基于时间或控制台促销价格分开。 | 计费时间、价格来源日期、路由负责人。 |
| 重试/回退成本 | 失败尝试和回退尝试可能会抵消表面上的 token 节省。 | 尝试次数、重试原因、回退模型、接受响应标记。 |
对于 Flatkey,也要保持同样的纪律:先查看当前的 模型目录 和 定价页面,再在日志中验证请求级别的使用情况。公开提及某个模型有助于发现可用性;而生产决策则需要一次成功的路由测试和一份可读的账本。
Flatkey 路由检查清单
Flatkey 改变了围绕 DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks 的操作流程。它可以让团队在受支持的模型和工具之间,继续使用一个 OpenAI 兼容的客户端接口、一个 Flatkey 密钥以及一层统一的用量审查。Flatkey 快速开始展示了 OpenAI 兼容的请求路径,而 OpenAI SDK 指南展示了 base_url 的设置。Flatkey 不应掩盖各提供商特有的要求。
在 Flatkey 路由接收生产流量之前,请按以下顺序执行:
- 打开当前的 Flatkey 模型目录,并搜索准确的 DeepSeek 或 Qwen 模型 ID。
- 确认端点家族适合该工作负载,通常本文使用 OpenAI 兼容的聊天接口。
- 确认该模型出现在当前账号路由中,而不只是旧文章或截图里。
- 通过
https://router.flatkey.ai/v1/chat/completions发送一个纯聊天请求。 - 在你拥有直接凭证时,通过直接的提供方路由发送同样的纯请求。
- 分别使用流式传输、一次工具调用、一次 JSON 输出测试、一个长上下文样本以及一次强制错误进行重复测试。
- 保存请求 ID、提供方类别、模型 ID、状态码、延迟、用量字段、成本字段、回退原因、密钥所有者以及回滚模型。
下面是最小的 Flatkey 冒烟测试:
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-verified-deepseek-or-qwen-model-id",
    "messages": [
      {
        "role": "user",
        "content": "Return one sentence confirming this route is alive."
      }
    ]
  }'
如果该请求因 model-not-found、不受支持的端点、HTTP 401、HTTP 429、超时或解析器失败而失败,这个测试仍然是有帮助的。它会告诉你,在真实流量切换之前,账号、模型 ID、端点家族、密钥作用域、配额或请求形状需要修正。
DeepSeek 路由检查
当 DeepSeek 是候选路由时,请使用此清单:
| 检查项 | 通过条件 |
|---|---|
| 当前模型 ID | 该路由使用 deepseek-flash 或 deepseek-v4-pro,或者团队已明确接受 DeepSeek 旧名称映射行为。 |
| 端点家族 | 应用调用的是预期的 DeepSeek 端点家族:OpenAI 格式或 Anthropic 格式。 |
| 功能支持 | JSON 输出、工具调用、Responses API、Anthropic API、beta 前缀补全、FIM 和视觉功能仅在工作负载实际使用到它们时才进行测试。 |
| 思考/非思考行为 | 所选模式足够明确,便于评估和记录。 |
| 并发 | 已了解账号级并发和按用户隔离行为;已测试 429 处理。 |
| 长请求行为 | 使用真实工作负载规模测试超时、流式传输、keep-alive 和最大输出行为。 |
| 用量和成本 | 已记录输入、输出、缓存命中/未命中、峰值/非峰值状态、重试以及接受的响应。 |
当你的产品需要 DeepSeek 原生行为且上述路由检查都通过时,DeepSeek 是更清晰的直接提供方路径。它并不会因为基础 URL 简单就自动更安全。
Qwen 路由检查
当通过 Model Studio 使用 Qwen 是候选路由时,请使用此清单:
| 检查项 | 通过条件 |
|---|---|
| 区域 | 工作负载允许的区域与您调用的 Model Studio 端点一致。 |
| 工作区域名 | 在需要的地方,{WorkspaceId} 已替换为真实的 workspace ID,且没有盲目沿用旧的/全局域名。 |
| API 密钥本地性 | API 密钥是在与端点相同的区域创建的;区域不匹配失败会与无效密钥失败分别分类。 |
| 模型家族 | 所选的 Qwen 模型家族支持应用所使用的请求结构、上下文长度和输出模式。 |
| 工具与流式行为 | 函数调用和流式传输分别测试,尤其因为 Model Studio 指出 tools 不能与 stream=True 同时使用。 |
| 多模态协议 | Qwen-VL、Qwen-Omni 和 Qwen-Audio 按协议检查;Qwen-Audio 不被视为 OpenAI 兼容的聊天路由。 |
| 计费单位 | 输入 token 档位、输出 tokens、上下文缓存、批量折扣资格以及促销状态都会记录。 |
当团队已经运行在 Alibaba Cloud 上,或者需要 Model Studio 的区域/账户模型时,Qwen 往往是更强的直接路由。它需要更多的配置证明,因为区域、工作区和密钥范围都是 API 合约的一部分。
决策矩阵
当利益相关者要求给出一个赢家时,请使用此矩阵。
| 决策维度 | 优先选择 DeepSeek API | 优先选择 Qwen API | 优先选择 Flatkey |
|---|---|---|---|
| 直接配置 | 您需要一个专注的 DeepSeek 账户和当前的 DeepSeek 模型家族。 | 您已经在使用 Alibaba Cloud Model Studio。 | 您希望在多个模型家族之间使用一个 OpenAI 兼容的基础 URL。 |
| 区域控制 | DeepSeek 账户层面的控制已足以满足工作负载。 | 区域、工作区以及区域性 API 密钥归属很重要。 | 您希望拥有网关级策略、日志以及共享的团队所有权。 |
| 工具/JSON 行为 | DeepSeek 的工具调用和 JSON 输出能通过您的解析器测试。 | Qwen 的函数调用和结构化输出能通过您的解析器测试。 | 相同的测试通过完全相同的 Flatkey 路由。 |
| 多模态路由 | 您只需要所选行所支持的 DeepSeek 功能。 | 您需要 Qwen-VL、Qwen-Omni 或其他 Model Studio 家族,并且已经检查过其协议。 | 您希望在一个运行层中比较文本、图像、视频或工具路由。 |
| 容量 | DeepSeek 账户级并发足以适配工作负载。 | Model Studio 配额和区域健康状况适配工作负载。 | 您希望在不同提供方之间拥有可观测的重试/回退策略。 |
| 财务审查 | DeepSeek 的缓存/峰值/输出单位很容易针对该工作负载建模。 | Qwen 的分层、缓存、批处理和控制台定价适配工作负载。 | 财务部门需要在所有路由之间看到一份统一的用量视图和一条统一的计费/充值轨迹。 |
没有一个通用的 DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks 胜出者。真正合适的是与工作负载、区域、解析器、成本模型和运行约定相匹配的路由。
迁移计划(适用于已在生产中交付的团队)
分阶段迁移,以便将模型质量和路由就绪状态分开评估。
- 基线当前路由:保存模型 ID、提示词、解析器预期、延迟、token 使用量、错误类别、成本和负责人。
- 重新查看当前文档:检查 DeepSeek 的模型/定价、首次调用、功能和速率限制页面;检查 Qwen 的 OpenAI 兼容、模型、定价和功能页面。
- 运行直连提供商测试:如果你有凭证,使用相同的提示词和解析器分别对直连 DeepSeek 和直连 Qwen 进行测试。
- 在路由查询后运行 Flatkey 测试:确认 Flatkey 中确实出现了该精确模型,然后通过
https://router.flatkey.ai/v1进行测试。 - 比较行为,而不只是答案:查看分块、工具调用 JSON、JSON 输出有效性、上下文错误、401/429 行为、超时行为和 usage 字段。
- 先迁移低风险流量:从内部工具、评测任务、批量摘要或小范围非关键产品切片开始。
- 在回读后再推进:在产品、平台和财务都能检查到相同的路由证据之前,不要宣布迁移完成。
这种分阶段计划可以避免一个常见错误:在路由本身仍未验证的情况下,就宣布某个模型胜出。
常见错误
| 错误 | 为什么会有害 | 更好的检查方式 |
|---|---|---|
| 在不检查日期的情况下使用旧的 DeepSeek 别名 | 别名映射可能掩盖行为变化,并让成本审查变得混乱。 | 迁移前核实当前模型名称和旧名称的行为。 |
| 把所有 Qwen 端点都当作同一个端点 | 区域、工作区域名和 API key 的本地性会决定调用是否能成功。 | 记录端点区域、工作区 ID 和 key 的区域。 |
| 只比较单个 token 价格 | 缓存命中、缓存未命中、输出长度、思考模式、输入分层、重试和促销都会改变真实成本。 | 按工作负载查看每个被接受响应的成本。 |
| 假设工具能力完全对等 | 工具调用形态和流式行为会因提供商和模型而异。 | 通过每条路由测试一次真实工具调用和一次流式运行。 |
| 仅根据目录提及就发布网关路由 | 公开目录可发现性并不等同于账户级路由就绪。 | 运行一次实时 Flatkey 路由测试并保存请求证据。 |
最终建议
对于 DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks,应先以提供商事实为准,再以路由证据收尾。
当你的工作负载适合 DeepSeek 当前的模型家族、OpenAI 兼容端点、功能集、定价单位和并发行为时,优先使用 DeepSeek 直连。当你需要 Model Studio 的 Qwen 系列、区域端点、工作区域名或阿里云账户控制时,优先使用 Qwen 直连。当真正的问题是需要一个 key、一个 OpenAI 兼容 base URL、共享使用证据、配额审查以及跨模型统一计费时,使用 Flatkey。
下一步不是一句口号。请查看当前提供商文档,查看 Flatkey 的 模型目录和定价页面,运行上面的冒烟测试,然后在你准备通过一个网关验证 DeepSeek vs Qwen API:OpenAI 兼容路由检查 工作流时获取一个 Flatkey key。对于相邻的上线工作,请将此检查清单与 Flatkey API 快速入门、统一 AI API 工作流、OpenAI API 替代迁移指南、区域 LLM 提供商路由以及AI 路由 API 指标搭配使用。
常见问题
DeepSeek vs Qwen API 只是模型质量的决定吗?
不是。DeepSeek vs Qwen API:OpenAI 兼容路由检查 还包括端点形态、模型别名、区域、工作区、API 密钥本地性、token 层级、缓存行为、工具调用、JSON 输出、流式解析器行为、速率限制、日志和计费证据。
DeepSeek 和 Qwen 哪个 API 更便宜?
这取决于具体模型、提示长度、输出长度、缓存行为、token 层级、思考模式、重试、路由和计费时间。请使用当前官方定价页面和你的实际使用日志,而不是照搬一个静态的赢家。
我可以对这两个提供商都使用 OpenAI SDK 吗?
可以。DeepSeek 和 Model Studio 都文档化了 OpenAI 兼容用法,但基础 URL、模型名称、额外参数、功能限制和账户设置有所不同。Flatkey 也通过 https://router.flatkey.ai/v1 为受支持的模型支持 OpenAI SDK 模式。
Qwen 的 OpenAI 兼容路由支持所有 Qwen 模型家族吗?
不支持。阿里云 Model Studio 说明受支持的 OpenAI 兼容模型包括 Qwen 大语言模型、Qwen-VL、Qwen-Coder、Qwen-Omni、Qwen-Math、DeepSeek、Kimi、GLM 和 MiniMax,但它另外说明 Qwen-Audio 不支持 OpenAI 兼容协议,应改用 DashScope。
DeepSeek vs Qwen API 路由的第一个 Flatkey 测试是什么?
先通过 https://router.flatkey.ai/v1 发起一个普通聊天补全,然后验证模型 ID、状态、usage 字段、计费单位、流式传输、工具调用、JSON 输出、错误行为、回退和回滚路径。


