
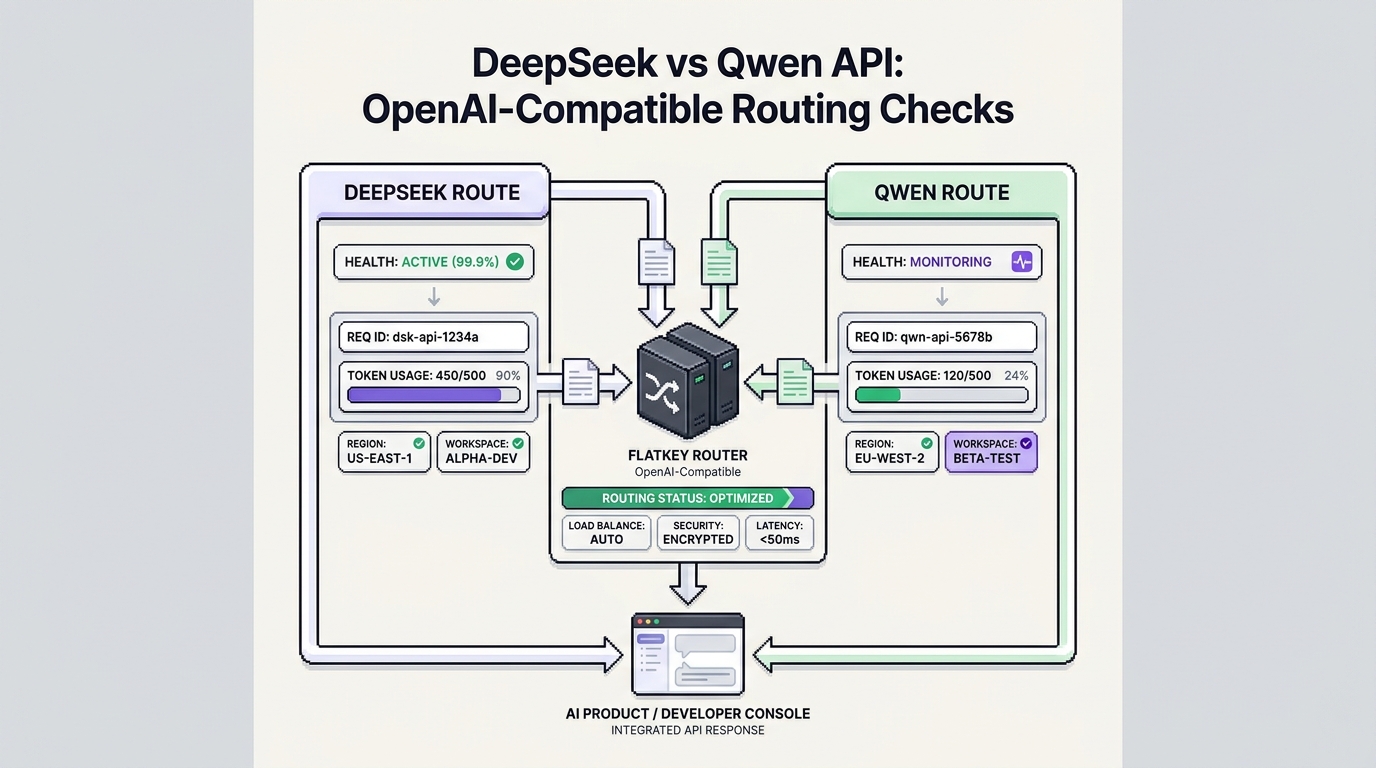
La question DeepSeek vs Qwen API : vérifications de routage compatibles OpenAI n’est pas seulement une comparaison de modèles. Pour une équipe de production, c’est une question de préparation au routage : quelle famille d’endpoint votre client appelle, quel compte possède la clé, quel ID de modèle est actuel, quelles fonctionnalités se comportent comme votre parseur l’attend, et où vous pouvez inspecter l’utilisation après le déplacement du trafic.
Ce cadrage est important, car les deux fournisseurs peuvent sembler familiers au niveau du SDK. DeepSeek documente une surface d’API compatible OpenAI avec https://api.deepseek.com comme URL de base au format OpenAI. Alibaba Cloud Model Studio documente un accès Qwen compatible OpenAI, mais son URL de base peut dépendre de la région et de l’espace de travail. Si vous utilisez Flatkey, votre application peut conserver la structure du SDK OpenAI et pointer vers https://router.flatkey.ai/v1, mais vous devez toujours vérifier le routage exact DeepSeek ou Qwen avant de le considérer prêt pour la production.
Utilisez ce guide DeepSeek vs Qwen API : vérifications de routage compatibles OpenAI comme checklist pratique avant de basculer des charges de travail, d’ajouter un repli, ou de standardiser une passerelle partagée.
Réponse rapide : vérifications de routage DeepSeek vs Qwen API
| Choix de routage | À privilégier quand | À vérifier avant le lancement |
|---|---|---|
| API DeepSeek directe | Vous avez besoin du comportement natif DeepSeek, des ID de modèle actuels de DeepSeek et d’un endpoint ciblé compatible OpenAI. | URL de base, ID de modèle, cycle de vie des alias, sortie JSON, appels d’outils, streaming, prise en charge de la vision, longueur de contexte, concurrence, gestion des 429 et unités de tarification. |
| API Qwen directe via Model Studio | Vous opérez déjà dans Alibaba Cloud, avez besoin des familles de modèles Qwen, ou devez contrôler directement la configuration de la région et de l’espace de travail. | Endpoint régional, domaine spécifique à l’espace de travail, clé API liée à la région, famille Qwen sélectionnée, compatibilité des outils/du streaming, paliers de jetons, règles de cache et erreurs d’authentification. |
| Route de passerelle Flatkey | Vous voulez une seule clé, une seule URL de base compatible OpenAI, une revue d’utilisation partagée et un routage plus simple entre plusieurs familles de modèles. | Ligne de modèle Flatkey actuelle, famille d’endpoint, état de santé de la route, journal des requêtes, champs jetons/coûts, transmission des fonctionnalités, politique de repli et route de retour arrière. |
La réponse pratique à DeepSeek vs Qwen API : vérifications de routage compatibles OpenAI est souvent hybride. Utilisez les routes directes du fournisseur lorsque vous avez besoin de contrôles spécifiques au fournisseur que vous n’avez pas validés via une passerelle. Utilisez Flatkey lorsque le problème opérationnel principal est la dispersion des clés fournisseurs, la fragmentation de la facturation et les changements SDK répétés entre équipes ou agents.
Faits fournisseurs à vérifier en premier
Commencez chaque revue DeepSeek vs Qwen API : vérifications de routage compatibles OpenAI avec la documentation actuelle du fournisseur, et non avec une ancienne liste de modèles.
DeepSeek documente actuellement que son API utilise un format compatible avec OpenAI et Anthropic. Sa documentation de premier appel liste https://api.deepseek.com pour les appels au format OpenAI et https://api.deepseek.com/anthropic pour les appels au format Anthropic. Son tableau des modèles et des tarifs actuel liste deepseek-flash et deepseek-v4-pro comme lignes actives, avec les versions des modèles, la prise en charge des fonctionnalités, la longueur de contexte, la sortie maximale et les limites de concurrence sur la même page.
La note sur le cycle de vie de DeepSeek est importante : des noms hérités tels que deepseek-v4-flash et deepseek-v4-flash-vision-exp sont encore acceptés, mais DeepSeek indique que ces noms retirés sont desservis par le nouveau modèle Flash et facturés au tarif Flash. Si votre code, votre politique de passerelle ou votre feuille d'évaluation utilise encore un ancien alias, mettez à jour la vérification de routage avant de comparer les résultats.
Qwen via Alibaba Cloud Model Studio part d'un contrat différent. Model Studio indique que les modèles Qwen prennent en charge des interfaces compatibles avec OpenAI et que le code OpenAI existant peut migrer en modifiant la clé API, l'URL de base et le nom du modèle. Mais la même documentation relie l'URL de base à la région et, pour plusieurs régions, à un domaine spécifique à l'espace de travail. Elle indique également qu'une clé API Model Studio est liée à la région où elle a été créée ; appeler le point de terminaison d'une autre région avec cette clé peut renvoyer une erreur d'authentification HTTP 401.
C'est la différence fondamentale. Avec DeepSeek, la première question est généralement « quel identifiant de modèle DeepSeek actuel et quel mode de fonctionnalité ? » Avec Qwen, la première question est souvent « quelle région, quel domaine d'espace de travail, quelle clé API et quelle famille de modèles ? »
Compatible avec OpenAI ne signifie pas identique
L'expression « compatible avec OpenAI » est un accélérateur de migration. Ce n'est pas une promesse que chaque point de terminaison, champ, flux, erreur ou cas limite d'appel d'outil se comporte de manière identique.
| Vérification | Route directe DeepSeek | Route directe Qwen | Route Flatkey |
|---|---|---|---|
| URL de base | L’URL de base au format OpenAI est https://api.deepseek.com. |
L’URL de base en mode compatible varie selon la région et peut inclure {WorkspaceId}. |
L’URL de base compatible OpenAI est https://router.flatkey.ai/v1. |
| Point de terminaison du chat | Les exemples cURL directs utilisent /chat/completions. |
Les exemples en mode compatible utilisent /chat/completions. |
Le trafic compatible OpenAI utilise /v1/chat/completions. |
| Identifiants de modèle | La documentation actuelle se concentre sur deepseek-flash et deepseek-v4-pro ; les anciens noms Flash sont acceptés mais réorientés. |
La documentation actuelle montre des lignes Qwen telles que qwen3.8-max, qwen3.7-plus et qwen3.8-flash, avec un comportement spécifique à la famille. |
Utilisez l’identifiant de modèle exact visible dans le répertoire des modèles Flatkey ou dans la route du compte. |
| Streaming | Testez les fragments diffusés, les attentes en veille, l’annulation et le traitement final de l’utilisation. | Les exemples de Model Studio montrent stream=True et stream_options={"include_usage": True}. |
Vérifiez que votre parseur SDK gère les fragments et l’utilisation finale via la passerelle. |
| Appels d’outils | DeepSeek documente les appels d’outils comme une fonctionnalité prise en charge pour les lignes actuelles. | Model Studio documente l’appel de fonctions, mais précise aussi que tools ne peut pas être utilisé simultanément avec stream=True dans la section des paramètres compatibles OpenAI. |
Exécutez un test réel d’appel d’outil avant qu’un agent ne dépende de la route. |
| Sortie JSON | DeepSeek indique la prise en charge de la sortie JSON pour les lignes actuelles. | Les paramètres compatibles Qwen incluent le formatage des réponses et des notes de prise en charge spécifiques au modèle. | Testez l’analyse du schéma, le comportement JSON invalide et le repli. |
| Vision/audio | Le tableau de DeepSeek indique la prise en charge de la vision pour deepseek-flash et non pour deepseek-v4-pro. |
Model Studio répertorie Qwen-VL et Qwen-Omni comme familles de modèles prises en charge, mais indique que Qwen-Audio ne prend pas en charge le protocole compatible OpenAI et doit utiliser DashScope. | Ne supposez pas une parité multimodale à partir d’un passage en chat textuel. |
| Capacité/erreurs | DeepSeek documente la concurrence au niveau du compte et HTTP 429 lorsqu’elle est dépassée. | Les incohérences de région/de clé Qwen peuvent renvoyer HTTP 401 ; les quotas et les limitations doivent être testés par région/compte. | Journalisez la classe de fournisseur, le code d’état, la tentative de nouvelle exécution, la raison du repli, la latence, les jetons et le coût. |
Voici la règle centrale de DeepSeek vs Qwen API : vérifications de routage compatibles OpenAI : prouvez la route que vous allez réellement exécuter, et non celle suggérée par le nom d’un fournisseur.
Vérifications des tarifs avant de comparer les routes
Une route peut être compatible tout en étant financièrement inadaptée à la charge de travail. Ne comparez pas DeepSeek vs Qwen API : vérifications de routage compatibles OpenAI avec un simple gros titre sur les jetons d’entrée.
La documentation tarifaire actuelle de DeepSeek facture par unités d’un million de jetons et sépare les jetons d’entrée avec cache, d’entrée sans cache et de sortie. Elle distingue aussi les tarifs de pointe et hors pointe et place les limites de concurrence à côté des lignes de modèles. Sa documentation sur les limites de débit indique que la concurrence est calculée au niveau du compte et qu’un excès de concurrence renvoie HTTP 429. Cela rend l’évaluation des coûts de DeepSeek simple uniquement si vos journaux séparent l’entrée, la sortie, le comportement du cache, la durée de la requête et le taux de 429.
Model Studio indique que les appels à l’API des modèles sont facturés à l’usage par défaut et que son document de tarification affiche les prix standard, les promotions étant gérées séparément dans la console. Il précise également que certains modèles utilisent une tarification par paliers basée sur le nombre total de jetons d’entrée dans une seule requête, et que le cache de contexte et les remises de batch ont leurs propres règles. Cela signifie qu’une courte requête de chat, une requête de récupération de 100K jetons, une requête répétée avec cache du contexte et un job batch peuvent relever de différentes catégories de coût Qwen.
Utilisez ce tableau de normalisation des coûts avant de promouvoir une route :
| Champ de coût | Pourquoi cela change la décision | Que consigner |
|---|---|---|
| Jetons d’entrée | Les paliers Qwen et les entrées sans cache de DeepSeek peuvent modifier le coût effectif. | Jetons du prompt, palier d’entrée, jetons de cache manqué, identifiant du modèle. |
| Jetons mis en cache | Les remises de cache n’aident que lorsque la charge de travail répète un contexte stable et que la route fournit des preuves. | Jetons de cache hit, jetons d’écriture de cache, politique de cache, famille de requêtes. |
| Jetons de sortie | Les réponses longues et les sorties de raisonnement/pensée peuvent dominer la facture. | Jetons de complétion, jetons de raisonnement/pensée s’ils sont renvoyés, limite de sortie. |
| Tarif de pointe/hors pointe ou état promotionnel | Les pages publiques des fournisseurs peuvent séparer les prix standard des promotions temporelles ou en console. | Heure de facturation, date de la source du prix, propriétaire de la route. |
| Coût de retry/fallback | Les tentatives échouées et les tentatives de repli peuvent annuler les économies apparentes de jetons. | Nombre de tentatives, raison du retry, modèle de fallback, indicateur de réponse acceptée. |
Pour Flatkey, conservez la même discipline : vérifiez le répertoire des modèles et la page de tarification actuels, puis vérifiez l’utilisation au niveau des requêtes dans les journaux. La mention publique d’un modèle est utile pour la découverte. Une décision de production nécessite un test de route réussi et un registre lisible.
Liste de contrôle de la route Flatkey
Flatkey modifie le flux de travail opérationnel autour de DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks. Il peut permettre aux équipes de conserver une seule surface client compatible OpenAI, une seule clé Flatkey et une seule couche de revue de l’utilisation sur les modèles et outils pris en charge. Le guide de démarrage rapide Flatkey montre le chemin de requête compatible OpenAI, et le guide du SDK OpenAI montre la configuration de base_url. Flatkey ne doit pas masquer les exigences spécifiques au fournisseur.
Utilisez cette séquence avant qu’une route Flatkey ne reçoive du trafic de production :
- Ouvrez le répertoire du modèle Flatkey actuel et recherchez l’ID exact du modèle DeepSeek ou Qwen.
- Confirmez que la famille de points de terminaison est adaptée à la charge de travail, généralement le chat compatible OpenAI pour cet article.
- Confirmez que le modèle apparaît dans la route du compte actuel, et non uniquement dans un ancien article ou une capture d’écran.
- Envoyez une requête de chat simple via
https://router.flatkey.ai/v1/chat/completions. - Envoyez la même requête simple via la route directe du fournisseur lorsque vous disposez d’identifiants directs.
- Répétez avec le streaming, un appel d’outil, un test de sortie JSON, un échantillon de long contexte et une erreur forcée.
- Enregistrez l’ID de requête, la classe de fournisseur, l’ID du modèle, le code d’état, la latence, les champs d’utilisation, les champs de coût, la raison du repli, le propriétaire de la clé et le modèle de retour arrière.
Voici le test de fumée Flatkey minimal :
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-verified-deepseek-or-qwen-model-id",
    "messages": [
      {
        "role": "user",
        "content": "Return one sentence confirming this route is alive."
      }
    ]
  }'
Si cette requête échoue avec modèle introuvable, point de terminaison non pris en charge, HTTP 401, HTTP 429, délai d’attente ou échec de l’analyseur, le test a tout de même été utile. Il vous indique que le compte, l’ID du modèle, la famille de points de terminaison, le périmètre de la clé, le quota ou la forme de la requête doivent être corrigés avant le transfert du trafic réel.
Vérifications de la route DeepSeek
Utilisez cette liste de contrôle lorsque DeepSeek est la route candidate :
| Vérification | Condition de réussite |
|---|---|
| ID du modèle actuel | La route utilise deepseek-flash ou deepseek-v4-pro, ou l’équipe a explicitement accepté le comportement de mappage des noms hérités de DeepSeek. |
| Famille de points de terminaison | L’application appelle la famille de points de terminaison DeepSeek visée : format OpenAI ou format Anthropic. |
| Prise en charge des fonctionnalités | La sortie JSON, les appels d’outils, l’API Responses, l’API Anthropic, l’achèvement avec préfixe bêta, FIM et la vision ne sont testés que là où la charge de travail les utilise. |
| Comportement de réflexion/sans réflexion | Le mode sélectionné est suffisamment explicite pour l’évaluation et la journalisation. |
| Concurrence | La concurrence au niveau du compte et le comportement d’isolation par utilisateur sont compris ; la gestion des 429 est testée. |
| Comportement des requêtes longues | Le délai d’attente, le streaming, le keep-alive et le comportement de sortie maximale sont testés avec des tailles réelles de charge de travail. |
| Utilisation et coût | L’entrée, la sortie, le cache hit/miss, l’état de pointe/hors pointe, les nouvelles tentatives et la réponse acceptée sont journalisés. |
DeepSeek est la voie directe du fournisseur la plus propre lorsque votre produit veut un comportement natif DeepSeek et que les vérifications de route ci-dessus passent. Ce n’est pas automatiquement plus sûr simplement parce que l’URL de base est simple.
Vérifications de la route Qwen
Utilisez cette liste de contrôle lorsque Qwen via Model Studio est la route candidate :
| Vérification | Condition de réussite |
|---|---|
| Région | La région autorisée de la charge de travail correspond au point de terminaison Model Studio que vous appelez. |
| Domaine de l’espace de travail | {WorkspaceId} est remplacé par le véritable ID d’espace de travail lorsque cela est requis, et les anciens domaines globaux ne sont pas repris aveuglément. |
| Localité de la clé API | La clé API a été créée dans la même région que le point de terminaison ; les échecs dus à une incompatibilité de région sont classés séparément des échecs dus à une clé invalide. |
| Famille de modèles | La famille de modèles Qwen sélectionnée prend en charge la forme de requête, la longueur de contexte et le mode de sortie utilisés par votre application. |
| Comportement des outils et du streaming | L’appel de fonctions et le streaming sont testés séparément, en particulier parce que Model Studio indique que tools ne peut pas être utilisé simultanément avec stream=True. |
| Protocole multimodal | Qwen-VL, Qwen-Omni et Qwen-Audio sont vérifiés selon le protocole ; Qwen-Audio n’est pas traité comme une route de chat compatible OpenAI. |
| Unité de tarification | Le niveau de jetons d’entrée, les jetons de sortie, le cache de contexte, l’éligibilité à la remise par lot et l’état de promotion sont consignés. |
Qwen est souvent la meilleure voie directe lorsque l’équipe fonctionne déjà sur Alibaba Cloud ou a besoin du modèle région/compte de Model Studio. Il nécessite davantage de preuves de configuration, car la région, l’espace de travail et le périmètre de la clé font partie du contrat d’API.
Matrice de décision
Utilisez cette matrice lorsqu’un décideur demande un gagnant.
| Domaine de décision | Préférer l’API DeepSeek | Préférer l’API Qwen | Préférer Flatkey |
|---|---|---|---|
| Configuration directe | Vous voulez un compte DeepSeek dédié et la famille de modèles DeepSeek actuelle. | Vous utilisez déjà Alibaba Cloud Model Studio. | Vous voulez une seule URL de base compatible OpenAI pour plusieurs familles de modèles. |
| Contrôle régional | Les contrôles de compte DeepSeek direct sont suffisants pour la charge de travail. | La région, l’espace de travail et la propriété régionale de la clé API comptent. | Vous voulez une politique, des journaux et une propriété d’équipe partagée au niveau de la passerelle. |
| Comportement des outils/JSON | Les appels d’outils et la sortie JSON de DeepSeek passent vos tests de parser. | Le function calling et la sortie structurée de Qwen passent vos tests de parser. | Les mêmes tests passent via l’itinéraire Flatkey exact. |
| Routage multimodal | Vous n’avez besoin que des fonctionnalités DeepSeek prises en charge par la ligne sélectionnée. | Vous avez besoin de Qwen-VL, Qwen-Omni ou d’une autre famille Model Studio et avez vérifié son protocole. | Vous voulez comparer les routes texte, image, vidéo ou outils dans une seule couche d’exploitation. |
| Capacité | La concurrence au niveau du compte DeepSeek convient à la charge de travail. | Les quotas Model Studio et la santé régionale conviennent à la charge de travail. | Vous voulez une politique observable de retry/fallback entre fournisseurs. |
| Revue financière | Les unités de cache/pointe/sortie DeepSeek sont faciles à modéliser pour la charge de travail. | Les paliers Qwen, le cache, le batch et la tarification de la console conviennent à la charge de travail. | La finance a besoin d’une vue unique de l’utilisation et d’un seul suivi de facturation/rechargement sur l’ensemble des routes. |
Il n’existe pas de gagnant universel pour DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks. Il existe un itinéraire qui correspond à la charge de travail, à la région, au parseur, au modèle de coûts et au contrat d’exploitation.
Plan de migration pour les équipes déjà en production
Procédez par étapes afin que la qualité du modèle et la disponibilité du routage restent distinctes.
- Établissez la base de référence du route actuel : enregistrez les IDs de modèle, les prompts, les attentes du parseur, la latence, l’utilisation des jetons, les classes d’erreurs, le coût et le responsable.
- Rouvrez la documentation actuelle : consultez les pages DeepSeek sur le modèle/tarification, le premier appel, les fonctionnalités et les limites de débit ; consultez les pages Qwen sur la compatibilité OpenAI, le modèle, la tarification et les fonctionnalités.
- Exécutez des tests en direct chez le fournisseur : utilisez les mêmes prompts et parseurs avec DeepSeek direct et Qwen direct si vous disposez des identifiants.
- Exécutez les tests Flatkey après la recherche de route : confirmez que le modèle exact apparaît dans Flatkey, puis testez via
https://router.flatkey.ai/v1. - Comparez le comportement, pas seulement les réponses : examinez les segments, le JSON d’appel d’outil, la validité de la sortie JSON, les erreurs de contexte, le comportement 401/429, le comportement des timeouts et les champs d’utilisation.
- Déplacez d’abord le trafic à faible risque : commencez par des outils internes, des jobs d’évaluation, des résumés par lots ou une petite partie non critique du produit.
- Validez après relecture : ne déclarez pas la migration terminée tant que le produit, la plateforme et la finance ne peuvent pas inspecter la même preuve de routage.
Ce plan par étapes évite une erreur fréquente : déclarer un modèle gagnant alors que le routage lui-même n’est pas encore éprouvé.
Erreurs courantes
| Mistake | Why it hurts | Better check |
|---|---|---|
| Using old DeepSeek aliases without a date check | Alias mapping can hide behavior changes and confuse cost reviews. | Verify current model names and legacy-name behavior before migration. |
| Treating all Qwen endpoints as one endpoint | Region, workspace domain, and API-key locality can decide whether the call works. | Record endpoint region, workspace ID, and key region. |
| Comparing one token price | Cache hit, cache miss, output length, thinking mode, input tiers, retries, and promotions change real cost. | Review cost per accepted response by workload. |
| Assuming tool parity | Tool-call shape and streaming behavior can differ by provider and model. | Test one real tool call and one streaming run through each route. |
| Publishing a gateway route from a catalog mention | Public catalog discovery is not the same as account-level route readiness. | Run a live Flatkey route test and save the request evidence. |
Recommandation finale
Pour DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks, commencez par la vérité du fournisseur et terminez par la preuve du routage.
Utilisez DeepSeek direct lorsque votre charge de travail correspond à la famille de modèles actuelle de DeepSeek, à son point de terminaison compatible OpenAI, à son ensemble de fonctionnalités, à ses unités de tarification et à son comportement de concurrence. Utilisez Qwen direct lorsque vous avez besoin des familles Qwen de Model Studio, de points de terminaison régionaux, de domaines de workspace ou de contrôles de compte Alibaba Cloud. Utilisez Flatkey lorsque le problème principal est une seule clé, une seule URL de base compatible OpenAI, une preuve d’utilisation partagée, la revue des quotas et une facturation unifiée entre les modèles.
L’étape suivante n’est pas un slogan. Vérifiez la documentation actuelle du fournisseur, consultez le répertoire des modèles et la page de tarification de Flatkey, exécutez les tests de vérification ci-dessus, puis obtenez une clé Flatkey lorsque vous serez prêt à valider un workflow DeepSeek vs Qwen API : vérifications de routage compatibles OpenAI via une seule passerelle. Pour les travaux de déploiement connexes, associez cette checklist au guide de démarrage rapide de l’API Flatkey, au workflow d’API IA unifiée, au guide de migration vers une alternative à l’API OpenAI, au routage régional des fournisseurs de LLM et aux métriques d’API de routage IA.
FAQ
DeepSeek vs Qwen API est-il uniquement une décision de qualité de modèle ?
Non. Les vérifications de routage compatibles OpenAI de DeepSeek vs Qwen API incluent également la forme de l’endpoint, les alias de modèles, la région, l’espace de travail, la localisation de la clé API, les paliers de jetons, le comportement du cache, les appels d’outils, la sortie JSON, le comportement du parseur en streaming, les limites de débit, les journaux et les preuves de facturation.
Quelle API est la moins chère, DeepSeek ou Qwen ?
Cela dépend du modèle exact, de la longueur du prompt, de la longueur de sortie, du comportement du cache, du palier de jetons, du mode de réflexion, des tentatives, de l’itinéraire et du moment de facturation. Utilisez les pages de tarification officielles actuelles et vos journaux d’utilisation réels au lieu de recopier un gagnant statique.
Puis-je utiliser un SDK OpenAI avec les deux fournisseurs ?
Oui. DeepSeek et Model Studio documentent tous deux une utilisation compatible OpenAI, mais l’URL de base, les noms de modèles, les paramètres supplémentaires, les limites fonctionnelles et la configuration du compte diffèrent. Flatkey prend également en charge le modèle SDK OpenAI via https://router.flatkey.ai/v1 pour les modèles pris en charge.
La route compatible OpenAI de Qwen prend-elle en charge toutes les familles de modèles Qwen ?
Non. Alibaba Cloud Model Studio indique que les modèles compatibles OpenAI pris en charge incluent les grands modèles de langage Qwen, Qwen-VL, Qwen-Coder, Qwen-Omni, Qwen-Math, DeepSeek, Kimi, GLM et MiniMax, mais précise séparément que Qwen-Audio ne prend pas en charge le protocole compatible OpenAI et doit utiliser DashScope à la place.
Quel est le premier test Flatkey pour le routage DeepSeek vs Qwen API ?
Commencez par une simple complétion de chat via https://router.flatkey.ai/v1, puis vérifiez l’ID du modèle, le statut, les champs d’utilisation, l’unité de tarification, le streaming, les appels d’outils, la sortie JSON, le comportement en cas d’erreur, le fallback et le chemin de rollback.


