
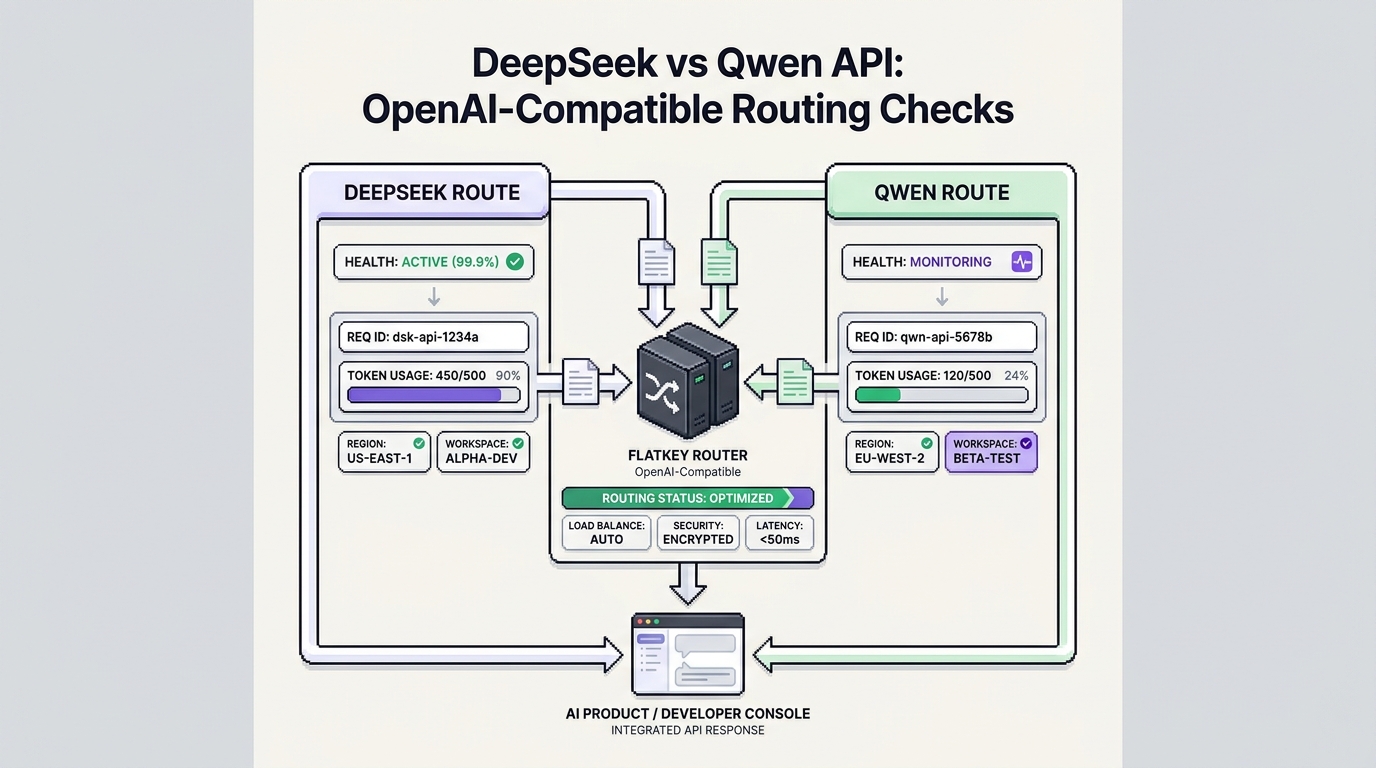
DeepSeek vs Qwen API: OpenAI互換ルーティングの確認という問いは、単なるモデル比較ではありません。プロダクションチームにとっては、どのエンドポイントファミリーをクライアントが呼び出すのか、どのアカウントがキーを所有するのか、どのモデルIDが最新なのか、どの機能がパーサーの期待どおりに動作するのか、そしてトラフィック移行後に使用状況をどこで確認できるのか、というルート準備状況の確認です。
この見方が重要なのは、両プロバイダーともSDK層では似て見えるからです。DeepSeekは、OpenAI形式のベースURLとしてhttps://api.deepseek.comを使うOpenAI互換APIのインターフェースを文書化しています。Alibaba Cloud Model StudioはOpenAI互換のQwenアクセスを文書化していますが、そのベースURLはリージョンやワークスペースによって異なる場合があります。Flatkeyを使う場合、アプリケーションはOpenAI SDKの形を保ったままhttps://router.flatkey.ai/v1を指定できますが、それでも本番対応と呼ぶ前に、正確なDeepSeekまたはQwenのルートを確認する必要があります。
ワークロードの切り替え、フォールバックの追加、共有ゲートウェイの標準化を行う前に、このDeepSeek vs Qwen API: OpenAI互換ルーティングの確認ガイドを実践的なチェックリストとして使ってください。
簡易回答: DeepSeek vs Qwen API のルーティング確認
| ルートの選択 | こういう場合に推奨 | 導入前に確認すること |
|---|---|---|
| Direct DeepSeek API | DeepSeekネイティブの挙動、DeepSeekの最新モデルID、そしてOpenAI互換の専用エンドポイントが必要な場合。 | ベースURL、モデルID、エイリアスのライフサイクル、JSON出力、ツール呼び出し、ストリーミング、画像対応、コンテキスト長、同時実行、429の処理、料金単位。 |
| Model Studio 経由の Direct Qwen API | すでにAlibaba Cloud内で運用している、Qwenのモデルファミリーが必要、またはリージョンとワークスペースの設定を直接管理する必要がある場合。 | リージョンのエンドポイント、ワークスペース固有のドメイン、リージョンに紐づくAPIキー、選択したQwenファミリー、ツール/ストリーミング互換性、トークン階層、キャッシュルール、認証エラー。 |
| Flatkey ゲートウェイルート | 1つのキー、1つのOpenAI互換ベースURL、共通の利用状況レビュー、複数のモデルファミリーにまたがる簡単なルーティングが必要な場合。 | 現在のFlatkeyのモデル行、エンドポイントファミリー、ルートの健全性、リクエストログ、トークン/コスト項目、機能の透過、フォールバックポリシー、ロールバックルート。 |
実務上のDeepSeek vs Qwen API: OpenAI互換ルーティングの確認への答えは、しばしばハイブリッドです。ゲートウェイを通じて検証していないプロバイダー固有の制御が必要な場合は、直接プロバイダールートを使います。より大きな運用課題が、散在するプロバイダーキー、断片化した課金、チームやエージェントごとに繰り返されるSDK変更である場合は、Flatkeyを使います。
最初に確認するプロバイダー情報
すべてのDeepSeek vs Qwen API: OpenAI互換ルーティングの確認レビューは、古いモデル一覧ではなく、最新のプロバイダー文書から始めてください。
DeepSeek は現在、API が OpenAI および Anthropic と互換性のある形式を使用していると文書化しています。初回呼び出しのドキュメントでは、OpenAI 形式の呼び出しには https://api.deepseek.com、Anthropic 形式の呼び出しには https://api.deepseek.com/anthropic が記載されています。現在の models and pricing table では、deepseek-flash と deepseek-v4-pro がアクティブな行として掲載されており、同じページにモデルバージョン、機能サポート、コンテキスト長、最大出力、同時実行制限が示されています。
DeepSeek のライフサイクルに関する注記は重要です。deepseek-v4-flash や deepseek-v4-flash-vision-exp などの旧名称は今でも受け付けられますが、DeepSeek によれば、それらの廃止された名称は新しい Flash モデルによって提供され、課金は Flash の価格で行われます。コード、ゲートウェイポリシー、または評価シートでまだ古い別名を使っている場合は、出力を比較する前にルートチェックを更新してください。
Alibaba Cloud Model Studio 経由の Qwen は、異なる契約から始まります。Model Studio では、Qwen モデルは OpenAI 互換インターフェースをサポートしており、既存の OpenAI コードは API キー、ベース URL、モデル名を変更することで移行できると説明しています。しかし同じドキュメントでは、ベース URL はリージョンに結び付けられており、さらにいくつかのリージョンではワークスペース固有のドメインに結び付けられているとされています。また、Model Studio の API キーは作成されたリージョンに紐付けられており、そのキーで別リージョンのエンドポイントを呼び出すと HTTP 401 の認証エラーが返る場合があるとしています。
これが本質的な違いです。DeepSeek では、最初の問いは通常「現在の DeepSeek モデル ID と機能モードはどれか?」です。Qwen では、最初の問いはしばしば「どのリージョン、ワークスペースドメイン、API キー、モデルファミリーか?」になります。
OpenAI互換は同一を意味しない
「OpenAI-compatible」という表現は移行を加速するためのものです。すべてのエンドポイント、フィールド、ストリーム、エラー、またはツール呼び出しのエッジケースが完全に同一の動作をするという約束ではありません。
| 確認項目 | DeepSeek 直接ルート | Qwen 直接ルート | Flatkey ルート |
|---|---|---|---|
| ベースURL | OpenAI形式のベースURLは https://api.deepseek.com です。 |
互換モードのベースURLは地域によって異なり、{WorkspaceId} を含む場合があります。 |
OpenAI互換のベースURLは https://router.flatkey.ai/v1 です。 |
| チャットエンドポイント | 直接の cURL 例では /chat/completions を使用します。 |
互換モードの例では /chat/completions を使用します。 |
OpenAI互換の通信では /v1/chat/completions を使用します。 |
| モデルID | 現在のドキュメントでは deepseek-flash と deepseek-v4-pro が中心です。旧来の Flash 名も受け付けられますが、内部的には新しい名前にマッピングされます。 |
現在のドキュメントでは qwen3.8-max、qwen3.7-plus、qwen3.8-flash などの Qwen 行が示され、ファミリーごとの動作が記載されています。 |
Flatkey のモデルディレクトリまたはアカウントルートに表示されている、正確なモデルIDを使用してください。 |
| ストリーミング | ストリーミングされたチャンク、アイドル待機、キャンセル、最終的な使用量の処理をテストします。 | Model Studio の例では stream=True と stream_options={"include_usage": True} が示されています。 |
SDK のパーサーが、ゲートウェイ経由でチャンクと最終使用量を正しく処理できることを確認してください。 |
| ツール呼び出し | DeepSeek は、現在の行に対してツール呼び出しをサポートされる機能として文書化しています。 | Model Studio では関数呼び出しが文書化されていますが、OpenAI互換のパラメータ欄では tools と stream=True を同時に使用できないことも記載されています。 |
エージェントがこのルートに依存する前に、実際のツール呼び出しテストを実行してください。 |
| JSON 出力 | DeepSeek は現在の行に対して JSON 出力のサポートを示しています。 | Qwen 互換のパラメータには、レスポンス形式の指定と、モデル固有のサポートに関する注記が含まれます。 | スキーマのパース、無効な JSON の挙動、フォールバックをテストしてください。 |
| ビジョン/音声 | DeepSeek の表では、deepseek-flash はビジョン対応、deepseek-v4-pro は非対応と示されています。 |
Model Studio では Qwen-VL と Qwen-Omni が対応モデルファミリーとして सूची示されていますが、Qwen-Audio は OpenAI互換プロトコルをサポートせず、DashScope を使用すべきと記載されています。 | テキストチャットの通過だけでマルチモーダルの同等性を前提にしないでください。 |
| 容量/エラー | DeepSeek は、アカウントレベルの同時実行数と、上限超過時の HTTP 429 を文書化しています。 | Qwen では、リージョン/キーの不一致により HTTP 401 が返る場合があります。クォータとスロットルはリージョン/アカウントごとにテストすべきです。 | プロバイダ種別、ステータスコード、リトライ、フォールバック理由、レイテンシ、トークン、コストをログに記録してください。 |
これが、DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks の中心的なルールです。プロバイダ名から推測される経路ではなく、実際に実行する経路を検証してください。
ルートを比較する前の価格チェック
経路が互換であっても、ワークロードに対して金銭的に不適切である可能性があります。DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks を 1 つの入力トークン見出しだけで比較しないでください。
DeepSeek の現在の料金ドキュメントでは、課金単位を100万トークンとしており、キャッシュヒット入力、キャッシュミス入力、出力トークンを分けて記載しています。また、ピーク時とオフピーク時の料金を区別し、モデル行の横に同時実行数の制限を示しています。レート制限ドキュメントには、同時実行数はアカウントレベルで計算され、過剰な同時実行は HTTP 429 を返すと記載されています。そのため、DeepSeek のコスト確認は、ログが入力、出力、キャッシュ動作、リクエスト継続時間、429 の発生率を分けている場合にのみ簡単になります。
Model Studio では、モデル API 呼び出しはデフォルトで従量課金であり、料金ドキュメントには標準価格が記載され、プロモーションはコンソールで別途扱われるとしています。また、一部のモデルでは、1 回のリクエストに含まれる入力トークン総数に基づく段階的料金が使われ、コンテキストキャッシュとバッチ割引にはそれぞれ別のルールがあるとしています。つまり、短いチャットリクエスト、10万トークンの検索リクエスト、キャッシュされた繰り返しコンテキストのリクエスト、バッチジョブは、Qwen の異なるコスト枠に入る可能性があります。
ルートを本番に昇格させる前に、このコスト正規化表を使ってください:
| Cost field | Why it changes the decision | What to log |
|---|---|---|
| Input tokens | Qwen tiers and DeepSeek cache-miss inputs can change effective cost. | Prompt tokens, input tier, cache miss tokens, model ID. |
| Cached tokens | Cache discounts only help when the workload repeats stable context and the route exposes evidence. | Cache hit tokens, cache write tokens, cache policy, request family. |
| Output tokens | Long answers and reasoning/thinking outputs can dominate the bill. | Completion tokens, reasoning/thinking tokens if returned, output limit. |
| Peak/off-peak or promotion state | Published provider pages can separate standard prices from time-based or console promotions. | Billing time, price source date, route owner. |
| Retry/fallback cost | Failed attempts and fallback attempts can erase apparent token savings. | Attempt count, retry reason, fallback model, accepted response flag. |
Flatkey でも、同じ дисципline を維持してください。現在のモデルディレクトリと料金ページを確認し、次にログでリクエストレベルの使用量を検証します。公開モデルの記載は、発見には役立ちます。運用上の判断には、成功したルートテストと読みやすい台帳が必要です。
Flatkeyルートのチェックリスト
Flatkey は DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks を中心に運用ワークフローを変えます。これにより、チームは対応モデルとツール全体で、1 つの OpenAI 互換クライアント表面、1 つの Flatkey キー、1 つの利用状況レビュー層を維持できます。Flatkey のクイックスタートでは OpenAI 互換のリクエストパスが示され、OpenAI SDK ガイドでは base_url の設定が示されています。Flatkey はプロバイダー固有の要件を隠すべきではありません。
Flatkey ルートが本番トラフィックを受ける前に、この手順を使用してください:
- 現在の Flatkey モデルディレクトリを開き、DeepSeek または Qwen の正確なモデル ID を検索します。
- エンドポイントファミリーがワークロードに適切であることを確認します。この記事では通常、OpenAI 互換の chat を使用します。
- モデルが現在のアカウントルートに表示されていることを確認します。古い記事やスクリーンショットにだけある状態ではいけません。
https://router.flatkey.ai/v1/chat/completions経由で通常の chat リクエストを送信します。- 直接の認証情報がある場合は、同じ通常のリクエストを直接プロバイダールート経由でも送信します。
- streaming、1 回の tool call、1 回の JSON 出力テスト、1 つの長文コンテキストサンプル、1 つの強制エラーで繰り返します。
- request ID、provider class、model ID、status code、latency、usage fields、cost fields、fallback reason、key owner、rollback model を保存します。
以下は最小限の Flatkey スモークテストです:
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-verified-deepseek-or-qwen-model-id",
    "messages": [
      {
        "role": "user",
        "content": "このルートが生きていることを確認する 1 文を返してください。"
      }
    ]
  }'
そのリクエストが model-not-found、unsupported endpoint、HTTP 401、HTTP 429、timeout、または parser failure で失敗しても、このテストには価値があります。実際のトラフィックを流す前に、アカウント、モデル ID、エンドポイントファミリー、キーのスコープ、クォータ、またはリクエスト形状の修正が必要だと分かるからです。
DeepSeekルートの確認
DeepSeek が候補ルートの場合は、このチェックリストを使用します:
| Check | Pass condition |
|---|---|
| Current model ID | ルートが deepseek-flash または deepseek-v4-pro を使用している、またはチームが DeepSeek のレガシー名マッピング動作を明示的に受け入れていること。 |
| Endpoint family | アプリが意図した DeepSeek のエンドポイントファミリー、つまり OpenAI 形式または Anthropic 形式を呼び出していること。 |
| Feature support | JSON 出力、tool call、Responses API、Anthropic API、beta prefix completion、FIM、vision は、ワークロードでそれらを使用する場合にのみテストされていること。 |
| Thinking/non-thinking behavior | 選択されたモードが、評価とログ記録のために十分に明示的であること。 |
| Concurrency | アカウントレベルの concurrency とユーザーごとの分離動作を理解していること。429 の処理をテストしていること。 |
| Long request behavior | timeout、streaming、keep-alive、max-output の挙動を実際のワークロードサイズでテストしていること。 |
| Usage and cost | input、output、cache hit/miss、peak/off-peak state、retries、accepted response がログに記録されていること。 |
製品が DeepSeek ネイティブの挙動を求め、かつ上記のルートチェックを満たす場合、DeepSeek はよりクリーンな直接プロバイダーパスです。ベース URL がシンプルだからといって、自動的により安全になるわけではありません。
Qwenルートの確認
Model Studio 経由の Qwen が候補ルートの場合は、このチェックリストを使用します:
| 確認項目 | 合格条件 |
|---|---|
| リージョン | ワークロードの許可リージョンが、呼び出す Model Studio エンドポイントと一致している。 |
| ワークスペースドメイン | {WorkspaceId} が必要な箇所で実際のワークスペース ID に置き換えられており、古い/グローバルなドメインがそのまま盲目的に引き継がれていない。 |
| APIキーの所在地 | APIキーがエンドポイントと同じリージョンで作成されている。リージョン不一致の失敗は、無効なキーによる失敗とは別に分類される。 |
| モデルファミリー | 選択した Qwen モデルファミリーが、アプリで使用するリクエスト形式、コンテキスト長、出力モードをサポートしている。 |
| ツールとストリーミングの挙動 | Function calling と streaming は個別にテストされる。特に Model Studio の注記では、tools は stream=True と同時に使用できないため。 |
| マルチモーダルプロトコル | Qwen-VL、Qwen-Omni、Qwen-Audio はプロトコルごとに確認される。Qwen-Audio は OpenAI 互換の chat route として扱われない。 |
| 料金単位 | 入力トークンの階層、出力トークン、コンテキストキャッシュ、バッチ割引の適用可否、プロモーション状態が記録される。 |
チームがすでに Alibaba Cloud 上で運用している、または Model Studio のリージョン/アカウントモデルが必要な場合、Qwen はしばしばより有力な直接ルートです。リージョン、ワークスペース、キーのスコープが API 契約の一部であるため、より多くの設定検証が必要です。
判断マトリクス
関係者から勝者を求められたときは、このマトリクスを使ってください。
| 判断領域 | DeepSeek API を優先 | Qwen API を優先 | Flatkey を優先 |
|---|---|---|---|
| 直接セットアップ | DeepSeek に特化したアカウントと、現在の DeepSeek モデルファミリーが欲しい。 | すでに Alibaba Cloud Model Studio を使用している。 | 複数のモデルファミリーに対して、1つの OpenAI 互換ベース URL を使いたい。 |
| リージョン制御 | ワークロードには DeepSeek アカウントレベルの制御で十分である。 | リージョン、ワークスペース、リージョン別 API キーの所有権が重要である。 | ゲートウェイレベルのポリシー、ログ、共有チーム所有権が欲しい。 |
| ツール/JSON の挙動 | DeepSeek の tool 呼び出しと JSON 出力がパーサーテストに合格する。 | Qwen の function calling と構造化出力がパーサーテストに合格する。 | 同じテストが、正確な Flatkey 経由のルートで通過する。 |
| マルチモーダルルーティング | 選択した行でサポートされる DeepSeek 機能だけが必要である。 | Qwen-VL、Qwen-Omni、または別の Model Studio ファミリーが必要で、そのプロトコルを確認済みである。 | テキスト、画像、動画、またはツールのルートを1つの運用層で比較したい。 |
| 容量 | DeepSeek のアカウントレベルの同時実行数がワークロードに適している。 | Model Studio のクォータとリージョンの健全性がワークロードに適している。 | プロバイダー横断で、可観測なリトライ/フォールバック方針が欲しい。 |
| 財務レビュー | DeepSeek の cache/peak/output 単位がワークロード向けにモデル化しやすい。 | Qwen の階層、キャッシュ、バッチ、コンソール料金がワークロードに適している。 | 財務部門には、ルート横断で1つの利用ビューと1つの請求/チャージ履歴が必要である。 |
普遍的な DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks の勝者はありません。ワークロード、リージョン、パーサー、コストモデル、運用契約に合うルートがあります。
既に本番運用しているチーム向けの移行計画
モデル品質とルートの準備状況を切り分けたまま、段階的に移行します。
- 現在のルートをベースライン化する: モデルID、プロンプト、パーサーの期待値、レイテンシ、トークン使用量、エラー種別、コスト、担当者を保存します。
- 現在のドキュメントを再確認する: DeepSeek のモデル/料金、初回呼び出し、機能、レート制限のページを確認し、Qwen の OpenAI互換、モデル、料金、機能のページを確認します。
- 直接プロバイダーでテストする: 認証情報があるなら、同じプロンプトとパーサーを直接 DeepSeek と直接 Qwen に対して使います。
- ルート検索後に Flatkey でテストする: 正確なモデルが Flatkey に表示されることを確認し、その後
https://router.flatkey.ai/v1経由でテストします。 - 回答だけでなく挙動を比較する: チャンク、ツール呼び出し JSON、JSON 出力の妥当性、コンテキストエラー、401/429 の挙動、タイムアウト時の挙動、usage フィールドを確認します。
- まず低リスクのトラフィックを移す: 社内ツール、eval ジョブ、バッチ要約、または非クリティカルな小さな製品範囲から始めます。
- 読み戻し後に本番化する: 製品、プラットフォーム、財務が同じルート証跡を確認できるようになるまで、移行完了とは言わないでください。
この段階的な計画はよくある誤りを防ぎます。つまり、ルート自体がまだ検証されていないのに、モデルを勝者と宣言してしまうことです。
よくある誤り
| 誤り | なぜ問題か | より良い確認方法 |
|---|---|---|
| 日付確認なしで古い DeepSeek エイリアスを使う | エイリアスのマッピングによって挙動の変更が隠れ、コストレビューが混乱することがあります。 | 移行前に現在のモデル名と旧名の挙動を確認します。 |
| すべての Qwen エンドポイントを 1 つのエンドポイントとして扱う | リージョン、ワークスペースドメイン、API キーのローカル性が、呼び出しが成功するかどうかを左右します。 | エンドポイントのリージョン、ワークスペース ID、キーのリージョンを記録します。 |
| 1 つのトークン価格だけを比較する | キャッシュヒット、キャッシュミス、出力長、thinking モード、入力階層、再試行、プロモーションによって実コストは変わります。 | ワークロードごとに、受理されたレスポンスあたりのコストを確認します。 |
| ツールの互換性を前提にする | ツール呼び出しの形状とストリーミング挙動は、プロバイダーやモデルによって異なることがあります。 | 各ルートで、実際のツール呼び出し 1 回とストリーミング実行 1 回をテストします。 |
| カタログへの言及だけでゲートウェイルートを公開する | 公開カタログで見つかることと、アカウントレベルでルートが使えることは同じではありません。 | ライブの Flatkey ルートテストを実行し、リクエスト証跡を保存します。 |
最終推奨
DeepSeek vs Qwen API: OpenAI-Compatible Routing Checks では、まずプロバイダーの事実を確認し、最後にルートの証跡で確定します。
DeepSeek 直結は、ワークロードが DeepSeek の現在のモデルファミリー、OpenAI 互換エンドポイント、機能セット、料金単位、同時実行挙動に合う場合に使います。Qwen 直結は、Model Studio の Qwen ファミリー、リージョンエンドポイント、ワークスペースドメイン、または Alibaba Cloud のアカウント制御が必要な場合に使います。Flatkey は、1 つのキー、1 つの OpenAI 互換 base URL、共有利用証跡、クォータ確認、モデル横断の統合請求がより重要な場合に使います。
次のステップはスローガンではありません。現在のプロバイダードキュメントを確認し、Flatkey の モデルディレクトリ と 料金ページ を確認し、上記のスモークテストを実行してから、1つのゲートウェイを通じた DeepSeek vs Qwen API: OpenAI互換ルーティングの確認 ワークフローを検証する準備ができたら Flatkey のキーを取得してください。隣接するロールアウト作業では、このチェックリストを Flatkey API クイックスタート、統合 AI API ワークフロー、OpenAI API 代替移行ガイド、地域別 LLM プロバイダールーティング、および AI ルーティング API メトリクス と組み合わせてください。
FAQ
DeepSeek vs Qwen API はモデル品質だけの判断ですか?
いいえ。DeepSeek vs Qwen API: OpenAI互換ルーティングの確認 には、エンドポイントの形、モデル別名、リージョン、ワークスペース、API キーのローカリティ、トークン階層、キャッシュ挙動、ツール呼び出し、JSON 出力、ストリーミングパーサーの挙動、レート制限、ログ、請求の証跡も含まれます。
DeepSeek と Qwen のどちらの API が安いですか?
それは、正確なモデル、プロンプト長、出力長、キャッシュ挙動、トークン階層、thinking モード、再試行、ルート、請求時刻によって異なります。固定の勝者を流用するのではなく、最新の公式料金ページと実際の使用ログを使ってください。
両方のプロバイダーで OpenAI SDK を使えますか?
はい。DeepSeek と Model Studio はどちらも OpenAI 互換の利用を文書化していますが、ベース URL、モデル名、追加パラメータ、機能上の注意点、アカウント設定は異なります。Flatkey も、対応モデルについては https://router.flatkey.ai/v1 を通じて OpenAI SDK パターンをサポートしています。
Qwen の OpenAI 互換ルートはすべての Qwen モデルファミリーをサポートしていますか?
いいえ。Alibaba Cloud Model Studio によると、サポートされる OpenAI 互換モデルには Qwen の大規模言語モデル、Qwen-VL、Qwen-Coder、Qwen-Omni、Qwen-Math、DeepSeek、Kimi、GLM、MiniMax が含まれますが、Qwen-Audio は OpenAI 互換プロトコルをサポートしておらず、代わりに DashScope を使用するよう別途案内されています。
DeepSeek vs Qwen API ルーティングにおける最初の Flatkey テストは何ですか?
まず https://router.flatkey.ai/v1 を通じた通常のチャット補完から始め、次に model ID、status、usage フィールド、価格単位、ストリーミング、ツール呼び出し、JSON 出力、エラー挙動、フォールバック、ロールバックパスを検証してください。


