
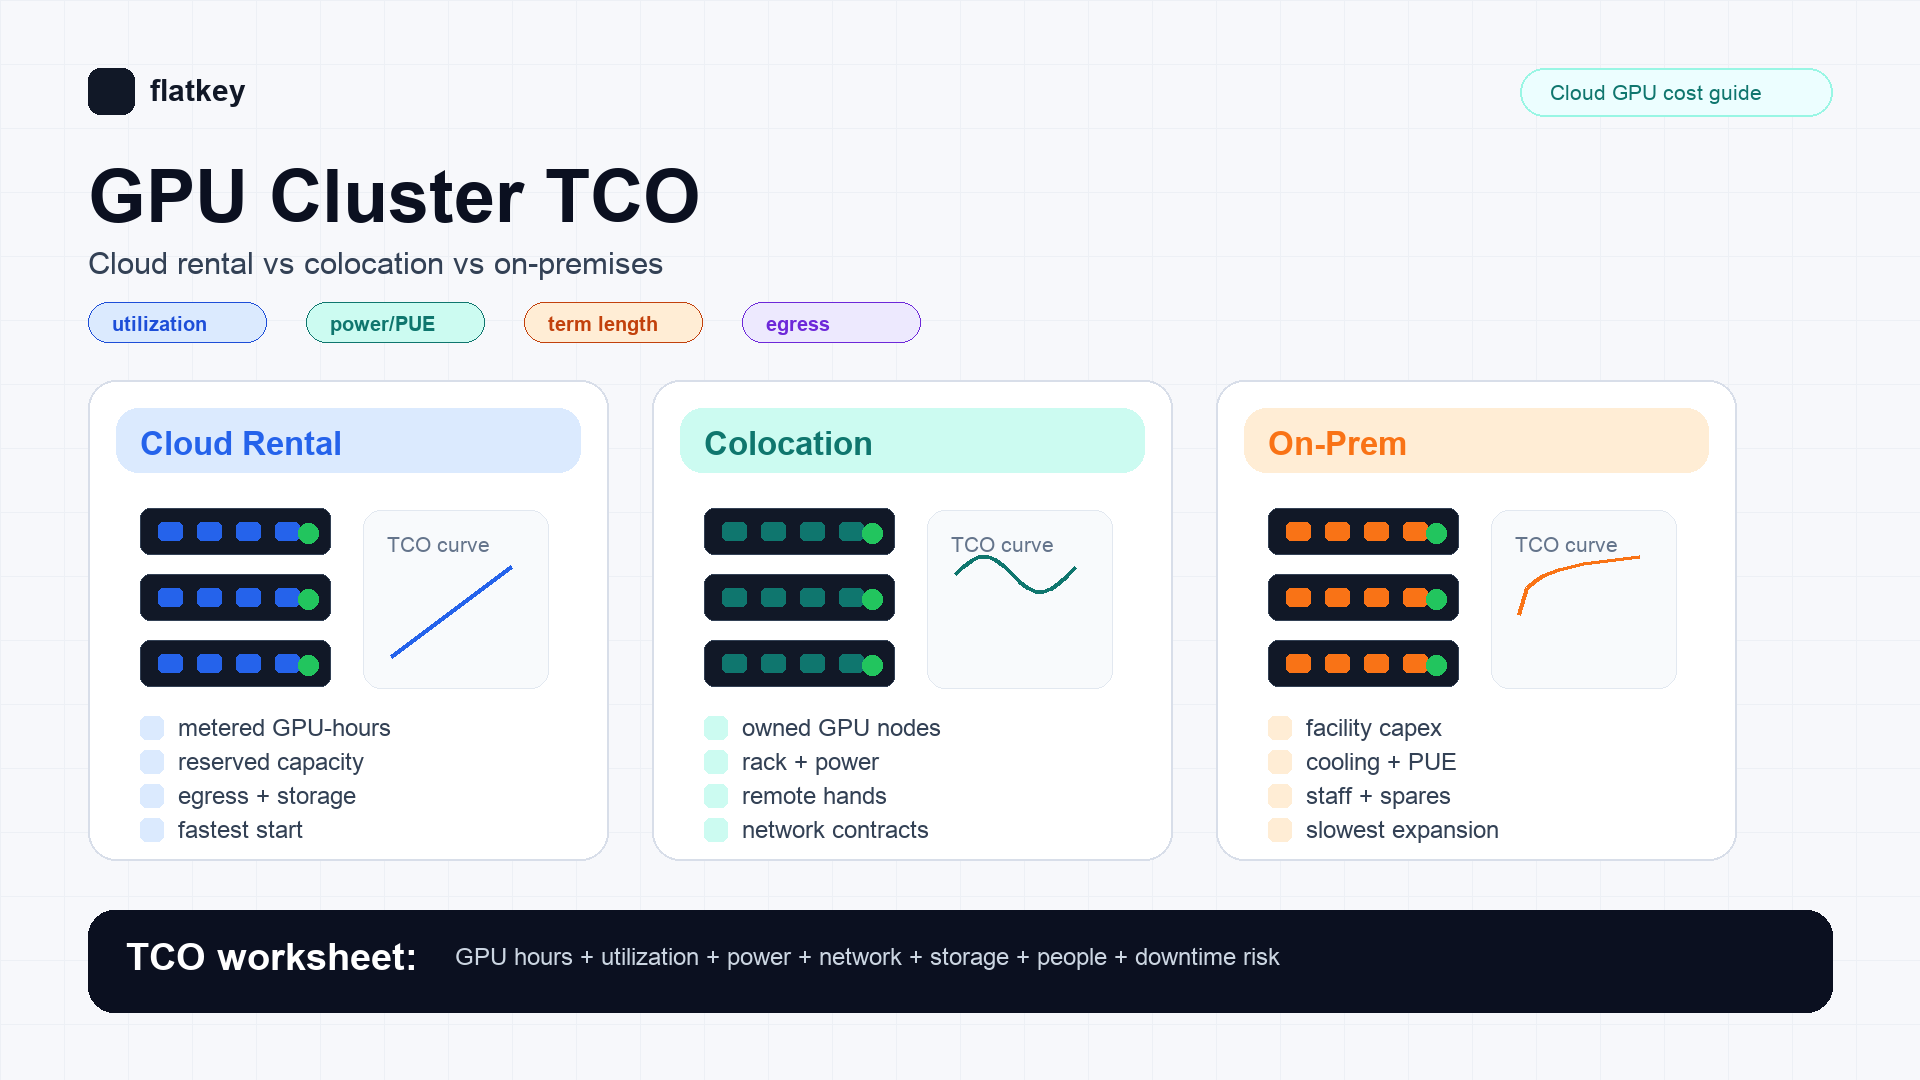
La plupart des comparaisons de TCO de clusters GPU échouent pour la même raison : elles comparent un tarif horaire cloud à un bon de commande matériel. Ce n’est pas la bonne décision.
La vraie décision est de savoir si votre équipe IA doit acheter de la flexibilité, acheter du matériel ou acheter le contrôle de l’infrastructure. Un modèle sérieux de TCO pour un cluster GPU doit normaliser la location cloud, la colocation et l’on-premises autour du même résultat : des entraînements terminés, des jetons d’inférence acceptés, des tâches de génération de médias ou des mois de capacité réservée.
Pour la plupart des équipes, la location de GPU cloud l’emporte lorsque l’utilisation est incertaine, que la rapidité de lancement compte ou que la charge de travail varie selon la famille de modèles. La colocation commence à l’emporter lorsque la demande est stable, que l’équipe peut exploiter le matériel et que le contrat est suffisamment long pour amortir les GPU, le réseau, les pièces de rechange et les interventions à distance. L’on-premises nécessite généralement la justification la plus solide : une utilisation très élevée et prévisible, des opérations de data center déjà en place, des exigences strictes de proximité des données ou une directive stratégique visant à posséder la couche infrastructure.
Règle pratique de Flatkey : commencez par la charge de travail, pas par le rack. Si la charge peut être servie par une API de modèle managée, comparez d’abord cette option. Si vous avez réellement besoin de GPU dédiés, évaluez la location cloud, la colocation et l’on-premises avec la même feuille de calcul avant de signer un contrat de capacité.
Réponse rapide sur le TCO d’un cluster GPU
Utilisez ce tableau de décision initial avant de construire le modèle complet.
| Situation | Commencer généralement par | Pourquoi |
|---|---|---|
| Prototype, fine-tuning par pics, courte fenêtre de benchmark | Location de GPU cloud | Engagement minimal et chemin le plus rapide vers la capacité. |
| Flotte d’inférence stable sur plusieurs mois avec mélange de modèles connu | Capacité réservée cloud ou colocation | L’utilisation est suffisamment élevée pour négocier une tarification contractuelle, mais le risque de possession peut encore être évité. |
| Grands travaux d’entraînement avec exigences strictes de topologie réseau | Cluster cloud dédié ou colocation | Vous avez besoin d’un placement de nœuds prévisible, d’un fabric réseau, de la proximité du stockage et d’une validation des benchmarks. |
| Utilisation pluriannuelle au-dessus de votre taux de rentabilité interne | Colocation ou on-premises | L’amortissement du matériel ne peut battre la location horaire que si le temps d’inactivité, les opérations, l’électricité et les interruptions sont comptés honnêtement. |
| Localité des données réglementée ou obligation de contrôle de l’infrastructure | On-premises ou colocation contrôlée | La décision de TCO inclut la conformité et le contrôle, pas seulement le prix du calcul. |
| L’application n’a besoin que des sorties du modèle, pas du contrôle du GPU | API de modèle ou devis du marché GPU | Acheter un cluster peut être excessif lorsque l’indicateur métier est le coût par sortie acceptée. |
Le reste de ce guide montre comment construire une feuille de calcul de TCO de cluster GPU que les équipes achats, plateforme et finance peuvent toutes utiliser.
Normaliser chaque option sur une seule unité
Ne comparez pas « H100 par heure » à « prix d’achat du serveur ». Choisissez un dénominateur et forcez chaque option à s’y conformer.
Les dénominateurs utiles incluent :
- Coût par entraînement terminé : idéal pour le fine-tuning périodique, les expérimentations de préentraînement et les jobs batch.
- Coût par sortie acceptée : idéal pour l’inférence LLM, la génération de code, la génération d’images et les pipelines vidéo où les relances comptent.
- Coût par mois-GPU réservé : idéal pour les équipes plateforme achetant de la capacité interne pour plusieurs équipes produit.
- Coût par jeton ou job qualifié SLA : idéal lorsque les interruptions, les préemptions ou le délai de file d’attente modifient la fiabilité côté utilisateur.
Pour l’inférence, le dénominateur le plus propre est souvent :
effective_cost_per_accepted_output =
  total_monthly_cluster_cost
  / accepted_outputs_after_retries_and_quality_filters
Ce dénominateur met en évidence deux éléments que le prix horaire masque : les jobs échoués et la capacité inutilisée.
Formule de TCO d’un cluster GPU
Utilisez ce modèle avant d’ajouter des détails propres au fournisseur :
monthly_gpu_cluster_tco =
  capacity_cost
  + storage_cost
  + data_transfer_cost
  + network_and_interconnect_cost
  + software_and_observability_cost
  + labor_and_operations_cost
  + support_and_warranty_cost
  + financing_or_depreciation_cost
  + downtime_and_retry_waste
Ensuite, convertissez-le dans l’unité qui vous intéresse :
unit_cost =
  monthly_gpu_cluster_tco
  / useful_work_completed_per_month
Cela compte parce qu’une heure GPU bon marché peut rester coûteuse si le cluster est sous-utilisé, si les jobs attendent dans la file, si le stockage se trouve dans la mauvaise région ou si les exécutions échouées consomment du temps au plein tarif.
Composants de coût par modèle de déploiement
| Ligne de coût | Location cloud | Colocation | On-premises |
|---|---|---|---|
| Capacité GPU | À la demande, spot, réservé, dédié ou sur devis du marché. | Achat ou location du matériel plus contrat de rack. | Achat ou location du matériel plus allocation interne des installations. |
| Énergie et refroidissement | Généralement intégrés au tarif, mais pas gratuits. | Électricité contractualisée, électricité mesurée, surcharge de refroidissement et limites de densité de puissance. | Électricité du réseau, onduleur, générateur, installation de refroidissement et exposition au PUE. |
| Réseau | Sortie de données, liaisons privées, IP publiques, trafic inter-régions, interconnexion. | Transit, cross-connects, liaisons privées, accès distant, services DDoS/sécurité. | WAN, transit internet, liaisons privées, pare-feu, commutation, chemins redondants. |
| Stockage | Bloc, objet, système de fichiers, instantanés, sauvegardes, niveaux d’IOPS. | NVMe local, stockage partagé, cible de sauvegarde, réplication distante. | Matériel de stockage, sauvegarde, réplication, remplacement des supports, opérations de cycle de vie. |
| Opérations | Principalement intégration de la plateforme et contrôles des coûts. | Cycle de vie du matériel, assistance à distance, tests d’acceptation, pièces de rechange, coordination des RMA. | Opérations complètes des installations et du matériel, accès physique, pièces de rechange, couverture hors heures ouvrées. |
| Risque d’engagement | Faible pour la demande à la demande ; plus élevé pour les contrats réservés ou dédiés. | Moyen à élevé. La sortie de contrat et la revente du matériel comptent. | Le plus élevé. Les décisions sur les installations et l’équipement peuvent dépasser la feuille de route du modèle. |
La location cloud paraît simple parce que de nombreux coûts sont intégrés au tarif. La colocation et l’on-premises semblent moins chères quand le tableur oublie les coûts humains, l’énergie, le réseau et le budget des pannes.
Location cloud : ce qu’il faut compter
La location cloud est la base la plus propre pour le TCO d’un cluster GPU, car elle transforme la capacité en service mesuré. Cela ne signifie pas que le tarif horaire est le coût total.
À compter :
- Tarif horaire de l’instance GPU ou du bare metal.
- Conditions de capacité réservée, engagée ou dédiée.
- Stockage attaché au cluster.
- Stockage objet et conservation des instantanés.
- Transfert de données et sortie de données.
- Réseau privé, équilibreurs de charge, IP publiques et NAT.
- Orchestrateur, Kubernetes, Slurm, observabilité, journalisation et alerting.
- Temps d’inactivité lié aux files d’attente, aux déploiements échoués, aux démarrages à froid et à un mauvais bin packing.
- Gaspillage lié aux tentatives sur spot ou interrompables, le cas échéant.
- Plan de support et coûts de gestion de compte.
La location cloud l’emporte généralement lorsque la courbe de demande de l’équipe est incertaine. Elle fournit aussi aux achats un point de référence de prix actuel. Les pages publiques des fournisseurs AWS, Google Cloud, Lambda, RunPod et d’autres clouds GPU sont utiles comme vérifications de source, mais le seul chiffre qui compte pour un grand cluster est le devis que vous pouvez réellement réserver pour la région, la topologie et la durée dont vous avez besoin.
Utilisez les pages officielles comme points de contrôle :
- AWS décrit l’infrastructure de classe P5 pour les charges de travail IA à grande échelle sur sa page d’instances EC2 P5.
- Google Cloud publie les tarifs GPU et précise que les prix dépendent du type de GPU, de la région et du modèle d’utilisation.
- Lambda et RunPod publient des grilles de prix de cloud GPU utiles pour des vérifications rapides du marché.
- Flatkey Compute publie un indice en direct du prix par heure GPU et permet aux acheteurs de publier des demandes anonymes de GPU auxquelles des fournisseurs vérifiés peuvent répondre par des offres.
Traitez chaque prix comme horodaté. La disponibilité des GPU et les tarifs horaires évoluent plus vite que les tarifs SaaS ordinaires.
Colocation : ce qu’il faut compter
La colocation n’est pas simplement « le cloud, mais moins cher ». Elle transfère une grande partie de la charge opérationnelle du fournisseur vers votre équipe.
À compter :
- Serveurs GPU, adaptateurs réseau, switches, optiques, câbles et stockage.
- Frais de rack ou de cage.
- Électricité contractualisée et électricité mesurée.
- Refroidissement et limitations de densité.
- Cross-connects, transit internet, liaisons privées et sécurité réseau.
- Assistance à distance, expédition, réception, installation, inventaire et gestion des RMA.
- GPU de rechange, alimentations, NIC, optiques, ventilateurs et disques de stockage.
- Amortissement du matériel, coût de location, coût de financement et hypothèses de revente.
- SLA des installations, fenêtres de maintenance et procédures d’accès.
- Opérations de plateforme : images, pilotes, pile CUDA, Kubernetes ou Slurm, observabilité, correctifs de sécurité et réponse aux incidents.
La colocation commence à avoir du sens lorsque l’utilisation est prévisible et élevée, que l’équipe dispose de réelles compétences en exploitation d’infrastructure et que le contrat offre une densité de puissance suffisante pour la génération de GPU que vous prévoyez d’exploiter. Elle échoue lorsque les équipes achètent le matériel mais sous-estiment l’assistance à distance, le réseau, les contraintes d’alimentation, les pièces de rechange et une montée en capacité lente.
Pour les clusters GPU, le fabric réseau est souvent le poste qui détermine l’architecture. Un cluster qui nécessite un entraînement étroitement couplé n’est pas équivalent à un ensemble de nœuds d’inférence isolés. Si la charge de travail dépend d’InfiniBand, de RoCE, de NVLink, de NVSwitch ou d’une disposition de stockage spécifique, incluez-le dans le devis et le test d’acceptation.
On-premises : ce qu’il faut compter
Le TCO d’un cluster GPU on-premises doit être traité comme un projet d’infrastructure, pas comme un achat de serveur.
À compter :
- Tout ce qui figure dans le modèle de colocation.
- Allocation d’espace dans la salle informatique ou travaux d’aménagement.
- Travaux électriques, UPS, générateur, distribution électrique et suppression d’incendie.
- Capacité et maintenance de l’installation de refroidissement.
- Sécurité physique et contrôle d’accès.
- Personnel des installations et escalade hors heures ouvrées.
- Assurance, audits de conformité et procédures de sécurité.
- Planification capacitaire à long terme pour la prochaine génération de GPU.
- Coût d’opportunité du capital immobilisé dans les installations et le matériel.
Le on-premises peut se justifier pour les organisations disposant déjà d’une solide infrastructure de centre de données, d’un taux d’utilisation élevé, d’exigences strictes de localisation ou d’un mandat de contrôle stratégique. C’est le choix le plus faible lorsque l’équipe est encore en train de découvrir le mix de modèles, la longueur de contexte, la cible de débit et l’adéquation produit-marché.
Le risque caché est le renouvellement des générations de GPU. Une décision d’implantation peut durer plus longtemps que l’architecture de modèle que vous servez. Si votre TCO dépend du maintien de la domination d’une famille de modèles pendant trois ans, mettez cette hypothèse à l’épreuve.
Utilisation au point mort
La question centrale du point mort est :
required_utilization =
  owned_monthly_cost
  / equivalent_cloud_monthly_cost_at_100_percent_use
Si l’infrastructure détenue coûte X $ par mois et que la location cloud équivalente à 100 % d’utilisation coûte Y $ par mois, alors la propriété ne fonctionne que si l’utilisation utile est supérieure à X / Y. L’utilisation utile désigne le travail qui aurait autrement été payé. Elle exclut les ressources inactives, les tâches échouées, les marges de file d’attente et la capacité réservée pour de rares pics.
Exécutez le modèle selon trois scénarios :
| Scénario | Ce qu’il faut tester |
|---|---|
| Cas de base | Charge de travail attendue, utilisation attendue, durée attendue. |
| Cas défavorable | Utilisation plus faible, mise en production du produit retardée, revente plus faible, coût de l’électricité plus élevé, acceptation plus lente. |
| Cas de stress | Le nouveau modèle ne tient pas en mémoire, la topologie réseau est incorrecte, ou la demande bascule vers une API managée. |
Si le cas défavorable détruit l’économie du projet, la location cloud ou un contrat dédié plus court constitue généralement la première étape la plus sûre.
Feuille de calcul TCO de cluster GPU à copier
Utilisez cette feuille de calcul dans votre document d’achat. Remplissez-la une fois pour la location cloud, une fois pour la colocation, et une fois pour le on-premises.
| Champ | Location cloud | Colocation | On-premises |
|---|---|---|---|
| Modèle et nombre de GPU | |||
| Durée du contrat | |||
| Utilisation utile attendue | |||
| Coût mensuel de capacité GPU | |||
| Stockage et sauvegarde | |||
| Transfert de données et réseau | |||
| Énergie et refroidissement | Inclus ou chiffré | ||
| Allocation de rack, cage ou installation | S/O | ||
| Amortissement ou location du matériel | S/O | ||
| Intervention à distance / personnel | |||
| Support, garantie et pièces de rechange | |||
| Observabilité et outils de plateforme | |||
| Temps d’arrêt et gaspillage des relances | |||
| TCO mensuel estimé | |||
| Dénominateur du coût unitaire | |||
| Coût par sortie acceptée | |||
| Délai de mise à l’échelle | |||
| Coût de sortie |
Ne sautez pas les deux dernières lignes. Le délai de mise à l’échelle et le coût de sortie sont les points où une économie matérielle séduisante devient souvent coûteuse.
Questions d’achat à poser à chaque fournisseur
Pour la location cloud :
- La capacité proposée est-elle mutualisée, réservée, dédiée ou bare metal ?
- Quelle région, quelle zone de disponibilité et quel placement des nœuds sont garantis ?
- Quel modèle exact de GPU, quelle quantité de mémoire, quel interconnect, quel CPU, quelle RAM, quel stockage local et quelle infrastructure réseau sont inclus ?
- Le stockage, les snapshots, le stockage objet, la bande passante, les IP publiques et le support sont-ils inclus ?
- Que se passe-t-il si le cluster est indisponible pendant la durée du contrat ?
- Le fournisseur peut-il exécuter un benchmark d’acceptation avant le début de l’engagement ?
- Comment les tâches échouées, les pannes de la plateforme et les fenêtres de maintenance sont-elles créditées ?
Pour la colocation :
- Quelle densité de puissance est contractualisée par rack ?
- L’électricité est-elle mesurée, engagée ou intégrée au prix du rack ?
- Quelles interventions remote hands sont incluses, et lesquelles sont facturables ?
- Quels opérateurs et liaisons privées sont disponibles ?
- À quelle vitesse des racks, de la puissance et des cross-connects supplémentaires peuvent-ils être provisionnés ?
- Qui est propriétaire des pièces de rechange, des RMA et de la maintenance du firmware ?
- Quel test d’acceptation confirme que le cluster est prêt pour la production ?
Pour le on-premises :
- Le site prend-il déjà en charge la densité de puissance cible ?
- Une capacité de refroidissement est-elle disponible sans travaux d’extension ?
- Qui est responsable de la réponse matérielle 24 h/24 et 7 j/7 ?
- Quel est le circuit d’approbation pour les changements électriques, réseau et sécurité ?
- Quelle est la période d’amortissement, et quelle valeur de revente est supposée ?
- Que se passe-t-il si le prochain modèle nécessite plus de mémoire, plus de bande passante ou une pile de service différente ?
Matrice de décision
| Critère | Location cloud | Colocation | On-premises |
|---|---|---|---|
| Vitesse de démarrage | Meilleure | Moyenne | La plus lente |
| Capital initial | Le plus faible | Moyen à élevé | Le plus élevé |
| Charge opérationnelle | La plus faible | Moyenne | La plus élevée |
| Économie de l’utilisation soutenue à long terme | Moyenne | Solide si bien exploité | Solide uniquement avec une certaine maturité des installations |
| Flexibilité selon la génération de GPU | Meilleure | Moyenne | La plus faible |
| Contrôle des installations | Faible | Moyen | Le plus élevé |
| Réversibilité des achats | Meilleure | Moyenne | La plus faible |
| Exigence de benchmark | Important | Critique | Critique |
La réponse la plus défendable est rarement « toujours cloud » ou « toujours acheter ». Il s’agit généralement d’une approche par phases : louer pour la découverte, réserver pour la demande stable, passer en colocation lorsque l’utilisation est prouvée, et passer en on-premises uniquement lorsque le contrôle des installations fait partie de l’exigence.
Erreurs courantes dans les modèles de TCO de cluster GPU
Comparer le prix catalogue au meilleur cas de possession
Un modèle de TCO de cluster GPU équitable compare des devis réels à un coût de possession réel. Le prix catalogue du cloud n’est pas la même chose qu’une capacité réservée ou négociée. Le prix d’achat du matériel n’est pas le même que le coût du cluster exploité.
Ignorer l’utilisation
Un cluster détenu avec 40 % d’utilisation utile peut être moins rentable qu’un cluster cloud avec un tarif horaire bien plus élevé. Mesurez le travail utile, pas les GPU installés.
Considérer la topologie réseau comme un détail secondaire
Le nombre de GPU seul ne définit pas un cluster. L’entraînement, le fine-tuning et l’inférence à haut débit peuvent avoir des exigences réseau et de stockage très différentes.
Oublier le gaspillage lié aux reprises
Les reprises, les déploiements échoués, les préemptions et les sorties de faible qualité augmentent tous le coût unitaire. Intégrez le gaspillage lié aux reprises dans le dénominateur, pas seulement dans le numérateur.
Sous-estimer le coût des personnes
Les pilotes, les versions de CUDA, les images de conteneurs, les ordonnanceurs, la supervision, les mises à jour du firmware, la sécurité et la réponse aux incidents font partie du TCO d’un cluster GPU. Quelqu’un les paie, même s’ils n’apparaissent pas sur le devis.
Quand une API de modèle surpasse un cluster GPU
Un cluster GPU dédié n’est pas toujours la bonne abstraction. Si votre produit a seulement besoin de sorties de modèle, et non du contrôle du matériel, comparez le TCO d’un cluster à une approche via API.
Les API de modèle peuvent gagner lorsque :
- Le trafic est irrégulier.
- Le mix de modèles change souvent.
- Vous avez besoin d’accéder à plusieurs modèles de pointe et modèles open source.
- L’équipe ne peut pas maintenir les GPU à un haut niveau d’utilisation.
- Les filtres de qualité et les reprises sont plus faciles à gérer au niveau des requêtes.
- La finance souhaite des enregistrements d’utilisation par requête plutôt qu’un pool d’infrastructure.
Flatkey est pertinent ici, car le même acheteur a souvent besoin des deux approches. Flatkey Compute aide les équipes à comparer la capacité GPU-heure en direct, à publier une demande GPU anonyme et à recevoir des offres de fournisseurs. La couche API de modèles et d’outils de Flatkey offre aux équipes un moyen d’acheminer les charges de travail IA via une seule clé, un seul solde et un seul registre d’utilisation lorsque la possession de la couche GPU est inutile.
Le flux de travail pratique est le suivant :
- Benchmarkez la charge de travail sur des GPU loués.
- Calculez le coût par sortie acceptée.
- Comparez la même charge de travail via des API de modèle.
- Réservez ou passez en colocation uniquement lorsque le matériel dédié l’emporte clairement selon des hypothèses pessimistes.
Liste de contrôle des sources pour votre modèle de TCO de cluster GPU
Utilisez des pages sources et des documents de devis à jour plutôt que de recopier des tarifs obsolètes d’un autre article.
| Type de source | Ce qu’il faut vérifier |
|---|---|
| Pages des fournisseurs de GPU cloud | Type d’instance, nombre de GPU, région, stockage, réseau, et si le prix est à la demande, réservé, spot ou dédié. |
| Spécifications système du fournisseur de GPU | Puissance, mémoire, interconnexion, format du serveur et topologie prise en charge. |
| Devis de colocation | Rack/cage, alimentation, remote hands, cross-connects, réseau, frais d’installation et limites d’expansion. |
| Données de services publics ou d’énergie | Hypothèses sur le prix de l’électricité et son augmentation. |
| Données de plateforme internes | Utilisation réelle, délai de file d’attente, taux d’échec, taux de reprise, volume de sorties acceptées et temps du personnel. |
| Hypothèses financières | Période d’amortissement, coût du capital, traitement fiscal, valeur résiduelle et coût de sortie du contrat. |
Points de départ utiles :
- Flatkey Compute pour le contexte en direct du marché des GPU-heure et la publication de demandes.
- Indice de prix Flatkey Compute pour des vérifications de référence du marché à l’heure.
- Instances AWS EC2 P5 pour le contexte d’infrastructure de cluster cloud H100.
- Tarification des GPU Google Cloud pour la méthodologie de tarification des GPU par type et région.
- Lambda GPU Cloud pour le contexte de tarification des GPU cloud spécialisés.
- Tarification RunPod pour les vérifications de prix des GPU sur marketplace et cloud.
- NVIDIA DGX H100 et NVIDIA DGX B200 pour les spécifications système du fournisseur.
- Données sur l’électricité de l’U.S. Energy Information Administration pour les hypothèses de coût de l’énergie.
- FinOps FOCUS si votre équipe financière a besoin de champs de coûts cloud standardisés.
Questions fréquemment posées
Qu’est-ce que le TCO d’un cluster GPU ?
Le TCO d’un cluster GPU est le coût total de fourniture d’un calcul IA utile à partir d’un cluster. Il inclut la capacité GPU, le stockage, le réseau, l’alimentation, le refroidissement, la main-d’œuvre, les logiciels, le support, les temps d’arrêt, le gaspillage dû aux tentatives répétées, ainsi que le risque lié au capital ou au contrat.
La location cloud de GPU est-elle toujours plus chère que l’achat de GPU ?
Non. La location cloud de GPU peut être moins chère lorsque l’utilisation est incertaine, que la charge de travail est de courte durée, que l’équipe manque de capacité opérationnelle, ou que la pile de modèles évolue rapidement. L’achat ou la colocation de GPU ne l’emporte que lorsque l’utilisation utile est suffisamment élevée pour compenser les opérations, l’énergie, le réseau, le financement et le risque de sortie.
Quand la colocation est-elle plus avantageuse que la location cloud ?
La colocation peut être plus avantageuse que la location cloud lorsque la demande est stable, que la durée du contrat est longue, que la densité électrique est suffisante, que le matériel est bien utilisé et que l’équipe peut exploiter le cluster. Elle ne surpasse pas la location cloud simplement parce que le prix d’achat du matériel semble inférieur au tarif public du cloud.
Quand une équipe devrait-elle choisir des GPU on-premises ?
Choisissez des GPU on-premises lorsque le contrôle des installations, la localisation des données, la conformité ou la maîtrise stratégique de l’infrastructure justifient la charge opérationnelle. Pour la plupart des équipes produit IA, l’on-premises est la dernière option à justifier, pas la valeur par défaut.
Comment les équipes FinOps devraient-elles comparer les options de cluster GPU ?
Les équipes FinOps devraient comparer les options sur la base du coût par résultat utile, et non sur le seul tarif horaire. La feuille de calcul doit inclure l’utilisation, le gaspillage dû aux tentatives répétées, le stockage, le transfert de données, le coût humain, l’énergie, la durée du contrat, le délai de mise à l’échelle et le coût de sortie.
Quelle est la place de Flatkey dans le TCO d’un cluster GPU ?
Flatkey aide les équipes à éviter d’acheter la mauvaise abstraction. Utilisez Flatkey Compute lorsque vous avez besoin d’une capacité GPU au prix du marché ou d’offres fournisseurs. Utilisez la couche API modèle et outil de Flatkey lorsque vous n’avez besoin que des sorties du modèle, d’une seule clé, d’un seul solde et d’un registre d’utilisation au niveau des requêtes.
En résumé
Le meilleur modèle de TCO pour un cluster GPU n’est pas le tableur le plus long. C’est celui qui rend trois décisions évidentes :
- Si la charge de travail a besoin de GPU dédiés ou non.
- Si la location cloud, la colocation ou l’on-premises présente le meilleur coût ajusté au risque de dégradation.
- Si le contrat reste valable lorsque l’utilisation, le mix de modèles, l’énergie et la disponibilité évoluent.
Commencez avec de la capacité louée ou une cotation GPU en temps réel du marché, benchmarkez la charge de travail réelle, normalisez par la production acceptée, et ne passez vers la colocation ou l’on-premises que lorsque le calcul d’utilisation utile résiste au scénario défavorable.
Si la réponse reste incertaine, conservez la valeur d’option. Le TCO d’un cluster GPU récompense les équipes qui achètent la capacité par étapes plutôt que de s’engager dans du matériel avant que la charge de travail ne fasse ses preuves.


