
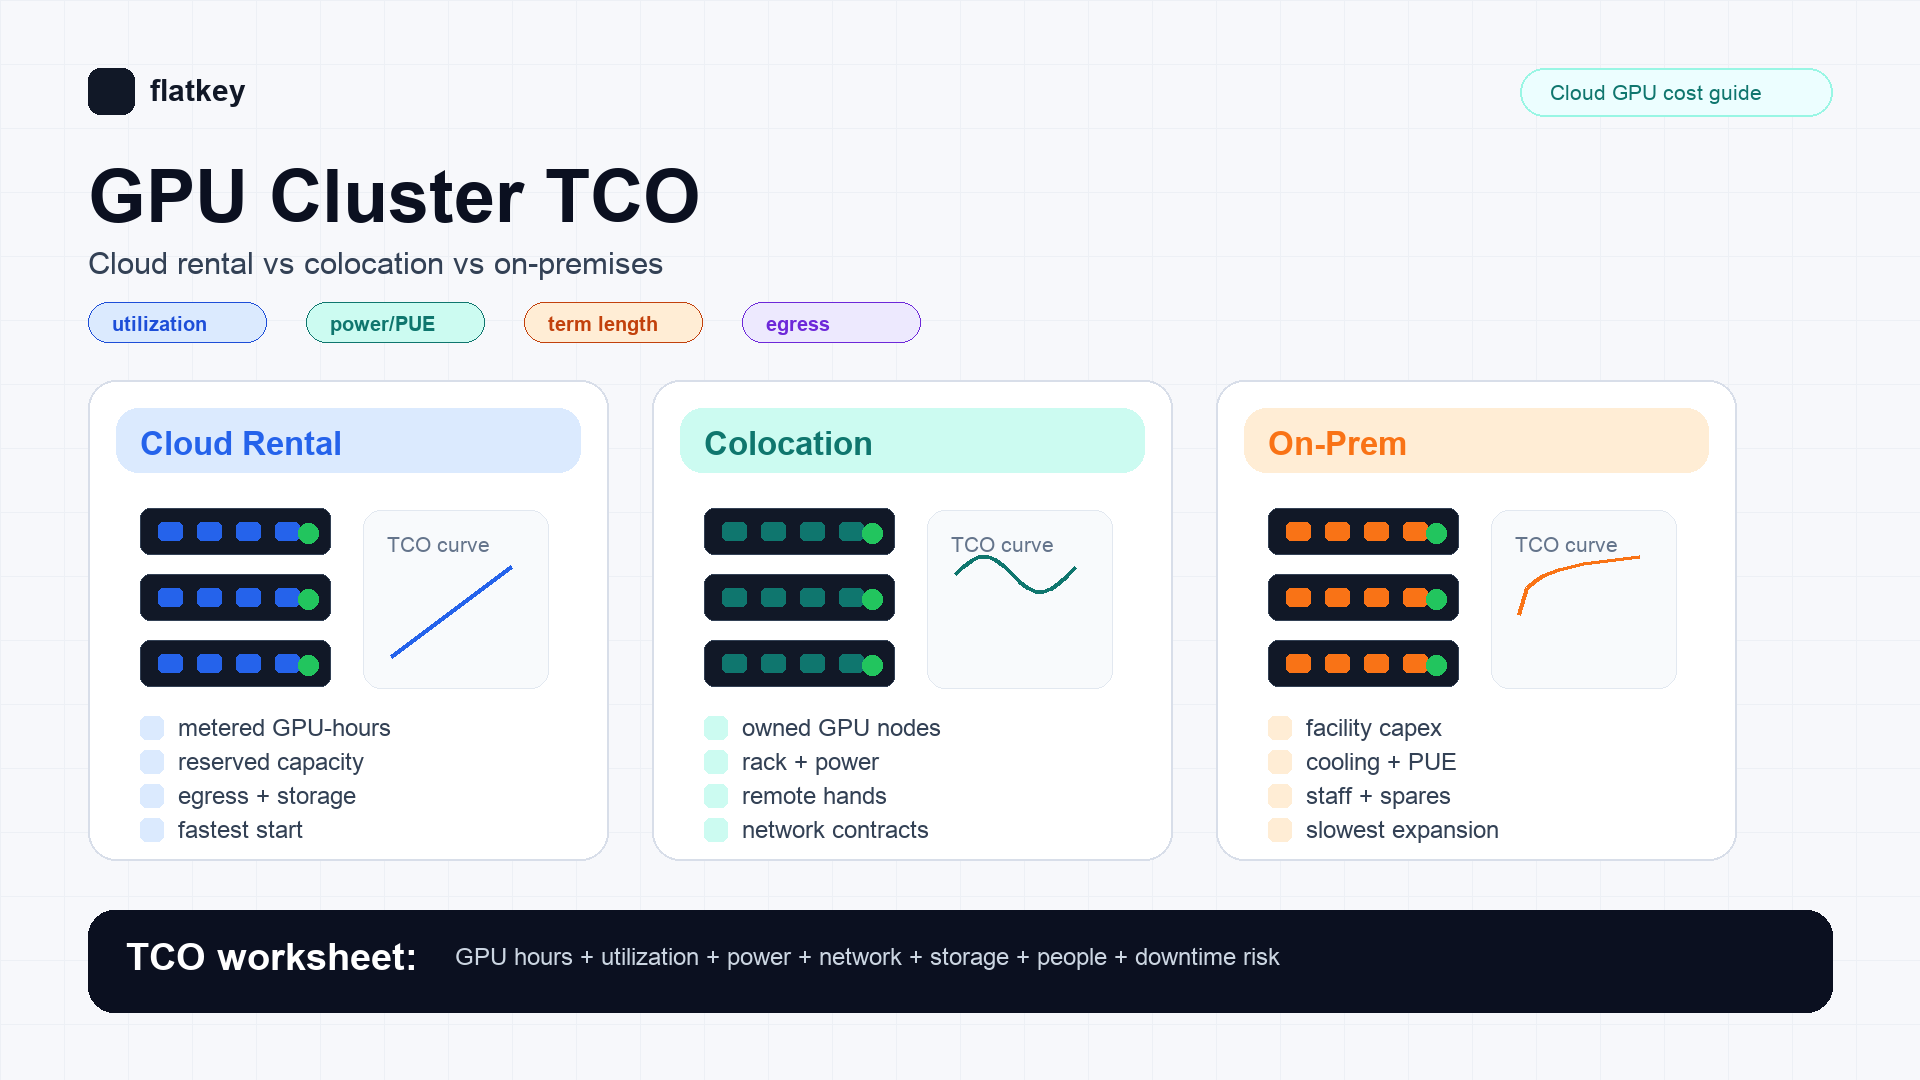
La mayoría de las comparaciones de TCO de clústeres GPU fallan por la misma razón: comparan una tarifa horaria de la nube con una orden de compra de hardware. Esa no es la decisión.
La decisión real es si tu equipo de IA debe comprar flexibilidad, comprar hardware o comprar control de la infraestructura. Un modelo serio de TCO de clústeres GPU tiene que normalizar el alquiler en la nube, la colocation y el on-premises alrededor del mismo resultado: ejecuciones de entrenamiento completadas, tokens de inferencia aceptados, trabajos de medios generados o meses de capacidad reservada.
Para la mayoría de los equipos, el alquiler de GPU en la nube gana cuando la utilización es incierta, la rapidez de lanzamiento importa o la carga de trabajo cambia según la familia de modelos. La colocation empieza a ganar cuando la demanda es estable, el equipo puede operar hardware y el contrato es lo suficientemente largo como para amortizar GPUs, red, repuestos y soporte remoto. El on-premises normalmente requiere la justificación más sólida: utilización muy alta y predecible, operaciones de centro de datos existentes, requisitos estrictos de localización o un mandato estratégico para poseer la capa de instalaciones.
La regla práctica de Flatkey: empieza por la carga de trabajo, no por el rack. Si la carga puede atenderse con una API de modelo gestionada, compárala primero. Si de verdad necesitas GPUs dedicadas, cotiza el alquiler en la nube, la colocation y el on-premises con la misma hoja de cálculo antes de firmar un contrato de capacidad.
Respuesta rápida sobre el TCO de clústeres GPU
Usa esta tabla de decisión de primera pasada antes de construir el modelo completo.
| Situación | Normalmente empezar con | Por qué |
|---|---|---|
| Prototipo, fine-tuning con picos, ventana corta de benchmark | Alquiler de GPU en la nube | Menor compromiso y vía más rápida a la capacidad. |
| Flota de inferencia estable de varios meses con mezcla de modelos conocida | Capacidad reservada en la nube o colocation | La utilización es lo bastante alta como para negociar precios por plazo, pero aún puede evitarse el riesgo de propiedad. |
| Trabajos de entrenamiento grandes con requisitos estrictos de topología de red | Clúster dedicado en la nube o colocation | Necesitas colocación predecible de nodos, tejido de red, localidad de almacenamiento y aceptación de benchmarks. |
| Utilización plurianual por encima de tu tasa mínima interna | Colocation o on-premises | La amortización del hardware puede superar al alquiler por hora solo si el tiempo ocioso, las operaciones, la energía y el tiempo de inactividad se contabilizan con honestidad. |
| Localización de datos regulada o mandato de control de instalaciones | On-premises o colocation controlada | La decisión de TCO incluye cumplimiento y control, no solo precio de cómputo. |
| La aplicación solo necesita salidas del modelo, no control de la GPU | API de modelo o cotización del mercado de GPU | Comprar un clúster puede ser excesivo cuando la métrica de negocio es el coste por salida aceptada. |
El resto de esta guía muestra cómo construir una hoja de cálculo de TCO de clústeres GPU que compras, ingeniería de plataforma y finanzas puedan usar por igual.
Normaliza cada opción a una sola unidad
No compares "H100 por hora" con "precio de compra del servidor". Elige un denominador y obliga a cada opción a encajar en él.
Los denominadores útiles incluyen:
- Coste por ejecución de entrenamiento completada: mejor para fine-tuning periódico, experimentos de preentrenamiento y trabajos por lotes.
- Coste por salida aceptada: mejor para inferencia de LLM, generación de código, generación de imágenes y pipelines de vídeo donde importan los reintentos.
- Coste por GPU-mes reservada: mejor para equipos de plataforma que compran capacidad interna para varios equipos de producto.
- Coste por token o trabajo con SLA: mejor cuando el tiempo de inactividad, la preempción o el retraso en cola cambian la fiabilidad de cara al usuario.
Para inferencia, el denominador más limpio suele ser:
effective_cost_per_accepted_output =
  total_monthly_cluster_cost
  / accepted_outputs_after_retries_and_quality_filters
Ese denominador detecta dos cosas que el precio por hora oculta: trabajos fallidos y capacidad ociosa.
Fórmula de TCO de clústeres GPU
Usa este modelo antes de añadir detalles específicos del proveedor:
monthly_gpu_cluster_tco =
  capacity_cost
  + storage_cost
  + data_transfer_cost
  + network_and_interconnect_cost
  + software_and_observability_cost
  + labor_and_operations_cost
  + support_and_warranty_cost
  + financing_or_depreciation_cost
  + downtime_and_retry_waste
Luego conviértelo en la unidad que te importa:
unit_cost =
  monthly_gpu_cluster_tco
  / useful_work_completed_per_month
Esto importa porque un GPU-hora barato puede seguir siendo caro si el clúster está infrautilizado, si los trabajos esperan en cola, si el almacenamiento está en la región equivocada o si las ejecuciones fallidas consumen tiempo a precio completo.
Componentes de coste por modelo de despliegue
| Línea de coste | Alquiler en la nube | Colocation | On-premises |
|---|---|---|---|
| Capacidad GPU | Bajo demanda, spot, reservada, dedicada o cotización de mercado. | Compra o leasing de hardware más contrato de rack. | Compra o leasing de hardware más asignación interna de instalaciones. |
| Electricidad y refrigeración | Normalmente integradas en la tarifa, pero no son gratuitas. | Electricidad contratada, electricidad medida, sobrecoste de refrigeración y límites de densidad de potencia. | Electricidad de red, UPS, generador, planta de refrigeración y exposición al PUE. |
| Red | Egress, enlaces privados, IP públicas, tráfico entre regiones, interconexión. | Tránsito, cross-connects, enlaces privados, acceso remoto, servicios de DDoS/seguridad. | WAN, tránsito de Internet, enlaces privados, firewalls, switching, rutas redundantes. |
| Almacenamiento | Bloque, objetos, sistema de archivos, snapshots, copias de seguridad, niveles de IOPS. | NVMe local, almacenamiento compartido, destino de copias de seguridad, replicación remota. | Hardware de almacenamiento, copias de seguridad, replicación, sustitución de medios, operaciones del ciclo de vida. |
| Operaciones | Principalmente integración de la plataforma y controles de costes. | Ciclo de vida del hardware, remote hands, pruebas de aceptación, repuestos, coordinación de RMA. | Operaciones completas de instalaciones y hardware, acceso físico, repuestos, cobertura fuera de horario. |
| Riesgo de compromiso | Bajo para bajo demanda; mayor para contratos reservados o dedicados. | Medio a alto. Importan la salida del contrato y la reventa del hardware. | El más alto. Las decisiones sobre instalaciones y equipos pueden superar la hoja de ruta del modelo. |
El alquiler en la nube parece simple porque muchos costes se agrupan en la tarifa. La colocation y el on-premises parecen más baratos cuando la hoja de cálculo se olvida de las personas, la energía, la red y el presupuesto para fallos.
Alquiler en la nube: qué contar
El alquiler en la nube es la base más limpia para el TCO de un clúster GPU porque convierte la capacidad en un servicio medido. Eso no significa que la tarifa por hora sea el coste total.
Cuenta:
- Tarifa por hora de la instancia GPU o bare-metal.
- Términos de capacidad reservada, comprometida o dedicada.
- Almacenamiento adjunto al clúster.
- Almacenamiento de objetos y retención de snapshots.
- Transferencia de datos y egress.
- Red privada, balanceadores de carga, IP públicas y NAT.
- Scheduler, Kubernetes, Slurm, observabilidad, logging y alertas.
- Tiempo de inactividad por huecos en la cola, despliegues fallidos, cold starts y mal bin packing.
- Desperdicio por reintentos spot o interruptibles, si se usan.
- Plan de soporte y costes de gestión de cuentas.
El alquiler en la nube suele ganar cuando la curva de demanda del equipo es incierta. También le da a compras una referencia de precio actual. Las páginas públicas de proveedores de AWS, Google Cloud, Lambda, RunPod y otras nubes GPU son útiles como comprobaciones de origen, pero el único número que importa para un clúster grande es la cotización que realmente puedes reservar para la región, la topología y el plazo que necesitas.
Usa las páginas oficiales como puntos de control:
- AWS describe infraestructura de clase P5 para cargas de trabajo de IA a gran escala en su página de instancias EC2 P5.
- Google Cloud publica precios de GPU y señala que el precio depende del tipo de GPU, la región y el modelo de uso.
- Lambda y RunPod publican superficies de precios de nube GPU que son útiles para comprobaciones rápidas del mercado.
- Flatkey Compute publica un índice en vivo del precio por hora de GPU y permite a los compradores publicar solicitudes anónimas de GPU para que proveedores verificados pujen por ellas.
Trata cada precio como si tuviera marca temporal. La disponibilidad de GPU y las tarifas por hora se mueven más rápido que los precios habituales de SaaS.
Colocation: qué contar
La colocation no es solo "la nube, pero más barata". Traslada una gran parte de la carga operativa del proveedor a tu equipo.
Cuenta:
- Servidores GPU, adaptadores de red, switches, ópticas, cables y almacenamiento.
- Tarifas de rack o jaula.
- Electricidad contratada y electricidad medida.
- Limitaciones de refrigeración y densidad.
- Cross-connects, tránsito de Internet, enlaces privados y seguridad de red.
- Remote hands, envío, recepción, instalación, inventario y gestión de RMA.
- GPUs, fuentes de alimentación, NIC, ópticas, ventiladores y unidades de almacenamiento de repuesto.
- Depreciación del hardware, coste de leasing, coste de financiación y supuestos de reventa.
- SLA de instalaciones, ventanas de mantenimiento y procedimientos de acceso.
- Operaciones de la plataforma: imágenes, drivers, stack CUDA, Kubernetes o Slurm, observabilidad, parches de seguridad y respuesta a incidentes.
La colocation empieza a tener sentido cuando la utilización es predecible y alta, el equipo tiene capacidad real de operaciones de infraestructura y el contrato ofrece suficiente densidad de potencia para la generación de GPU que planeas ejecutar. Falla cuando los equipos compran el hardware pero subestiman remote hands, red, limitaciones de energía, repuestos y la expansión lenta.
Para los clústeres GPU, la red de interconexión suele ser el elemento que decide la arquitectura. Un clúster que necesita entrenamiento estrechamente acoplado no es equivalente a un conjunto de nodos de inferencia aislados. Si la carga de trabajo depende de InfiniBand, RoCE, NVLink, NVSwitch o de una disposición específica del almacenamiento, incluye eso en la cotización y en la prueba de aceptación.
On-premises: qué contar
El TCO de un clúster GPU on-premises debe tratarse como un proyecto de instalaciones, no como una compra de servidores.
Cuenta:
- Todo lo incluido en el modelo de colocation.
- Asignación de espacio en sala de datos o construcción/adaptación.
- Trabajos eléctricos, UPS, generador, distribución de energía y supresión de incendios.
- Capacidad y mantenimiento de la planta de refrigeración.
- Seguridad física y control de acceso.
- Personal de instalaciones y escalado fuera de horario.
- Seguros, auditorías de cumplimiento y procedimientos de seguridad.
- Planificación de capacidad a largo plazo para la siguiente generación de GPU.
- Coste de oportunidad del capital inmovilizado en instalaciones y hardware.
On-premises puede justificarse para organizaciones con infraestructura de centro de datos existente, alta utilización, requisitos estrictos de localidad o mandatos estratégicos de control. Es la opción más débil cuando el equipo todavía está descubriendo la mezcla de modelos, la longitud del contexto, el objetivo de rendimiento y el ajuste producto-mercado.
El riesgo oculto es la rotación de generaciones de GPU. Una decisión de instalaciones puede durar más que la arquitectura de modelo que estás sirviendo. Si tu TCO depende de que una familia de modelos siga siendo dominante durante tres años, somete esa suposición a pruebas de estrés.
Utilización de equilibrio
La cuestión central del punto de equilibrio es:
required_utilization =
  owned_monthly_cost
  / equivalent_cloud_monthly_cost_at_100_percent_use
Si la infraestructura propia cuesta $X por mes y el alquiler equivalente en la nube con utilización total cuesta $Y por mes, entonces la propiedad solo funciona si la utilización útil está por encima de X / Y. Utilización útil significa trabajo que de otro modo habría sido pagado. Excluye inventario inactivo, trabajos fallidos, holgura de cola y capacidad reservada para picos poco frecuentes.
Ejecuta el modelo bajo tres escenarios:
| Escenario | Qué probar |
|---|---|
| Caso base | Carga de trabajo esperada, utilización esperada, plazo esperado. |
| Caso adverso | Menor utilización, uso del producto retrasado, menor reventa, mayor consumo eléctrico, aceptación más lenta. |
| Caso de estrés | El nuevo modelo no cabe en memoria, la topología de red es incorrecta o la demanda se desplaza a una API gestionada. |
Si el caso adverso destruye la economía, el alquiler en la nube o un contrato dedicado más corto suele ser el primer paso más seguro.
Hoja de trabajo de TCO de clúster GPU copiable
Usa esta hoja de trabajo en tu documento de compras. Rellénala una vez para alquiler en la nube, una vez para colocation y una vez para on-premises.
| Campo | Alquiler en la nube | Colocation | On-premises |
|---|---|---|---|
| Modelo y cantidad de GPU | |||
| Plazo del contrato | |||
| Utilización útil esperada | |||
| Coste mensual de capacidad GPU | |||
| Almacenamiento y copias de seguridad | |||
| Transferencia de datos y red | |||
| Energía y refrigeración | Incluido o cotizado | ||
| Rack, cage o asignación de instalaciones | N/A | ||
| Amortización o arrendamiento de hardware | N/A | ||
| Remote hands / personal | |||
| Soporte, garantía y repuestos | |||
| Observabilidad y herramientas de plataforma | |||
| Tiempo de inactividad y desperdicio por reintentos | |||
| TCO mensual estimado | |||
| Denominador de coste unitario | |||
| Coste por salida aceptada | |||
| Tiempo de preparación para expansión | |||
| Coste de salida |
No omitas las dos últimas filas. El tiempo de preparación para expansión y el coste de salida son donde la economía de hardware aparentemente atractiva a menudo se vuelve cara.
Preguntas de compras que hacer a todos los proveedores
Para alquiler en la nube:
- ¿La capacidad cotizada es compartida, reservada, dedicada o bare metal?
- ¿Qué región, zona de disponibilidad y ubicación de nodos están garantizadas?
- ¿Qué modelo exacto de GPU, tamaño de memoria, interconexión, CPU, RAM, almacenamiento local y tejido de red están incluidos?
- ¿Están incluidos el almacenamiento, las instantáneas, el almacenamiento de objetos, el ancho de banda, las IP públicas y el soporte?
- ¿Qué ocurre si el clúster no está disponible durante el plazo?
- ¿Puede el proveedor ejecutar un benchmark de aceptación antes de que comience el compromiso?
- ¿Cómo se acreditan los trabajos fallidos, las interrupciones de la plataforma y las ventanas de mantenimiento?
Para colocation:
- ¿Qué densidad de potencia se contrata por rack?
- ¿La energía se mide, se compromete o se integra en el precio del rack?
- ¿Qué trabajo de remote hands está incluido y qué es facturable?
- ¿Qué operadores y enlaces privados están disponibles?
- ¿Con qué rapidez se pueden aprovisionar racks, energía y cross-connects adicionales?
- ¿Quién es propietario de repuestos, RMA y mantenimiento de firmware?
- ¿Qué prueba de aceptación confirma que el clúster está listo para producción?
Para on-premises:
- ¿La instalación ya admite la densidad de potencia objetivo?
- ¿Hay capacidad de refrigeración disponible sin una ampliación?
- ¿Quién es responsable de la respuesta de hardware 24/7?
- ¿Cuál es el proceso de aprobación para cambios eléctricos, de red y de seguridad?
- ¿Cuál es el período de depreciación y qué valor de reventa se asume?
- ¿Qué ocurre si el próximo modelo requiere más memoria, más ancho de banda o una pila de servicio diferente?
Matriz de decisión
| Criterio | Alquiler en la nube | Colocation | On-premises |
|---|---|---|---|
| Velocidad de arranque | La mejor | Media | La más lenta |
| Capital inicial | El más bajo | De medio a alto | El más alto |
| Carga operativa | La más baja | Media | La más alta |
| Economía de utilización estable a largo plazo | Media | Fuerte si se opera bien | Fuerte solo con madurez de la instalación |
| Flexibilidad por generación de GPU | La mejor | Media | La más baja |
| Control de la instalación | Bajo | Medio | El más alto |
| Reversibilidad de la adquisición | La mejor | Media | La más baja |
| Requisito de benchmark | Importante | Crítico | Crítico |
La respuesta más defendible rara vez es "siempre nube" o "siempre comprar". Suele ser un enfoque por fases: alquilar para el descubrimiento, reservar para la demanda estable, hacer colocation cuando se demuestra la utilización y pasar a on-premises solo cuando el control de la instalación forma parte del requisito.
Errores comunes en los modelos de TCO de clústeres GPU
Comparar el precio de lista con la propiedad en el mejor de los casos
Un modelo de TCO de clúster GPU justo compara presupuestos reales con el costo real de propiedad. El precio de lista de la nube no es lo mismo que la capacidad reservada o negociada. El precio de compra del hardware no es lo mismo que el costo de un clúster operado.
Ignorar la utilización
Un clúster propio con un 40% de utilización efectiva puede perder frente a un clúster en la nube con una tarifa por hora mucho más alta. Mide el trabajo útil, no las GPUs instaladas.
Tratar la topología de red como algo secundario
El número de GPU por sí solo no define un clúster. El entrenamiento, el ajuste fino y la inferencia de alto rendimiento pueden tener requisitos de red y almacenamiento muy distintos.
Olvidar el desperdicio por reintentos
Los reintentos, los despliegues fallidos, las preempciones y las salidas de baja calidad aumentan todos el costo unitario. Incluye el desperdicio por reintentos en el denominador, no solo en el numerador.
Subestimar el costo de las personas
Los drivers, las versiones de CUDA, las imágenes de contenedor, los programadores, la monitorización, el firmware, el parcheo de seguridad y la respuesta a incidentes forman parte del TCO de un clúster GPU. Alguien paga por ellos incluso cuando no aparecen en el presupuesto.
Cuándo una API de modelo supera a un clúster GPU
Un clúster GPU dedicado no siempre es la abstracción correcta. Si tu producto solo necesita salidas del modelo, no control del hardware, compara el TCO del clúster con una ruta por API.
Las APIs de modelo pueden ganar cuando:
- El tráfico es irregular.
- La mezcla de modelos cambia con frecuencia.
- Necesitas acceso a múltiples modelos frontier y open models.
- El equipo no puede mantener las GPUs con una utilización alta.
- Los filtros de calidad y los reintentos son más fáciles de gestionar en la capa de solicitudes.
- Finanzas quiere registros de uso por solicitud en lugar de un pool de infraestructura.
Flatkey es relevante aquí porque el mismo comprador a menudo necesita ambas rutas. Flatkey Compute ayuda a los equipos a comparar capacidad viva de GPU-hora, publicar demanda anónima de GPU y recibir ofertas de proveedores. La capa de API de modelos y herramientas de Flatkey da a los equipos una forma de enrutar cargas de trabajo de IA a través de una sola clave, un solo saldo y un solo libro mayor de uso cuando no es necesario poseer la capa GPU.
El flujo de trabajo práctico es:
- Benchmark de la carga de trabajo en GPUs alquiladas.
- Calcular el costo por salida aceptada.
- Comparar la misma carga de trabajo a través de APIs de modelo.
- Reservar o hacer colocation solo cuando el hardware dedicado gane claramente bajo supuestos pesimistas.
Lista de verificación de fuentes para tu modelo de TCO de clúster GPU
Utiliza páginas fuente y documentos de cotización actuales en lugar de copiar tarifas desactualizadas de otro artículo.
| Tipo de fuente | Qué verificar |
|---|---|
| Páginas de proveedores de GPU en la nube | Tipo de instancia, cantidad de GPU, región, almacenamiento, red y si el precio es bajo demanda, reservado, spot o dedicado. |
| Especificaciones del sistema del proveedor de GPU | Potencia, memoria, interconexión, formato del servidor y topología compatible. |
| Cotización de colocation | Rack/cage, energía, hands remotos, cross-connects, red, cargos de instalación y límites de expansión. |
| Datos de servicios públicos o energía | Supuestos sobre el precio de la electricidad y su escalada. |
| Datos internos de la plataforma | Utilización real, retraso en cola, tasa de fallos, tasa de reintentos, volumen de salidas aceptadas y tiempo del personal. |
| Supuestos financieros | Periodo de depreciación, costo de capital, tratamiento fiscal, valor residual y costo de salida del contrato. |
Puntos de partida útiles:
- Flatkey Compute para contexto de mercado en vivo de GPU-hora y publicación de demanda.
- Índice de precios de Flatkey Compute para comprobaciones de referencia del mercado por hora.
- Instancias AWS EC2 P5 para contexto de infraestructura de clúster H100 en la nube.
- Precios de GPU de Google Cloud para la metodología de precios de GPU por tipo y región.
- Lambda GPU Cloud para contexto de precios de GPU en la nube especializada.
- Precios de RunPod para comprobaciones de precios de marketplace y GPU en la nube.
- NVIDIA DGX H100 y NVIDIA DGX B200 para especificaciones del sistema del proveedor.
- datos de electricidad de la U.S. Energy Information Administration para supuestos de costo de energía.
- FinOps FOCUS si tu equipo financiero necesita campos estandarizados de costo en la nube.
Preguntas frecuentes
¿Qué es el TCO de un clúster GPU?
El TCO de un clúster GPU es el coste total de entregar cómputo de IA útil a partir de un clúster. Incluye capacidad GPU, almacenamiento, redes, energía, refrigeración, mano de obra, software, soporte, tiempo de inactividad, desperdicio por reintentos y riesgo de capital o contractual.
¿El alquiler de GPU en la nube es siempre más caro que comprar GPUs?
No. El alquiler de GPU en la nube puede ser más barato cuando la utilización es incierta, la carga de trabajo es de corta duración, el equipo carece de capacidad operativa o la pila del modelo cambia rápidamente. Comprar o poner GPUs en colocation solo gana cuando la utilización útil es lo bastante alta como para compensar operaciones, energía, redes, financiación y riesgo de salida.
¿Cuándo la colocation supera al alquiler en la nube?
La colocation puede superar al alquiler en la nube cuando la demanda es estable, el plazo contractual es largo, la densidad de potencia es suficiente, el hardware se utiliza bien y el equipo puede operar el clúster. No supera al alquiler en la nube solo porque el precio de compra del hardware parezca inferior a una tarifa pública de la nube.
¿Cuándo debería un equipo elegir GPUs on-premises?
Elige GPUs on-premises cuando el control de la instalación, la residencia de los datos, el cumplimiento normativo o la propiedad estratégica de la infraestructura merezcan la carga operativa. Para la mayoría de los equipos de producto de IA, on-premises es la última opción que justificar, no la predeterminada.
¿Cómo deberían los equipos de FinOps comparar las opciones de clúster GPU?
Los equipos de FinOps deberían comparar las opciones por coste por resultado útil, no solo por tarifa por hora. La hoja de cálculo debe incluir utilización, desperdicio por reintentos, almacenamiento, transferencia de datos, coste de personal, energía, plazo contractual, tiempo de preparación para la expansión y coste de salida.
¿Dónde encaja Flatkey en el TCO de un clúster GPU?
Flatkey ayuda a los equipos a evitar comprar la abstracción equivocada. Usa Flatkey Compute cuando necesites capacidad GPU a precio de mercado o presupuestos de proveedores. Usa la capa de API de modelos y herramientas de Flatkey cuando solo necesites salidas de modelos, una clave, un saldo y un libro mayor de uso a nivel de solicitud.
En resumen
El mejor modelo de TCO para un clúster GPU no es la hoja de cálculo más larga. Es el que deja tres decisiones claras:
- Si la carga de trabajo necesita GPUs dedicadas en absoluto.
- Si el alquiler en la nube, la colocation o on-premises tiene el mejor coste ajustado al peor escenario.
- Si el contrato sigue funcionando cuando cambian la utilización, la combinación de modelos, la energía y la disponibilidad.
Empieza con capacidad alquilada o con una cotización real del mercado de GPU, compara con la carga de trabajo real, normaliza por el resultado aceptado y solo avanza hacia colocation u on-premises cuando la matemática de la utilización útil resista el caso adverso.
Si la respuesta sigue siendo incierta, conserva el valor de la opción. El TCO de un clúster GPU recompensa a los equipos que compran capacidad por etapas en lugar de comprometerse con hardware antes de que la carga de trabajo se haya probado.


