
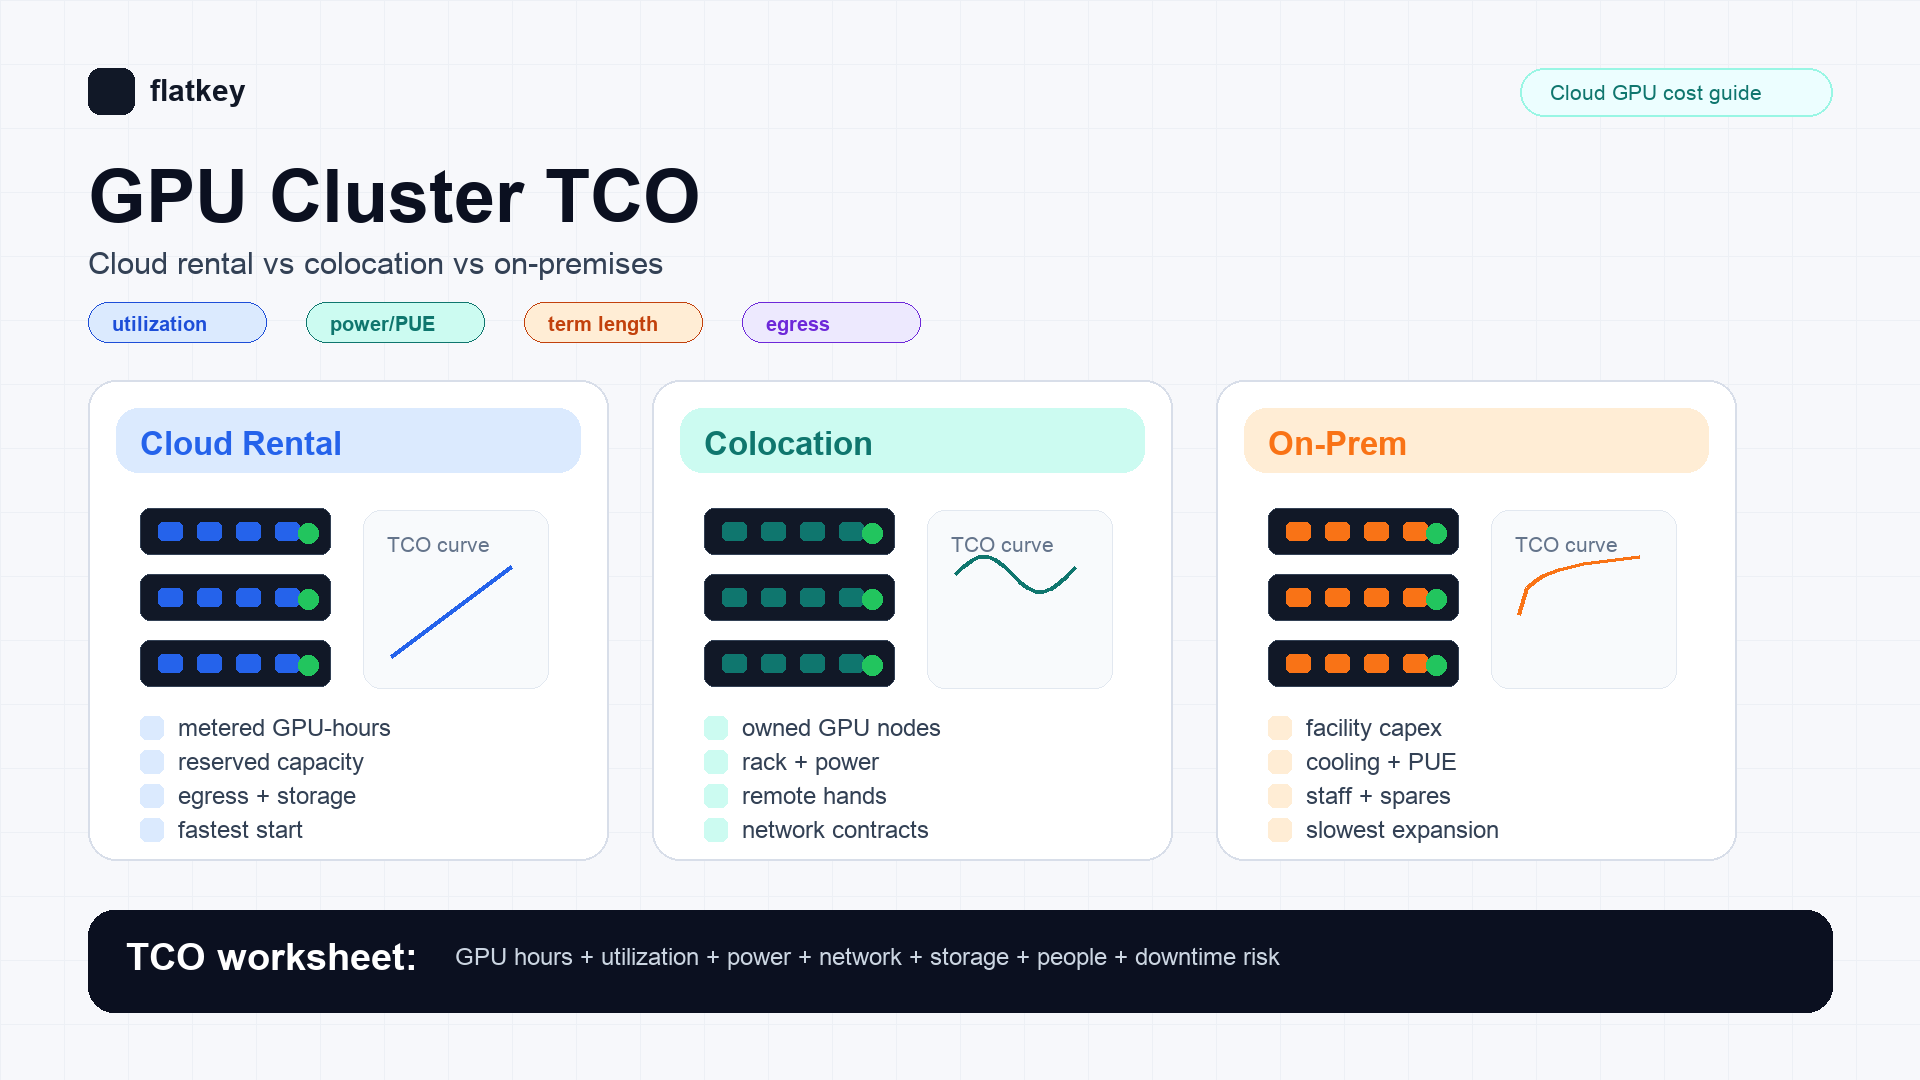
Большинство сравнений TCO GPU-кластеров проваливаются по одной и той же причине: они сравнивают почасовую ставку облака с заказом на покупку оборудования. Но это не то решение.
На самом деле нужно решить, должна ли ваша AI-команда покупать гибкость, покупать оборудование или покупать контроль над инфраструктурой. Серьёзная модель TCO GPU-кластера должна приводить облачную аренду, колокацию и on-premises к одному и тому же результату: завершённые обучающие прогоны, принятые токены инференса, сгенерированные медиа-задачи или зарезервированные месяцы мощности.
Для большинства команд аренда GPU в облаке выигрывает, когда загрузка непредсказуема, важна скорость запуска или рабочая нагрузка меняется в зависимости от семейства моделей. Колокация начинает выигрывать, когда спрос стабилен, команда умеет обслуживать оборудование, а срок контракта достаточно длинный, чтобы амортизировать GPU, сеть, запасные части и удалённые руки. On-premises обычно требует наиболее веского обоснования: очень высокой и предсказуемой загрузки, уже существующих операций дата-центра, жёстких требований к локальности данных или стратегического решения владеть уровнем инфраструктуры.
Практическое правило Flatkey: начинайте с рабочей нагрузки, а не с стойки. Если задачу может закрыть управляемый API модели, сначала сравните именно его. Если вам действительно нужны выделенные GPU, оцените аренду в облаке, колокацию и on-premises по одной и той же таблице расчёта, прежде чем подписывать контракт на мощности.
Краткий ответ по TCO GPU-кластера
Используйте эту таблицу первого приближения, прежде чем строить полную модель.
| Ситуация | Обычно начинать с | Почему |
|---|---|---|
| Прототип, скачкообразный fine-tuning, короткое окно бенчмарка | Аренда GPU в облаке | Минимальные обязательства и самый быстрый путь к мощности. |
| Стабильный парк инференса на несколько месяцев с известным набором моделей | Резервированная мощность в облаке или колокация | Загрузка достаточно высока, чтобы согласовать долгосрочное ценообразование, но риск владения всё ещё можно избежать. |
| Крупные обучающие задачи со строгими требованиями к сетевой топологии | Выделенный облачный кластер или колокация | Нужны предсказуемое размещение узлов, сетевой fabric, близость хранилища и прохождение бенчмарка. |
| Многолетняя загрузка выше внутренней пороговой ставки | Колокация или on-premises | Амортизация оборудования может обойти почасовую аренду только если честно учесть простой, операции, питание и простои. |
| Требования по локальности регулируемых данных или мандат на контроль над инфраструктурой | On-premises или контролируемая колокация | Решение TCO включает соответствие требованиям и контроль, а не только цену вычислений. |
| Приложению нужны только результаты модели, а не контроль над GPU | API модели или котировка рынка GPU | Покупка кластера может быть избыточной, когда бизнес-метрика — это стоимость за принятый результат. |
Остальная часть этого руководства показывает, как построить таблицу TCO GPU-кластера, которой смогут пользоваться закупки, platform engineering и финансы.
Приведите все варианты к одной единице
Не сравнивайте «H100 в час» с «ценой покупки сервера». Выберите один знаменатель и приведите к нему все варианты.
Полезные знаменатели включают:
- Стоимость за завершённый обучающий прогон: лучше всего подходит для периодического fine-tuning, экспериментов по pretraining и пакетных задач.
- Стоимость за принятый результат: лучше всего подходит для LLM-инференса, генерации кода, генерации изображений и видеопайплайнов, где важны повторы.
- Стоимость за зарезервированный GPU-месяц: лучше всего подходит для platform-команд, покупающих внутреннюю мощность для нескольких продуктовых команд.
- Стоимость за токен или задачу, соответствующие SLA: лучше всего подходит, когда простои, preemption или задержка в очереди меняют надёжность для пользователя.
Для инференса самым чистым знаменателем часто бывает:
effective_cost_per_accepted_output =
  total_monthly_cluster_cost
  / accepted_outputs_after_retries_and_quality_filters
Этот знаменатель учитывает две вещи, которые скрывает почасовая цена: неудачные задачи и простой мощности.
Формула TCO GPU-кластера
Используйте эту модель, прежде чем добавлять детали, зависящие от провайдера:
monthly_gpu_cluster_tco =
  capacity_cost
  + storage_cost
  + data_transfer_cost
  + network_and_interconnect_cost
  + software_and_observability_cost
  + labor_and_operations_cost
  + support_and_warranty_cost
  + financing_or_depreciation_cost
  + downtime_and_retry_waste
Затем переведите её в нужную вам единицу:
unit_cost =
  monthly_gpu_cluster_tco
  / useful_work_completed_per_month
Это важно, потому что дешёвый GPU-час всё равно может оказаться дорогим, если кластер недоиспользуется, если задачи ждут в очереди, если хранилище находится не в том регионе или если неудачные запуски сжигают время по полной ставке.
Компоненты затрат по модели развертывания
| Статья затрат | Облачная аренда | Колокация | On-premises |
|---|---|---|---|
| GPU capacity | По требованию, spot, reserved, dedicated или по рыночному котировочному запросу. | Покупка или аренда оборудования плюс контракт на стойку. | Покупка или аренда оборудования плюс выделение ресурсов внутреннего объекта. |
| Power and cooling | Обычно включены в тариф, но не бесплатны. | Контрактная мощность, учет по счетчику, накладные расходы на охлаждение и ограничения по плотности мощности. | Сетевая электроэнергия, ИБП, генератор, система охлаждения и зависимость от PUE. |
| Network | Исходящий трафик, частные каналы, публичные IP, межрегиональный трафик, interconnect. | Транзит, cross-connects, частные каналы, удаленный доступ, DDoS/security services. | WAN, интернет-транзит, частные каналы, межсетевые экраны, коммутирование, резервные пути. |
| Storage | Block, object, filesystem, snapshots, backups, IOPS tiers. | Локальный NVMe, общая система хранения, backup target, удаленная репликация. | Storage hardware, backup, replication, замена носителей, lifecycle operations. |
| Operations | В основном интеграция платформы и контроль затрат. | Жизненный цикл оборудования, remote hands, приемочные тесты, запасные части, координация RMA. | Полный комплекс операций по объекту и оборудованию, физический доступ, запасные части, поддержка после рабочего времени. |
| Commitment risk | Низкий для on-demand; выше для reserved или dedicated контрактов. | Средний или высокий. Важны выход из контракта и перепродажа оборудования. | Самый высокий. Решения по объекту и оборудованию могут пережить дорожную карту модели. |
Облачная аренда выглядит простой, потому что многие затраты включены в тариф. Колокация и on-premises выглядят дешевле, когда в таблице забывают про людей, электроэнергию, сеть и бюджет на отказы.
Облачная аренда: что учитывать
Облачная аренда — самый чистый базовый вариант для TCO GPU-кластера, потому что она превращает мощность в тарифицируемый сервис. Это не означает, что почасовая ставка — это полная стоимость.
Учитывайте:
- Почасовую ставку GPU-инстанса или bare-metal.
- Условия reserved, committed или dedicated capacity.
- Хранилище, подключенное к кластеру.
- Объектное хранилище и хранение snapshot'ов.
- Передачу данных и исходящий трафик.
- Частные сети, load balancers, публичные IP и NAT.
- Scheduler, Kubernetes, Slurm, observability, logging и alerting.
- Простой из-за очередей, неудачных развертываний, cold starts и неэффективной bin packing.
- Потери на повторных попытках для spot или interruptible, если они используются.
- План поддержки и расходы на управление аккаунтом.
Облачная аренда обычно выигрывает, когда кривая спроса команды неопределенна. Она также дает закупкам актуальный ценовой ориентир. Публичные страницы провайдеров AWS, Google Cloud, Lambda, RunPod и других GPU-облаков полезны для сверки источников, но единственная цифра, которая имеет значение для большого кластера, — это котировка, которую вы реально можете зарезервировать для нужного региона, топологии и срока.
Используйте официальные страницы как контрольные точки:
- AWS описывает инфраструктуру класса P5 для крупномасштабных AI workloads на странице своих инстансов EC2 P5.
- Google Cloud публикует цены на GPU и указывает, что стоимость зависит от типа GPU, региона и модели использования.
- Lambda и RunPod публикуют ценовые поверхности GPU cloud, полезные для быстрой проверки рынка.
- Flatkey Compute публикует живой индекс цены за GPU-час и позволяет покупателям размещать анонимные запросы на GPU, на которые проверенные поставщики могут делать ставки.
Относитесь к каждой цене как к актуальной на конкретный момент времени. Доступность GPU и почасовые ставки меняются быстрее, чем обычные цены SaaS.
Колокация: что учитывать
Колокация — это не просто «облако, но дешевле». Она переносит значительную часть операционной нагрузки от провайдера к вашей команде.
Учитывайте:
- GPU-серверы, сетевые адаптеры, коммутаторы, optics, кабели и хранилище.
- Плата за стойку или клетку.
- Контрактная мощность и учет по счетчику.
- Охлаждение и ограничения по плотности.
- Cross-connects, интернет-транзит, частные каналы и сетевую безопасность.
- Remote hands, доставка, приемка, установка, инвентаризация и обработка RMA.
- Запасные GPU, блоки питания, NIC, optics, вентиляторы и накопители.
- Амортизацию оборудования, стоимость аренды, стоимость финансирования и предположения по перепродаже.
- SLA объекта, окна обслуживания и процедуры доступа.
- Операции платформы: образы, драйверы, стек CUDA, Kubernetes или Slurm, observability, security patching и реагирование на инциденты.
Колокация начинает иметь смысл, когда использование предсказуемо и высоко, у команды есть реальная компетенция в эксплуатации инфраструктуры, а контракт дает достаточную плотность мощности для поколения GPU, которое вы планируете использовать. Она не работает, когда команды покупают оборудование, но недооценивают remote hands, сеть, ограничения по мощности, запасные части и медленное расширение.
Для GPU-кластеров сетевая фабрика часто является той статьей, которая определяет архитектуру. Кластер, которому нужно тесно связанное обучение, не эквивалентен набору изолированных inference-узлов. Если нагрузка зависит от InfiniBand, RoCE, NVLink, NVSwitch или определенной схемы хранения, включите это в котировку и приемочные тесты.
On-premises: что учитывать
TCO GPU-кластера on-premises следует рассматривать как проект по созданию объекта, а не как покупку сервера.
Учитывайте:
- Все, что входит в модель колокации.
- Выделение пространства в data hall или его строительство.
- Электромонтажные работы, ИБП, генератор, распределение питания и система пожаротушения.
- Мощность системы охлаждения и ее обслуживание.
- Физическую безопасность и контроль доступа.
- Персонал объекта и эскалацию вне рабочего времени.
- Страхование, аудиты соответствия и процедуры безопасности.
- Долгосрочное планирование мощности для следующего поколения GPU.
- Упущенную выгоду капитала, связанного в объектах и оборудовании.
On-premises можно оправдать для организаций с уже развитой инфраструктурой дата-центров, высокой загрузкой, строгими требованиями к локальности или стратегическими требованиями к контролю. Это наименее удачный выбор, когда команда еще только выясняет состав моделей, длину контекста, целевую пропускную способность и соответствие продукта рынку.
Скрытый риск — смена поколений GPU. Решение о площадке может оказаться долговечнее, чем архитектура модели, которую вы обслуживаете. Если ваш TCO зависит от того, что одна семейство моделей останется доминирующим в течение трех лет, подвергните это предположение стресс-тесту.
Точка безубыточности по загрузке
Ключевой вопрос безубыточности:
required_utilization =
  owned_monthly_cost
  / equivalent_cloud_monthly_cost_at_100_percent_use
Если собственная инфраструктура стоит $X в месяц, а эквивалентная аренда в облаке при полной загрузке стоит $Y в месяц, то владение работает только если полезная загрузка выше X / Y. Под полезной загрузкой понимается работа, за которую в противном случае пришлось бы платить. Она не включает простаивающий запас, неудачные задания, резерв под очереди и мощность, зарезервированную на редкие пики.
Прогоните модель по трем сценариям:
| Сценарий | Что тестировать |
|---|---|
| Базовый случай | Ожидаемая нагрузка, ожидаемая загрузка, ожидаемый срок. |
| Негативный сценарий | Более низкая загрузка, отсрочка использования продукта, более слабая перепродажа, более высокая стоимость электроэнергии, более медленное принятие. |
| Стресс-сценарий | Новая модель не помещается в память, сетевая топология неверна или спрос смещается к managed API. |
Если негативный сценарий разрушает экономику, обычно безопаснее начать с облачной аренды или более короткого выделенного контракта.
Шаблон TCO для GPU-кластера, который можно скопировать
Используйте этот шаблон в документе по закупке. Заполните его один раз для облачной аренды, один раз для колокации и один раз для on-premises.
| Поле | Облачная аренда | Колокация | On-premises |
|---|---|---|---|
| Модель и количество GPU | |||
| Срок контракта | |||
| Ожидаемая полезная загрузка | |||
| Ежемесячная стоимость GPU-мощности | |||
| Хранение и резервное копирование | |||
| Передача данных и сеть | |||
| Питание и охлаждение | Включено или указано в предложении | ||
| Стойка, клетка или выделение площадки | N/A | ||
| Амортизация оборудования или лизинг | N/A | ||
| Удаленные руки / персонал | |||
| Поддержка, гарантия и запасные части | |||
| Наблюдаемость и инструменты платформы | |||
| Простой и потери на повторных попытках | |||
| Оценочный ежемесячный TCO | |||
| Знаменатель удельной стоимости | |||
| Стоимость за принятый результат | |||
| Срок поставки масштабирования | |||
| Стоимость выхода |
Не пропускайте последние две строки. Срок поставки масштабирования и стоимость выхода — это те места, где привлекательная экономика оборудования часто становится дорогой.
Вопросы по закупке, которые нужно задать каждому поставщику
Для облачной аренды:
- Указанная мощность общая, зарезервированная, выделенная или bare metal?
- Какие регион, зона доступности и размещение узлов гарантируются?
- Какие именно модель GPU, объем памяти, interconnect, CPU, RAM, локальное хранилище и сетевая fabric включены?
- Включены ли хранилище, snapshots, object storage, пропускная способность, публичные IP и поддержка?
- Что происходит, если кластер недоступен в течение срока контракта?
- Может ли провайдер запустить acceptance benchmark до начала обязательств?
- Как компенсируются неудачные задания, сбои платформы и окна обслуживания?
Для колокации:
- Какая плотность мощности законтрактована на стойку?
- Учет электроэнергии ведется по счетчику, по обязательству или она включена в цену стойки?
- Какие работы remote hands включены, а какие подлежат оплате?
- Какие операторы связи и private links доступны?
- Как быстро можно добавить стойки, питание и cross-connects?
- Кто владеет запасными частями, RMA и обслуживанием firmware?
- Какой acceptance test подтверждает, что кластер готов к production?
Для on-premises:
- Поддерживает ли объект уже целевую плотность мощности?
- Доступна ли мощность охлаждения без строительства?
- Кто отвечает за круглосуточную hardware response?
- Каков путь согласования для изменений в электрике, сети и безопасности?
- Каков срок амортизации и какая остаточная стоимость предполагается?
- Что происходит, если следующая модель требует больше памяти, большей пропускной способности или другого serving stack?
Матрица принятия решения
| Критерий | Облачная аренда | Колокация | On-premises |
|---|---|---|---|
| Скорость запуска | Лучше всего | Средняя | Самая медленная |
| Первоначальный капитал | Минимальный | От среднего до высокого | Максимальный |
| Эксплуатационная нагрузка | Минимальная | Средняя | Максимальная |
| Экономика при долгосрочной стабильной загрузке | Средняя | Сильная при хорошей эксплуатации | Сильная только при зрелой инфраструктуре |
| Гибкость по поколениям GPU | Лучше всего | Средняя | Минимальная |
| Контроль над инфраструктурой | Низкий | Средний | Максимальный |
| Обратимость закупки | Лучше всего | Средняя | Минимальная |
| Требование к бенчмарку | Важно | Критично | Критично |
Наиболее обоснованный ответ редко бывает «всегда облако» или «всегда покупка». Обычно это поэтапный подход: аренда для исследования, резервирование для стабильного спроса, колокация, когда загрузка подтверждена, и on-premises только тогда, когда контроль над инфраструктурой является частью требований.
Распространённые ошибки в моделях TCO GPU-кластера
Сравнение прайс-листа с лучшим сценарием владения
Корректная модель TCO GPU-кластера сравнивает реальные коммерческие предложения с реальной стоимостью владения. Прайс-лист облака — это не то же самое, что резервированная или согласованная мощность. Цена покупки оборудования — это не то же самое, что стоимость эксплуатации кластера.
Игнорирование утилизации
Купленный кластер с полезной утилизацией 40% может оказаться хуже облачного кластера с гораздо более высокой почасовой ставкой. Измеряйте полезную работу, а не количество установленных GPU.
Рассмотрение сетевой топологии как второстепенного фактора
Одного только числа GPU недостаточно для определения кластера. Обучение, fine-tuning и высокопроизводительный inference могут иметь совершенно разные требования к сети и хранилищу.
Забывание о потерях на повторных попытках
Повторные попытки, неудачные развёртывания, preemptions и низкокачественные результаты — всё это повышает удельную стоимость. Закладывайте потери на повторные попытки в знаменатель, а не только в числитель.
Недооценка стоимости людей
Драйверы, версии CUDA, контейнерные образы, планировщики, мониторинг, прошивки, обновления безопасности и реагирование на инциденты — всё это часть TCO GPU-кластера. Кто-то за это платит, даже если этого нет в коммерческом предложении.
Когда API модели лучше GPU-кластера
Выделенный GPU-кластер не всегда является правильной абстракцией. Если вашему продукту нужны только результаты модели, а не контроль над оборудованием, сравните TCO кластера с вариантом через API.
API моделей могут оказаться выгоднее, когда:
- Трафик носит всплесковый характер.
- Состав моделей часто меняется.
- Вам нужен доступ к нескольким frontier и open моделям.
- Команда не может поддерживать высокий уровень утилизации GPU.
- Фильтры качества и повторные попытки проще управляются на уровне запросов.
- Финансам нужны записи об использовании по запросам вместо инфраструктурного пула.
Flatkey здесь уместен, потому что одному и тому же покупателю часто нужны оба пути. Flatkey Compute помогает командам сравнивать доступную почасовую мощность GPU в реальном времени, публиковать анонимный спрос на GPU и получать предложения от поставщиков. Уровень model and tool API компании Flatkey даёт командам способ направлять AI-нагрузки через один ключ, один баланс и один журнал использования, когда владение GPU-слоем не требуется.
Практический рабочий процесс:
- Проведите бенчмарк нагрузки на арендованных GPU.
- Рассчитайте стоимость за принятый результат.
- Сравните ту же нагрузку через API моделей.
- Резервируйте или используйте колокацию только тогда, когда выделенное оборудование явно выигрывает при учёте негативных сценариев.
Контрольный список источников для вашей модели TCO GPU-кластера
Используйте актуальные страницы источников и документы с коммерческими предложениями, а не копируйте устаревшие тарифы из другой статьи.
| Тип источника | Что проверить |
|---|---|
| Страницы облачных GPU-провайдеров | Тип инстанса, количество GPU, регион, хранилище, сеть и то, является ли цена on-demand, reserved, spot или dedicated. |
| Технические характеристики GPU-вендора | Питание, память, interconnect, форм-фактор сервера и поддерживаемая топология. |
| Коммерческое предложение по колокации | Rack/cage, питание, remote hands, cross-connects, сеть, стоимость установки и ограничения на расширение. |
| Данные по коммунальным услугам или энергии | Допущения по цене электроэнергии и её росту. |
| Внутренние данные платформы | Реальная утилизация, задержка очереди, частота отказов, частота повторных попыток, объём принятого результата и время сотрудников. |
| Финансовые допущения | Срок амортизации, стоимость капитала, налоговый режим, остаточная стоимость и стоимость выхода из контракта. |
Полезные отправные точки:
- Flatkey Compute для актуального рыночного контекста почасовой мощности GPU и публикации спроса.
- Индекс цен Flatkey Compute для почасовых рыночных ориентиров.
- AWS EC2 P5 instances для контекста инфраструктуры H100 cloud cluster.
- Google Cloud GPU pricing для методологии ценообразования GPU по типу и региону.
- Lambda GPU Cloud для контекста цен на специализированные облачные GPU.
- RunPod pricing для проверки цен на marketplace и cloud GPU.
- NVIDIA DGX H100 и NVIDIA DGX B200 для технических характеристик систем вендора.
- данные U.S. Energy Information Administration по электроэнергии для допущений по стоимости энергии.
- FinOps FOCUS, если вашей финансовой команде нужны стандартизированные поля cloud cost.
Часто задаваемые вопросы
Что такое TCO GPU-кластера?
TCO GPU-кластера — это полная стоимость предоставления полезных AI-вычислений из кластера. Она включает GPU-емкость, хранилище, сеть, электроэнергию, охлаждение, трудозатраты, ПО, поддержку, простои, потери на повторные прогоны и риск капитала или контракта.
Всегда ли аренда GPU в облаке дороже, чем покупка GPU?
Нет. Аренда GPU в облаке может быть дешевле, когда загрузка неопределенна, задача краткосрочная, у команды не хватает операционной емкости или стек моделей быстро меняется. Покупка или размещение GPU в колокации выигрывает только тогда, когда полезная загрузка достаточно высока, чтобы компенсировать операционные расходы, электроэнергию, сеть, финансирование и риск выхода.
Когда колокация выгоднее облачной аренды?
Колокация может быть выгоднее облачной аренды, когда спрос стабилен, срок контракта длинный, плотность энергопотребления достаточна, оборудование используется эффективно, а команда может эксплуатировать кластер. Она не становится выгоднее облачной аренды только потому, что цена покупки оборудования выглядит ниже, чем прайс-листовый тариф облака.
Когда команде стоит выбрать GPU on-premises?
Выбирайте GPU on-premises, когда контроль над площадкой, локальность данных, соответствие требованиям или стратегическое владение инфраструктурой стоят операционной нагрузки. Для большинства команд, создающих AI-продукты, on-premises — это последний вариант, который нужно обосновать, а не вариант по умолчанию.
Как команды FinOps должны сравнивать варианты GPU-кластера?
Команды FinOps должны сравнивать варианты по стоимости на единицу полезного результата, а не только по почасовой ставке. В расчетной таблице должны быть учтены загрузка, потери на повторные прогоны, хранение данных, передача данных, стоимость людей, электроэнергия, срок контракта, время на расширение и стоимость выхода.
Какую роль Flatkey играет в TCO GPU-кластера?
Flatkey помогает командам избежать покупки неверного абстрактного уровня. Используйте Flatkey Compute, когда вам нужна GPU-емкость по рыночной цене или предложения поставщиков. Используйте слой API моделей и инструментов Flatkey, когда вам нужны только результаты модели, один ключ, один баланс и журнал использования на уровне запросов.
Итог
Лучшая модель TCO GPU-кластера — это не самая длинная таблица. Это та, которая делает три решения очевидными:
- Нужны ли вообще выделенные GPU для этой рабочей нагрузки.
- Что с учетом downside-кейса имеет лучшую стоимость: облачная аренда, колокация или on-premises.
- Будет ли контракт по-прежнему работать, когда меняются загрузка, состав моделей, энергопотребление и доступность.
Начните с арендованной емкости или живой рыночной котировки GPU, проведите бенчмарк на реальной рабочей нагрузке, нормализуйте по принятому результату и переходите к колокации или on-premises только тогда, когда математика полезной загрузки выдерживает downside-кейс.
Если ответ по-прежнему неочевиден, сохраняйте опциональность. TCO GPU-кластера вознаграждает команды, которые закупают емкость поэтапно, а не привязываются к оборудованию до того, как рабочая нагрузка докажет свою жизнеспособность.


