
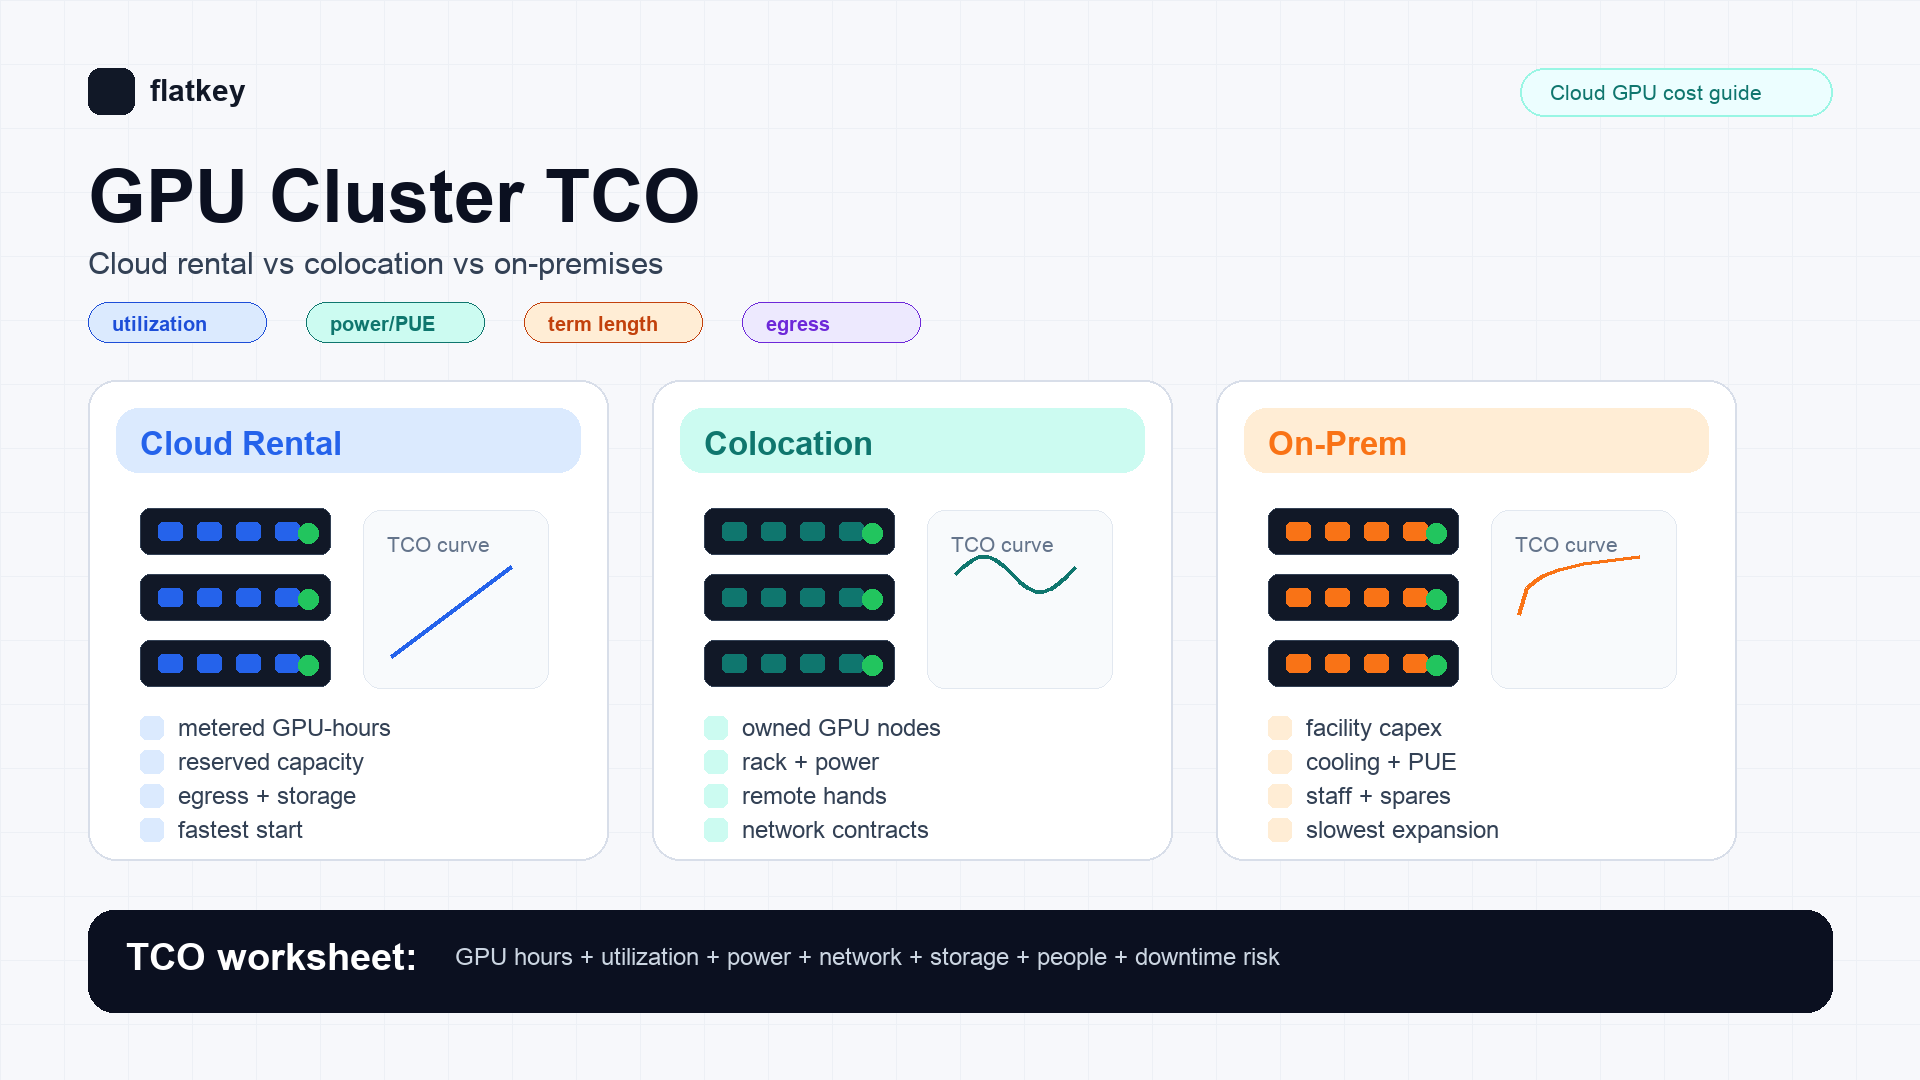
Sebagian besar perbandingan TCO klaster GPU gagal karena alasan yang sama: mereka membandingkan tarif per jam cloud dengan pesanan pembelian perangkat keras. Itu bukan keputusan yang sebenarnya.
Keputusan yang sesungguhnya adalah apakah tim AI Anda harus membeli fleksibilitas, membeli perangkat keras, atau membeli kendali atas fasilitas. Model TCO klaster GPU yang serius harus menormalkan sewa cloud, colocation, dan on-premises terhadap keluaran yang sama: training run yang selesai, token inferensi yang diterima, pekerjaan pembuatan media yang dihasilkan, atau bulan kapasitas yang dipesan.
Untuk sebagian besar tim, sewa GPU cloud menang saat pemakaian tidak pasti, kecepatan peluncuran penting, atau beban kerja berubah menurut keluarga model. Colocation mulai menang saat permintaan stabil, tim mampu mengoperasikan perangkat keras, dan kontraknya cukup panjang untuk mengamortisasi GPU, jaringan, suku cadang, dan dukungan hands-on jarak jauh. On-premises biasanya membutuhkan justifikasi terkuat: pemakaian yang sangat tinggi dan dapat diprediksi, operasi pusat data yang sudah ada, persyaratan lokalitas yang ketat, atau mandat strategis untuk memiliki lapisan fasilitasnya sendiri.
Aturan praktis Flatkey: mulai dari beban kerja, bukan rack. Jika beban kerja bisa dilayani oleh API model terkelola, bandingkan itu terlebih dahulu. Jika Anda benar-benar membutuhkan GPU khusus, hargai sewa cloud, colocation, dan on-premises dengan lembar kerja yang sama sebelum menandatangani kontrak kapasitas.
Jawaban singkat TCO klaster GPU
Gunakan tabel keputusan awal ini sebelum membangun model penuh.
| Situasi | Biasanya mulai dengan | Mengapa |
|---|---|---|
| Prototipe, fine-tuning yang meledak-ledak, jendela benchmark singkat | Sewa GPU cloud | Komitmen paling rendah dan jalur tercepat untuk mendapatkan kapasitas. |
| Armada inferensi multi-bulan yang stabil dengan campuran model yang diketahui | Kapasitas terreservasi cloud atau colocation | Pemakaian cukup tinggi untuk menegosiasikan harga jangka waktu, tetapi risiko kepemilikan mungkin masih bisa dihindari. |
| Pekerjaan training besar dengan persyaratan topologi jaringan yang ketat | Klaster cloud khusus atau colocation | Anda memerlukan penempatan node yang dapat diprediksi, fabric jaringan, lokalitas storage, dan penerimaan benchmark. |
| Pemakaian multi-tahun di atas tingkat hambatan internal Anda | Colocation atau on-premises | Amortisasi perangkat keras bisa mengalahkan sewa per jam hanya jika waktu menganggur, operasi, daya, dan downtime dihitung dengan jujur. |
| Lokalitas data yang diatur atau mandat kendali fasilitas | On-premises atau colocation terkendali | Keputusan TCO mencakup kepatuhan dan kendali, bukan hanya harga komputasi. |
| Aplikasi hanya membutuhkan output model, bukan kendali GPU | API model atau penawaran pasar GPU | Membeli klaster bisa berlebihan ketika metrik bisnisnya adalah biaya per output yang diterima. |
Bagian selanjutnya dari panduan ini menunjukkan cara membangun lembar kerja TCO klaster GPU yang bisa digunakan oleh procurement, platform engineering, dan finance.
Normalkan setiap opsi ke satu unit
Jangan membandingkan "H100 per jam" dengan "harga beli server." Pilih satu penyebut dan paksa setiap opsi masuk ke dalamnya.
Penyebut yang berguna meliputi:
- Biaya per training run yang selesai: paling baik untuk fine-tuning berkala, eksperimen pretraining, dan pekerjaan batch.
- Biaya per output yang diterima: paling baik untuk inferensi LLM, pembuatan kode, pembuatan gambar, dan pipeline video yang melibatkan retry.
- Biaya per GPU-bulan yang dipesan: paling baik untuk tim platform yang membeli kapasitas internal untuk banyak tim produk.
- Biaya per token atau pekerjaan yang memenuhi SLA: paling baik ketika downtime, preemption, atau antrian menunggu mengubah keandalan yang terlihat oleh pengguna.
Untuk inferensi, penyebut yang paling bersih sering kali adalah:
effective_cost_per_accepted_output =
  total_monthly_cluster_cost
  / accepted_outputs_after_retries_and_quality_filters
Penyebut itu menangkap dua hal yang disembunyikan oleh harga per jam: pekerjaan yang gagal dan kapasitas menganggur.
Rumus TCO klaster GPU
Gunakan model ini sebelum menambahkan detail spesifik penyedia:
monthly_gpu_cluster_tco =
  capacity_cost
  + storage_cost
  + data_transfer_cost
  + network_and_interconnect_cost
  + software_and_observability_cost
  + labor_and_operations_cost
  + support_and_warranty_cost
  + financing_or_depreciation_cost
  + downtime_and_retry_waste
Kemudian ubah menjadi unit yang Anda pedulikan:
unit_cost =
  monthly_gpu_cluster_tco
  / useful_work_completed_per_month
Ini penting karena GPU-hour yang murah tetap bisa mahal jika klaster kurang dimanfaatkan, jika pekerjaan menunggu di antrean, jika storage berada di region yang salah, atau jika run yang gagal menghabiskan waktu dengan tarif penuh.
Komponen biaya menurut model deployment
| Biaya | Sewa cloud | Colocation | On-premises |
|---|---|---|---|
| Kapasitas GPU | On-demand, spot, reserved, dedicated, atau penawaran pasar. | Pembelian atau sewa perangkat keras plus kontrak rack. | Pembelian atau sewa perangkat keras plus alokasi fasilitas internal. |
| Daya dan pendinginan | Biasanya sudah termasuk dalam tarif, tetapi tidak gratis. | Daya yang dikontrakkan, daya terukur, overhead pendinginan, dan batas kepadatan daya. | Daya utilitas, UPS, generator, plant pendingin, dan eksposur PUE. |
| Jaringan | Egress, private links, IP publik, traffic lintas wilayah, interconnect. | Transit, cross-connect, private links, akses jarak jauh, layanan DDoS/keamanan. | WAN, transit internet, private links, firewall, switching, jalur redundan. |
| Penyimpanan | Block, object, filesystem, snapshot, backup, tier IOPS. | Local NVMe, shared storage, target backup, replikasi jarak jauh. | Perangkat keras penyimpanan, backup, replikasi, penggantian media, operasi siklus hidup. |
| Operasi | Terutama integrasi platform dan kontrol biaya. | Siklus hidup perangkat keras, remote hands, pengujian penerimaan, suku cadang, koordinasi RMA. | Operasi fasilitas dan perangkat keras penuh, akses fisik, suku cadang, cakupan di luar jam kerja. |
| Risiko komitmen | Rendah untuk on-demand; lebih tinggi untuk kontrak reserved atau dedicated. | Sedang hingga tinggi. Keberhentian kontrak dan penjualan kembali perangkat keras sangat berpengaruh. | Tertinggi. Keputusan fasilitas dan peralatan dapat melampaui roadmap model. |
Sewa cloud terlihat sederhana karena banyak biaya dibundel ke dalam tarif. Colocation dan on-premises tampak lebih murah ketika spreadsheet melupakan orang, daya, jaringan, dan anggaran kegagalan.
Sewa cloud: apa yang harus dihitung
Sewa cloud adalah baseline paling bersih untuk TCO klaster GPU karena mengubah kapasitas menjadi layanan terukur. Itu tidak berarti tarif per jam adalah seluruh biaya.
Hitung:
- Tarif per jam instance GPU atau bare metal.
- Ketentuan kapasitas reserved, committed, atau dedicated.
- Penyimpanan yang terpasang pada klaster.
- Penyimpanan object dan retensi snapshot.
- Transfer data dan egress.
- Networking private, load balancer, IP publik, dan NAT.
- Scheduler, Kubernetes, Slurm, observability, logging, dan alerting.
- Waktu idle akibat celah antrean, deployment gagal, cold start, dan poor bin packing.
- Pemborosan retry spot atau interruptible, jika digunakan.
- Rencana dukungan dan biaya manajemen akun.
Sewa cloud biasanya unggul ketika kurva permintaan tim tidak pasti. Ini juga memberi pengadaan patokan harga terkini. Halaman penyedia publik dari AWS, Google Cloud, Lambda, RunPod, dan cloud GPU lainnya berguna sebagai cek sumber, tetapi satu-satunya angka yang penting untuk klaster besar adalah penawaran yang benar-benar bisa Anda reserve untuk wilayah, topologi, dan jangka waktu yang Anda butuhkan.
Gunakan halaman resmi sebagai titik pemeriksaan:
- AWS menjelaskan infrastruktur kelas P5 untuk beban kerja AI skala besar pada halaman instance EC2 P5.
- Google Cloud mempublikasikan harga GPU dan mencatat bahwa harga bergantung pada jenis GPU, wilayah, dan model penggunaan.
- Lambda dan RunPod mempublikasikan permukaan harga cloud GPU yang berguna untuk cek pasar cepat.
- Flatkey Compute mempublikasikan indeks harga GPU per jam secara langsung dan memungkinkan pembeli memasang permintaan GPU anonim agar pemasok terverifikasi dapat menawar.
Perlakukan setiap harga sebagai berstempel waktu. Ketersediaan GPU dan tarif per jam bergerak lebih cepat daripada harga SaaS biasa.
Colocation: apa yang harus dihitung
Colocation bukan sekadar "cloud, tetapi lebih murah." Ini memindahkan sebagian besar beban operasional dari penyedia ke tim Anda.
Hitung:
- Server GPU, adaptor jaringan, switch, optic, kabel, dan penyimpanan.
- Biaya rack atau cage.
- Daya yang dikontrakkan dan daya terukur.
- Pendinginan dan batas kepadatan.
- Cross-connect, transit internet, private links, dan keamanan jaringan.
- Remote hands, pengiriman, penerimaan, instalasi, inventaris, dan penanganan RMA.
- GPU cadangan, catu daya, NIC, optic, kipas, dan drive penyimpanan.
- Penyusutan perangkat keras, biaya sewa, biaya pembiayaan, dan asumsi nilai jual kembali.
- SLA fasilitas, jendela pemeliharaan, dan prosedur akses.
- Operasi platform: image, driver, stack CUDA, Kubernetes atau Slurm, observability, patch keamanan, dan respons insiden.
Colocation mulai masuk akal ketika utilisasi dapat diprediksi dan tinggi, tim memiliki kemampuan operasi infrastruktur yang nyata, dan kontraknya memberi kepadatan daya yang cukup untuk generasi GPU yang ingin Anda jalankan. Ini gagal ketika tim membeli perangkat keras tetapi meremehkan remote hands, jaringan, kendala daya, suku cadang, dan ekspansi yang lambat.
Untuk klaster GPU, fabric jaringan sering kali menjadi item biaya yang menentukan arsitektur. Klaster yang membutuhkan training tightly coupled tidak sama dengan sekumpulan node inference yang terisolasi. Jika workload bergantung pada InfiniBand, RoCE, NVLink, NVSwitch, atau tata letak penyimpanan tertentu, masukkan itu ke bagian penawaran dan pengujian penerimaan.
On-premises: apa yang harus dihitung
TCO klaster GPU on-premises harus diperlakukan sebagai proyek fasilitas, bukan pembelian server.
Hitung:
- Segala sesuatu dalam model colocation.
- Alokasi ruang data hall atau buildout.
- Pekerjaan listrik, UPS, generator, distribusi daya, dan pemadaman kebakaran.
- Kapasitas dan pemeliharaan plant pendingin.
- Keamanan fisik dan kontrol akses.
- Staf fasilitas dan eskalasi di luar jam kerja.
- Asuransi, audit kepatuhan, dan prosedur keselamatan.
- Perencanaan kapasitas jangka panjang untuk generasi GPU berikutnya.
- Biaya peluang modal yang terikat pada fasilitas dan perangkat keras.
On-premises dapat dibenarkan untuk organisasi yang sudah memiliki kapabilitas data center, utilisasi tinggi, persyaratan locality yang ketat, atau mandat kontrol strategis. Ini adalah pilihan yang paling lemah ketika tim masih sedang menemukan campuran model, context length, target throughput, dan product-market fit.
Risiko tersembunyi adalah turnover generasi GPU. Keputusan fasilitas dapat bertahan lebih lama daripada arsitektur model yang Anda layani. Jika TCO Anda bergantung pada satu keluarga model tetap dominan selama tiga tahun, uji secara stres asumsi tersebut.
Utilisasi titik impas
Pertanyaan break-even inti adalah:
required_utilization =
  owned_monthly_cost
  / equivalent_cloud_monthly_cost_at_100_percent_use
Jika infrastruktur milik sendiri biayanya $X per bulan dan sewa cloud yang setara pada utilisasi penuh biayanya $Y per bulan, maka kepemilikan hanya berhasil jika utilisasi yang berguna berada di atas X / Y. Utilisasi yang berguna berarti pekerjaan yang jika tidak demikian akan dibayar. Ini tidak termasuk inventaris menganggur, job yang gagal, padding antrean, dan kapasitas yang disisihkan untuk lonjakan langka.
Jalankan model dalam tiga skenario:
| Skenario | Apa yang diuji |
|---|---|
| Kasus dasar | Beban kerja yang diharapkan, utilisasi yang diharapkan, jangka waktu yang diharapkan. |
| Kasus downside | Utilisasi lebih rendah, penggunaan produk tertunda, resale lebih lemah, daya lebih mahal, adopsi lebih lambat. |
| Kasus stres | Model baru tidak muat di memori, topologi jaringan salah, atau permintaan bergeser ke managed API. |
Jika kasus downside menghancurkan ekonominya, sewa cloud atau kontrak dedicated yang lebih pendek biasanya merupakan langkah awal yang lebih aman.
Lembar kerja TCO klaster GPU yang dapat disalin
Gunakan worksheet ini dalam dokumen pengadaan Anda. Isi sekali untuk sewa cloud, sekali untuk colocation, dan sekali untuk on-premises.
| Field | Sewa cloud | Colocation | On-premises |
|---|---|---|---|
| Model GPU dan jumlah | |||
| Jangka kontrak | |||
| Utilisasi berguna yang diharapkan | |||
| Biaya kapasitas GPU bulanan | |||
| Penyimpanan dan backup | |||
| Transfer data dan jaringan | |||
| Daya dan pendinginan | Sudah termasuk atau dikutip | ||
| Rak, cage, atau alokasi fasilitas | N/A | ||
| Amortisasi atau sewa hardware | N/A | ||
| Remote hands / staf | |||
| Dukungan, garansi, dan suku cadang | |||
| Observability dan tooling platform | |||
| Downtime dan pemborosan retry | |||
| Estimasi TCO bulanan | |||
| Denominator biaya per unit | |||
| Biaya per output yang diterima | |||
| Lead time ekspansi | |||
| Biaya keluar |
Jangan melewatkan dua baris terakhir. Lead time ekspansi dan biaya keluar adalah area di mana ekonomi hardware yang menarik sering berubah menjadi mahal.
Pertanyaan pengadaan untuk setiap pemasok
Untuk sewa cloud:
- Apakah kapasitas yang dikutip bersifat shared, reserved, dedicated, atau bare metal?
- Region, availability zone, dan penempatan node mana yang dijamin?
- Model GPU, ukuran memori, interconnect, CPU, RAM, local storage, dan network fabric apa yang disertakan secara spesifik?
- Apakah storage, snapshot, object storage, bandwidth, public IP, dan support sudah termasuk?
- Apa yang terjadi jika cluster tidak tersedia selama masa kontrak?
- Apakah provider dapat menjalankan benchmark penerimaan sebelum komitmen dimulai?
- Bagaimana job yang gagal, outage platform, dan maintenance window dikreditkan?
Untuk colocation:
- Berapa density daya yang dikontrakkan per rak?
- Apakah daya diukur dengan meter, dikomitmenkan, atau digabungkan ke harga rak?
- Pekerjaan remote hands apa yang termasuk, dan apa yang dapat ditagihkan?
- Carrier dan private link apa yang tersedia?
- Seberapa cepat rak tambahan, daya, dan cross-connect dapat disediakan?
- Siapa yang memiliki suku cadang, RMA, dan maintenance firmware?
- Apa acceptance test yang memastikan cluster siap produksi?
Untuk on-premises:
- Apakah fasilitas sudah mendukung density daya target?
- Apakah kapasitas pendinginan tersedia tanpa pembangunan tambahan?
- Siapa yang bertanggung jawab atas respons hardware 24/7?
- Apa jalur persetujuan untuk perubahan listrik, jaringan, dan keamanan?
- Berapa periode depresiasi, dan berapa nilai jual kembali yang diasumsikan?
- Apa yang terjadi jika model berikutnya memerlukan lebih banyak memori, lebih banyak bandwidth, atau stack serving yang berbeda?
Matriks keputusan
| Kriteria | Sewa cloud | Colocation | On-premises |
|---|---|---|---|
| Kecepatan mulai | Terbaik | Sedang | Terlambat |
| Modal awal | Terendah | Sedang hingga tinggi | Tertinggi |
| Beban operasional | Terendah | Sedang | Tertinggi |
| Ekonomi pemanfaatan stabil jangka panjang | Sedang | Kuat jika dioperasikan dengan baik | Kuat hanya dengan kematangan fasilitas |
| Fleksibilitas menurut generasi GPU | Terbaik | Sedang | Terendah |
| Kontrol fasilitas | Rendah | Sedang | Tertinggi |
| Reversibilitas pengadaan | Terbaik | Sedang | Terendah |
| Persyaratan benchmark | Penting | Kritis | Kritis |
Jawaban yang paling dapat dipertahankan jarang sekali adalah "selalu cloud" atau "selalu beli." Biasanya ini adalah pendekatan bertahap: sewa untuk eksplorasi, reservasi untuk permintaan yang stabil, colocation ketika utilisasi terbukti, dan gunakan on-premises hanya ketika kontrol fasilitas merupakan bagian dari kebutuhan.
Kesalahan umum dalam model TCO klaster GPU
Membandingkan harga daftar dengan kepemilikan dalam skenario terbaik
Model TCO klaster GPU yang adil membandingkan penawaran nyata dengan biaya kepemilikan nyata. Harga daftar cloud tidak sama dengan kapasitas terreservasi atau yang dinegosiasikan. Harga pembelian perangkat keras tidak sama dengan biaya klaster yang dioperasikan.
Mengabaikan utilisasi
Klaster milik sendiri dengan utilisasi efektif 40% dapat kalah dari klaster cloud dengan tarif per jam yang jauh lebih tinggi. Ukur pekerjaan yang efektif, bukan GPU yang terpasang.
Menganggap topologi jaringan sebagai hal sekunder
Jumlah GPU saja tidak mendefinisikan sebuah klaster. Training, fine-tuning, dan inference berthroughput tinggi dapat memiliki kebutuhan jaringan dan penyimpanan yang sangat berbeda.
Lupa memperhitungkan pemborosan akibat retry
Retry, deployment yang gagal, preemption, dan output berkualitas rendah semuanya menaikkan biaya per unit. Masukkan pemborosan retry ke dalam penyebut, bukan hanya pembilang.
Meremehkan biaya tenaga kerja
Driver, versi CUDA, image container, scheduler, pemantauan, patch firmware, keamanan, dan respons insiden adalah bagian dari TCO klaster GPU. Seseorang membayarnya bahkan ketika tidak tercantum dalam penawaran.
Kapan API model mengungguli klaster GPU
Klaster GPU khusus tidak selalu menjadi abstraksi yang tepat. Jika produk Anda hanya membutuhkan output model, bukan kontrol perangkat keras, bandingkan TCO klaster dengan jalur API.
API model dapat lebih unggul ketika:
- Lalu lintas bersifat sporadis.
- Campuran model sering berubah.
- Anda membutuhkan akses ke beberapa model frontier dan open model.
- Tim tidak dapat menjaga utilisasi GPU tetap tinggi.
- Filter kualitas dan retry lebih mudah dikelola di layer permintaan.
- Tim finance menginginkan catatan penggunaan per permintaan, bukan kumpulan infrastruktur.
Flatkey relevan di sini karena pembeli yang sama sering membutuhkan kedua jalur. Flatkey Compute membantu tim membandingkan kapasitas GPU-hour langsung, memposting permintaan GPU secara anonim, dan menerima tawaran dari pemasok. Lapisan API model dan tool dari Flatkey memberi tim cara untuk merutekan beban kerja AI melalui satu kunci, satu saldo, dan satu buku besar penggunaan ketika memiliki layer GPU tidak diperlukan.
Alur kerja praktisnya adalah:
- Benchmark beban kerja pada GPU sewaan.
- Hitung biaya per output yang diterima.
- Bandingkan beban kerja yang sama melalui API model.
- Lakukan reservasi atau colocation hanya ketika perangkat keras khusus jelas menang dalam asumsi skenario terburuk.
Daftar sumber untuk model TCO klaster GPU Anda
Gunakan halaman sumber dan dokumen penawaran yang terbaru, bukan menyalin tarif usang dari artikel lain.
| Jenis sumber | Yang perlu diverifikasi |
|---|---|
| Halaman penyedia GPU cloud | Jenis instance, jumlah GPU, region, penyimpanan, jaringan, dan apakah harga bersifat on-demand, terreservasi, spot, atau dedicated. |
| Spesifikasi sistem vendor GPU | Daya, memori, interconnect, form factor server, dan topologi yang didukung. |
| Penawaran colocation | Rack/cage, daya, remote hands, cross-connect, jaringan, biaya instalasi, dan batas ekspansi. |
| Data utilitas atau energi | Asumsi harga listrik dan eskalasinya. |
| Data platform internal | Utilisasi nyata, penundaan antrean, tingkat kegagalan, tingkat retry, volume output yang diterima, dan waktu staf. |
| Asumsi keuangan | Periode depresiasi, biaya modal, perlakuan pajak, nilai sisa, dan biaya keluar kontrak. |
Rujukan awal yang berguna:
- Flatkey Compute untuk konteks pasar GPU-hour langsung dan posting permintaan.
- Indeks harga Flatkey Compute untuk pemeriksaan referensi pasar per jam.
- AWS EC2 P5 instances untuk konteks infrastruktur klaster cloud H100.
- Harga GPU Google Cloud untuk metodologi harga GPU menurut tipe dan region.
- Lambda GPU Cloud untuk konteks harga GPU cloud spesialis.
- Harga RunPod untuk pemeriksaan harga GPU marketplace dan cloud.
- NVIDIA DGX H100 dan NVIDIA DGX B200 untuk spesifikasi sistem vendor.
- Data listrik U.S. Energy Information Administration untuk asumsi biaya daya.
- FinOps FOCUS jika tim finance Anda membutuhkan field biaya cloud yang terstandarisasi.
Pertanyaan yang sering diajukan
Apa itu TCO klaster GPU?
TCO klaster GPU adalah total biaya untuk menghadirkan komputasi AI yang berguna dari sebuah klaster. Ini mencakup kapasitas GPU, penyimpanan, jaringan, daya, pendinginan, tenaga kerja, perangkat lunak, dukungan, waktu henti, pemborosan akibat retry, serta risiko modal atau kontrak.
Apakah sewa GPU cloud selalu lebih mahal daripada membeli GPU?
Tidak. Sewa GPU cloud bisa lebih murah ketika pemanfaatannya tidak pasti, beban kerja bersifat jangka pendek, tim tidak memiliki kapasitas operasional, atau tumpukan model berubah dengan cepat. Membeli atau menempatkan GPU di colocation hanya unggul ketika pemanfaatan yang berguna cukup tinggi untuk menutupi operasional, daya, jaringan, pembiayaan, dan risiko keluar.
Kapan colocation mengalahkan sewa cloud?
Colocation dapat mengalahkan sewa cloud ketika permintaan stabil, jangka kontrak panjang, kepadatan daya memadai, perangkat keras dimanfaatkan dengan baik, dan tim mampu mengoperasikan klaster. Colocation tidak mengalahkan sewa cloud hanya karena harga beli perangkat keras terlihat lebih rendah daripada tarif daftar cloud.
Kapan tim harus memilih GPU on-premises?
Pilih GPU on-premises ketika kontrol fasilitas, lokasi data, kepatuhan, atau kepemilikan infrastruktur strategis sepadan dengan beban operasionalnya. Bagi sebagian besar tim produk AI, on-premises adalah opsi terakhir untuk dibenarkan, bukan pilihan default.
Bagaimana tim FinOps seharusnya membandingkan opsi klaster GPU?
Tim FinOps harus membandingkan opsi berdasarkan biaya per output yang berguna, bukan hanya tarif per jam. Lembar kerja harus mencakup pemanfaatan, pemborosan akibat retry, penyimpanan, transfer data, biaya tenaga kerja, daya, jangka kontrak, waktu tunggu ekspansi, dan biaya keluar.
Di mana Flatkey berperan dalam TCO klaster GPU?
Flatkey membantu tim menghindari pembelian abstraksi yang salah. Gunakan Flatkey Compute ketika Anda membutuhkan kapasitas GPU dengan harga pasar atau penawaran dari pemasok. Gunakan lapisan API model dan alat milik Flatkey ketika Anda hanya membutuhkan output model, satu kunci, satu saldo, dan buku besar penggunaan di tingkat permintaan.
Intinya
Model TCO klaster GPU terbaik bukanlah spreadsheet yang paling panjang. Model terbaik adalah yang membuat tiga keputusan berikut menjadi jelas:
- Apakah beban kerja benar-benar membutuhkan GPU khusus atau tidak.
- Apakah sewa cloud, colocation, atau on-premises memiliki biaya terbaik yang sudah disesuaikan dengan sisi negatifnya.
- Apakah kontrak masih tetap layak ketika pemanfaatan, campuran model, daya, dan ketersediaan berubah.
Mulailah dengan kapasitas sewaan atau kutipan pasar GPU langsung, benchmark beban kerja yang sebenarnya, normalisasi berdasarkan output yang diterima, dan hanya beralih ke colocation atau on-premises ketika matematika pemanfaatan yang berguna tetap bertahan dalam skenario terburuk.
Jika jawabannya masih belum pasti, pertahankan nilai opsinya. TCO klaster GPU menguntungkan tim yang membeli kapasitas secara bertahap, bukan mengunci diri ke perangkat keras sebelum beban kerja benar-benar terbukti.


