
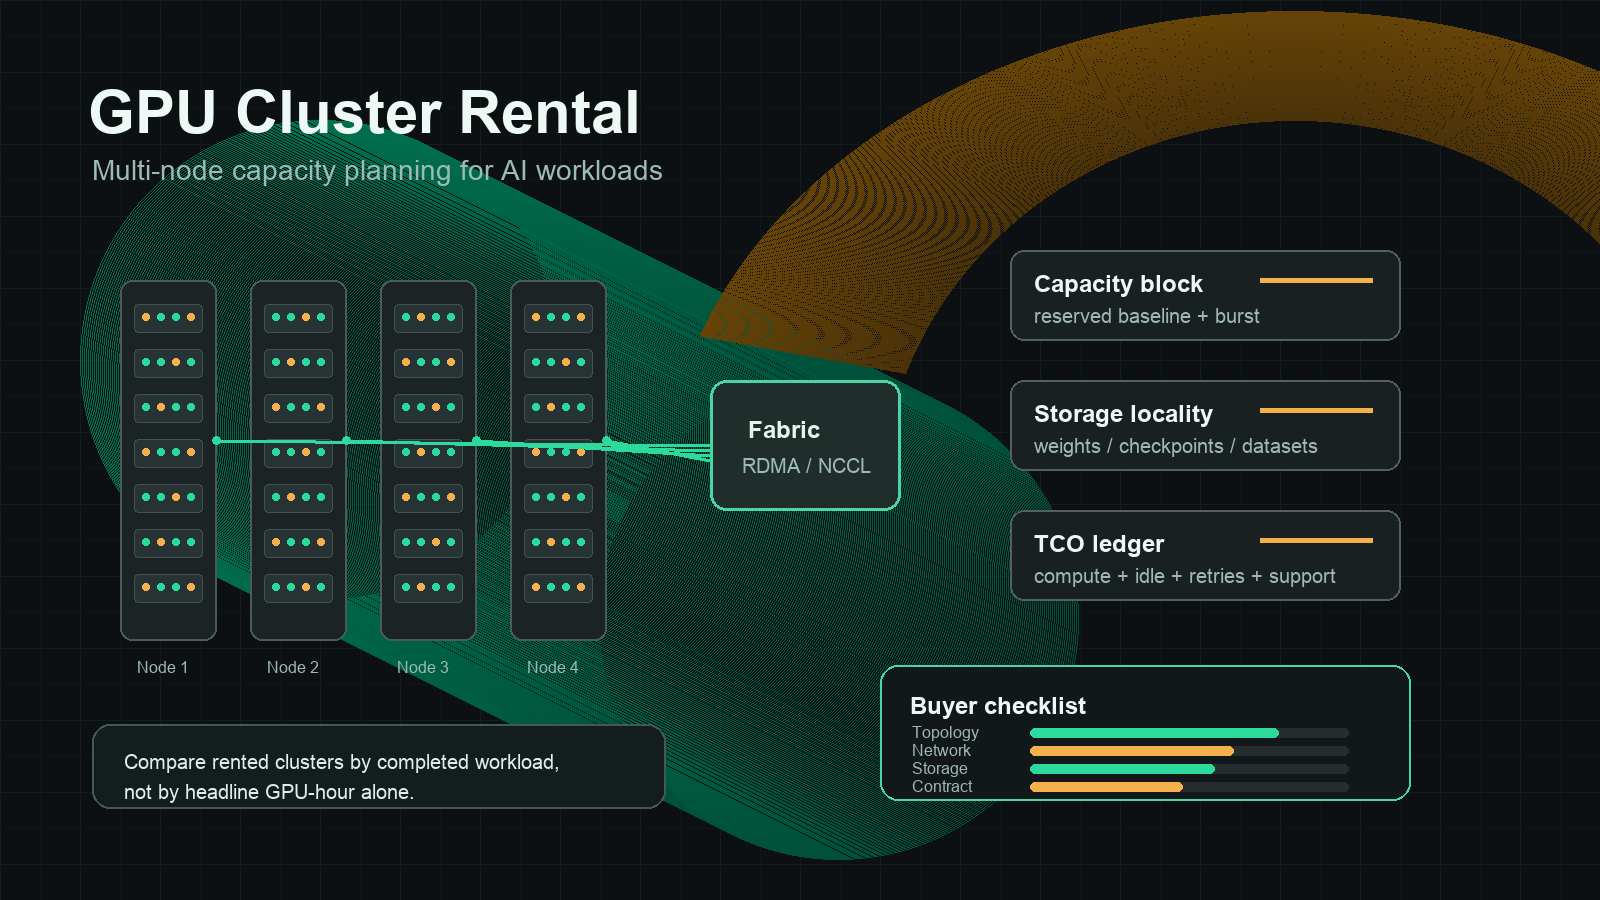
GPU-Cluster-Miete: Ein Kaufratgeber für Multi-Node-KI-Kapazitäten
Die Miete eines GPU-Clusters wird attraktiv, wenn eine GPU, ein Node oder ein Provider-Account nicht mehr ausreicht. Vielleicht benötigt ein Trainingslauf acht bis vierundsechzig GPUs, die über Netzwerke mit geringer Latenz verbunden sind. Vielleicht hat der Inference-Traffic eine stabile Grundlast und einen starken Burst in der Launch-Woche. Vielleicht möchte der Einkauf garantierte H100-, H200-, B200- oder L40S-Kapazität, ohne Hardware zu kaufen, ein Rechenzentrumsteam einzustellen und die Vorlaufzeiten der Lieferkette abzuwarten.
Das Schwierige daran ist, dass ein „GPU-Cluster“ nicht ein einzelnes Produkt ist. Ein Angebot kann eine Hyperscaler-Reservierung, eine spezialisierte Zuweisung in einer GPU-Cloud, einen Bare-Metal-Cluster, einen Marketplace-Fleet, ein verwaltetes Kubernetes-Setup oder einen privaten Kapazitätsblock bedeuten. Der stündliche GPU-Preis ist nur die erste Kostenposition.
Dieser Leitfaden gibt Enterprise-KI-Teams eine praktische Methode, um gpu cluster rental-Optionen zu bewerten, gpu cluster rental cloud providers zu vergleichen und zu entscheiden, wann man mieten, reservieren, kaufen oder stattdessen eine Modell-API verwenden sollte.
Die kurze Antwort
Nutzen Sie GPU-Cluster-Miete, wenn Ihr Workload mindestens einen dieser Bedarfe hat:
| Bedarf | Warum das auf einen Cluster hindeutet |
|---|---|
| Multi-GPU-Training | Das Modell, die Batchgröße oder die Fine-Tuning-Methode benötigt mehr Speicher oder Durchsatz, als ein Node bereitstellen kann. |
| Multi-Node-Inference | Sie benötigen hohe Basiskapazität, Mandantenisolation oder vorhersehbare Warteschlangenzeit für Produktions-Traffic. |
| Stabile Auslastung | Dieselbe GPU-Klasse bleibt lange genug ausgelastet, um reservierte oder dedizierte Kapazität zu rechtfertigen. |
| Netzwerkempfindliche Jobs | Verteiltes Training, geshardetes Serving oder große Embedding-/Index-Workloads benötigen bekannte Platzierung und erwartbares Fabric-Verhalten. |
| Einkaufssteuerung | Die Finanzabteilung benötigt ein festes Budget, Supportbedingungen, Region, Compliance-Umfang und Verlängerungsdatum. |
Wählen Sie gpu cluster rental nicht nur deshalb, weil eine große GPU pro Stunde günstiger erscheint. Wählen Sie es, wenn der abgeschlossene Workload unter Einbeziehung von Netzwerk, Speicher, Auslastung, Neustart-Risiko, Support, Betrieb und Vertragsbedingungen günstiger oder sicherer ist.
reale Clusterkosten pro nutzbarem Output =
  (Compute + Speicher + Netzwerk + Leerlaufzeit + Wiederholungen + Support + Engineering-Overhead)
  / akzeptierte Trainingsläufe, Inference-Tokens, Jobs, Bilder oder Kundenanfragen
Was gilt als GPU-Cluster-Miete?
GPU-Cluster-Miete kann mehrere Kaufmodelle beschreiben. Halten Sie diese bei der Bewertung getrennt.
| Mietmodell | Am besten geeignet für | Hauptrisiko |
|---|---|---|
| Single-Node-Multi-GPU-Server | Frühes Training, Fine-Tuning, Batch-Jobs, Experimente eines Teams | Wächst leicht aus; Netzwerkannahmen lassen sich nicht auf Multi-Node-Läufe übertragen. |
| Multi-Node-On-Demand-Cluster | Kurzfristige Projekte, Benchmark-Fenster, Burst-Kapazität | Die Verfügbarkeit kann je nach Region und GPU-Familie variieren. |
| Reservierter oder dedizierter Cluster | Produktions-Inference, geplanter Trainingskalender, Launch-Fenster | Auslastungsrisiko, wenn sich die Nachfrage ändert oder eine neuere GPU-Klasse die Wirtschaftlichkeit verschiebt. |
| GPU-Fleet im Marketplace | Experimente, flexible Batch-Jobs, günstigere opportunistische Kapazität | Host-Zuverlässigkeit, Datenbewegung, Unterbrechungen und Support können variieren. |
| Verwaltetes Kubernetes- oder Slurm-Cluster | Plattformteams, die wiederholbare Planung und Governance benötigen | Sie sind weiterhin verantwortlich für Workload-Packaging, Observability, Kostenkontrolle und Incident Response. |
| Modell-API oder serverless Inference | Teams, die Ausgaben benötigen, nicht Hardware-Kontrolle | Weniger Kontrolle über Gewichte, Kernel, Platzierung und den Low-Level-Serving-Stack. |
Deshalb hat die Suchanfrage „gpu cluster rental or cloud gpu cluster“ normalerweise eine geteilte Kaufabsicht. Manche Teams benötigen physische Kapazität, die sie terminieren können. Andere brauchen verlässliche KI-Ausgaben und sollten GPUs nicht direkt betreiben.
Beginnen Sie mit dem Workload, nicht mit dem Anbieter
Bevor Sie gpu cluster rental cloud providers vergleichen, erstellen Sie ein einseitiges Kapazitätsbriefing. Ein Anbieterangebot ist nur dann aussagekräftig, wenn jeder Vendor dieselbe Workload-Form sieht.
| Kurzes Feld | Was anzugeben ist |
|---|---|
| Workload-Typ | Pretraining, Fine-Tuning, Retrieval Embedding, Batch-Inferenz, Online-Inferenz, Bild-/Videogenerierung, Simulation oder Forschungs-Notebooks. |
| Modell und Framework | Modellfamilie, Parameteranzahl, Präzision, Quantisierung, PyTorch/JAX, vLLM, SGLang, TensorRT-LLM, Ray, Kubernetes, Slurm oder ein anderer Scheduler. |
| GPU-Ziel | H100 SXM, H100 PCIe, H200, B200, A100, L40S, RTX 4090, RTX PRO 6000 oder eine Spanne akzeptabler Alternativen. |
| Cluster-Form | GPUs pro Node, Node-Anzahl, Speicher pro GPU, CPU/RAM-Verhältnis, lokales NVMe und ob Jobs eine Placement Group benötigen. |
| Netzwerkbedarf | NVLink/NVSwitch innerhalb des Nodes, InfiniBand oder RoCE zwischen den Nodes, Zielwert für All-Reduce-Bandbreite und akzeptabler Jitter. |
| Speicherpfad | Datensatzgröße, Checkpoint-Größe, Cache für Modellgewichte, Speicherort des Object Storage, lokaler Scratch, Snapshot-Richtlinie und Aufbewahrungsdauer. |
| Auslastungsziel | Erwartete Basis-Auslastung, Burst-Stunden, Toleranz für Leerlauf, Wartungsfenster und erwartete Warteschlangenzeit. |
| Zuverlässigkeitsrichtlinie | Checkpoint-Frequenz, Retry-Budget, toleriertes Eviction-Risiko, Support-SLA und Eskalationspfad für Vorfälle. |
| Daten und Compliance | Region, Datenresidenz, Datenschutz-, Audit-, Export- und Anforderungen an die Kundentrennung. |
| Vertragsgrenze | Laufzeit, Mindestumsatz, Kapazitätsgarantie, Upgrade-Pfad, Supportumfang und Kündigungsbedingungen. |
Wenn Sie diese Tabelle nicht ausfüllen können, reservieren Sie noch keinen Cluster. Mieten Sie zuerst kurzfristige On-Demand-Kapazität, benchmarken Sie die Workload und machen Sie aus dem Benchmark eine Beschaffungsanforderung.
Anbieterkategorien zum Vergleich
Es gibt drei nützliche Anbieterkategorien für GPU-Cluster-Miete.
| Kategorie | Beispiele zur Bewertung | Worin sie typischerweise gut sind | Was zu prüfen ist |
|---|---|---|---|
| Hyperscale-Clouds | AWS, Google Cloud, Microsoft Azure | Ausgereifte Identität, Regionen, Compliance, Netzwerkprodukte, Support, Abrechnungskontrollen | GPU-Verfügbarkeit, Kontingent, Reservierungsmechanik, gesamte Cloud-Rechnung, Datenübertragungskosten und betriebliche Komplexität. |
| Spezialisierte GPU-Clouds | Lambda, CoreWeave, Crusoe, Runpod Enterprise, regionale KI-Clouds | Schnellere Gespräche zur GPU-Beschaffung, KI-native Unterstützung, einfachere GPU-Preise, dedizierte Cluster-Verträge | Netzwerk-Fabric, Speicher, Observability, Enterprise-Kontrollen, Support-SLA und Verlängerungs-/Upgrade-Bedingungen. |
| Marktplätze und flexible Flotten | Vast.ai, Runpod-Kapazität im Community-Stil, vermittelter GPU-Kapazität | Niedrigere Einstiegskosten und schnelle Experimente | Host-Zuverlässigkeit, Unterbrechungsrisiko, Datenbewegung, Support-Tiefe, Compliance und ob Produktionsverkehr angemessen ist. |
Verwenden Sie offizielle Quellseiten als aktuelle Prüfzeitpunkte, nicht als permanente Preislisten. Für diesen Artikel wurden die Angaben am 12. Oktober 2026 überprüft.
| Quelle | Warum das in einer Käuferprüfung wichtig ist |
|---|---|
| AWS EC2 P5-Instanzen und EC2 Capacity Blocks | Prüfen Sie die H100-Cluster-Form, die EFA-/Netzwerkbeschreibung, die Reservierungsmechanik, das Kontingent und die regionale Verfügbarkeit. |
| Beschleunigeroptimierte Maschinen von Google Cloud und GPU-Preise | Prüfen Sie die Maschinenfamilien A3/A4, die GPU-Preisstruktur, Speicher, Rabatte bei zugesicherter Nutzung und Regionshinweise. |
| Azure ND H100 v5-Serie | Prüfen Sie Azures H100-Cluster-Form, die InfiniBand-Beschreibung, VM-Größen und die regionale Verfügbarkeit. |
| Lambda GPU Cloud | Prüfen Sie veröffentlichte GPU-Cloud-Tarife, Instanztypen, Bedingungen für reservierte Cloud-Kapazität und Verfügbarkeitsangaben. |
| Runpod-Preise und Runpod-Dokumentation | Trennen Sie Annahmen zu Pods, Serverless, sicherer/Community-Kapazität, Speicher und Netzwerkvolumen. |
| Vast.ai-Preise und Vast.ai-Dokumentation | Behandeln Sie jedes Angebot als Marketplace-Offerte mit eigenem Host, eigener Zuverlässigkeit, eigenem Speicher, Standort und Unterbrechungsprofil. |
| NVIDIA NCCL-Tests | Verwenden Sie praktische Benchmarks für verteiltes Training, statt allgemeine Aussagen über ein „Hochgeschwindigkeitsnetzwerk“ zu akzeptieren. |
| NVIDIA GPU Operator und Slurm GRES | Bestätigen Sie, ob Ihr Team oder der Anbieter GPU-Scheduling, Treiber, Telemetrie und Zuweisungsrichtlinien verantwortet. |
Die Multi-Node-Prüfungen, die zählen
Single-GPU-Miete ist vor allem eine Entscheidung über Preis, Speicher, Image und Verfügbarkeit. Die Miete eines Multi-Node-GPU-Clusters fügt Topologie- und Betriebsrisiken hinzu.
1. GPU-Topologie
Fragen Sie nach der genauen Node-Form und ob der Cluster homogen ist.
- GPU-Modell und Speicherkapazität.
- PCIe versus SXM, wo relevant.
- GPUs pro Knoten.
- Intra-Node-NVLink- oder NVSwitch-Topologie.
- CPU-Modell, RAM und lokales NVMe pro Knoten.
- MIG-, vGPU- oder Full-GPU-Zuweisungsrichtlinie.
- Ob alle Knoten in einer Placement-Domain liegen.
Akzeptieren Sie "8x H100" nicht als vollständige Spezifikation. Ein 8x-H100-SXM-Server, ein 8x-H100-PCIe-Server und acht separate H100-Knoten können sich sehr unterschiedlich verhalten.
2. Netzwerkinfrastruktur
Für verteiltes Training kann das Netzwerk darüber entscheiden, ob der Cluster nutzbar ist. Fragen Sie nach:
- InfiniBand-, RoCE-, EFA-, GPUDirect- oder anderen Details zur Fabric.
- Anzahl und Geschwindigkeit der NICs pro Knoten.
- Oversubscription-Ratio.
- Placement-Garantie für die angebotenen Knoten.
- Ob der Anbieter NCCL-All-Reduce-Tests auf genau diesem Pool ausgeführt hat.
- Richtlinie für Wartung und Fehlerisolierung.
Nehmen Sie die Netzwerkvalidierung in den Abnahmetest auf:
cluster acceptance test:
  run nccl-tests all_reduce across every rented node
  compare bandwidth and latency to provider quote
  repeat after container image, driver, and framework install
  save logs with date, node IDs, GPU model, and region
Wenn der Anbieter keinen grundlegenden verteilten Benchmark vor Vertragsunterzeichnung unterstützen kann, werten Sie das als Risikosignal.
3. Storage und Datenpfad
GPU-Teams unterschätzen Storage oft, weil das GPU-Angebot groß wirkt und die Storage-Zeile gewöhnlich aussieht. Bei Multi-Node-Clustern entscheidet der Storage über Startzeit, Checkpoint-Zeit und Wiederherstellung nach Ausfällen.
Fragen Sie nach:
- Lokales NVMe pro Knoten.
- Optionen für ein gemeinsames Dateisystem.
- Region des Object Storage und Egress-Pfad.
- Datenstaging-Zeit.
- Strategie für den Cache der Modellgewichte.
- Durchsatz beim Schreiben/Lesen von Checkpoints.
- Preise für Snapshots und Backups.
- Bereinigungsrichtlinie nach Ende der Miete.
Führen Sie dann einen realen Test aus: Ziehen Sie den Produktions-Container, stagen Sie den Datensatz, laden Sie die Gewichte, schreiben Sie einen Checkpoint, stellen Sie aus dem Checkpoint wieder her und messen Sie die abrechenbare Zeit.
4. Scheduler- und Zugriffsmodell
Das beste GPU-Angebot kann trotzdem scheitern, wenn Ihr Team Jobs nicht zuverlässig einplanen kann. Legen Sie fest, wer verantwortlich ist für:
- Kubernetes- oder Slurm-Setup.
- Verwaltung von Treiber- und CUDA-Versionen.
- Container-Registry und Image-Scanning.
- Benutzerzugriff, SSH-Richtlinie, Secrets und Audit-Logs.
- Kontingente nach Team oder Projekt.
- Abschaltung bei Inaktivität.
- Kosten-Tags und Usage-Exports.
- Incident-Eskalation.
Ein vom Anbieter verwalteter Cluster kann die Einrichtungszeit verkürzen, aber Sie benötigen dennoch ein klares Runbook für fehlerhafte Images, fehlgeschlagene Jobs, Quotenstreitigkeiten und dringende Kapazitätsänderungen.
Arbeitsblatt für Cloud-Preise bei GPU-Cluster-Miete
Normalisieren Sie für jeden Anbieter das Angebot in dasselbe Arbeitsblatt.
| Position | Zu stellende Frage | Warum sich das auf TCO auswirkt |
|---|---|---|
| GPU-Compute | Was ist die abrechenbare Einheit: Sekunde, Minute, Stunde, Monat oder Kapazitätsblock? | Kurzaufträge und Leerlaufzeiten reagieren empfindlich auf die Abrechnungsgranularität. |
| Mindestbindung | Gibt es eine Laufzeit, einen Mindestumsatz oder eine nicht kündbare Reservierung? | Ein günstiger Stundensatz kann teuer werden, wenn die Auslastung sinkt. |
| Storage | Welche Storage-Tiers sind enthalten und welche werden separat abgerechnet? | Datensätze, Checkpoints, Modellgewichte und Snapshots können nach dem Ende der Jobs bestehen bleiben. |
| Netzwerk | Werden regionsübergreifender Traffic, öffentlicher Egress, private Links oder dedizierte Fabric separat abgerechnet? | Große Datensätze und generierte Medien können mehr Daten bewegen als erwartet. |
| Support | Wie sind Reaktionszeit, Eskalationspfad und enthaltene technische Unterstützung? | Cluster-Vorfälle sind während Trainingsfenstern teuer. |
| Zuverlässigkeit | Was passiert, wenn ein Knoten während eines Multi-Node-Jobs ausfällt? | Neustart- und Warteschlangenzeit gehören in das Kostenmodell. |
| Upgrade-Pfad | Können Sie während der Laufzeit von H100 auf Kapazitäten der Klasse H200/B200 wechseln? | GPU-Generationen verschieben die Leistung pro Dollar. |
| Observability | Erhalten Sie pro Knoten Auslastung, Job-Logs, Billing-Exports und Fehlerursachencodes? | Ohne Nutzungsdaten kann die Finanzabteilung die Rechnung nicht erklären. |
| Sicherheit | Sind Mandantentrennung, Audit-Logs, Secrets und Löschfristen für Daten dokumentiert? | Enterprise-Käufer benötigen Nachweise, keine mündlichen Zusagen. |
Verwenden Sie diese Formel in der Tabelle:
monatliche Cluster-TCO =
  zugesicherte Rechenleistung
  + Burst-Rechenleistung
  + persistenter Speicher
  + Snapshots
  + Netzwerk-Egress
  + Support
  + Leerlaufverschwendung
  + Wiederholungsverschwendung
  + Engineering-Overhead
Berechnen Sie dann die nutzbare Einheit:
Kosten pro nutzbarer Einheit =
  monatliche Cluster-TCO / akzeptierte Workload-Einheiten
Die nutzbare Einheit sollte dem Geschäftsergebnis entsprechen: abgeschlossene Fine-Tunes, verarbeitete Training-Tokens, akzeptierte Bild-Batches, Inference-Tokens, Kundenanfragen oder ausgelieferte Experimente.
2026 mieten, reservieren oder kaufen
Das Keyword "gpu cluster rental or cloud or buy 2026" führt zur eigentlichen Beschaffungsfrage. Verwenden Sie die untenstehende Entscheidungstabelle vor einer großen Verpflichtung.
| Option | Bevorzugt, wenn | Vermeiden, wenn |
|---|---|---|
| On-Demand mieten | Die Workload neu ist, der Zeitplan ungewiss ist oder Benchmarks sich noch ändern. | Sie bereits eine stabile Basis-Auslastung und dringende Verfügbarkeitsanforderungen haben. |
| Kapazität reservieren oder dedizieren | Die Auslastung vorhersehbar ist, Starttermine wichtig sind und dieselbe GPU-Klasse monatelang ausgelastet sein wird. | Sich die Modellarchitektur, die Serving-Engine oder das GPU-Ziel bald ändern wird. |
| Kaufen oder Colocation nutzen | Sie eine sehr hohe Auslastung, stabile Hardwareanforderungen, Rechenzentrums-Expertise und Kapitalfreigabe haben. | Sie schnelles Hochskalieren, Flexibilität bei der GPU-Generation, verwalteten Support oder globale Regionen benötigen. |
| Model-APIs verwenden | Sie Modell-Outputs stärker benötigen als Hardware-Kontrolle, und der Betriebsaufwand die GPU-Einsparungen übersteigen würde. | Sie benutzerdefinierte Gewichte, Low-Level-Kernel-Kontrolle, einen privaten Serving-Stack oder eine feste Hardware-Platzierung benötigen. |
Für viele KI-Produktteams ist der praktische Weg gestaffelt:
- On-Demand-GPUs für Benchmarks mieten.
- Stabile Jobs in reservierte oder dedizierte GPU-Cluster-Miete verlagern.
- Burst- und Experiment-Traffic auf flexibler Kapazität halten.
- Model-APIs für Workloads verwenden, bei denen Infrastrukturkontrolle das Produkt nicht verbessert.
- Kauf oder Colocation erst nach erneuter Bewertung in Betracht ziehen, wenn Auslastung und Workload-Struktur stabil sind.
GPU-Cluster-Miete in Indien
Die Formulierung "gpu cluster rental in india" sollte nicht als eigener Artikel behandelt werden, es sei denn, der Käufer hat India-spezifische Anforderungen an Beschaffung, Datenresidenz oder Latenz. Verwenden Sie dasselbe Arbeitsblatt und ergänzen Sie dann regionale Prüfungen:
- Befindet sich der Cluster physisch in Indien, in nahegelegenen Asien-Regionen oder wird er nur an in Indien ansässige Unternehmen verkauft?
- Wo werden Trainingsdaten, Checkpoints und Protokolle gespeichert?
- Welche Anforderungen gelten für grenzüberschreitende Übertragung, Steuern, Rechnungen und Supportzeiten?
- Wird lokaler Support während der indischen Geschäftszeiten benötigt?
- Ist Latenz für Inferenz wichtig, oder handelt es sich um eine Offline-Trainings-Workload?
- Gibt es Import-, Beschaffungs- oder Compliance-Beschränkungen, wenn Hardware gekauft statt gemietet wird?
Für Offline-Training kann eine nahegelegene Region akzeptabel sein, wenn Datenübertragung und Compliance sauber gelöst sind. Für latenzkritische Inferenz oder regulierte Daten können Region und Vertragsbedingungen wichtiger sein als der beworbene GPU-Tarif.
Warnsignale in Angeboten für GPU-Cluster-Miete
Stoppen Sie den Deal, wenn Sie eines davon sehen:
- Das Angebot nennt "H100 cluster", aber nicht PCIe/SXM, Knotenform, Speicher oder Netzwerk.
- Der Anbieter kann das Fehlermanagement für einen defekten Knoten in einem verteilten Job nicht beschreiben.
- Speicher und Egress fehlen im Angebot.
- Supportbedingungen sind während Ihres teuersten Trainingsfensters unklar.
- "Dediziert" wird verwendet, ohne Mandantenisolierung, Platzierung und Noisy-Neighbor-Risiko zu erläutern.
- Das Angebot nennt einen niedrigen Monatspreis, aber keine Auslastungs- oder Kündigungsbedingungen.
- Es gibt kein Benchmark-Fenster vor der Bindung.
- Der Anbieter weigert sich, Billing-Exportfelder oder Nutzungsdaten zu teilen.
- Sie können Treiber-/CUDA-/Framework-Versionen vor der ersten Workload nicht verifizieren.
- Die Sales-Präsentation erwähnt Compliance, aber der Vertrag definiert Datenverarbeitung und Löschung nicht.
Was vor der Unterzeichnung zu benchmarken ist
Führen Sie eine kleine Abnahme-Suite aus, bevor Sie einen gemieteten GPU-Cluster reservieren oder skalieren.
| Test | Bestanden, wenn |
|---|---|
| Container-Pull und Start | Das Produktionsimage startet auf jedem Knoten schnell und reproduzierbar. |
| GPU-Health | Alle GPUs melden erwartetes Modell, Speicher, Treiber und CUDA-Kompatibilität. |
| NCCL All-Reduce | Bandbreite und Latenz zwischen den Knoten entsprechen der vom Anbieter angegebenen Cluster-Klasse. |
| Storage-Stage | Datensatz und Modellgewichte können innerhalb des geplanten Einrichtungsfensters bereitgestellt werden. |
| Checkpoint-Schreiben/Lesen | Checkpoints werden abgeschlossen, ohne dass GPU-Zeit zu lange ungenutzt bleibt. |
| Fehlerübung | Einen Worker beenden und Neustart-, Checkpoint- und Abrechnungsverhalten bestätigen. |
| Leerlauf-Abschaltung | Ungenutzte Knoten stoppen oder alarmieren, bevor sich Verschwendung summiert. |
| Billing-Export | Nutzung kann nach Team, Workload, Umgebung und Job zugeordnet werden. |
| Sicherheitsprüfung | Zugriff, Secrets, Protokolle, Datenlöschung und Audit-Aufzeichnungen entsprechen der Richtlinie. |
Speichern Sie die Benchmark-Ausgabe mit Datum, Anbieter, Region, GPU-Modell, Image-Version, Framework-Version und Knoten-IDs. So wird die Auswahl des Anbieters von einer Debatte über Tarife zu einer reproduzierbaren technischen Prüfung.
Wo Flatkey hineinpasst
Flatkey ist kein Ersatz für jeden gemieteten GPU-Cluster. Wenn Sie benutzerdefinierte Gewichte, private Kernel, Multi-Node-Training oder direkte Hardwarekontrolle benötigen, brauchen Sie weiterhin GPU-Kapazität.
Flatkey wird relevant, wenn die Frage ist, ob Sie für eine bestimmte Workload überhaupt GPUs betreiben müssen. Flatkey gibt Teams einen Schlüssel, ein Guthaben und eine Rechnung für 300+ offizielle Modelle und 1.000+ Pay-per-Call-Tools sowie Sichtbarkeit der Nutzung auf Request-Ebene. Das macht es als Vergleichspfad nützlich für:
- Prototyp-Workloads, bevor Sie sich für einen Cluster entscheiden.
- Agenten- und Anwendungsverkehr, der auf offiziellen Model-APIs laufen kann.
- Finanzprüfungen, die Self-Hosted-GPU-Kosten mit Model-API-Kosten vergleichen müssen.
- Teams, die ein gemeinsames Ledger für KI-Nutzung wollen, bevor sie entscheiden, welche Workloads dedizierte Hardware verdienen.
Wenn eine Workload keine Hardwarekontrolle erfordert, vergleichen Sie GPU-Cluster-Miete mit einem API-Weg anhand der Kosten pro akzeptiertem Ergebnis und nicht anhand der reinen GPU-Stunden. Die zugehörigen Leitfäden zu GPU-Mietpreisen, Preisvergleich von KI-Modellen, wie man KI-Modellpreise vergleicht, KI-Gateway-Preisen, Ausgabenmanagement für KI-APIs und Kontingentverwaltung für KI-APIs sind die richtigen nächsten Prüfungen.
Käufer-Checkliste
Verwenden Sie diese Checkliste, bevor Sie die GPU-Cluster-Miete freigeben:
- Definieren Sie die Workload und die nützliche Ausgabeeinheit.
- Benchmarken Sie On-Demand-Kapazität, bevor Sie reservieren.
- Geben Sie GPU-Modell, Speicher, Node-Form, lokalen Speicher und Netzwerk-Fabric an.
- Fordern Sie einen verteilten Benchmark für Multi-Node-Training an.
- Beziehen Sie Speicher, Egress, Support, Leerlaufzeit und Wiederholungsverluste in die TCO ein.
- Bestätigen Sie Region, Compliance, Datenlöschung und Audit-Anforderungen.
- Fragen Sie, wie sich ein ausgefallener Node auf einen laufenden Job auswirkt.
- Fordern Sie Nutzungs- und Abrechnungsexporte nach Team, Umgebung und Job an.
- Trennen Sie reservierte Basiskapazität von Burst-Kapazität.
- Vergleichen Sie erneut mit Modell-APIs, wenn keine Hardwarekontrolle erforderlich ist.
Die beste Entscheidung für GPU-Cluster-Miete ist diejenige, die die Workload zuverlässig mit dem geringsten operativen Überraschungspotenzial abschließt. Die günstigste GPU-Stunde ist nur dann sinnvoll, wenn Cluster, Speicher, Netzwerk und Vertrag Ihrem Team erlauben, diese Stunde in akzeptierte Arbeit umzuwandeln.
Fragen, die Käufer stellen
Was ist GPU-Cluster-Miete?
GPU-Cluster-Miete ist die Praxis, mehrere GPUs zu mieten, oft über einen oder mehrere verbundene Nodes hinweg, für KI-Training, Inferenz, Batch-Verarbeitung oder Forschung. Sie kann On-Demand, reserviert, dediziert, marktplatzbasiert oder von einem Cloud-Anbieter verwaltet sein.
Ist GPU-Cluster-Miete günstiger als der Kauf von GPUs?
Das hängt von der Auslastung, der Laufzeit, den operativen Fähigkeiten, der Finanzierung, dem Strom, dem Zugang zum Rechenzentrum, dem Support und davon ab, wie oft sich Ihre Ziel-GPU-Klasse ändert. Mieten ist in der Regel besser bei Unsicherheit und Geschwindigkeit. Kaufen kann sich nur lohnen, wenn Auslastung und Hardwarebedarf stabil genug sind, um Kapital- und Betriebskosten aufzufangen.
Was sollte ich GPU-Cluster-Miete-Cloud-Anbieter fragen?
Fragen Sie nach GPU-Modell, Node-Form, Netzwerk-Fabric, Speicher, Region, Kontingent, Support-SLA, Auslastungsannahmen, Abrechnungsexporten, Bedingungen zur Datenlöschung, Benchmark-Zugang und danach, was passiert, wenn ein Node während eines verteilten Jobs ausfällt.
Brauche ich InfiniBand oder RoCE für einen gemieteten GPU-Cluster?
Sie brauchen ein Hochleistungs-Cluster-Netzwerk, wenn Jobs stark über Nodes hinweg kommunizieren, insbesondere bei verteiltem Training und geshardetem Serving. Für vollständig parallelisierbare Batch-Inferenz oder unabhängige Jobs benötigen Sie es möglicherweise nicht. Benchmarken Sie mit Ihrer eigenen Workload, bevor Sie für ein Premium-Fabric bezahlen.
Wie sollte ich GPU-Cluster-Miete in Indien vergleichen?
Verwenden Sie dasselbe Miet-Arbeitsblatt und ergänzen Sie dann Indien-spezifische Fragen zu Region, Datenresidenz, Steuern, Rechnungsanforderungen, Supportzeiten, Latenz und grenzüberschreitender Datenübertragung. Vergleichen Sie nicht nur den stündlichen GPU-Preis.


