
A maioria das comparações de TCO de cluster GPU falha pelo mesmo motivo: comparam uma taxa horária de nuvem com uma ordem de compra de hardware. Essa não é a decisão.
A decisão real é se a sua equipe de IA deve comprar flexibilidade, comprar hardware ou comprar controle da infraestrutura. Um modelo sério de TCO de cluster GPU precisa normalizar aluguel na nuvem, colocation e on-premises em torno do mesmo resultado: execuções de treinamento concluídas, tokens de inferência aceitos, jobs de mídia gerados ou meses de capacidade reservada.
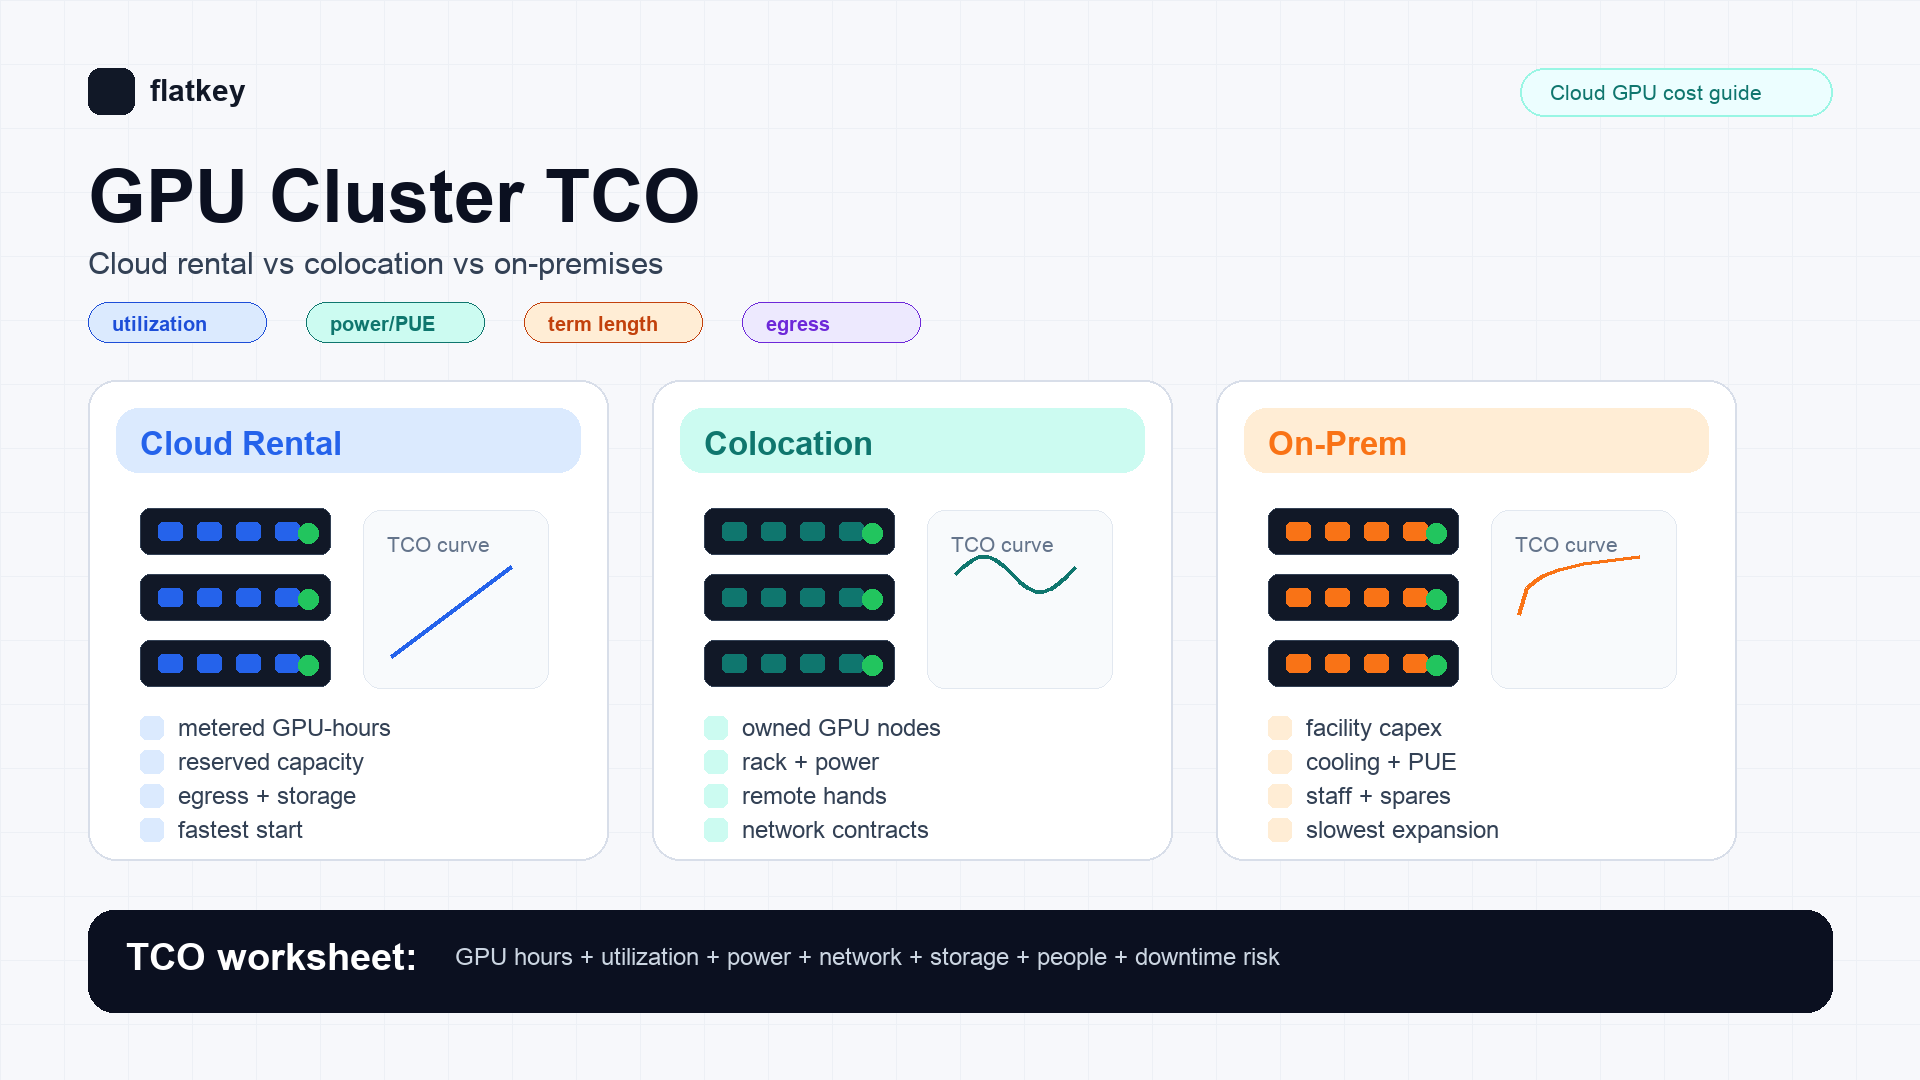
Para a maioria das equipes, o aluguel de GPU na nuvem vence quando a utilização é incerta, a velocidade de lançamento importa ou a carga de trabalho muda por família de modelo. O colocation começa a vencer quando a demanda é estável, a equipe consegue operar hardware e o contrato é longo o suficiente para amortizar GPUs, rede, sobressalentes e hands remotas. O on-premises normalmente exige a justificativa mais forte: utilização muito alta e previsível, operações de data center já existentes, requisitos rígidos de localidade ou um mandato estratégico para controlar a camada de infraestrutura.
A regra prática da Flatkey: comece pela carga de trabalho, não pelo rack. Se a carga puder ser atendida por uma API de modelo gerenciada, compare isso primeiro. Se você realmente precisar de GPUs dedicadas, faça a precificação do aluguel na nuvem, do colocation e do on-premises com a mesma planilha antes de assinar um contrato de capacidade.
Resposta rápida sobre TCO de cluster GPU
Use esta tabela de decisão inicial antes de construir o modelo completo.
| Situação | Normalmente comece com | Por quê |
|---|---|---|
| Protótipo, fine-tuning em picos, janela curta de benchmark | Aluguel de GPU na nuvem | Menor compromisso e caminho mais rápido para capacidade. |
| Frota de inferência estável por vários meses com mix de modelos conhecido | Capacidade reservada na nuvem ou colocation | A utilização é alta o suficiente para negociar preço por prazo, mas o risco de propriedade ainda pode ser evitado. |
| Grandes jobs de treinamento com requisitos rígidos de topologia de rede | Cluster dedicado na nuvem ou colocation | Você precisa de posicionamento previsível de nós, fabric de rede, localidade de storage e aceitação de benchmark. |
| Utilização plurianual acima da sua taxa interna de retorno mínima | Colocation ou on-premises | A amortização de hardware só pode superar o aluguel por hora se o tempo ocioso, as operações, a energia e o downtime forem contabilizados com honestidade. |
| Localidade de dados regulada ou exigência de controle da infraestrutura | On-premises ou colocation controlado | A decisão de TCO inclui compliance e controle, não apenas o preço de computação. |
| O app precisa apenas dos outputs do modelo, não do controle da GPU | API de modelo ou cotação do mercado de GPU | Comprar um cluster pode ser exagero quando a métrica de negócio é custo por output aceito. |
O restante deste guia mostra como construir uma planilha de TCO de cluster GPU que compras, engenharia de plataforma e finanças possam usar.
Normalize cada opção em uma única unidade
Não compare "H100 por hora" com "preço de compra do servidor". Escolha um denominador e force todas as opções a caber nele.
Denominadores úteis incluem:
- Custo por execução de treinamento concluída: melhor para fine-tuning periódico, experimentos de pré-treinamento e jobs em lote.
- Custo por output aceito: melhor para inferência de LLM, geração de código, geração de imagens e pipelines de vídeo em que retries importam.
- Custo por GPU-mês reservado: melhor para equipes de plataforma comprando capacidade interna para várias equipes de produto.
- Custo por token ou job qualificado para SLA: melhor quando downtime, preempção ou atraso na fila alteram a confiabilidade percebida pelo usuário.
Para inferência, o denominador mais limpo costuma ser:
effective_cost_per_accepted_output =
  total_monthly_cluster_cost
  / accepted_outputs_after_retries_and_quality_filters
Esse denominador captura duas coisas que o preço por hora esconde: jobs com falha e capacidade ociosa.
Fórmula de TCO de cluster GPU
Use este modelo antes de adicionar detalhes específicos do provedor:
monthly_gpu_cluster_tco =
  capacity_cost
  + storage_cost
  + data_transfer_cost
  + network_and_interconnect_cost
  + software_and_observability_cost
  + labor_and_operations_cost
  + support_and_warranty_cost
  + financing_or_depreciation_cost
  + downtime_and_retry_waste
Depois, converta para a unidade que você considera importante:
unit_cost =
  monthly_gpu_cluster_tco
  / useful_work_completed_per_month
Isso importa porque uma GPU-hora barata ainda pode ser cara se o cluster estiver subutilizado, se os jobs esperarem na fila, se o storage ficar na região errada ou se execuções com falha consumirem tempo cobrado integralmente.
Componentes de custo por modelo de implantação
| Linha de custo | Aluguel na nuvem | Colocation | On-premises |
|---|---|---|---|
| Capacidade de GPU | Sob demanda, spot, reservado, dedicado ou cotação de mercado. | Compra ou leasing de hardware mais contrato de rack. | Compra ou leasing de hardware mais alocação interna de instalações. |
| Energia e refrigeração | Normalmente embutidas na tarifa, mas não gratuitas. | Energia contratada, energia medida, overhead de refrigeração e limites de densidade de potência. | Energia da concessionária, UPS, gerador, planta de refrigeração e exposição ao PUE. |
| Rede | Saída de dados, links privados, IPs públicos, tráfego entre regiões, interconexão. | Transit, cross-connects, links privados, acesso remoto, serviços de DDoS/segurança. | WAN, trânsito de internet, links privados, firewalls, switching, caminhos redundantes. |
| Armazenamento | Bloco, objeto, filesystem, snapshots, backups, camadas de IOPS. | NVMe local, armazenamento compartilhado, destino de backup, replicação remota. | Hardware de armazenamento, backup, replicação, substituição de mídia, operações de ciclo de vida. |
| Operações | Principalmente integração da plataforma e controles de custo. | Ciclo de vida do hardware, suporte remoto, testes de aceitação, peças sobressalentes, coordenação de RMA. | Operações completas de instalações e hardware, acesso físico, sobressalentes, cobertura fora do horário comercial. |
| Risco de compromisso | Baixo para on-demand; mais alto para contratos reservados ou dedicados. | Médio a alto. A saída do contrato e a revenda do hardware importam. | Mais alto. Decisões de instalações e equipamentos podem ultrapassar o roadmap do modelo. |
O aluguel na nuvem parece simples porque muitos custos estão agrupados na tarifa. Colocation e on-premises parecem mais baratos quando a planilha esquece as pessoas, a energia, a rede e o orçamento para falhas.
Aluguel na nuvem: o que contar
O aluguel na nuvem é a base mais limpa para o TCO de um cluster de GPU porque converte capacidade em um serviço medido. Isso não significa que a tarifa horária seja o custo total.
Conte:
- Tarifa horária da instância de GPU ou bare metal.
- Termos de capacidade reservada, comprometida ou dedicada.
- Armazenamento anexado ao cluster.
- Armazenamento de objetos e retenção de snapshots.
- Transferência de dados e saída de dados.
- Rede privada, balanceadores de carga, IPs públicos e NAT.
- Scheduler, Kubernetes, Slurm, observabilidade, logging e alerting.
- Tempo ocioso por lacunas na fila, implantações com falha, cold starts e bin packing ruim.
- Desperdício por tentativas em spot ou interruptible, se usado.
- Plano de suporte e custos de gerenciamento de conta.
O aluguel na nuvem normalmente vence quando a curva de demanda da equipe é incerta. Ele também fornece ao procurement uma referência de preço atual. As páginas públicas de provedores como AWS, Google Cloud, Lambda, RunPod e outras nuvens de GPU são úteis como verificação de fonte, mas o único número que importa para um cluster grande é a cotação que você realmente pode reservar para a região, a topologia e o prazo de que precisa.
Use as páginas oficiais como checkpoints:
- A AWS descreve a infraestrutura da classe P5 para cargas de trabalho de IA em larga escala na página da instância EC2 P5.
- O Google Cloud publica preços de GPUs e observa que o preço depende do tipo de GPU, região e modelo de uso.
- A Lambda e a RunPod publicam superfícies de preço de cloud GPU que são úteis para verificações rápidas de mercado.
- A Flatkey Compute publica um índice de preço por hora de GPU em tempo real e permite que compradores publiquem solicitações anônimas de GPU para que fornecedores verificados façam ofertas.
Trate todo preço como registrado com data e hora. A disponibilidade de GPU e as tarifas horárias mudam mais rápido do que o preço de SaaS comum.
Colocation: o que contar
Colocation não é apenas "nuvem, mas mais barato". Ele transfere uma grande parte da carga operacional do provedor para a sua equipe.
Conte:
- Servidores GPU, adaptadores de rede, switches, ópticas, cabos e armazenamento.
- Taxas de rack ou cage.
- Energia contratada e energia medida.
- Limitações de refrigeração e densidade.
- Cross-connects, trânsito de internet, links privados e segurança de rede.
- Suporte remoto, envio, recebimento, instalação, inventário e tratamento de RMA.
- GPUs sobressalentes, fontes de alimentação, NICs, ópticas, ventoinhas e unidades de armazenamento.
- Depreciação de hardware, custo de leasing, custo de financiamento e premissas de revenda.
- SLA da instalação, janelas de manutenção e procedimentos de acesso.
- Operações da plataforma: imagens, drivers, stack CUDA, Kubernetes ou Slurm, observabilidade, patching de segurança e resposta a incidentes.
Colocation começa a fazer sentido quando a utilização é previsível e alta, a equipe tem capacidade real de operações de infraestrutura e o contrato oferece densidade de potência suficiente para a geração de GPU que você planeja executar. Ele falha quando as equipes compram o hardware, mas subestimam suporte remoto, networking, restrições de energia, sobressalentes e expansão lenta.
Para clusters de GPU, a malha de rede costuma ser o item que decide a arquitetura. Um cluster que precisa de treinamento fortemente acoplado não é equivalente a um conjunto de nós de inferência isolados. Se a carga de trabalho depende de InfiniBand, RoCE, NVLink, NVSwitch ou de um layout específico de armazenamento, faça disso parte da cotação e do teste de aceitação.
On-premises: o que contar
O TCO de um cluster de GPU on-premises deve ser tratado como um projeto de instalações, não como uma compra de servidor.
Conte:
- Tudo no modelo de colocation.
- Alocação de espaço no data hall ou buildout.
- Trabalho elétrico, UPS, gerador, distribuição de energia e supressão de incêndio.
- Capacidade da planta de refrigeração e manutenção.
- Segurança física e controle de acesso.
- Pessoal de instalações e escalonamento fora do horário comercial.
- Seguro, auditorias de conformidade e procedimentos de segurança.
- Planejamento de capacidade de longo prazo para a próxima geração de GPU.
- Custo de oportunidade do capital preso em instalações e hardware.
On-premises pode ser justificado para organizações com infraestrutura de data center já estabelecida, alta utilização, requisitos rigorosos de localidade ou exigências estratégicas de controle. É a pior escolha quando a equipe ainda está descobrindo o mix de modelos, o comprimento de contexto, a meta de throughput e o encaixe produto-mercado.
O risco oculto é a troca de geração de GPU. Uma decisão de infraestrutura pode durar mais do que a arquitetura de modelo que você está atendendo. Se o seu TCO depende de uma família de modelos permanecer dominante por três anos, teste esse pressuposto em cenários estressados.
Utilização de ponto de equilíbrio
A questão central do ponto de equilíbrio é:
required_utilization =
  owned_monthly_cost
  / equivalent_cloud_monthly_cost_at_100_percent_use
Se a infraestrutura própria custa $X por mês e o aluguel equivalente na nuvem com utilização total custa $Y por mês, então a propriedade só funciona se a utilização útil estiver acima de X / Y. Utilização útil significa trabalho que, de outra forma, teria sido pago. Ela exclui inventário ocioso, jobs com falha, folga na fila e capacidade reservada para picos raros.
Execute o modelo em três cenários:
| Cenário | O que testar |
|---|---|
| Caso base | Carga de trabalho esperada, utilização esperada, prazo esperado. |
| Caso pessimista | Menor utilização, uso do produto atrasado, menor valor de revenda, energia mais cara, aceitação mais lenta. |
| Caso de estresse | O novo modelo não cabe na memória, a topologia de rede está errada ou a demanda migra para uma API gerenciada. |
Se o caso pessimista destruir a economia, o aluguel na nuvem ou um contrato dedicado mais curto geralmente é o primeiro passo mais seguro.
Planilha de TCO de cluster GPU para copiar
Use esta planilha no seu documento de compras. Preencha uma vez para aluguel na nuvem, uma vez para colocation e uma vez para on-premises.
| Campo | Aluguel na nuvem | Colocation | On-premises |
|---|---|---|---|
| Modelo e quantidade de GPU | |||
| Prazo do contrato | |||
| Utilização útil esperada | |||
| Custo mensal da capacidade de GPU | |||
| Armazenamento e backup | |||
| Transferência de dados e rede | |||
| Energia e refrigeração | Incluídos ou cotados | ||
| Espaço em rack, gaiola ou alocação de instalações | N/A | ||
| Amortização ou leasing de hardware | N/A | ||
| Hands remotos / equipe | |||
| Suporte, garantia e peças de reposição | |||
| Observabilidade e ferramentas de plataforma | |||
| Tempo de inatividade e desperdício por retries | |||
| TCO mensal estimado | |||
| Denominador do custo unitário | |||
| Custo por saída aceita | |||
| Prazo de expansão | |||
| Custo de saída |
Não pule as duas últimas linhas. O prazo de expansão e o custo de saída são os pontos em que uma economia de hardware aparentemente atraente frequentemente se torna cara.
Perguntas de compras para fazer a todo fornecedor
Para aluguel na nuvem:
- A capacidade cotada é compartilhada, reservada, dedicada ou bare metal?
- Qual região, zona de disponibilidade e posicionamento de nó são garantidos?
- Qual modelo exato de GPU, tamanho de memória, interconnect, CPU, RAM, armazenamento local e fabric de rede estão incluídos?
- Armazenamento, snapshots, object storage, largura de banda, IPs públicos e suporte estão incluídos?
- O que acontece se o cluster ficar indisponível durante o prazo?
- O provedor pode executar um benchmark de aceitação antes do início do compromisso?
- Como jobs com falha, interrupções da plataforma e janelas de manutenção são creditados?
Para colocation:
- Qual densidade de energia é contratada por rack?
- A energia é medida, comprometida ou agregada ao preço do rack?
- Quais serviços de hands remotos estão incluídos e quais são cobrados?
- Quais operadoras e links privados estão disponíveis?
- Com que rapidez racks adicionais, energia e cross-connects podem ser provisionados?
- Quem é o responsável por peças de reposição, RMAs e manutenção de firmware?
- Qual teste de aceitação confirma que o cluster está pronto para produção?
Para on-premises:
- A instalação já suporta a densidade de energia alvo?
- A capacidade de refrigeração está disponível sem uma obra de expansão?
- Quem é o responsável pela resposta de hardware 24/7?
- Qual é o fluxo de aprovação para mudanças elétricas, de rede e de segurança?
- Qual é o período de depreciação e qual valor de revenda é assumido?
- O que acontece se o próximo modelo exigir mais memória, mais largura de banda ou uma stack de serving diferente?
Matriz de decisão
| Critério | Aluguel na nuvem | Colocation | On-premises |
|---|---|---|---|
| Velocidade de início | Melhor | Média | Mais lenta |
| Capital inicial | Mais baixo | Médio a alto | Mais alto |
| Esforço operacional | Mais baixo | Médio | Mais alto |
| Economia de utilização estável no longo prazo | Média | Forte se operado bem | Forte apenas com maturidade da infraestrutura |
| Flexibilidade por geração de GPU | Melhor | Média | Mais baixa |
| Controle da infraestrutura | Baixo | Médio | Mais alto |
| Reversibilidade da aquisição | Melhor | Média | Mais baixa |
| Requisito de benchmark | Importante | Crítico | Crítico |
A resposta mais defensável raramente é "sempre nuvem" ou "sempre comprar". Geralmente, trata-se de uma abordagem em fases: alugar para descoberta, reservar para demanda estável, usar colocation quando a utilização estiver comprovada e ir para on-premises apenas quando o controle da infraestrutura fizer parte do requisito.
Erros comuns em modelos de TCO de cluster GPU
Comparar preço de tabela com propriedade no melhor cenário
Um modelo justo de TCO de cluster GPU compara cotações reais com custo real de propriedade. O preço de tabela da nuvem não é o mesmo que capacidade reservada ou negociada. O preço de compra do hardware não é o mesmo que o custo de um cluster em operação.
Ignorar a utilização
Um cluster próprio com 40% de utilização efetiva pode perder para um cluster na nuvem com uma tarifa horária muito maior. Meça trabalho útil, não GPUs instaladas.
Tratar a topologia de rede como um detalhe secundário
A contagem de GPUs sozinha não define um cluster. Treinamento, fine-tuning e inferência de alto throughput podem ter requisitos de rede e armazenamento muito diferentes.
Esquecer o desperdício por reexecução
Reexecuções, implantações com falha, preempções e saídas de baixa qualidade aumentam o custo unitário. Coloque o desperdício por reexecução no denominador, não apenas no numerador.
Subestimar o custo de pessoal
Drivers, versões do CUDA, imagens de contêiner, agendadores, monitoramento, firmware, correção de segurança e resposta a incidentes fazem parte do TCO de cluster GPU. Alguém paga por isso mesmo quando não está na cotação.
Quando uma API de modelo supera um cluster GPU
Um cluster GPU dedicado nem sempre é a abstração certa. Se o seu produto só precisa de saídas do modelo, e não de controle do hardware, compare o TCO do cluster com uma rota via API.
APIs de modelo podem vencer quando:
- O tráfego é irregular.
- A combinação de modelos muda com frequência.
- Você precisa de acesso a múltiplos modelos frontier e open source.
- A equipe não consegue manter as GPUs com alta utilização.
- Filtros de qualidade e reexecuções são mais fáceis de gerenciar na camada de requisição.
- O financeiro quer registros de uso por requisição em vez de um pool de infraestrutura.
A Flatkey é relevante aqui porque o mesmo comprador muitas vezes precisa dos dois caminhos. A Flatkey Compute ajuda as equipes a comparar capacidade viva de GPU-hora, publicar demanda anônima por GPU e receber ofertas de fornecedores. A camada de API de modelos e ferramentas da Flatkey oferece às equipes uma forma de rotear cargas de trabalho de IA por uma chave, um saldo e um livro-razão de uso quando não for necessário possuir a camada de GPU.
O fluxo de trabalho prático é:
- Faça benchmark da carga de trabalho em GPUs alugadas.
- Calcule o custo por saída aceita.
- Compare a mesma carga de trabalho por meio de APIs de modelo.
- Reserve ou use colocation apenas quando o hardware dedicado vencer claramente sob premissas conservadoras.
Lista de verificação de fontes para o seu modelo de TCO de cluster GPU
Use páginas de fonte e documentos de cotação atuais em vez de copiar tarifas desatualizadas de outro artigo.
| Tipo de fonte | O que verificar |
|---|---|
| Páginas de provedores de GPU na nuvem | Tipo de instância, contagem de GPU, região, armazenamento, rede e se o preço é sob demanda, reservado, spot ou dedicado. |
| Especificações de sistema do fornecedor de GPU | Energia, memória, interconexão, formato do servidor e topologia suportada. |
| Cotação de colocation | Rack/cage, energia, hands remotas, cross-connects, rede, taxas de instalação e limites de expansão. |
| Dados de utilidade ou energia | Premissas de preço da eletricidade e escalonamento. |
| Dados internos da plataforma | Utilização real, atraso de fila, taxa de falha, taxa de reexecução, volume de saídas aceitas e tempo da equipe. |
| Premissas financeiras | Período de depreciação, custo de capital, tratamento tributário, valor residual e custo de saída do contrato. |
Pontos de partida úteis:
- Flatkey Compute para contexto de mercado de GPU-hora ao vivo e publicação de demanda.
- Índice de preços da Flatkey Compute para verificações de referência de mercado por hora.
- Instâncias AWS EC2 P5 para contexto de infraestrutura de cluster H100 na nuvem.
- Preços de GPU do Google Cloud para metodologia de precificação de GPU por tipo e região.
- Lambda GPU Cloud para contexto de preços de GPU em nuvem especializada.
- Preços da RunPod para verificações de preços de GPU de marketplace e nuvem.
- NVIDIA DGX H100 e NVIDIA DGX B200 para especificações de sistema do fornecedor.
- Dados de eletricidade da U.S. Energy Information Administration para premissas de custo de energia.
- FinOps FOCUS se a sua equipe financeira precisar de campos padronizados de custo de nuvem.
Perguntas frequentes
O que é o TCO de um cluster GPU?
O TCO de um cluster GPU é o custo total de entregar computação de IA útil a partir de um cluster. Isso inclui capacidade de GPU, armazenamento, rede, energia, refrigeração, mão de obra, software, suporte, tempo de inatividade, desperdício por reexecuções e risco de capital ou contratual.
O aluguel de GPU na nuvem é sempre mais caro do que comprar GPUs?
Não. O aluguel de GPU na nuvem pode ser mais barato quando a utilização é incerta, a carga de trabalho é de curta duração, a equipe não tem capacidade operacional ou a pilha de modelos muda rapidamente. Comprar GPUs ou usá-las em colocation só compensa quando a utilização útil é alta o suficiente para compensar operações, energia, rede, financiamento e risco de saída.
Quando o colocation supera o aluguel na nuvem?
O colocation pode superar o aluguel na nuvem quando a demanda é estável, o prazo do contrato é longo, a densidade de energia é suficiente, o hardware é bem utilizado e a equipe consegue operar o cluster. Ele não supera o aluguel na nuvem apenas porque o preço de compra do hardware parece menor do que uma tarifa pública da nuvem.
Quando uma equipe deve escolher GPUs on-premises?
Escolha GPUs on-premises quando o controle da instalação, a localidade dos dados, a conformidade ou a propriedade estratégica da infraestrutura valerem o esforço operacional. Para a maioria das equipes de produtos de IA, on-premises é a última opção a justificar, não a padrão.
Como as equipes de FinOps devem comparar as opções de cluster GPU?
As equipes de FinOps devem comparar as opções pelo custo por saída útil, e não apenas pela taxa horária. A planilha deve incluir utilização, desperdício por reexecuções, armazenamento, transferência de dados, custo de pessoal, energia, prazo contratual, tempo de lead para expansão e custo de saída.
Onde a Flatkey se encaixa no TCO de cluster GPU?
A Flatkey ajuda as equipes a evitar comprar a abstração errada. Use o Flatkey Compute quando precisar de capacidade de GPU com preço de mercado ou de propostas de fornecedores. Use a camada de API de modelo e ferramenta da Flatkey quando precisar apenas de saídas de modelo, uma única chave, um saldo único e um ledger de uso por requisição.
Em resumo
O melhor modelo de TCO para cluster GPU não é a planilha mais longa. É aquele que deixa claras três decisões:
- Se a carga de trabalho realmente precisa de GPUs dedicadas.
- Se aluguel na nuvem, colocation ou on-premises tem o melhor custo ajustado ao downside.
- Se o contrato ainda funciona quando a utilização, o mix de modelos, a energia e a disponibilidade mudam.
Comece com capacidade alugada ou uma cotação ao vivo do mercado de GPU, faça benchmark da carga de trabalho real, normalize pelo output aceito e só avance para colocation ou on-premises quando a matemática da utilização útil resistir ao cenário adverso.
Se a resposta ainda for incerta, mantenha o valor da opção. O TCO de cluster GPU recompensa equipes que compram capacidade em etapas, em vez de se prenderem ao hardware antes de a carga de trabalho se provar.


