
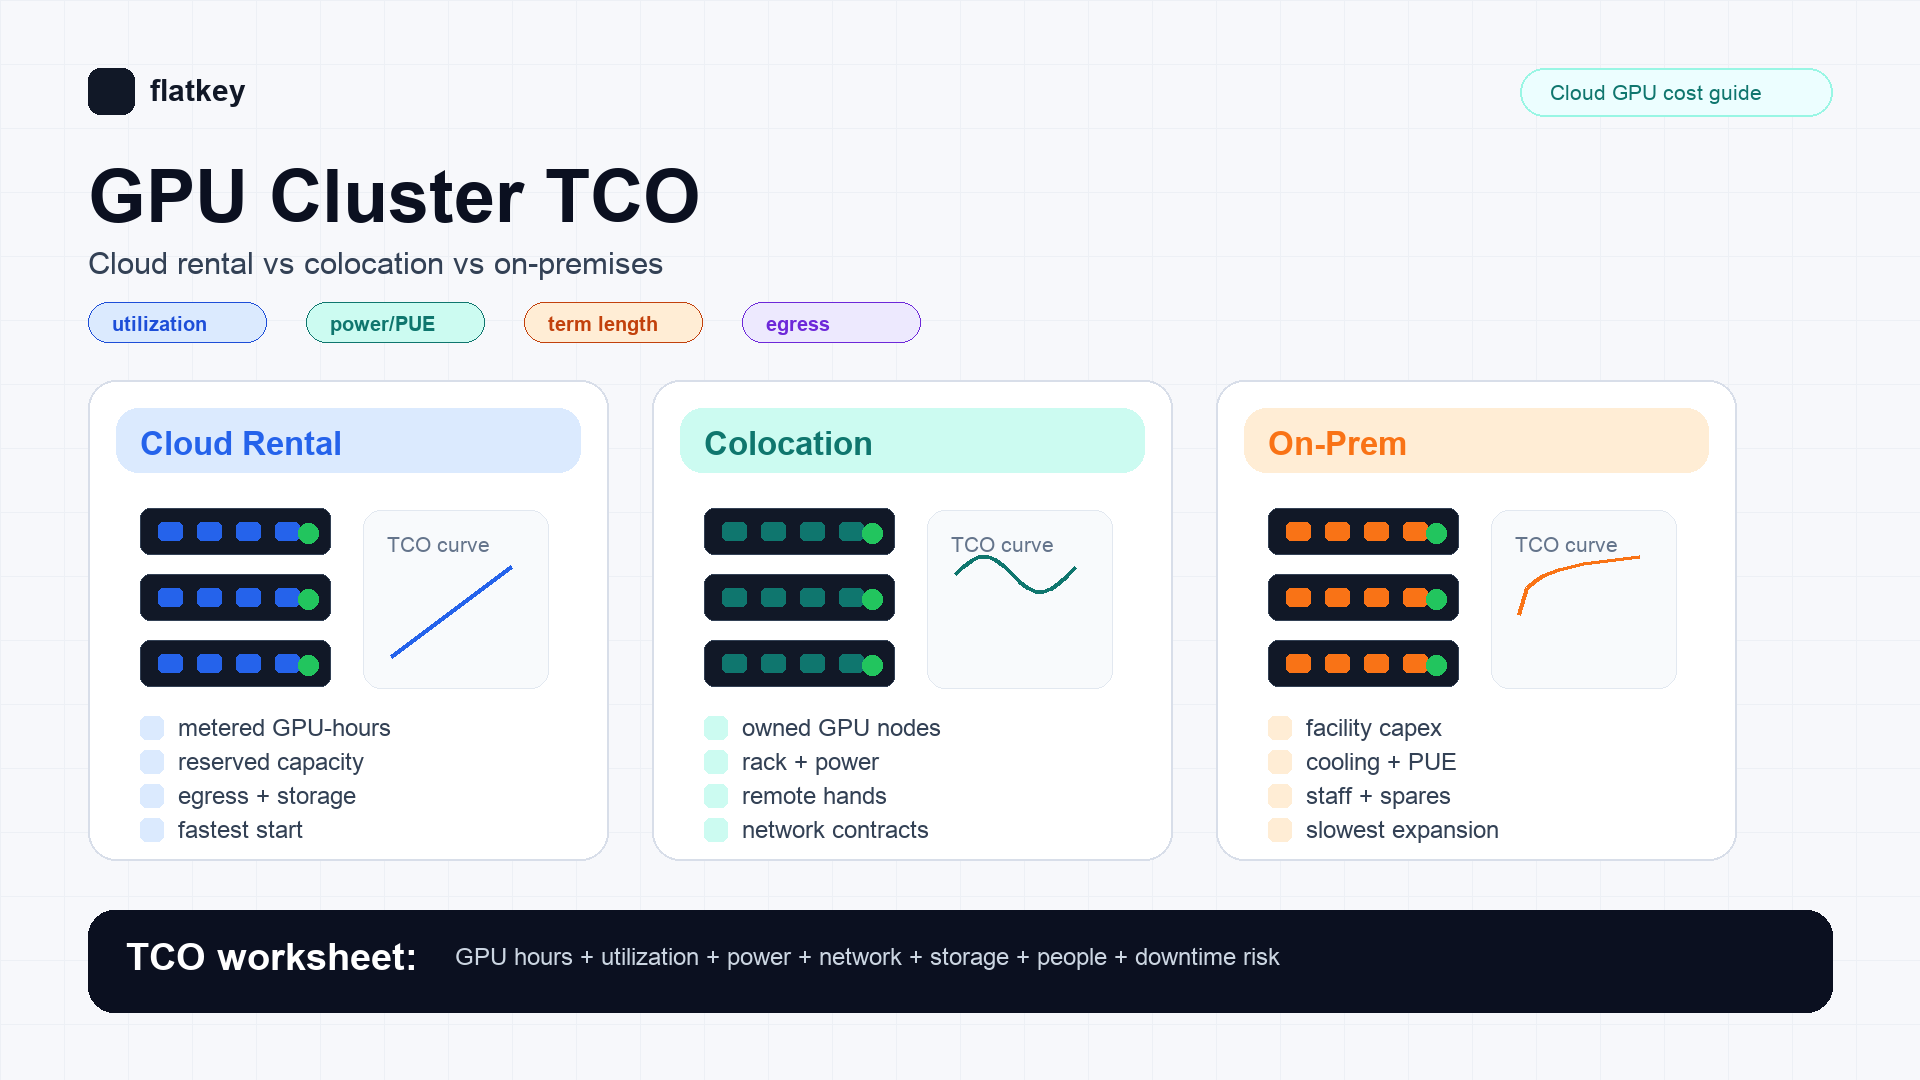
GPUクラスターのTCO比較が失敗する理由は、ほぼ同じです。クラウドの時間単価とハードウェアの発注書を比較してしまうからです。それは意思決定ではありません。
本当の意思決定は、AIチームが柔軟性を買うのか、ハードウェアを買うのか、それとも設備の制御を買うのか、という点です。まともなGPUクラスターのTCOモデルは、クラウドレンタル、コロケーション、オンプレミスを同じ成果に正規化する必要があります。たとえば、完了した学習実行、承認された推論トークン、生成メディアジョブ、または確保済みキャパシティ月数です。
多くのチームでは、利用率が不確実で、立ち上げ速度が重要で、あるいはワークロードがモデルファミリごとに変わる場合、クラウドGPUレンタルが有利です。需要が安定しており、チームがハードウェアを運用でき、かつGPU、ネットワーク、予備機、リモートハンズを償却できるだけの十分に長い契約であれば、コロケーションが有利になり始めます。オンプレミスには通常、最も強い正当化が必要です。非常に高く予測可能な利用率、既存のデータセンター運用、厳しいローカリティ要件、または設備レイヤーを自社で保有するという戦略的な方針がそれに当たります。
Flatkeyの実務ルールは次のとおりです。ラックではなく、まずワークロードから始めてください。ワークロードがマネージドモデルAPIで提供できるなら、まずそれと比較します。専用GPUが本当に必要な場合は、キャパシティ契約に署名する前に、同じワークシートでクラウドレンタル、コロケーション、オンプレミスを見積もってください。
GPUクラスターTCOの簡易回答
完全なモデルを作る前に、この初回判定表を使ってください。
| 状況 | 通常まず検討するもの | 理由 |
|---|---|---|
| プロトタイプ、断続的なファインチューニング、短いベンチマーク期間 | クラウドGPUレンタル | コミットメントが最小で、キャパシティ確保までの最短経路だから。 |
| 既知のモデル構成を持つ、安定した数か月単位の推論フリート | クラウドの予約キャパシティまたはコロケーション | 利用率が十分高く、期間価格の交渉ができるが、所有リスクはまだ回避できる可能性があるため。 |
| 厳格なネットワークトポロジー要件のある大規模学習ジョブ | 専用クラウドクラスターまたはコロケーション | 予測可能なノード配置、ネットワークファブリック、ストレージのローカリティ、ベンチマークの受け入れが必要だから。 |
| 社内のハードルレートを上回る複数年利用 | コロケーションまたはオンプレミス | ハードウェア償却は、遊休時間、運用、電力、ダウンタイムを正直に織り込んだ場合にのみ、時間課金を上回れるから。 |
| 規制上のデータローカリティまたは設備制御の義務 | オンプレミスまたは管理されたコロケーション | TCOの判断には、計算コストだけでなく、コンプライアンスと制御が含まれるため。 |
| アプリが必要とするのはモデル出力だけで、GPU制御ではない | モデルAPIまたはGPU市場価格見積もり | ビジネスメトリクスが承認済み出力あたりのコストである場合、クラスター購入は過剰になり得るから。 |
このガイドの残りでは、調達、プラットフォームエンジニアリング、財務のいずれも使えるGPUクラスターTCOワークシートの作り方を示します。
すべての選択肢を1つの単位に正規化する
"H100 per hour" を "サーバー購入価格" と比較しないでください。分母を1つ選び、すべての विकल्पをそこに押し込んでください。
有用な分母には次のようなものがあります。
- 完了した学習実行あたりのコスト: 定期的なファインチューニング、事前学習実験、バッチジョブに最適です。
- 承認された出力あたりのコスト: リトライが重要なLLM推論、コード生成、画像生成、動画パイプラインに最適です。
- 予約済みGPU月あたりのコスト: 複数の製品チーム向けに社内キャパシティを購入するプラットフォームチームに最適です。
- SLA適合トークンまたはジョブあたりのコスト: ダウンタイム、プリエンプション、キュー遅延がユーザー向けの信頼性に影響する場合に最適です。
推論では、最も明確な分母はしばしば次の式です。
effective_cost_per_accepted_output =
  total_monthly_cluster_cost
  / accepted_outputs_after_retries_and_quality_filters
この分母は、時間単価が隠してしまう2つの要素、すなわち失敗したジョブと遊休キャパシティを捉えます。
GPUクラスターTCOの式
プロバイダー固有の詳細を追加する前に、このモデルを使ってください。
monthly_gpu_cluster_tco =
  capacity_cost
  + storage_cost
  + data_transfer_cost
  + network_and_interconnect_cost
  + software_and_observability_cost
  + labor_and_operations_cost
  + support_and_warranty_cost
  + financing_or_depreciation_cost
  + downtime_and_retry_waste
その後、関心のある単位に変換します。
unit_cost =
  monthly_gpu_cluster_tco
  / useful_work_completed_per_month
安価なGPU時間でも、クラスターの稼働率が低い、ジョブがキューで待つ、ストレージが不適切なリージョンにある、または失敗した実行が定価の時間を消費する場合は、なお高くつくからです。
展開モデル別のコスト要素
| コスト項目 | クラウドレンタル | コロケーション | オンプレミス |
|---|---|---|---|
| GPU capacity | オンデマンド、スポット、リザーブド、専有、または市場見積もり。 | ハードウェアの購入またはリースに加え、ラック契約。 | ハードウェアの購入またはリースに加え、社内施設の配賦。 |
| Power and cooling | 通常は料金に含まれるが、無料ではない。 | 契約電力、従量課金電力、冷却オーバーヘッド、および電力密度の制限。 | 商用電力、UPS、発電機、冷却設備、そしてPUEの影響。 |
| Network | エグレス、プライベートリンク、パブリックIP、リージョン間トラフィック、相互接続。 | トランジット、クロスコネクト、プライベートリンク、リモートアクセス、DDoS/セキュリティサービス。 | WAN、インターネットトランジット、プライベートリンク、ファイアウォール、スイッチング、冗長経路。 |
| Storage | ブロック、オブジェクト、ファイルシステム、スナップショット、バックアップ、IOPSティア。 | ローカルNVMe、共有ストレージ、バックアップ先、リモートレプリケーション。 | ストレージハードウェア、バックアップ、レプリケーション、メディア交換、ライフサイクル運用。 |
| Operations | 主にプラットフォーム統合とコスト管理。 | ハードウェアのライフサイクル、リモートハンズ、受入テスト、予備部品、RMA調整。 | 施設およびハードウェアの完全な運用、物理アクセス、予備部品、時間外対応。 |
| Commitment risk | オンデマンドでは低いが、リザーブドまたは専有契約では高くなる。 | 中〜高。契約終了とハードウェアの再販が重要。 | 最も高い。施設と設備の決定は、モデルのロードマップより長く続くことがある。 |
クラウドレンタルは、多くのコストが料金にまとめられているため単純に見えます。コロケーションやオンプレミスは、スプレッドシートが人員、電力、ネットワーク、障害対応予算を忘れると、安く見えます。
クラウドレンタル:何を計算に入れるか
クラウドレンタルは、容量を従量課金サービスに変換するため、GPUクラスターのTCOにおける最も分かりやすいベースラインです。だからといって、時間単価が総コストであるわけではありません。
Count:
- GPUインスタンスまたはベアメタルの時間単価。
- リザーブド、コミット、または専有の容量条件。
- クラスターに接続されたストレージ。
- オブジェクトストレージとスナップショット保持。
- データ転送とエグレス。
- プライベートネットワーク、ロードバランサー、パブリックIP、NAT。
- スケジューラ、Kubernetes、Slurm、オブザーバビリティ、ログ、アラート。
- キューの隙間、デプロイ失敗、コールドスタート、不適切なビンパッキングによるアイドル時間。
- 使用する場合は、スポットまたは中断可能な再試行の無駄。
- サポートプランとアカウント管理コスト。
チームの需要曲線が不確実な場合、クラウドレンタルが有利になることがよくあります。また、調達に対して最新の価格ベンチマークを提供します。AWS、Google Cloud、Lambda、RunPod、その他のGPUクラウドの公開プロバイダーページはソース確認に役立ちますが、大規模クラスターで本当に重要なのは、必要なリージョン、トポロジー、契約期間で実際に予約できる見積もりだけです。
公式ページは確認ポイントとして使ってください:
- AWSは、EC2 P5インスタンスページで大規模AIワークロード向けのP5クラス基盤を説明しています。
- Google CloudはGPU価格を公開し、価格はGPUの種類、リージョン、利用モデルに依存すると記載しています。
- LambdaとRunPodは、簡易な市場確認に役立つGPUクラウド価格表を公開しています。
- Flatkey Computeは、ライブのGPU時間単価インデックスを公開し、購入者が匿名のGPUリクエストを出して、認証済みサプライヤーが入札できるようにしています。
すべての価格はタイムスタンプ付きとして扱ってください。GPUの在庫と時間単価は、一般的なSaaS価格より速く変動します。
コロケーション:何を計算に入れるか
コロケーションは、単に「クラウドだが安い」ではありません。運用負担の大きな部分を、プロバイダーから自社チームへ移します。
Count:
- GPUサーバー、ネットワークアダプター、スイッチ、光トランシーバー、ケーブル、ストレージ。
- ラックまたはケージ費用。
- 契約電力と従量課金電力。
- 冷却と密度の制約。
- クロスコネクト、インターネットトランジット、プライベートリンク、ネットワークセキュリティ。
- リモートハンズ、出荷、受領、設置、在庫管理、RMA対応。
- 予備GPU、電源ユニット、NIC、光トランシーバー、ファン、ストレージドライブ。
- ハードウェアの減価償却、リースコスト、資金調達コスト、再販前提。
- 施設SLA、メンテナンスウィンドウ、アクセス手順。
- プラットフォーム運用: イメージ、ドライバー、CUDAスタック、KubernetesまたはSlurm、オブザーバビリティ、セキュリティパッチ適用、インシデント対応。
コロケーションが有効になり始めるのは、利用率が予測可能で高く、チームに本格的なインフラ運用能力があり、契約が計画するGPU世代に十分な電力密度を提供するときです。ハードウェアを購入したものの、リモートハンズ、ネットワーク、電力制約、予備部品、拡張の遅さを見積もり誤ると失敗します。
GPUクラスターでは、ネットワークファブリックがアーキテクチャを決める項目になることが多いです。密結合トレーニングを必要とするクラスターは、独立した推論ノードの集合と同等ではありません。ワークロードがInfiniBand、RoCE、NVLink、NVSwitch、または特定のストレージ構成に依存する場合、それを見積もりと受入テストの一部にしてください。
オンプレミス:何を計算に入れるか
オンプレミスのGPUクラスターTCOは、サーバー購入ではなく、施設プロジェクトとして扱うべきです。
Count:
- コロケーションモデルのすべて。
- データホールのスペース配分または構築。
- 電気工事、UPS、発電機、電力配電、消火設備。
- 冷却設備の容量と保守。
- 物理セキュリティと入退室管理。
- 施設スタッフと時間外のエスカレーション。
- 保険、コンプライアンス監査、安全手順。
- 次のGPU世代に向けた長期の容量計画。
- 施設とハードウェアに縛られる資本の機会費用。
オンプレミスは、既存のデータセンター基盤が充実している組織、高い稼働率、厳格なローカリティ要件、または戦略的な統制要件がある場合には正当化できます。モデルの組み合わせ、コンテキスト長、スループット目標、そしてプロダクトマーケットフィットをまだ模索している段階では、最も弱い選択肢です。
見落とされがちなリスクは GPU 世代交代です。設備の意思決定は、提供しているモデルアーキテクチャより長く続くことがあります。TCO が、あるモデルファミリーが3年間にわたって優勢であり続けることに依存しているなら、その前提をストレステストしてください。
損益分岐稼働率
中核となる損益分岐点の問いは次のとおりです:
required_utilization =
  owned_monthly_cost
  / equivalent_cloud_monthly_cost_at_100_percent_use
自社保有インフラの月額コストが $X で、同等のクラウドレンタルをフル稼働で利用した場合の月額コストが $Y なら、有効稼働率が X / Y を上回る場合にのみ保有は成立します。有効稼働率とは、そうでなければ支払い対象になっていたであろう作業を指します。遊休在庫、失敗したジョブ、キューの余白、まれなピークのために確保した容量は含みません。
モデルは次の3つのシナリオで実行してください:
| シナリオ | 検証内容 |
|---|---|
| ベースケース | 想定ワークロード、想定稼働率、想定期間。 |
| ダウンサイドケース | 稼働率低下、製品利用の遅れ、再販価値の低下、電力コスト上昇、導入承認の遅延。 |
| ストレスケース | 新しいモデルがメモリに収まらない、ネットワークトポロジーが適切でない、または需要がマネージド API に移行する。 |
ダウンサイドケースで経済性が崩れるなら、通常はクラウドレンタルか、より短い専用契約から始めるほうが安全です。
そのまま使える GPU クラスタ TCO ワークシート
このワークシートを調達文書で使ってください。クラウドレンタル、コロケーション、オンプレミスそれぞれで1回ずつ記入します。
| 項目 | クラウドレンタル | コロケーション | オンプレミス |
|---|---|---|---|
| GPU モデルと台数 | |||
| 契約期間 | |||
| 想定有効稼働率 | |||
| GPU 容量の月額コスト | |||
| ストレージとバックアップ | |||
| データ転送とネットワーク | |||
| 電力と冷却 | 込み、または見積もり済み | ||
| ラック、ケージ、または設備割り当て | N/A | ||
| ハードウェアの償却またはリース | N/A | ||
| リモートハンズ / スタッフ | |||
| サポート、保証、予備部品 | |||
| 可観測性とプラットフォームツール | |||
| ダウンタイムと再試行の無駄 | |||
| 見積月額 TCO | |||
| 単位コストの分母 | |||
| 承認済み出力1件あたりのコスト | |||
| 拡張のリードタイム | |||
| 退出コスト |
最後の2行を省略しないでください。拡張のリードタイムと退出コストこそが、魅力的なハードウェア経済性を高くつかせる要因です。
すべてのベンダーに尋ねるべき調達質問
クラウドレンタルの場合:
- 提示された容量は共有、予約済み、専有、またはベアメタルのどれですか?
- どのリージョン、アベイラビリティゾーン、ノード配置が保証されますか?
- 正確な GPU モデル、メモリサイズ、相互接続、CPU、RAM、ローカルストレージ、ネットワークファブリックは何が含まれますか?
- ストレージ、スナップショット、オブジェクトストレージ、帯域幅、パブリック IP、サポートは含まれますか?
- 契約期間中にクラスタが利用できない場合はどうなりますか?
- コミットメント開始前に、提供者は受入ベンチマークを実行できますか?
- 失敗したジョブ、プラットフォーム障害、メンテナンス時間はどのようにクレジットされますか?
コロケーションの場合:
- ラックあたりの契約電力密度はどれくらいですか?
- 電力は計測、コミット、またはラック価格に組み込まれていますか?
- どのリモートハンズ作業が含まれ、何が課金対象ですか?
- 利用可能なキャリアとプライベートリンクはどれですか?
- 追加のラック、電力、クロスコネクトはどのくらいの速さで用意できますか?
- 予備部品、RMA、ファームウェア保守の所有者は誰ですか?
- クラスタが本番対応であることを確認する受入テストは何ですか?
オンプレミスの場合:
- 設備はすでに対象の電力密度をサポートしていますか?
- 増設工事なしで冷却 क्षमताは利用できますか?
- 24/7 のハードウェア対応は誰が担当しますか?
- 電気、ネットワーク、セキュリティの変更に対する承認フローは何ですか?
- 償却期間はどれくらいで、どの再販価値を想定していますか?
- 次のモデルがより多くのメモリ、より広い帯域幅、または別のサービングスタックを必要とした場合はどうなりますか?
意思決定マトリクス
| 基準 | クラウドレンタル | コロケーション | オンプレミス |
|---|---|---|---|
| 導入スピード | 最速 | 中程度 | 最も遅い |
| 初期資本 | 最小 | 中〜高 | 最大 |
| 運用負荷 | 最小 | 中程度 | 最大 |
| 長期的な安定稼働時の経済性 | 中程度 | うまく運用できれば高い | 設備の成熟度がある場合のみ高い |
| GPU世代ごとの柔軟性 | 最良 | 中程度 | 最小 |
| 設備の管理制御 | 低い | 中程度 | 最大 |
| 調達の可逆性 | 最良 | 中程度 | 最小 |
| ベンチマーク要件 | 重要 | 極めて重要 | 極めて重要 |
最も妥当な答えは、「常にクラウド」でも「常に購入」でもありません。通常は段階的なアプローチです。探索にはレンタルを使い、安定需要には予約を使い、利用率が実証されたらコロケーションを行い、設備管理が要件の一部である場合にのみオンプレミスに移行します。
GPUクラスターのTCOモデルにおけるよくある誤り
定価と最良ケースの所有コストを比較する
公平なGPUクラスターTCOモデルは、実際の見積もりと実際の所有コストを比較します。クラウドの定価は、予約済み容量や交渉済み容量と同じではありません。ハードウェアの購入価格は、運用中のクラスターコストと同じではありません。
利用率を無視する
実効利用率が40%の所有クラスターは、時間単価がはるかに高いクラウドクラスターに負けることがあります。設置済みGPU数ではなく、実際に有効な作業量を測定してください。
ネットワークトポロジーを後回しにする
GPU数だけではクラスターは定義できません。学習、ファインチューニング、高スループット推論では、ネットワークとストレージの要件が大きく異なる場合があります。
再試行による無駄を忘れる
再試行、デプロイ失敗、プリエンプション、低品質な出力はすべて単位コストを押し上げます。再試行の無駄は、分子だけでなく分母にも含めてください。
人件費を過小評価する
ドライバ、CUDAバージョン、コンテナイメージ、スケジューラ、監視、ファームウェア、セキュリティパッチ適用、インシデント対応は、GPUクラスターTCOの一部です。見積書に載っていなくても、誰かがその費用を負担しています。
モデルAPIがGPUクラスターより優れる場合
専用GPUクラスターは、常に適切な抽象化とは限りません。製品が必要としているのがハードウェア制御ではなくモデル出力だけなら、クラスターTCOとAPI経路を比較してください。
次のような場合、モデルAPIが有利になることがあります。
- トラフィックがスパイキーである。
- モデルの組み合わせが頻繁に変わる。
- 複数のフロンティアモデルとオープンモデルにアクセスする必要がある。
- チームがGPUを高い利用率で維持できない。
- 品質フィルタと再試行をリクエスト層で管理しやすい。
- 財務部門が、インフラプールではなくリクエストごとの利用記録を求めている。
Flatkeyはここで重要です。なぜなら、同じ購入者がしばしば両方の経路を必要とするからです。Flatkey Computeは、チームが稼働中のGPU時間容量を比較し、匿名のGPU需要を投稿し、サプライヤーの入札を受け取るのを支援します。FlatkeyのモデルおよびツールAPIレイヤーは、GPUレイヤーを所有する必要がない場合でも、1つのキー、1つの残高、1つの使用台帳でAIワークロードをルーティングする方法をチームに提供します。
実務上のワークフローは次のとおりです。
- レンタルGPUでワークロードをベンチマークする。
- 受け入れ済み出力1件あたりのコストを計算する。
- 同じワークロードをモデルAPI経由で比較する。
- 下振れシナリオでも専用ハードウェアが明確に有利な場合にのみ、予約またはコロケーションを行う。
GPUクラスターTCOモデルのためのソースチェックリスト
別の記事から古い料金をコピーするのではなく、最新のソースページと見積書を使用してください。
| ソースの種類 | 確認すべき内容 |
|---|---|
| クラウドGPUプロバイダのページ | インスタンス種別、GPU数、リージョン、ストレージ、ネットワーク、および料金がオンデマンド、予約、スポット、または専有のどれか。 |
| GPUベンダーのシステム仕様 | 電力、メモリ、相互接続、サーバーフォームファクタ、および対応トポロジー。 |
| コロケーション見積もり | ラック/ケージ、電力、リモートハンズ、クロスコネクト、ネットワーク、設置費用、および拡張制限。 |
| 公共料金またはエネルギーデータ | 電力価格の前提と上昇率。 |
| 社内プラットフォームデータ | 実際の利用率、キュー遅延、失敗率、再試行率、受け入れ済み出力量、およびスタッフ工数。 |
| 財務前提 | 償却期間、資本コスト、税務上の扱い、残存価値、および契約終了コスト。 |
有用な出発点:
- Flatkey Compute は、稼働中のGPU時間市場コンテキストと需要投稿に役立ちます。
- Flatkey Compute price index は、時間単価の市場参照確認に役立ちます。
- AWS EC2 P5 instances は、H100クラウドクラスターのインフラコンテキストに役立ちます。
- Google Cloud GPU pricing は、タイプとリージョン別のGPU価格設定方法に役立ちます。
- Lambda GPU Cloud は、専門クラウドGPUの価格コンテキストに役立ちます。
- RunPod pricing は、マーケットプレイスおよびクラウドGPUの価格確認に役立ちます。
- NVIDIA DGX H100 および NVIDIA DGX B200 は、ベンダーのシステム仕様確認に役立ちます。
- U.S. Energy Information Administration electricity data は、電力コストの前提に役立ちます。
- FinOps FOCUS は、財務チームが標準化されたクラウドコスト項目を必要とする場合に役立ちます。
よくある質問
GPUクラスターのTCOとは何ですか?
GPUクラスターのTCOとは、クラスターから有用なAI計算を提供するための総コストです。これには、GPU容量、ストレージ、ネットワーク、電力、冷却、人件費、ソフトウェア、サポート、ダウンタイム、再試行の無駄、そして資本リスクまたは契約リスクが含まれます。
クラウドのGPUレンタルは、GPUを購入するより常に高いのですか?
いいえ。利用率が不確実な場合、ワークロードが短期間の場合、運用能力がチームにない場合、またはモデルスタックが急速に変化する場合は、クラウドのGPUレンタルのほうが安くなることがあります。GPUの購入やコロケーションが有利になるのは、有用な利用率が、運用、電力、ネットワーク、資金調達、そして撤退リスクを相殺できるほど高い場合だけです。
コロケーションがクラウドレンタルより有利になるのはいつですか?
需要が安定しており、契約期間が長く、電力密度が十分で、ハードウェアが高い稼働率で使われ、かつチームがクラスターを運用できる場合、コロケーションはクラウドレンタルに勝ることがあります。ハードウェアの購入価格がクラウドの定価より安く見えるというだけでは、クラウドレンタルに勝つことにはなりません。
チームはいつオンプレミスのGPUを選ぶべきですか?
設備の制御、データの所在地、コンプライアンス、または戦略的なインフラ所有が運用負担に見合う場合は、オンプレミスのGPUを選びます。ほとんどのAIプロダクトチームにとって、オンプレミスはデフォルトではなく、正当化の最後の選択肢です。
FinOpsチームはGPUクラスターの選択肢をどのように比較すべきですか?
FinOpsチームは、時間単価だけでなく、有用な出力あたりのコストで選択肢を比較すべきです。ワークシートには、利用率、再試行の無駄、ストレージ、データ転送、人件費、電力、契約期間、拡張リードタイム、撤退コストを含めるべきです。
FlatkeyはGPUクラスターのTCOにどう位置づけられますか?
Flatkeyは、チームが間違った抽象化を購入するのを避けるのに役立ちます。市場価格のGPU容量やサプライヤーの見積もりが必要な場合は、Flatkey Computeを使ってください。モデル出力、1つのキー、1つの残高、リクエスト単位の利用台帳だけが必要な場合は、FlatkeyのモデルおよびツールAPI層を使ってください。
結論
最良のGPUクラスターTCOモデルは、最も長いスプレッドシートではありません。次の3つの判断を明確にできるモデルです。
- そのワークロードがそもそも専用GPUを必要とするか。
- クラウドレンタル、コロケーション、オンプレミスのどれが、下振れリスクを織り込んだうえで最も低コストか。
- 利用率、モデル構成、電力、可用性が変わっても、その契約が依然として機能するか。
まずはレンタル容量か、ライブのGPU市場見積もりから始め、実際のワークロードをベンチマークし、承認済み出力あたりで正規化してください。そして、有用な利用率の計算が下振れケースでも成立するときにだけ、コロケーションやオンプレミスへ進んでください。
それでも答えが不確かなら、選択肢の価値を維持してください。GPUクラスターのTCOは、ワークロードが実証される前にハードウェアへ固定するのではなく、段階的に容量を購入するチームに報います。


