Grok 4.3 vs GPT-5:ベンチマーク、価格、使い分けのルーティング
Grok 4.3 vs GPT-5:ベンチマーク、価格、使い分けのルーティングは、2026年10月時点ではレガシーモデルのルーティングに関する問題です。OpenAIは、gpt-5モデルIDおよびgpt-5-2025-08-07スナップショットを2026年12月11日に削除する予定です。移行表ではgpt-5.6-solが示されており、現在のモデルガイダンスでは、新しい複雑な推論またはコーディングのワークロードにはGPT-6 Astraが推奨されています。xAIのリリースノートでは、現在の最先端GrokルートとしてGrok 4.7が掲載されています。それでも、多くのチームは、古いエージェント、ダッシュボード、ベンチマーク、調達メモがこれらの名前を前提に作られているため、Grok 4.3とGPT-5を比較する必要があります。
簡潔に言うと、より低い公表出力価格、より大きな文書化済みコンテキストウィンドウ、xAI互換の推論コントロールが有効なワークロードでは、まずGrok 4.3を使用します。アプリケーションがOpenAIネイティブのResponses APIの動作、ホスト型ツール、プロンプトキャッシュ、Chat Completions互換性、または既存のOpenAI評価ベースラインに依存する場合は、まずGPT-5を使用します。本当の問題がモデル品質だけではなく、すべてのサービスにキー、請求書、ログ、フォールバックコードを分散させずにモデルを切り替えることである場合は、ルーターを使用します。
この判断を公開ベンチマークのラベルだけで行わないでください。ワークロード上でモデルを比較し、受け入れられた出力あたりのコストに基づいてルーティングしてください。
クイック比較:Grok 4.3 vs GPT-5
| 判断領域 | Grok 4.3 | GPT-5 | ルーティングに関する注記 |
|---|---|---|---|
| 最新性の状況 | 旧世代のGrokルート。xAIのリリースノートでは現在、Grok 4.7が現行として強調されています。 | 非推奨。OpenAIはgpt-5およびgpt-5-2025-08-07を2026年12月11日に削除する予定です。 |
両方をレガシールートとして扱い、削除日より前にGPT-5の移行を計画してください。 |
| モデルID | grok-4.3、エイリアスはgrok-4.3-latest。 |
gpt-5、デフォルトのスナップショットはgpt-5-2025-08-07。 |
再現可能なテストのため、正確なモデルIDまたはスナップショットを固定してください。 |
| 入力と出力 | テキストおよび画像入力、テキスト出力。 | テキストおよび画像入力、テキスト出力。 | どちらも視覚支援付きテキストワークフローに適合しますが、動画向けのルートではありません。 |
| コンテキスト | xAIは100万トークンのコンテキストウィンドウを掲載しており、プロンプトトークンが200kを超える場合は長文コンテキスト価格が適用されます。 | OpenAIは400kのコンテキストウィンドウ、272kの最大入力トークン、128kの最大出力トークンを掲載しています。 | 見出し上のコンテキスト数値だけでなく、実際に利用可能なコンテキストをテストしてください。 |
| 公表テキスト価格 | プロンプトトークンが200k未満の場合、100万トークンあたり入力$1.25/キャッシュ済み$0.20/出力$2.50。プロンプトトークンが200k以上の場合は$2.50/$0.40/$5.00。 | 100万トークンあたり入力$1.25/キャッシュ済み$0.125/出力$10。 | Grok 4.3は公表出力価格が低く、GPT-5はキャッシュ済み入力が低価格です。 |
| バッチ | xAIはGrok 4.3をバッチ対応としており、20%のバッチ割引を提供しています。 | OpenAIはGPT-5 Batchをサポート対象として掲載しています。 | バッチが有効なのは、応答の遅延を許容できる場合のみです。 |
| ツール機能 | xAIのドキュメントには、関数呼び出し、構造化出力、推論、推論努力量のオプションが掲載されています。 | OpenAIのドキュメントには、ストリーミング、構造化出力、関数呼び出し、ファイル検索、画像入力、ウェブ検索、プロンプトキャッシュ、サポート対象のResponses APIツールが掲載されています。 | OpenAIホスト型ツールが要件に含まれる場合、通常はGPT-5のほうが強力です。 |
これが、Grok 4.3 vs GPT-5:ベンチマーク、価格、使い分けのルーティングにおける実践的なベンチマークの出発点です。公開仕様は異なるコストとコンテキストの特性を示していますが、本番環境での勝者は、最も低い受け入れ済み出力コストでバリデーターを通過するルートです。
モデル名ではなくルートをベンチマークする
公開モデルのリーダーボードは発見には有用ですが、本番環境での問いに答えることはほとんどありません。ベンチマークスコアでは、ルートが正確なスキーマを維持するか、レート制限から復旧できるか、正しい場所に使用状況を記録するか、再試行後も予算内に収まるかは分かりません。
トラフィックを移行する前に、小規模なベンチマークパックを作成してください。
| ベンチマークトラック | テスト対象 | ルートが変わる理由 |
|---|---|---|
| 推論とコーディング | エージェント、コーディング、分析、サポートのワークフローから得た実際のプロンプト50~200件。 | 一般的なベンチマークでの勝利が、あなたのプロンプト形式に転用できるとは限りません。 |
| 構造化出力 | 必須のJSONスキーマ、列挙型フィールド、ネストしたオブジェクト、無効入力のケース。 | より優れた文章を書くモデルでも、パーサーで失敗する可能性があります。 |
| ツール呼び出し | 必須ツール、ツール不要、誤ったツール、ツールエラーのケース。 | 一度の不適切なアクションが、より高いトークン価格よりも大きなコストになる可能性があります。 |
| 長文コンテキスト | p50、p90、最悪ケースの検索取得パック。 | 大きなコンテキストウィンドウは、信頼できる想起と同義ではありません。 |
| コスト | 入力トークン、キャッシュ済みトークン、出力トークン、バッチモード、再試行、拒否された出力。 | 受け入れ率を考慮しなければ、公表トークン価格だけでは不完全です。 |
| レイテンシ | 最初のトークンまでの時間、応答全体のレイテンシ、タイムアウト率、キューイングの挙動。 | ユーザー向けエージェントでは、コストが高くても高速なルートが必要になる場合があります。 |
| フォールバック | プロバイダーエラー、429、モデル未検出、スキーマ失敗、タイムアウト、品質低下した出力。 |
ロールバックルールのないルートは、本番環境に対応できていません。 |
ルートの指標は次のとおりです。
cost_per_accepted_output =
  (input_cost + cached_input_cost + output_cost + tool_cost + retry_cost + fallback_cost)
  / accepted_outputs
十分な品質とレイテンシーの余裕があるワークロードで、この式の結果が有利になる場合はGrok 4.3を使用してください。OpenAIネイティブの挙動によって、実装リスク、検証失敗、または統合コストが、表示されている出力価格の差を相殺できるほど低減される場合はGPT-5を使用してください。
価格:Grok 4.3が安価な領域と、GPT-5が依然として優位になり得る領域
短いコンテキストのテキストリクエストについて、xAIはGrok 4.3の価格を100万トークンあたり入力$1.25、キャッシュ済み入力$0.20、出力$2.50と記載しています。プロンプトトークンが20万以上の場合、xAIはより高い長文コンテキスト価格として、100万トークンあたり入力$2.50、キャッシュ済み入力$0.40、出力$5.00を記載しています。xAIはまた、Grok 4.3がバッチ対応であり、バッチ割引が20%であることも示しています。
OpenAIはGPT-5の価格を100万トークンあたり入力$1.25、キャッシュ済み入力$0.125、出力$10と記載しています。このため、GPT-5は表示上の出力トークン価格では高価ですが、Grok 4.3の短文コンテキスト向けキャッシュ済み入力の価格帯よりもキャッシュ済み入力は安価です。
価格判断はワークロードの形状によって変わります。
| ワークロードの形状 | 価格上の圧力 | 最初に試す可能性が高いもの |
|---|---|---|
| 短いプロンプト、長い生成回答 | 出力価格が支配的です。 | まずGrok 4.3を試し、その後、出力受け入れ率を比較します。 |
| 繰り返し使用する大規模なシステムプロンプトまたはポリシーパック | キャッシュ済み入力が重要です。 | 両方をテストしてください。キャッシュヒット率が高い場合、GPT-5のキャッシュ済み入力が重要になる可能性があります。 |
| プロンプトトークン20万超の長い検索結果パック | 長文コンテキスト価格が適用されます。 | 長文コンテキスト価格とレイテンシーを含めてGrok 4.3をテストします。 |
| OpenAIホスト型ツールまたはResponses APIのワークフロー | ツールおよび統合の挙動が重要です。 | 直接的な機能サポートによってアプリの複雑さを減らせる可能性があるため、まずGPT-5をテストします。 |
| オフライン評価またはバックフィル | バッチの経済性が重要です。 | 完了までの遅延を許容できる場合は、両方のバッチ経路をテストします。 |
表示されている入力価格だけを比較すると、Grok 4.3 vs GPT-5:ベンチマーク、価格、使い分けのルーティングは誤解を招くスプレッドシート上の演習になります。出力長、再試行率、ツール障害、人手レビューによって、見かけ上の節約は失われる可能性があります。
Grok 4.3にルーティングするべき場合
ワークロードがコスト重視で、出力比率が高く、OpenAIネイティブのツールに依存していない場合は、Grok 4.3から始めてください。
適した候補には次が含まれます。
- テキスト出力が長く、検証が単純な社内分析タスク。
- 文書化された100万トークンのコンテキストウィンドウが有用で、長文コンテキスト価格がなお代替案を上回る長文コンテキスト要約。
- バッチ処理が許容され、20%のバッチ割引が適用される評価ジョブ。
- 関数呼び出しまたは構造化出力を使用するものの、OpenAIホスト型ツールを必要としないワークフロー。
- GPT、Claude、Gemini、DeepSeek、またはQwenとの比較のためにGrokファミリーの経路が必要なモデル実験。
ローンチ前に、プロバイダーのコンソールまたはゲートウェイカタログで正確なGrok経路を確認してください。xAIにはより新しいGrok経路があり、Flatkeyの現在のローカルナレッジではgrok-4.3ではなくgrok-4.2が確認されているため、ライブカタログに表示されるまで、Grok 4.3がゲートウェイ経由で利用可能だと想定しないでください。
GPT-5にルーティングするべき場合
ワークロードがOpenAIのAPIサーフェスに依存している場合、または評価履歴ですでにGPT-5をベースラインとして使用している場合は、GPT-5から始めてください。
適した候補には次が含まれます。
- モデル実験のために書き直すべきではない、既存のOpenAI Chat CompletionsまたはResponses APIアプリケーション。
- Responses APIを介してウェブ検索、ファイル検索、画像生成、コードインタープリター、MCPなどのOpenAIホスト型ツールを使用するワークロード。
- OpenAIのプロンプトキャッシュ、構造化出力、ストリーミング、またはOpenAI固有のプロジェクト制御に依存する製品。
- 過去のGPT-5スナップショットが受け入れベースラインの一部である回帰テスト。
- より新しいモデルへ移行する前に、GPT-5を安定した参照経路として使用する移行監査。
期限に関する注記:OpenAIはgpt-5およびgpt-5-2025-08-07を2026年12月11日に削除する予定です。この比較は新規デプロイのデフォルトとしてではなく、移行検証のために使用してください。文書化されている移行先はgpt-5.6-solです。現在のOpenAIモデルガイダンスでは、新しい複雑な推論またはコーディングのワークロードにはGPT-6 Astraを推奨しています。
OpenAIはGPT-5を旧モデルとして文書化しています。新しいプロジェクトを開始する場合は、現在OpenAIが推奨するモデルも比較してください。固定されたレガシー経路が論点である場合、GPT-5は依然として有用ですが、最新のモデルレビューなしに新規構築のデフォルト回答として扱うべきではありません。
ルーターの方が適した選択となる場合
チームはGrok 4.3とGPT-5のどちらが優れているかをよく尋ねますが、実際のボトルネックは運用の分散です。
- プロバイダーごとに分かれたキー。
- プロバイダーごとに分かれたダッシュボードと請求書。
- プロバイダーごとに分かれたレート制限ポリシー。
- プロバイダーごとに分かれたステータス確認。
- プロバイダーごとに分かれた使用量エクスポート。
- エージェントやサービス全体にハードコードされた異なるモデルID。
- あるプロバイダーの性能が低下したときの共有フォールバックルールがないこと。
Flatkeyのポジショニングは、このレイヤーのために構築されています。1つのキー、1つの残高、1つの請求書、公式モデルアクセス、使用ログ、そしてOpenAI互換ルーターです。これは、すべてのプロバイダーネイティブ機能がすべての経路で自動的に動作することを意味するわけではありません。チームが、サポート対象モデルを比較し、使用状況の証拠を確認するための単一の運用画面を得られることを意味します。
本番トラフィックを変更する前に、この記事をAIモデルカタログガイド、AIルーティングAPIで実際に重要な指標のフレームワーク、そしてFlatkey APIクイックスタートと併せてご覧ください。
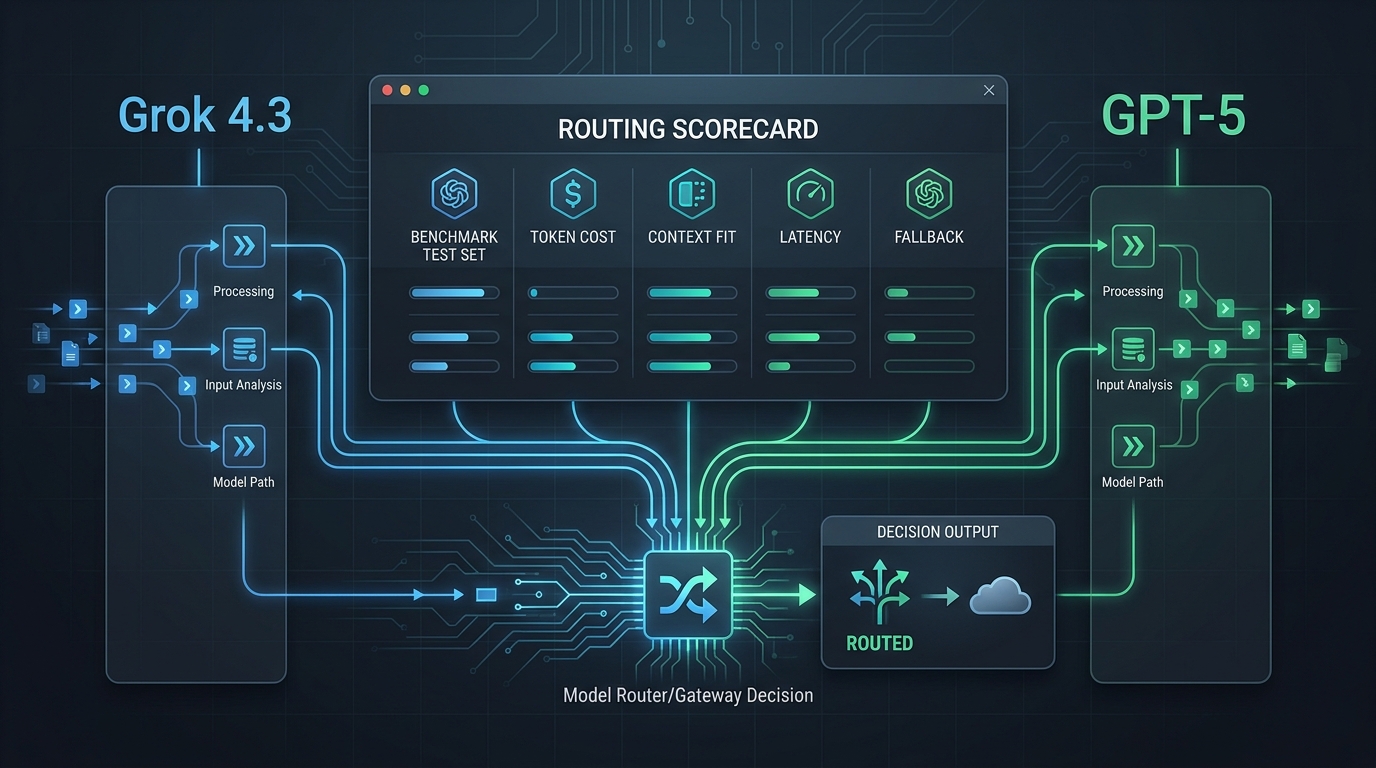
実践的なルーティング・スコアカード
Grok 4.3 vs GPT-5:ベンチマーク、価格、使い分けのルーティングには、このスコアカードを使用してください。同じワークロードに対して、各ルートを1~5で評価します。
| 評価基準 | 重み | Grok 4.3 | GPT-5 | 注記 |
|---|---|---|---|---|
| 承認済み出力率 | 25% | 回答はバリデーターまたはレビュー基準を通過しますか? | ||
| 承認済み出力あたりのコスト | 20% | プロンプトサイズ、出力長、キャッシュ、バッチ、ツール、リトライ、却下された出力を含めてください。 | ||
| ツールおよびスキーマの信頼性 | 15% | 無効なJSON、誤ったツール呼び出し、欠落フィールド、サポートされないパラメータをカウントします。 | ||
| コンテキストの信頼性 | 15% | p50、p90、および最悪ケースの検索パックをテストします。 | ||
| レイテンシーとタイムアウト | 10% | TTFT、完全な完了までの時間、タイムアウト率を測定します。 | ||
| 可観測性 | 10% | エンジニアリング部門と財務部門は、プロバイダー、モデル、トークン、コスト、レイテンシー、エラーを確認できますか? | ||
| フォールバック準備状況 | 5% | ロールバックはテスト済みで文書化されていますか? |
次に、ルート記録を作成します。
route_review:
  workload: support_case_summarization
  candidates:
    - grok-4.3
    - gpt-5
  required_features:
    - structured_output
    - streaming
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
  stop_conditions:
    - schema_failure_rate_above_threshold
    - timeout_rate_above_threshold
    - cost_per_accepted_output_above_budget
このポリシーは、リーダーボードのスクリーンショットよりも有用です。モデルが利用できない、遅すぎる、高すぎる、またはタスクに適していない場合に、アプリケーションが何をすべきかを指示できるためです。
トラフィック移行前のプレフライトチェックリスト
実際のユーザーをいずれかのモデルにルーティングする前に、以下を確認してください。
- モデルの可用性を確認する。 リリース当日に、直接プロバイダーのコンソールとすべてのゲートウェイカタログを確認します。
- モデルIDを固定する。
grok-4.3を意図的に使用してください。既存のGPT-5トラフィックについては、検証済みの移行を完了する間のみgpt-5-2025-08-07を固定します。これとgpt-5はいずれも2026年12月11日に廃止予定です。 - エンドポイントファミリーを確認する。 ワークロードがxAI互換ルート、OpenAI Chat Completions、OpenAI Responses、バッチ、またはゲートウェイエンドポイントのどれを使用するか確認します。
- 必要な機能をテストする。 ツール、構造化出力、画像入力、ストリーミング、キャッシュ、バッチは、ワークロードで実際に必要な場合にのみテストしてください。
- 使用可能なコンテキストを測定する。 現実的なコンテキストサイズで、再現率と引用の規律を確認します。
- 承認済み出力のコストを計算する。 リトライ、却下された出力、人手レビューを含めます。
- すべてのルートをログに記録する。 プロバイダー、モデル、リクエストID、入力トークン、出力トークン、キャッシュトークン、レイテンシー、ステータス、コストを記録します。
- フォールバックを定義する。 リトライ、ルート切り替え、キューイング、出力の縮退、クローズドフェイルを行うタイミングを決定します。
- 責任者を割り当てる。 キー、予算、クォータ、ルートの健全性、ロールバックに責任を持つ担当者を定めます。
- モデル変更後に再実行する。 GrokまたはGPTの新リリースにより、この比較はすぐに古くなる可能性があります。
FAQ:GPT-5.4およびGPT-5.5のバリアント
比較対象がGrok 4.3対GPT-5.4またはGPT-5.5の場合、何が変わりますか?
gpt-5.4またはgpt-5.5をGPT-5の列に代入し、同じ結果になると想定しないでください。モデルの各バージョンには、それぞれ固有の可用性、価格、コンテキスト上限、移行ステータスがあります。既存のGPT-5ワークロードを移行する場合は、この比較を用いて評価を設計し、その後、独自のプロンプトでGrok 4.3と正確にサポートされているOpenAIの代替モデルを比較してください。新規構築の場合は、非推奨のGPT-5モデルIDではなく、OpenAIの最新モデルガイダンスから始めてください。
参照し続けるべき情報源
ルートを最終決定する際は、最新のドキュメントを使用してください。
- GPT-5のステータス、スナップショット、コンテキスト、エンドポイント、機能、価格の概要については、OpenAI GPT-5モデルのドキュメントを参照してください。
- 現在のテキストトークン料金表とリージョン/高速モードに関する注意事項については、OpenAI APIの料金を参照してください。
- Grok 4.3のコンテキスト、価格、バッチ、モダリティ、推論コントロールについては、xAIのモデルと料金を参照してください。
- 現在のGrokモデルの最新性については、xAIリリースノートを参照してください。
- サードパーティのモデル探索指標については、独自のルートベンチマークの代替としてではなく、Artificial Analysisモデルリーダーボードを参照してください。
結論
Grok 4.3 vs GPT-5:ベンチマーク、価格、使い分けのルーティングでは、出力トークンが大半を占め、OpenAIネイティブのツールが不要な場合、Grok 4.3が通常、最初に価格を検討すべき選択肢です。アプリケーションがOpenAIのResponses API、ホスト型ツール、プロンプトキャッシュ、または既存のGPT-5ベースラインに依存している場合は、GPT-5が通常、最初に統合を検討すべき選択肢です。
本番環境では、この2つの判断を分けてください。まずワークロードを通過するモデルを選び、次にログ、コスト管理、フォールバック、そしてクリーンなロールバックパスを提供するルートを選びます。統合ルーターの価値が発揮されるのは、まさにこの点です。
Geminiも候補に入っている場合は、サブスクリプションとAPI価格の比較について、Grok vs Gemini(2026年10月)をお読みください。