Grok 4.3 so với GPT-5: Benchmark, Giá và Khi nào nên định tuyến từng mô hình
Grok 4.3 so với GPT-5: Benchmark, Giá và Khi nào nên định tuyến từng mô hình là một câu hỏi về định tuyến mô hình cũ vào tháng 10 năm 2026. OpenAI đã lên lịch loại bỏ ID mô hình gpt-5 và bản chụp gpt-5-2025-08-07 vào ngày 11 tháng 12 năm 2026. Bảng di chuyển của hãng trỏ đến gpt-5.6-sol, trong khi hướng dẫn mô hình hiện tại khuyến nghị GPT-6 Astra cho khối lượng công việc suy luận phức tạp hoặc lập trình mới. Ghi chú phát hành của xAI hiện liệt kê Grok 4.7 là tuyến Grok tiên phong hiện tại. Tuy vậy, nhiều nhóm vẫn cần so sánh Grok 4.3 và GPT-5 vì các agent, bảng điều khiển, benchmark và ghi chú mua sắm cũ được xây dựng xoay quanh những tên này.
Câu trả lời ngắn gọn: hãy ưu tiên dùng Grok 4.3 khi khối lượng công việc hưởng lợi từ giá đầu ra niêm yết thấp hơn, cửa sổ ngữ cảnh được tài liệu hóa lớn hơn và các cơ chế kiểm soát suy luận tương thích với xAI. Hãy ưu tiên dùng GPT-5 khi ứng dụng của bạn phụ thuộc vào hành vi Responses API gốc của OpenAI, công cụ được lưu trữ, bộ nhớ đệm prompt, khả năng tương thích Chat Completions hoặc một đường cơ sở đánh giá OpenAI sẵn có. Hãy dùng router khi vấn đề thực sự không chỉ là chất lượng mô hình, mà là chuyển đổi mô hình mà không phải phân tán khóa, hóa đơn, nhật ký và mã dự phòng khắp mọi dịch vụ.
Đừng đưa ra quyết định này chỉ dựa trên nhãn benchmark công khai. Hãy so sánh các mô hình trên khối lượng công việc của bạn, rồi định tuyến theo chi phí trên mỗi đầu ra được chấp nhận.
So sánh nhanh: Grok 4.3 so với GPT-5
| Khu vực quyết định | Grok 4.3 | GPT-5 | Lưu ý định tuyến |
|---|---|---|---|
| Trạng thái cập nhật | Tuyến Grok cũ; ghi chú phát hành của xAI hiện làm nổi bật Grok 4.7 là phiên bản hiện tại. | Đã bị ngừng hỗ trợ; OpenAI lên lịch loại bỏ gpt-5 và gpt-5-2025-08-07 vào ngày 11 tháng 12 năm 2026. |
Hãy coi cả hai là các tuyến cũ; lập kế hoạch di chuyển GPT-5 trước ngày loại bỏ. |
| ID mô hình | grok-4.3, bí danh grok-4.3-latest. |
gpt-5, bản chụp mặc định gpt-5-2025-08-07. |
Ghim ID mô hình hoặc bản chụp chính xác để kiểm thử có thể lặp lại. |
| Đầu vào và đầu ra | Đầu vào văn bản và hình ảnh; đầu ra văn bản. | Đầu vào văn bản và hình ảnh; đầu ra văn bản. | Cả hai phù hợp với quy trình văn bản có hỗ trợ thị giác; không mô hình nào là tuyến video. |
| Ngữ cảnh | xAI liệt kê cửa sổ ngữ cảnh 1M, với giá ngữ cảnh dài áp dụng trên 200k token prompt. | OpenAI liệt kê cửa sổ ngữ cảnh 400k, tối đa 272k token đầu vào và tối đa 128k token đầu ra. | Hãy kiểm thử ngữ cảnh có thể sử dụng, không chỉ con số ngữ cảnh nổi bật. |
| Giá văn bản niêm yết | $1.25 / $0.20 bộ nhớ đệm / $2.50 đầu ra trên mỗi 1M token dưới 200k token prompt; $2.50 / $0.40 / $5.00 ở mức 200k+ token prompt. | $1.25 / $0.125 bộ nhớ đệm / $10 đầu ra trên mỗi 1M token. | Grok 4.3 rẻ hơn về giá đầu ra niêm yết; GPT-5 có đầu vào được lưu đệm rẻ hơn. |
| Batch | xAI đánh dấu Grok 4.3 hỗ trợ batch với mức giảm giá batch 20%. | OpenAI đánh dấu GPT-5 hỗ trợ Batch. | Batch chỉ hữu ích khi có thể chấp nhận phản hồi chậm hơn. |
| Công cụ | Tài liệu xAI liệt kê gọi hàm, đầu ra có cấu trúc, suy luận và các tùy chọn mức độ suy luận. | Tài liệu OpenAI liệt kê streaming, đầu ra có cấu trúc, gọi hàm, tìm kiếm tệp, đầu vào hình ảnh, tìm kiếm web, bộ nhớ đệm prompt và các công cụ Responses API được hỗ trợ. | GPT-5 thường mạnh hơn khi các công cụ do OpenAI lưu trữ là một phần của yêu cầu. |
Đó là điểm khởi đầu benchmark thực tế cho Grok 4.3 so với GPT-5: Benchmark, Giá và Khi nào nên định tuyến từng mô hình. Các thông số công khai gợi ý những cấu trúc chi phí và ngữ cảnh khác nhau, nhưng bên chiến thắng trong môi trường sản xuất là tuyến vượt qua trình xác thực của bạn với chi phí đầu ra được chấp nhận thấp nhất.
Đánh giá benchmark cho tuyến, không phải tên mô hình
Các bảng xếp hạng mô hình công khai hữu ích cho việc khám phá, nhưng hiếm khi trả lời được câu hỏi về môi trường sản xuất. Điểm benchmark không cho bạn biết liệu một tuyến có giữ nguyên schema chính xác của bạn, phục hồi sau giới hạn tốc độ, ghi nhật ký mức sử dụng đúng nơi hay nằm trong ngân sách sau các lần thử lại hay không.
Hãy xây dựng một bộ benchmark nhỏ trước khi chuyển lưu lượng:
| Nhóm benchmark | Cần kiểm thử | Vì sao điều này thay đổi tuyến |
|---|---|---|
| Suy luận và lập trình | 50-200 prompt thực tế từ quy trình agent, lập trình, phân tích hoặc hỗ trợ. | Chiến thắng trong benchmark tổng quát có thể không chuyển sang dạng prompt của bạn. |
| Đầu ra có cấu trúc | Schema JSON bắt buộc, trường enum, đối tượng lồng nhau và các trường hợp đầu vào không hợp lệ. | Mô hình viết văn xuôi tốt hơn vẫn có thể làm hỏng trình phân tích cú pháp của bạn. |
| Lời gọi công cụ | Các trường hợp cần công cụ, không cần công cụ, dùng sai công cụ và lỗi công cụ. | Một hành động sai có thể tốn kém hơn giá token cao hơn. |
| Ngữ cảnh dài | Gói truy xuất p50, p90 và trường hợp xấu nhất. | Cửa sổ ngữ cảnh lớn không đồng nghĩa với khả năng nhớ lại đáng tin cậy. |
| Chi phí | Token đầu vào, token được lưu đệm, token đầu ra, chế độ batch, số lần thử lại và đầu ra bị từ chối. | Giá token niêm yết là chưa đầy đủ nếu không có tỷ lệ chấp nhận. |
| Độ trễ | Thời gian đến token đầu tiên, độ trễ phản hồi đầy đủ, tỷ lệ hết thời gian chờ và hành vi xếp hàng. | Agent hướng đến người dùng có thể cần một tuyến nhanh hơn ngay cả khi tốn kém hơn. |
| Dự phòng | Lỗi nhà cung cấp, 429, không tìm thấy mô hình, lỗi schema, hết thời gian chờ và đầu ra suy giảm. |
Một tuyến không có quy tắc khôi phục không sẵn sàng cho môi trường sản xuất. |
Chỉ số của tuyến nên là:
cost_per_accepted_output =
  (input_cost + cached_input_cost + output_cost + tool_cost + retry_cost + fallback_cost)
  / accepted_outputs
Sử dụng Grok 4.3 khi mô hình này thắng theo công thức đó cho một khối lượng công việc có đủ biên độ về chất lượng và độ trễ. Sử dụng GPT-5 khi hành vi thuần OpenAI giúp giảm rủi ro triển khai, lỗi xác thực hoặc chi phí tích hợp đủ để bù lại mức giá đầu ra niêm yết của nó.
Giá: Grok 4.3 rẻ hơn ở đâu và GPT-5 vẫn có thể thắng ở đâu
Đối với các yêu cầu văn bản có ngữ cảnh ngắn, xAI niêm yết Grok 4.3 ở mức 1,25 USD đầu vào, 0,20 USD đầu vào được lưu đệm và 2,50 USD đầu ra cho mỗi 1 triệu token. Với từ 200k token trong prompt trở lên, xAI niêm yết mức giá ngữ cảnh dài cao hơn: 2,50 USD đầu vào, 0,40 USD đầu vào được lưu đệm và 5,00 USD đầu ra cho mỗi 1 triệu token. xAI cũng đánh dấu Grok 4.3 là hỗ trợ batch với mức giảm giá batch 20%.
OpenAI niêm yết GPT-5 ở mức 1,25 USD đầu vào, 0,125 USD đầu vào được lưu đệm và 10 USD đầu ra cho mỗi 1 triệu token. Điều đó khiến GPT-5 đắt hơn về token đầu ra niêm yết, nhưng rẻ hơn về đầu vào được lưu đệm so với mức đầu vào được lưu đệm cho ngữ cảnh ngắn của Grok 4.3.
Quyết định về giá thay đổi theo cấu trúc khối lượng công việc:
| Cấu trúc khối lượng công việc | Yếu tố gây áp lực về giá | Thử nghiệm đầu tiên có khả năng phù hợp |
|---|---|---|
| Prompt ngắn, câu trả lời được tạo dài | Giá đầu ra chi phối. | Thử Grok 4.3 trước, sau đó so sánh tỷ lệ chấp nhận đầu ra. |
| Prompt hệ thống lớn hoặc gói chính sách được lặp lại | Đầu vào được lưu đệm là quan trọng. | Thử cả hai; đầu vào được lưu đệm của GPT-5 có thể quan trọng nếu tỷ lệ cache hit cao. |
| Gói truy xuất dài vượt quá 200k token trong prompt | Áp dụng mức giá ngữ cảnh dài. | Thử Grok 4.3 với giá ngữ cảnh dài và có tính cả độ trễ. |
| Công cụ do OpenAI lưu trữ hoặc quy trình Responses API | Hành vi của công cụ và tích hợp là quan trọng. | Thử GPT-5 trước vì hỗ trợ tính năng trực tiếp có thể giảm độ phức tạp của ứng dụng. |
| Đánh giá ngoại tuyến hoặc backfill | Tính kinh tế của batch là quan trọng. | Thử cả hai hướng batch nếu có thể chấp nhận hoàn thành chậm. |
Nếu bạn chỉ so sánh giá đầu vào niêm yết, Grok 4.3 so với GPT-5: Benchmark, Giá và Khi nào nên định tuyến từng mô hình sẽ trở thành một bài tập bảng tính gây hiểu lầm. Độ dài đầu ra, tỷ lệ thử lại, lỗi công cụ và đánh giá của con người có thể xóa sạch khoản tiết kiệm có vẻ đạt được.
Khi nào nên định tuyến đến Grok 4.3
Hãy bắt đầu với Grok 4.3 khi khối lượng công việc nhạy cảm về chi phí, có đầu ra lớn và không gắn với các công cụ thuần OpenAI.
Các ứng viên phù hợp gồm:
- Các tác vụ phân tích nội bộ có đầu ra văn bản dài và việc xác thực đơn giản.
- Tóm tắt ngữ cảnh dài, nơi cửa sổ ngữ cảnh 1M được tài liệu hóa là hữu ích và giá ngữ cảnh dài vẫn thấp hơn các lựa chọn thay thế.
- Các công việc đánh giá mà batch là chấp nhận được và áp dụng mức giảm giá batch 20%.
- Các quy trình sử dụng function calling hoặc đầu ra có cấu trúc, nhưng không yêu cầu công cụ do OpenAI lưu trữ.
- Các thử nghiệm mô hình mà bạn muốn có một tuyến thuộc họ Grok để so sánh với GPT, Claude, Gemini, DeepSeek hoặc Qwen.
Trước khi triển khai, hãy xác minh tuyến Grok chính xác trong bảng điều khiển nhà cung cấp hoặc danh mục gateway. xAI có các tuyến Grok mới hơn, và kiến thức cục bộ hiện tại của Flatkey xác nhận grok-4.2 thay vì grok-4.3, vì vậy đừng cho rằng Grok 4.3 khả dụng qua một gateway cho đến khi danh mục trực tiếp xác nhận điều đó.
Khi nào nên định tuyến đến GPT-5
Hãy bắt đầu với GPT-5 khi khối lượng công việc phụ thuộc vào bề mặt API của OpenAI hoặc khi lịch sử đánh giá của bạn đã dùng GPT-5 làm mốc chuẩn.
Các ứng viên phù hợp gồm:
- Các ứng dụng OpenAI Chat Completions hoặc Responses API hiện có không nên được viết lại chỉ để thử nghiệm mô hình.
- Khối lượng công việc sử dụng các công cụ do OpenAI lưu trữ như tìm kiếm web, tìm kiếm tệp, tạo ảnh, trình thông dịch mã hoặc MCP thông qua Responses API.
- Các sản phẩm dựa vào prompt caching, đầu ra có cấu trúc, streaming hoặc các kiểm soát dự án dành riêng cho OpenAI.
- Các kiểm thử hồi quy trong đó ảnh chụp nhanh GPT-5 trước đây là một phần của mốc chấp nhận.
- Các đợt kiểm toán di chuyển mà GPT-5 là tuyến tham chiếu ổn định trước khi chuyển sang mô hình mới hơn.
Lưu ý có thời hạn: OpenAI lên lịch loại bỏ gpt-5 và gpt-5-2025-08-07 vào ngày 11 tháng 12 năm 2026. Hãy dùng so sánh này để xác thực việc di chuyển, không phải làm mặc định cho triển khai mới. Đích di chuyển được tài liệu hóa là gpt-5.6-sol; hướng dẫn mô hình hiện tại của OpenAI khuyến nghị GPT-6 Astra cho khối lượng công việc suy luận phức tạp hoặc lập trình mới.
OpenAI ghi nhận GPT-5 là một mô hình trước đây. Nếu bạn bắt đầu một dự án mới, hãy so sánh cả mô hình hiện được OpenAI khuyến nghị. GPT-5 vẫn có thể hữu ích khi vấn đề là một tuyến cũ được ghim, nhưng không nên được xem là câu trả lời mặc định cho một bản dựng mới nếu chưa đánh giá mô hình hiện tại.
Khi nào router là câu trả lời tốt hơn
Các nhóm thường hỏi Grok 4.3 hay GPT-5 tốt hơn, nhưng nút thắt thực sự là sự phân mảnh trong vận hành:
- Các khóa nhà cung cấp riêng biệt.
- Các bảng điều khiển và hóa đơn riêng biệt.
- Các chính sách giới hạn tốc độ riêng biệt.
- Các bước kiểm tra trạng thái riêng biệt.
- Các tệp xuất mức sử dụng riêng biệt.
- Các ID mô hình khác nhau được mã hóa cứng trong các agent và dịch vụ.
- Không có quy tắc fallback dùng chung khi một nhà cung cấp suy giảm.
Định vị của Flatkey được xây dựng cho lớp đó: một khóa, một số dư, một hóa đơn, quyền truy cập mô hình chính thức, nhật ký sử dụng và một router tương thích OpenAI. Điều đó không có nghĩa mọi tính năng thuần nhà cung cấp tự động hoạt động qua mọi tuyến. Điều đó có nghĩa nhóm có một bề mặt vận hành duy nhất để so sánh các mô hình được hỗ trợ và xem xét bằng chứng về mức sử dụng.
Kết hợp bài viết này với hướng dẫn danh mục mô hình AI, khung chỉ số API định tuyến AI và hướng dẫn nhanh về API Flatkey trước khi thay đổi lưu lượng production.
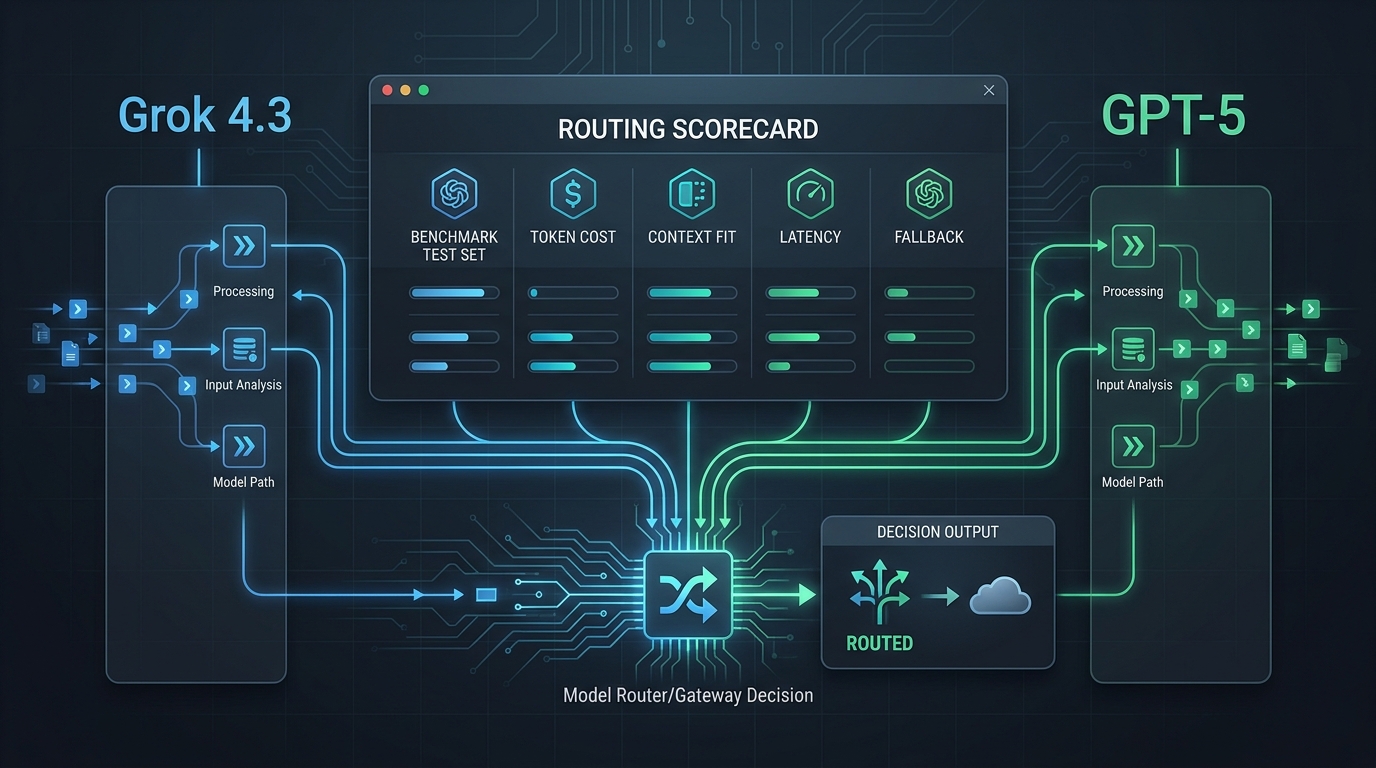
Bảng chấm điểm định tuyến thực tế
Sử dụng bảng chấm điểm này cho Grok 4.3 so với GPT-5: Benchmark, Giá và Khi nào nên định tuyến từng mô hình. Chấm điểm từng tuyến từ 1 đến 5 cho cùng một khối lượng công việc.
| Tiêu chí | Trọng số | Grok 4.3 | GPT-5 | Ghi chú |
|---|---|---|---|---|
| Tỷ lệ đầu ra được chấp nhận | 25% | Câu trả lời có vượt qua trình xác thực hoặc tiêu chí đánh giá của bạn không? | ||
| Chi phí cho mỗi đầu ra được chấp nhận | 20% | Bao gồm kích thước prompt, độ dài đầu ra, cache, batch, công cụ, lần thử lại và đầu ra bị từ chối. | ||
| Độ tin cậy của công cụ và schema | 15% | Đếm JSON không hợp lệ, lệnh gọi công cụ sai, trường bị thiếu và tham số không được hỗ trợ. | ||
| Độ tin cậy ngữ cảnh | 15% | Kiểm thử các gói truy xuất p50, p90 và trường hợp xấu nhất. | ||
| Độ trễ và hết thời gian chờ | 10% | Đo TTFT, thời gian hoàn thành đầy đủ và tỷ lệ hết thời gian chờ. | ||
| Khả năng quan sát | 10% | Bộ phận kỹ thuật và tài chính có thể kiểm tra nhà cung cấp, mô hình, token, chi phí, độ trễ và lỗi không? | ||
| Mức độ sẵn sàng dự phòng | 5% | Việc rollback đã được kiểm thử và lập tài liệu chưa? |
Sau đó, viết một bản ghi tuyến:
route_review:
  workload: support_case_summarization
  candidates:
    - grok-4.3
    - gpt-5
  required_features:
    - structured_output
    - streaming
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
  stop_conditions:
    - schema_failure_rate_above_threshold
    - timeout_rate_above_threshold
    - cost_per_accepted_output_above_budget
Chính sách đó hữu ích hơn ảnh chụp màn hình bảng xếp hạng vì nó cho ứng dụng của bạn biết cần làm gì khi một mô hình không khả dụng, quá chậm, quá đắt hoặc không phù hợp với tác vụ.
Danh sách kiểm tra trước khi chuyển lưu lượng
Thực hiện các kiểm tra này trước khi định tuyến người dùng thực đến một trong hai mô hình:
- Xác nhận tính khả dụng của mô hình. Kiểm tra bảng điều khiển của nhà cung cấp trực tiếp và mọi danh mục gateway vào cùng ngày bạn ra mắt.
- Ghim ID mô hình. Chủ động sử dụng
grok-4.3. Với lưu lượng GPT-5 hiện có, chỉ ghimgpt-5-2025-08-07trong khi hoàn tất quá trình di chuyển đã được xác thực; cả mô hình này vàgpt-5đều được lên lịch gỡ bỏ vào ngày 11 tháng 12 năm 2026. - Xác minh họ endpoint. Xác nhận liệu khối lượng công việc sử dụng các tuyến tương thích xAI, OpenAI Chat Completions, OpenAI Responses, batch hay endpoint gateway.
- Kiểm thử các tính năng bắt buộc. Công cụ, đầu ra có cấu trúc, đầu vào hình ảnh, streaming, caching và batch chỉ nên được kiểm thử nếu khối lượng công việc của bạn thực sự cần chúng.
- Đo lường ngữ cảnh có thể sử dụng. Kiểm tra khả năng truy hồi và tính kỷ luật trong trích dẫn ở các kích thước ngữ cảnh thực tế.
- Tính chi phí đầu ra được chấp nhận. Bao gồm các lần thử lại, đầu ra bị từ chối và đánh giá thủ công.
- Ghi log mọi tuyến. Ghi lại nhà cung cấp, mô hình, ID yêu cầu, token đầu vào, token đầu ra, token cache, độ trễ, trạng thái và chi phí.
- Xác định phương án dự phòng. Quyết định thời điểm thử lại, chuyển tuyến, xếp hàng đợi, giảm chất lượng đầu ra hoặc đóng lỗi.
- Phân công trách nhiệm. Giao cho một người trách nhiệm về khóa, ngân sách, hạn ngạch, tình trạng tuyến và rollback.
- Chạy lại sau các thay đổi mô hình. Các bản phát hành Grok hoặc GPT mới có thể nhanh chóng khiến so sánh này lỗi thời.
Câu hỏi thường gặp: các biến thể GPT-5.4 và GPT-5.5
Điều gì thay đổi khi so sánh là Grok 4.3 với GPT-5.4 hoặc GPT-5.5?
Đừng thay gpt-5.4 hoặc gpt-5.5 vào cột GPT-5 và cho rằng kết quả sẽ giống nhau. Mỗi phiên bản mô hình có tính khả dụng, giá, giới hạn ngữ cảnh và trạng thái di chuyển riêng. Nếu bạn đang chuyển một khối lượng công việc GPT-5 hiện có, hãy dùng so sánh này để thiết kế đánh giá, rồi so sánh Grok 4.3 với phương án thay thế OpenAI được hỗ trợ chính xác trên các prompt của riêng bạn. Đối với một bản dựng mới, hãy bắt đầu từ hướng dẫn mô hình hiện tại của OpenAI thay vì ID mô hình GPT-5 đã lỗi thời.
Các nguồn cần luôn mở để kiểm tra
Sử dụng tài liệu trực tiếp khi hoàn thiện một tuyến:
- tài liệu mô hình GPT-5 của OpenAI để biết trạng thái, snapshot, ngữ cảnh, endpoint, tính năng và tóm tắt giá của GPT-5.
- giá API OpenAI để biết các mức giá token văn bản hiện tại và các lưu ý về khu vực/chế độ nhanh.
- mô hình và giá xAI để biết ngữ cảnh, giá, batch, phương thức và các điều khiển suy luận của Grok 4.3.
- ghi chú phát hành xAI để biết độ mới hiện tại của mô hình Grok.
- bảng xếp hạng mô hình Artificial Analysis để xem các chỉ số khám phá mô hình của bên thứ ba, không phải để thay thế benchmark tuyến của riêng bạn.
Kết luận
Với Grok 4.3 so với GPT-5: Benchmark, Giá và Khi nào nên định tuyến từng mô hình, Grok 4.3 thường là lựa chọn đầu tiên để kiểm tra về giá khi token đầu ra chiếm ưu thế và không cần các công cụ gốc của OpenAI. GPT-5 thường là lựa chọn đầu tiên để kiểm tra khả năng tích hợp khi ứng dụng của bạn phụ thuộc vào Responses API của OpenAI, các công cụ được lưu trữ, cơ chế lưu đệm prompt hoặc một baseline GPT-5 hiện có.
Đối với môi trường production, hãy tách riêng cả hai quyết định: trước tiên chọn mô hình đáp ứng được workload của bạn, sau đó chọn tuyến cung cấp nhật ký, kiểm soát chi phí, phương án dự phòng và quy trình rollback rõ ràng. Đó là lúc một router hợp nhất phát huy giá trị.
Nếu Gemini cũng nằm trong danh sách của bạn, hãy đọc Grok so với Gemini (tháng 10 năm 2026) để xem so sánh về giá thuê bao và API.