Grok 4.3 vs GPT-5: benchmarks, precios y cuándo enrutar cada uno
Grok 4.3 vs GPT-5: benchmarks, precios y cuándo enrutar cada uno es una cuestión de enrutamiento de modelos heredados en octubre de 2026. OpenAI ha programado la eliminación del ID de modelo gpt-5 y de la instantánea gpt-5-2025-08-07 para el 11 de diciembre de 2026. Su tabla de migración apunta a gpt-5.6-sol, mientras que la guía actual sobre modelos recomienda GPT-6 Astra para una nueva carga de trabajo compleja de razonamiento o programación. Las notas de lanzamiento de xAI ahora enumeran Grok 4.7 como la ruta Grok de frontera actual. Aun así, muchos equipos necesitan comparar Grok 4.3 y GPT-5 porque los agentes, paneles, benchmarks y notas de compras más antiguos se crearon en torno a esos nombres.
La respuesta breve: use primero Grok 4.3 cuando una carga de trabajo se beneficie de su menor precio de salida publicado, mayor ventana de contexto documentada y controles de razonamiento compatibles con xAI. Use primero GPT-5 cuando su aplicación dependa del comportamiento nativo de la Responses API de OpenAI, herramientas alojadas, almacenamiento en caché de prompts, compatibilidad con Chat Completions o una base de evaluación existente de OpenAI. Use un enrutador cuando el problema real no sea solo la calidad del modelo, sino cambiar de modelos sin distribuir claves, facturas, registros y código de respaldo entre todos los servicios.
No tome esta decisión basándose únicamente en etiquetas de benchmarks públicos. Compare los modelos en su carga de trabajo y, después, enrute según el costo por salida aceptada.
Comparación rápida: Grok 4.3 vs GPT-5
| Área de decisión | Grok 4.3 | GPT-5 | Nota de enrutamiento |
|---|---|---|---|
| Estado de actualidad | Ruta Grok anterior; las notas de lanzamiento de xAI ahora destacan Grok 4.7 como la versión actual. | Obsoleto; OpenAI programa la eliminación de gpt-5 y gpt-5-2025-08-07 para el 11 de diciembre de 2026. |
Trate ambos como rutas heredadas; planifique la migración de GPT-5 antes de su fecha de eliminación. |
| ID de modelo | grok-4.3, alias grok-4.3-latest. |
gpt-5, instantánea predeterminada gpt-5-2025-08-07. |
Fije el ID de modelo exacto o la instantánea para realizar pruebas repetibles. |
| Entrada y salida | Entrada de texto e imagen; salida de texto. | Entrada de texto e imagen; salida de texto. | Ambos pueden adaptarse a flujos de trabajo de texto asistidos por visión; ninguno es una ruta de vídeo. |
| Contexto | xAI enumera una ventana de contexto de 1M, con precios de contexto largo por encima de 200k tokens de prompt. | OpenAI enumera una ventana de contexto de 400k, un máximo de 272k tokens de entrada y un máximo de 128k tokens de salida. | Pruebe el contexto utilizable, no solo la cifra principal del contexto. |
| Precio de texto publicado | $1.25 / $0.20 en caché / $2.50 de salida por 1M tokens por debajo de 200k tokens de prompt; $2.50 / $0.40 / $5.00 con 200k+ tokens de prompt. | $1.25 / $0.125 en caché / $10 de salida por 1M tokens. | Grok 4.3 es más barato en el precio de salida publicado; GPT-5 tiene una entrada en caché más barata. |
| Procesamiento por lotes | xAI marca Grok 4.3 como habilitado para procesamiento por lotes con un descuento del 20%. | OpenAI marca GPT-5 Batch como compatible. | El procesamiento por lotes solo ayuda cuando es aceptable una respuesta retrasada. |
| Herramientas | La documentación de xAI enumera llamadas a funciones, salidas estructuradas, razonamiento y opciones de esfuerzo de razonamiento. | La documentación de OpenAI enumera streaming, salidas estructuradas, llamadas a funciones, búsqueda de archivos, entrada de imágenes, búsqueda web, almacenamiento en caché de prompts y herramientas compatibles con la Responses API. | GPT-5 suele ser más sólido cuando las herramientas alojadas por OpenAI forman parte del requisito. |
Ese es el punto de partida práctico de benchmark para Grok 4.3 vs GPT-5: benchmarks, precios y cuándo enrutar cada uno. Las especificaciones públicas sugieren diferentes estructuras de costo y contexto, pero el ganador en producción es la ruta que supera su validador al menor costo por salida aceptada.
Evalúe la ruta, no el nombre del modelo
Las clasificaciones públicas de modelos son útiles para descubrir opciones, pero rara vez responden a la pregunta de producción. Una puntuación de benchmark no le indica si una ruta preserva su esquema exacto, se recupera de límites de tasa, registra el uso en el lugar correcto o se mantiene dentro del presupuesto después de los reintentos.
Prepare un pequeño paquete de benchmarks antes de mover tráfico:
| Pista de benchmark | Qué probar | Por qué cambia la ruta |
|---|---|---|
| Razonamiento y programación | 50-200 prompts reales de flujos de trabajo de agentes, programación, análisis o soporte. | Una victoria en un benchmark general puede no trasladarse a la forma de sus prompts. |
| Salida estructurada | Esquema JSON requerido, campos enum, objetos anidados y casos de entrada no válida. | El modelo que redacta mejor prosa aún puede fallar su analizador. |
| Llamadas a herramientas | Casos de herramienta requerida, sin herramienta, herramienta incorrecta y error de herramienta. | Una mala acción puede costar más que un precio de token superior. |
| Contexto largo | Paquetes de recuperación p50, p90 y del peor caso. | Una ventana de contexto grande no equivale a una recuperación fiable. |
| Costo | Tokens de entrada, tokens en caché, tokens de salida, modo por lotes, reintentos y salidas rechazadas. | El precio de token publicado está incompleto sin la tasa de aceptación. |
| Latencia | Tiempo hasta el primer token, latencia de respuesta completa, tasa de tiempos de espera y comportamiento de las colas. | Los agentes orientados al usuario pueden necesitar una ruta más rápida incluso si cuesta más. |
| Respaldo | Errores del proveedor, 429, modelo no encontrado, fallo de esquema, tiempo de espera y salida degradada. |
Una ruta sin una regla de reversión no está lista para producción. |
La métrica de la ruta debe ser:
cost_per_accepted_output =
  (input_cost + cached_input_cost + output_cost + tool_cost + retry_cost + fallback_cost)
  / accepted_outputs
Use Grok 4.3 cuando resulte ganador en esa fórmula para una carga de trabajo con suficiente margen de calidad y latencia. Use GPT-5 cuando el comportamiento nativo de OpenAI reduzca lo suficiente el riesgo de implementación, los fallos de validación o el coste de integración como para compensar su precio de salida indicado.
Precios: dónde Grok 4.3 es más barato y dónde GPT-5 aún puede ganar
Para solicitudes de texto con contexto corto, xAI indica para Grok 4.3 $1.25 de entrada, $0.20 de entrada en caché y $2.50 de salida por cada 1M de tokens. Con 200k o más tokens de prompt, xAI indica precios superiores para contexto largo: $2.50 de entrada, $0.40 de entrada en caché y $5.00 de salida por cada 1M de tokens. xAI también marca Grok 4.3 como compatible con procesamiento por lotes, con un descuento del 20% por lotes.
OpenAI indica para GPT-5 $1.25 de entrada, $0.125 de entrada en caché y $10 de salida por cada 1M de tokens. Esto hace que GPT-5 sea más caro en tokens de salida según el precio indicado, pero más barato en entrada en caché que la tarifa de entrada en caché de contexto corto de Grok 4.3.
La decisión de precio cambia según la forma de la carga de trabajo:
| Forma de la carga de trabajo | Presión de precio | Primera prueba probable |
|---|---|---|
| Prompt corto, respuesta generada larga | El precio de salida predomina. | Pruebe primero Grok 4.3 y, después, compare la tasa de aceptación de salida. |
| Prompt de sistema grande repetido o paquete de políticas | La entrada en caché importa. | Pruebe ambos; la entrada en caché de GPT-5 puede importar si la tasa de aciertos de caché es alta. |
| Paquete de recuperación largo con más de 200k tokens de prompt | Se aplican precios de contexto largo. | Pruebe Grok 4.3 incluyendo el precio de contexto largo y la latencia. |
| Herramientas alojadas por OpenAI o flujo de trabajo de Responses API | Importan el comportamiento de las herramientas y la integración. | Pruebe primero GPT-5 porque la compatibilidad directa con funciones puede reducir la complejidad de la aplicación. |
| Evaluaciones sin conexión o rellenados históricos | Importa la economía de los lotes. | Pruebe ambas rutas por lotes si se acepta una finalización diferida. |
Si solo compara el precio de entrada indicado, Grok 4.3 vs GPT-5: Benchmarks, Pricing, and When to Route Each se convierte en un ejercicio engañoso de hoja de cálculo. La longitud de salida, la tasa de reintentos, los fallos de herramientas y la revisión humana pueden eliminar el ahorro aparente.
Cuándo enrutar a Grok 4.3
Comience con Grok 4.3 cuando la carga de trabajo sea sensible al coste, intensiva en salida y no esté vinculada a herramientas nativas de OpenAI.
Entre los buenos candidatos se incluyen:
- Tareas de análisis interno en las que la salida de texto es larga y la validación es sencilla.
- Resúmenes de contexto largo en los que la ventana de contexto documentada de 1M resulta útil y el precio de contexto largo sigue superando a las alternativas.
- Trabajos de evaluación en los que se aceptan lotes y se aplica un descuento por lotes del 20%.
- Flujos de trabajo que usan llamadas a funciones o salidas estructuradas, pero no requieren herramientas alojadas por OpenAI.
- Experimentos de modelos en los que desea una ruta de la familia Grok para compararla con GPT, Claude, Gemini, DeepSeek o Qwen.
Antes del lanzamiento, verifique la ruta exacta de Grok en la consola del proveedor o el catálogo del gateway. xAI tiene rutas de Grok más recientes, y el conocimiento local actual de Flatkey confirma grok-4.2 en lugar de grok-4.3, así que no suponga que Grok 4.3 está disponible a través de un gateway hasta que el catálogo en vivo lo indique.
Cuándo enrutar a GPT-5
Comience con GPT-5 cuando la carga de trabajo dependa de la superficie de API de OpenAI o cuando su historial de evaluación ya use GPT-5 como referencia.
Entre los buenos candidatos se incluyen:
- Aplicaciones existentes de OpenAI Chat Completions o Responses API que no deberían reescribirse para un experimento de modelo.
- Cargas de trabajo que usan herramientas alojadas por OpenAI, como búsqueda web, búsqueda de archivos, generación de imágenes, intérprete de código o MCP a través de Responses API.
- Productos que dependen del almacenamiento en caché de prompts de OpenAI, salidas estructuradas, streaming o controles de proyecto específicos de OpenAI.
- Pruebas de regresión en las que las instantáneas previas de GPT-5 forman parte de la referencia de aceptación.
- Auditorías de migración en las que GPT-5 es la ruta de referencia estable antes de pasar a un modelo más nuevo.
Nota con fecha límite: OpenAI tiene programada la retirada de gpt-5 y gpt-5-2025-08-07 el 11 de diciembre de 2026. Use esta comparación para validar migraciones, no como opción predeterminada para una nueva implementación. El destino de migración documentado es gpt-5.6-sol; la guía actual de modelos de OpenAI recomienda GPT-6 Astra para una nueva carga de trabajo compleja de razonamiento o programación.
OpenAI documenta GPT-5 como un modelo anterior. Si está iniciando un proyecto nuevo, compare también el modelo actualmente recomendado por OpenAI. GPT-5 aún puede ser útil cuando la cuestión es una ruta heredada fijada, pero no debe tratarse como la respuesta predeterminada para una nueva implementación sin una revisión actual de modelos.
Cuándo un router es la mejor opción
Los equipos suelen preguntar si Grok 4.3 o GPT-5 es mejor, pero el verdadero cuello de botella es la dispersión operativa:
- Claves de proveedor independientes.
- Paneles e facturas independientes.
- Políticas de límite de tasa independientes.
- Comprobaciones de estado independientes.
- Exportaciones de uso independientes.
- Diferentes ID de modelo codificados de forma rígida en agentes y servicios.
- Ninguna regla de respaldo compartida cuando un proveedor se degrada.
El posicionamiento de Flatkey está diseñado para esa capa: una clave, un saldo, una factura, acceso oficial a los modelos, registros de uso y un router compatible con OpenAI. Eso no significa que todas las funciones nativas de cada proveedor funcionen automáticamente a través de todas las rutas. Significa que el equipo obtiene una única superficie operativa para comparar modelos compatibles y revisar evidencias de uso.
Combine este artículo con la guía del catálogo de modelos de IA, el marco de métricas de la API de enrutamiento de IA y la guía de inicio rápido de la API de Flatkey antes de cambiar el tráfico de producción.
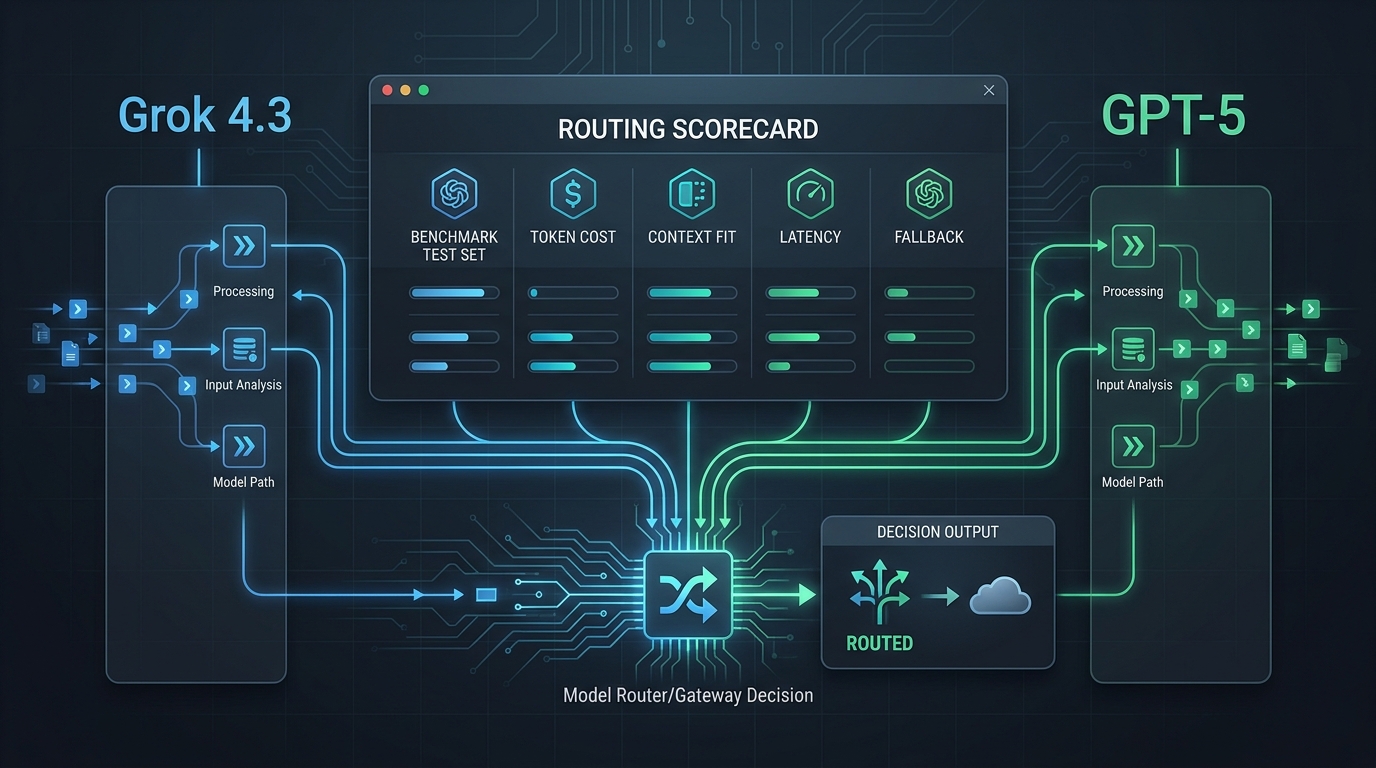
Una tarjeta de puntuación práctica para el enrutamiento
Use esta tarjeta de puntuación para Grok 4.3 vs GPT-5: benchmarks, precios y cuándo enrutar cada uno. Puntúe cada ruta del 1 al 5 para la misma carga de trabajo.
| Criterio | Peso | Grok 4.3 | GPT-5 | Notas |
|---|---|---|---|---|
| Tasa de resultados aceptados | 25% | ¿La respuesta supera su validador o rúbrica de revisión? | ||
| Coste por resultado aceptado | 20% | Incluya el tamaño del prompt, la longitud de la salida, la caché, el procesamiento por lotes, las herramientas, los reintentos y las salidas rechazadas. | ||
| Fiabilidad de herramientas y esquemas | 15% | Cuente JSON no válido, llamadas a herramientas incorrectas, campos ausentes y parámetros no compatibles. | ||
| Fiabilidad del contexto | 15% | Pruebe paquetes de recuperación p50, p90 y de peor caso. | ||
| Latencia y tiempos de espera | 10% | Mida TTFT, el tiempo de finalización completo y la tasa de tiempos de espera. | ||
| Observabilidad | 10% | ¿Pueden ingeniería y finanzas inspeccionar el proveedor, el modelo, los tokens, el coste, la latencia y los errores? | ||
| Preparación para contingencias | 5% | ¿Se ha probado y documentado la reversión? |
A continuación, redacte un registro de ruta:
route_review:
  workload: support_case_summarization
  candidates:
    - grok-4.3
    - gpt-5
  required_features:
    - structured_output
    - streaming
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
  stop_conditions:
    - schema_failure_rate_above_threshold
    - timeout_rate_above_threshold
    - cost_per_accepted_output_above_budget
Esa política es más útil que una captura de pantalla de una clasificación porque le indica a su aplicación qué hacer cuando un modelo no está disponible, es demasiado lento, demasiado caro o no es adecuado para la tarea.
Lista de comprobación previa antes de mover tráfico
Realice estas comprobaciones antes de enrutar usuarios reales a cualquiera de los modelos:
- Confirme la disponibilidad del modelo. Compruebe la consola del proveedor directo y cualquier catálogo de pasarela el mismo día del lanzamiento.
- Fije los ID de modelo. Use
grok-4.3deliberadamente. Para el tráfico existente de GPT-5, fijegpt-5-2025-08-07solo mientras completa una migración validada; tanto este comogpt-5están programados para su retirada el 11 de diciembre de 2026. - Verifique la familia de endpoints. Confirme si la carga de trabajo usa rutas compatibles con xAI, OpenAI Chat Completions, OpenAI Responses, procesamiento por lotes o endpoints de pasarela.
- Pruebe las funciones necesarias. Las herramientas, las salidas estructuradas, la entrada de imágenes, el streaming, el almacenamiento en caché y el procesamiento por lotes deben probarse solo si su carga de trabajo realmente los necesita.
- Mida el contexto utilizable. Compruebe la recuperación y la disciplina de citación con tamaños de contexto realistas.
- Calcule el coste por salida aceptada. Incluya reintentos, salidas rechazadas y revisión humana.
- Registre cada ruta. Registre el proveedor, el modelo, el ID de solicitud, los tokens de entrada, los tokens de salida, los tokens de caché, la latencia, el estado y el coste.
- Defina la contingencia. Decida cuándo reintentar, cambiar de ruta, poner en cola, degradar la salida o fallar de forma cerrada.
- Asigne responsabilidades. Asigne a alguien la responsabilidad de las claves, el presupuesto, la cuota, el estado de las rutas y la reversión.
- Vuelva a ejecutar tras cambios de modelo. Las nuevas versiones de Grok o GPT pueden dejar obsoleta rápidamente esta comparación.
Preguntas frecuentes: variantes de GPT-5.4 y GPT-5.5
¿Qué cambia cuando la comparación es Grok 4.3 vs GPT-5.4 o GPT-5.5?
No sustituya gpt-5.4 o gpt-5.5 en la columna de GPT-5 y suponga que los resultados serán los mismos. Cada versión de modelo tiene su propia disponibilidad, precio, límites de contexto y estado de migración. Si está migrando una carga de trabajo existente de GPT-5, use esta comparación para diseñar la evaluación y, a continuación, compare Grok 4.3 con el reemplazo exacto compatible de OpenAI usando sus propios prompts. Para una implementación nueva, comience por la guía actual de modelos de OpenAI en lugar del ID de modelo GPT-5 obsoleto.
Fuentes que conviene mantener abiertas
Use la documentación en vivo al finalizar una ruta:
- Documentación del modelo GPT-5 de OpenAI para el estado, la instantánea, el contexto, los endpoints, las funciones y el resumen de precios de GPT-5.
- Precios de la API de OpenAI para las filas actuales de precios por token de texto y las advertencias sobre regiones/modo rápido.
- Modelos y precios de xAI para el contexto, los precios, el procesamiento por lotes, las modalidades y los controles de razonamiento de Grok 4.3.
- Notas de lanzamiento de xAI para conocer la actualidad de los modelos Grok.
- Clasificación de modelos de Artificial Analysis para métricas de descubrimiento de modelos de terceros, no como sustituto de sus propios benchmarks de rutas.
Conclusión
Para Grok 4.3 vs GPT-5: benchmarks, precios y cuándo enrutar cada uno, Grok 4.3 suele ser la primera prueba de precios cuando predominan los tokens de salida y no se requieren herramientas nativas de OpenAI. GPT-5 suele ser la primera prueba de integración cuando tu aplicación depende de la Responses API de OpenAI, herramientas alojadas, caché de prompts o una línea base existente de GPT-5.
Para producción, mantén ambas decisiones separadas: primero elige el modelo que supere tu carga de trabajo y luego la ruta que te proporcione registros, control de costes, respaldo y una vía clara de reversión. Ahí es donde un enrutador unificado se gana su lugar.
Si Gemini también está en tu lista, lee Grok vs Gemini (octubre de 2026) para comparar los precios de suscripción y de API.