Grok 4.3 vs GPT-5 : benchmarks, tarifs et routage
Grok 4.3 vs GPT-5 : benchmarks, tarifs et routage est une question de routage de modèles hérités en octobre 2026. OpenAI a programmé la suppression de l’ID de modèle gpt-5 et du snapshot gpt-5-2025-08-07 le 11 décembre 2026. Son tableau de migration indique gpt-5.6-sol, tandis que les recommandations actuelles sur les modèles préconisent GPT-6 Astra pour une nouvelle charge de travail complexe de raisonnement ou de code. Les notes de version de xAI répertorient désormais Grok 4.7 comme la route Grok de pointe actuelle. Néanmoins, de nombreuses équipes doivent comparer Grok 4.3 et GPT-5, car d’anciens agents, tableaux de bord, benchmarks et notes d’approvisionnement ont été conçus autour de ces noms.
La réponse courte : utilisez d’abord Grok 4.3 lorsqu’une charge de travail bénéficie de son prix de sortie affiché inférieur, de sa fenêtre de contexte documentée plus grande et de contrôles de raisonnement compatibles avec xAI. Utilisez d’abord GPT-5 lorsque votre application dépend du comportement natif de l’API Responses d’OpenAI, des outils hébergés, du cache de prompts, de la compatibilité avec Chat Completions ou d’une base d’évaluation OpenAI existante. Utilisez un routeur lorsque le véritable problème n’est pas uniquement la qualité du modèle, mais le changement de modèle sans répartir les clés, les factures, les journaux et le code de repli entre tous les services.
Ne prenez pas cette décision à partir des seuls libellés de benchmarks publics. Comparez les modèles sur votre charge de travail, puis acheminez les requêtes selon le coût par sortie acceptée.
Comparaison rapide : Grok 4.3 vs GPT-5
| Domaine de décision | Grok 4.3 | GPT-5 | Note de routage |
|---|---|---|---|
| Statut d’actualité | Ancienne route Grok ; les notes de version de xAI mettent désormais Grok 4.7 en avant comme version actuelle. | Obsolète ; OpenAI prévoit de supprimer gpt-5 et gpt-5-2025-08-07 le 11 décembre 2026. |
Considérez les deux comme des routes héritées ; planifiez la migration de GPT-5 avant sa date de suppression. |
| ID du modèle | grok-4.3, alias grok-4.3-latest. |
gpt-5, snapshot par défaut gpt-5-2025-08-07. |
Épinglez l’ID exact du modèle ou le snapshot afin d’obtenir des tests reproductibles. |
| Entrée et sortie | Entrée texte et image ; sortie texte. | Entrée texte et image ; sortie texte. | Les deux conviennent aux flux de travail textuels assistés par vision ; aucun n’est une route vidéo. |
| Contexte | xAI indique une fenêtre de contexte de 1 M, avec une tarification long contexte au-delà de 200 k tokens de prompt. | OpenAI indique une fenêtre de contexte de 400 k, un maximum de 272 k tokens d’entrée et de 128 k tokens de sortie. | Testez le contexte réellement exploitable, pas seulement le nombre de contexte affiché en titre. |
| Prix texte affiché | 1,25 $ / 0,20 $ en cache / 2,50 $ en sortie par 1 M de tokens en dessous de 200 k tokens de prompt ; 2,50 $ / 0,40 $ / 5,00 $ à partir de 200 k tokens de prompt. | 1,25 $ / 0,125 $ en cache / 10 $ en sortie par 1 M de tokens. | Grok 4.3 est moins cher au prix de sortie affiché ; GPT-5 offre une entrée mise en cache moins chère. |
| Traitement par lots | xAI indique que Grok 4.3 prend en charge le traitement par lots avec une remise de 20 %. | OpenAI indique que GPT-5 Batch est pris en charge. | Le traitement par lots n’aide que lorsqu’une réponse différée est acceptable. |
| Outils | La documentation xAI répertorie les appels de fonctions, les sorties structurées, le raisonnement et les options d’effort de raisonnement. | La documentation OpenAI répertorie le streaming, les sorties structurées, les appels de fonctions, la recherche de fichiers, l’entrée image, la recherche web, le cache de prompts et les outils pris en charge par l’API Responses. | GPT-5 est généralement plus adapté lorsque les outils hébergés par OpenAI font partie des exigences. |
C’est le point de départ pratique des benchmarks pour Grok 4.3 vs GPT-5 : benchmarks, tarifs et routage. Les spécifications publiques suggèrent des profils de coût et de contexte différents, mais le gagnant en production est la route qui passe votre validateur au coût le plus faible par sortie acceptée.
Évaluez la route, pas le nom du modèle
Les classements publics de modèles sont utiles pour la découverte, mais ils répondent rarement à la question de production. Un score de benchmark ne vous indique pas si une route préserve votre schéma exact, se remet de limites de débit, enregistre l’utilisation au bon endroit ou respecte le budget après les nouvelles tentatives.
Constituez un petit ensemble de benchmarks avant de déplacer du trafic :
| Volet de benchmark | Éléments à tester | Pourquoi cela modifie la route |
|---|---|---|
| Raisonnement et code | 50 à 200 prompts réels issus de flux de travail d’agents, de code, d’analyse ou de support. | Une victoire dans un benchmark général peut ne pas se transférer à la forme de vos prompts. |
| Sortie structurée | Schéma JSON requis, champs enum, objets imbriqués et cas d’entrée invalide. | Le modèle qui produit la meilleure prose peut tout de même faire échouer votre analyseur. |
| Appels d’outils | Cas d’outil requis, sans outil, mauvais outil et erreur d’outil. | Une mauvaise action peut coûter plus cher qu’un prix par token plus élevé. |
| Contexte long | Ensembles de récupération p50, p90 et pire cas. | Une grande fenêtre de contexte n’est pas synonyme de rappel fiable. |
| Coût | Tokens d’entrée, tokens mis en cache, tokens de sortie, mode batch, nouvelles tentatives et sorties rejetées. | Le prix affiché par token est incomplet sans le taux d’acceptation. |
| Latence | Délai jusqu’au premier token, latence de réponse complète, taux de timeout et comportement de mise en file d’attente. | Les agents destinés aux utilisateurs peuvent nécessiter une route plus rapide même si elle coûte plus cher. |
| Repli | Erreurs de fournisseur, 429, modèle introuvable, échec de schéma, timeout et sortie dégradée. |
Une route sans règle de retour en arrière n’est pas prête pour la production. |
La métrique de route devrait être :
cost_per_accepted_output =
  (input_cost + cached_input_cost + output_cost + tool_cost + retry_cost + fallback_cost)
  / accepted_outputs
Utilisez Grok 4.3 lorsqu'il est gagnant selon cette formule pour une charge de travail disposant d'une marge suffisante en matière de qualité et de latence. Utilisez GPT-5 lorsque le comportement natif d'OpenAI réduit suffisamment le risque d'implémentation, les échecs de validation ou le coût d'intégration pour compenser son prix de sortie affiché.
Tarification : où Grok 4.3 est moins cher et où GPT-5 peut encore l'emporter
Pour les requêtes textuelles à contexte court, xAI affiche Grok 4.3 à 1,25 $ pour l'entrée, 0,20 $ pour l'entrée mise en cache et 2,50 $ pour la sortie par million de tokens. À partir de 200 k tokens de prompt, xAI affiche une tarification de contexte long plus élevée : 2,50 $ pour l'entrée, 0,40 $ pour l'entrée mise en cache et 5,00 $ pour la sortie par million de tokens. xAI indique également que Grok 4.3 prend en charge le traitement par lots avec une remise de 20 %.
OpenAI affiche GPT-5 à 1,25 $ pour l'entrée, 0,125 $ pour l'entrée mise en cache et 10 $ pour la sortie par million de tokens. GPT-5 est donc plus cher pour les tokens de sortie affichés, mais moins cher pour l'entrée mise en cache que le tarif d'entrée mise en cache à contexte court de Grok 4.3.
La décision tarifaire varie selon la forme de la charge de travail :
| Forme de la charge de travail | Pression sur le prix | Premier test probable |
|---|---|---|
| Prompt court, longue réponse générée | Le prix de sortie domine. | Testez d'abord Grok 4.3, puis comparez le taux d'acceptation des sorties. |
| Grand prompt système ou pack de politiques répété | L'entrée mise en cache compte. | Testez les deux ; l'entrée mise en cache de GPT-5 peut compter si le taux de cache est élevé. |
| Grand pack de récupération dépassant 200 k tokens de prompt | La tarification de contexte long s'applique. | Testez Grok 4.3 en incluant le prix de contexte long et la latence. |
| Outils hébergés par OpenAI ou workflow Responses API | Le comportement des outils et de l'intégration compte. | Testez d'abord GPT-5, car la prise en charge directe des fonctionnalités peut réduire la complexité de l'application. |
| Évaluations hors ligne ou remises à jour de données | L'économie du traitement par lots compte. | Testez les deux parcours par lots si une exécution différée est acceptable. |
Si vous comparez uniquement le prix d'entrée affiché, Grok 4.3 vs GPT-5 : benchmarks, tarifs et routage devient un exercice de tableur trompeur. La longueur des sorties, le taux de nouvelles tentatives, les échecs d'outils et la révision humaine peuvent effacer les économies apparentes.
Quand router vers Grok 4.3
Commencez avec Grok 4.3 lorsque la charge de travail est sensible aux coûts, génère beaucoup de sorties et n'est pas liée aux outils natifs d'OpenAI.
Les bons candidats incluent :
- Les tâches d'analyse internes où la sortie textuelle est longue et la validation est simple.
- La synthèse à contexte long, lorsque la fenêtre de contexte documentée de 1 M est utile et que le prix du contexte long reste plus avantageux que les alternatives.
- Les tâches d'évaluation où le traitement par lots est acceptable et où une remise de 20 % s'applique.
- Les workflows utilisant l'appel de fonctions ou les sorties structurées, mais ne nécessitant pas d'outils hébergés par OpenAI.
- Les expérimentations de modèles pour lesquelles vous souhaitez une route de la famille Grok à comparer à GPT, Claude, Gemini, DeepSeek ou Qwen.
Avant le lancement, vérifiez la route Grok exacte dans la console du fournisseur ou le catalogue de la passerelle. xAI propose des routes Grok plus récentes, et les connaissances locales actuelles de Flatkey confirment grok-4.2 plutôt que grok-4.3 ; ne supposez donc pas que Grok 4.3 est disponible via une passerelle tant que le catalogue en direct ne l'indique pas.
Quand router vers GPT-5
Commencez avec GPT-5 lorsque la charge de travail dépend de la surface d'API d'OpenAI ou lorsque votre historique d'évaluation utilise déjà GPT-5 comme référence.
Les bons candidats incluent :
- Les applications existantes OpenAI Chat Completions ou Responses API qui ne doivent pas être réécrites pour une expérimentation de modèle.
- Les charges de travail utilisant des outils hébergés par OpenAI tels que la recherche web, la recherche de fichiers, la génération d'images, l'interpréteur de code ou MCP via la Responses API.
- Les produits reposant sur la mise en cache des prompts d'OpenAI, les sorties structurées, le streaming ou les contrôles de projet spécifiques à OpenAI.
- Les tests de régression où des snapshots GPT-5 antérieurs font partie de la référence d'acceptation.
- Les audits de migration où GPT-5 est la route de référence stable avant le passage à un modèle plus récent.
Note limitée dans le temps : OpenAI prévoit de retirer gpt-5 et gpt-5-2025-08-07 le 11 décembre 2026. Utilisez cette comparaison pour la validation de migration, et non comme choix par défaut pour un nouveau déploiement. La cible de migration documentée est gpt-5.6-sol ; les recommandations actuelles d'OpenAI concernant les modèles préconisent GPT-6 Astra pour une nouvelle charge de travail complexe de raisonnement ou de programmation.
OpenAI documente GPT-5 comme un modèle précédent. Si vous démarrez un nouveau projet, comparez également le modèle actuellement recommandé par OpenAI. GPT-5 peut encore être utile lorsqu'une route héritée épinglée est en question, mais il ne doit pas être considéré comme la réponse par défaut pour une nouvelle implémentation sans examen des modèles actuels.
Quand un routeur est la meilleure solution
Les équipes demandent souvent si Grok 4.3 ou GPT-5 est meilleur, mais le véritable goulot d'étranglement est la dispersion opérationnelle :
- Des clés fournisseur distinctes.
- Des tableaux de bord et factures distincts.
- Des politiques de limitation de débit distinctes.
- Des vérifications d'état distinctes.
- Des exports d'utilisation distincts.
- Des identifiants de modèle différents codés en dur dans les agents et les services.
- Aucune règle de repli partagée lorsqu'un fournisseur se dégrade.
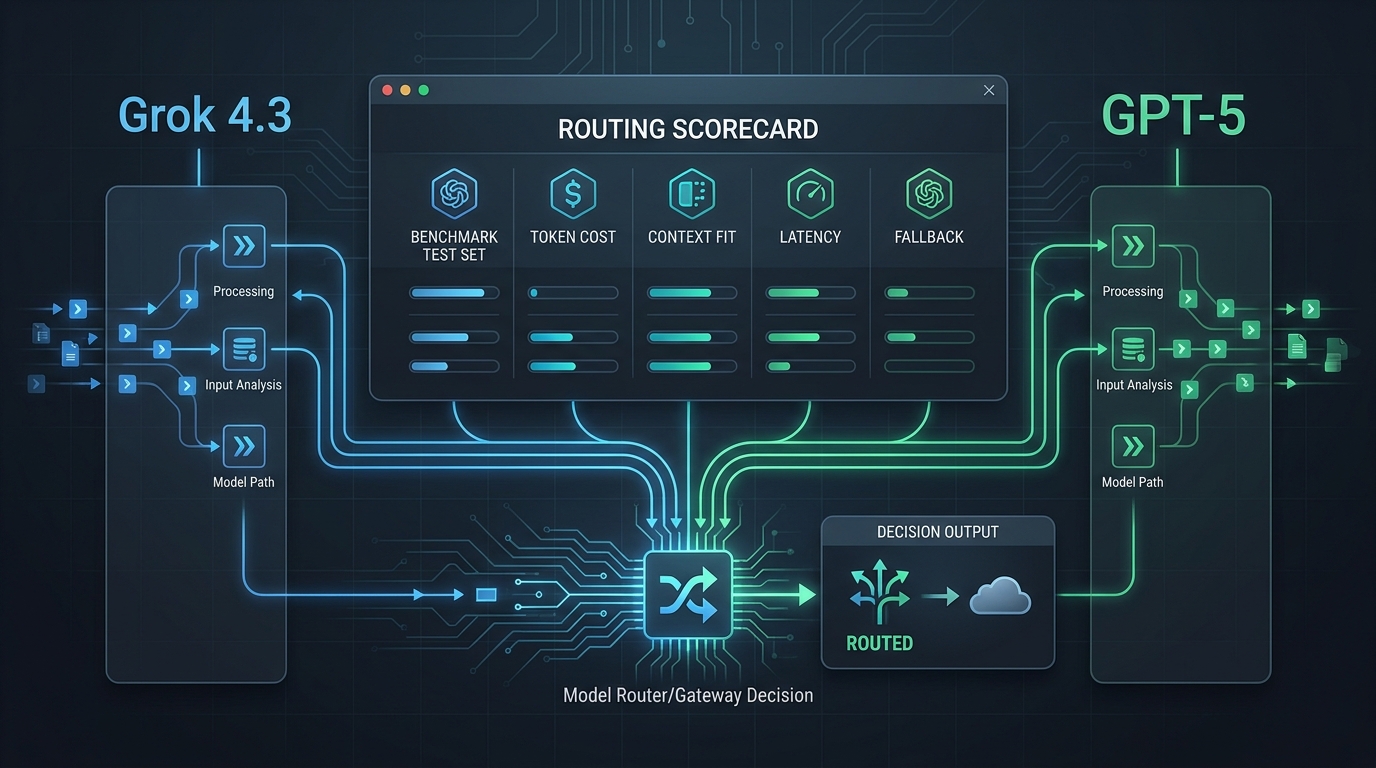
Le positionnement de Flatkey est conçu pour cette couche : une clé, un solde, une facture, un accès officiel aux modèles, des journaux d'utilisation et un routeur compatible avec OpenAI. Cela ne signifie pas que chaque fonctionnalité native d'un fournisseur fonctionne automatiquement via chaque route. Cela signifie que l'équipe dispose d'une surface d'exploitation unique pour comparer les modèles pris en charge et examiner les preuves d'utilisation.
Associez cet article au guide du catalogue de modèles IA, au cadre des métriques d’API de routage IA et au guide de démarrage rapide de l’API Flatkey avant de modifier le trafic de production.
Une grille d’évaluation pratique du routage
Utilisez cette grille pour Grok 4.3 vs GPT-5 : benchmarks, tarifs et routage. Évaluez chaque route de 1 à 5 pour la même charge de travail.
| Critère | Poids | Grok 4.3 | GPT-5 | Notes |
|---|---|---|---|---|
| Taux de sorties acceptées | 25 % | La réponse réussit-elle votre validateur ou votre grille de revue ? | ||
| Coût par sortie acceptée | 20 % | Incluez la taille du prompt, la longueur de sortie, le cache, le traitement par lots, les outils, les nouvelles tentatives et les sorties rejetées. | ||
| Fiabilité des outils et des schémas | 15 % | Comptez les JSON non valides, les appels d’outils erronés, les champs manquants et les paramètres non pris en charge. | ||
| Fiabilité du contexte | 15 % | Testez les ensembles de récupération p50, p90 et les pires cas. | ||
| Latence et délais d’expiration | 10 % | Mesurez le TTFT, le temps de complétion total et le taux de délais d’expiration. | ||
| Observabilité | 10 % | Les équipes d’ingénierie et de finance peuvent-elles examiner le fournisseur, le modèle, les tokens, le coût, la latence et les erreurs ? | ||
| Préparation du repli | 5 % | Le retour en arrière est-il testé et documenté ? |
Rédigez ensuite un enregistrement de route :
route_review:
  workload: support_case_summarization
  candidates:
    - grok-4.3
    - gpt-5
  required_features:
    - structured_output
    - streaming
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
  stop_conditions:
    - schema_failure_rate_above_threshold
    - timeout_rate_above_threshold
    - cost_per_accepted_output_above_budget
Cette politique est plus utile qu’une capture d’écran d’un classement, car elle indique à votre application quoi faire lorsqu’un modèle est indisponible, trop lent, trop coûteux ou inadapté à la tâche.
Liste de contrôle avant de déplacer le trafic
Effectuez ces vérifications avant de router de vrais utilisateurs vers l’un ou l’autre modèle :
- Confirmez la disponibilité du modèle. Vérifiez la console directe du fournisseur et tout catalogue de passerelle le jour même du lancement.
- Épinglez les ID de modèle. Utilisez
grok-4.3intentionnellement. Pour le trafic GPT-5 existant, épinglezgpt-5-2025-08-07uniquement pendant que vous terminez une migration validée ; ce modèle commegpt-5doivent être retirés le 11 décembre 2026. - Vérifiez la famille d’endpoint. Confirmez si la charge de travail utilise des routes compatibles xAI, OpenAI Chat Completions, OpenAI Responses, des endpoints de traitement par lots ou de passerelle.
- Testez les fonctionnalités requises. Les outils, les sorties structurées, l’entrée d’images, le streaming, le cache et le traitement par lots ne doivent être testés que si votre charge de travail en a réellement besoin.
- Mesurez le contexte utilisable. Vérifiez le rappel et la rigueur des citations avec des tailles de contexte réalistes.
- Calculez le coût par sortie acceptée. Incluez les nouvelles tentatives, les sorties rejetées et la revue humaine.
- Journalisez chaque route. Enregistrez le fournisseur, le modèle, l’ID de requête, les tokens d’entrée, les tokens de sortie, les tokens de cache, la latence, le statut et le coût.
- Définissez le repli. Décidez quand réessayer, changer de route, mettre en file d’attente, dégrader la sortie ou échouer de manière fermée.
- Attribuez un responsable. Confiez à une personne la responsabilité des clés, du budget, du quota, de l’état de santé des routes et du retour en arrière.
- Réexécutez après les changements de modèle. Les nouvelles versions de Grok ou GPT peuvent rapidement rendre cette comparaison obsolète.
FAQ : variantes GPT-5.4 et GPT-5.5
Que change une comparaison entre Grok 4.3 et GPT-5.4 ou GPT-5.5 ?
Ne remplacez pas gpt-5.4 ou gpt-5.5 dans la colonne GPT-5 en supposant obtenir les mêmes résultats. Chaque version de modèle a sa propre disponibilité, son propre prix, ses propres limites de contexte et son propre statut de migration. Si vous déplacez une charge de travail GPT-5 existante, utilisez cette comparaison pour concevoir l’évaluation, puis comparez Grok 4.3 avec le remplacement OpenAI exact pris en charge sur vos propres prompts. Pour une nouvelle implémentation, partez des recommandations actuelles d’OpenAI sur les modèles plutôt que de l’ID de modèle GPT-5 obsolète.
Sources à garder ouvertes
Utilisez la documentation en direct lors de la finalisation d’une route :
- Documentation du modèle OpenAI GPT-5 pour le statut, le snapshot, le contexte, les endpoints, les fonctionnalités et le résumé des tarifs de GPT-5.
- Tarification de l’API OpenAI pour les lignes tarifaires actuelles des tokens de texte et les réserves concernant les régions et le mode rapide.
- Modèles et tarifs xAI pour le contexte, la tarification, le traitement par lots, les modalités et les contrôles de raisonnement de Grok 4.3.
- Notes de version xAI pour connaître l’actualité des modèles Grok.
- Classement des modèles d’Artificial Analysis pour des métriques tierces de découverte de modèles, et non comme substitut à vos propres benchmarks de routage.
En résumé
Pour Grok 4.3 vs GPT-5 : benchmarks, tarifs et routage, Grok 4.3 est généralement le premier test tarifaire lorsque les tokens de sortie dominent et que les outils natifs d’OpenAI ne sont pas nécessaires. GPT-5 est généralement le premier test d’intégration lorsque votre application dépend de l’API Responses d’OpenAI, d’outils hébergés, de la mise en cache des prompts ou d’une référence GPT-5 existante.
En production, gardez les deux décisions séparées : choisissez d’abord le modèle qui répond aux exigences de votre charge de travail, puis choisissez la route qui vous offre des journaux, un contrôle des coûts, une solution de repli et un chemin de retour en arrière clair. C’est là qu’un routeur unifié trouve toute sa place.
Si Gemini figure également sur votre liste, consultez Grok vs Gemini (octobre 2026) pour comparer les tarifs des abonnements et des API.