Grok 4.3 vs GPT-5: Benchmark, Harga, dan Kapan Merutekan Masing-Masing
Grok 4.3 vs GPT-5: Benchmark, Harga, dan Kapan Merutekan Masing-Masing adalah pertanyaan perutean model lama pada Oktober 2026. OpenAI telah menjadwalkan ID model gpt-5 dan snapshot gpt-5-2025-08-07 untuk dihapus pada 11 Desember 2026. Tabel migrasinya mengarah ke gpt-5.6-sol, sementara panduan model saat ini merekomendasikan GPT-6 Astra untuk beban kerja penalaran atau pemrograman kompleks yang baru. Catatan rilis xAI kini mencantumkan Grok 4.7 sebagai rute Grok frontier saat ini. Namun, banyak tim masih perlu membandingkan Grok 4.3 dan GPT-5 karena agen, dasbor, benchmark, dan catatan pengadaan lama dibuat berdasarkan nama-nama tersebut.
Jawaban singkatnya: gunakan Grok 4.3 terlebih dahulu ketika beban kerja mendapat manfaat dari harga output yang tercantum lebih rendah, jendela konteks terdokumentasi yang lebih besar, dan kontrol penalaran yang kompatibel dengan xAI. Gunakan GPT-5 terlebih dahulu ketika aplikasi Anda bergantung pada perilaku Responses API native OpenAI, alat yang dihosting, caching prompt, kompatibilitas Chat Completions, atau baseline evaluasi OpenAI yang sudah ada. Gunakan router ketika masalah sebenarnya bukan hanya kualitas model, melainkan berpindah model tanpa menyebarkan kunci, faktur, log, dan kode fallback ke setiap layanan.
Jangan membuat keputusan ini hanya berdasarkan label benchmark publik. Bandingkan model pada beban kerja Anda, lalu rutekan berdasarkan biaya per output yang diterima.
Perbandingan singkat: Grok 4.3 vs GPT-5
| Area keputusan | Grok 4.3 | GPT-5 | Catatan perutean |
|---|---|---|---|
| Status kebaruan | Rute Grok yang lebih lama; catatan rilis xAI kini menyoroti Grok 4.7 sebagai versi saat ini. | Sudah tidak digunakan lagi; OpenAI menjadwalkan gpt-5 dan gpt-5-2025-08-07 untuk dihapus pada 11 Desember 2026. |
Perlakukan keduanya sebagai rute lama; rencanakan migrasi GPT-5 sebelum tanggal penghapusannya. |
| ID model | grok-4.3, alias grok-4.3-latest. |
gpt-5, snapshot default gpt-5-2025-08-07. |
Kunci ID model atau snapshot yang tepat untuk pengujian yang dapat diulang. |
| Input dan output | Input teks dan gambar; output teks. | Input teks dan gambar; output teks. | Keduanya dapat digunakan untuk alur kerja teks berbantuan visi; tidak ada yang merupakan rute video. |
| Konteks | xAI mencantumkan jendela konteks 1M, dengan harga konteks panjang di atas 200k token prompt. | OpenAI mencantumkan jendela konteks 400k, maksimum 272k token input, dan maksimum 128k token output. | Uji konteks yang dapat digunakan, bukan hanya angka konteks utama. |
| Harga teks yang tercantum | $1.25 / $0.20 cached / $2.50 output per 1M token di bawah 200k token prompt; $2.50 / $0.40 / $5.00 pada 200k+ token prompt. | $1.25 / $0.125 cached / $10 output per 1M token. | Grok 4.3 lebih murah dalam harga output yang tercantum; GPT-5 memiliki input cached yang lebih murah. |
| Batch | xAI menandai Grok 4.3 sebagai mendukung batch dengan diskon batch 20%. | OpenAI menandai GPT-5 Batch sebagai didukung. | Batch hanya membantu ketika respons yang tertunda dapat diterima. |
| Perkakas | Dokumen xAI mencantumkan function calling, structured outputs, reasoning, dan opsi reasoning-effort. | Dokumen OpenAI mencantumkan streaming, structured outputs, function calling, file search, image input, web search, prompt caching, dan alat Responses API yang didukung. | GPT-5 biasanya lebih unggul ketika alat yang dihosting OpenAI menjadi bagian dari persyaratan. |
Itulah titik awal benchmark praktis untuk Grok 4.3 vs GPT-5: Benchmark, Harga, dan Kapan Merutekan Masing-Masing. Spesifikasi publik menunjukkan bentuk biaya dan konteks yang berbeda, tetapi pemenang di produksi adalah rute yang lolos validator Anda dengan biaya output diterima terendah.
Benchmark rute, bukan nama model
Papan peringkat model publik berguna untuk penemuan, tetapi jarang menjawab pertanyaan produksi. Skor benchmark tidak memberi tahu Anda apakah suatu rute mempertahankan skema persis Anda, pulih dari batas laju, mencatat penggunaan di tempat yang tepat, atau tetap sesuai anggaran setelah percobaan ulang.
Buat paket benchmark kecil sebelum memindahkan trafik:
| Jalur benchmark | Apa yang diuji | Mengapa hal ini mengubah rute |
|---|---|---|
| Penalaran dan pemrograman | 50-200 prompt nyata dari alur kerja agen, pemrograman, analisis, atau dukungan. | Kemenangan benchmark umum mungkin tidak berlaku pada bentuk prompt Anda. |
| Output terstruktur | Skema JSON yang diperlukan, kolom enum, objek bertingkat, dan kasus input tidak valid. | Model yang menulis prosa lebih baik tetap dapat gagal pada parser Anda. |
| Panggilan alat | Kasus alat yang diperlukan, tanpa alat, alat yang salah, dan kesalahan alat. | Satu tindakan buruk dapat berbiaya lebih besar daripada harga token yang lebih tinggi. |
| Konteks panjang | Paket pengambilan p50, p90, dan kasus terburuk. | Jendela konteks besar tidak sama dengan recall yang andal. |
| Biaya | Token input, token cached, token output, mode batch, percobaan ulang, dan output yang ditolak. | Harga token yang tercantum tidak lengkap tanpa tingkat penerimaan. |
| Latensi | Waktu hingga token pertama, latensi respons penuh, tingkat timeout, dan perilaku antrean. | Agen yang berhadapan dengan pengguna mungkin memerlukan rute lebih cepat meskipun biayanya lebih tinggi. |
| Fallback | Kesalahan penyedia, 429, model-tidak-ditemukan, kegagalan skema, timeout, dan output yang menurun. |
Rute tanpa aturan rollback belum siap untuk produksi. |
Metrik rute seharusnya adalah:
cost_per_accepted_output =
  (input_cost + cached_input_cost + output_cost + tool_cost + retry_cost + fallback_cost)
  / accepted_outputs
Gunakan Grok 4.3 ketika model ini unggul dalam formula tersebut untuk beban kerja dengan ruang toleransi kualitas dan latensi yang memadai. Gunakan GPT-5 ketika perilaku native OpenAI cukup mengurangi risiko implementasi, kegagalan validasi, atau biaya integrasi untuk mengimbangi harga output yang tercantum.
Harga: di mana Grok 4.3 lebih murah dan di mana GPT-5 masih dapat unggul
Untuk permintaan teks dengan konteks singkat, xAI mencantumkan harga Grok 4.3 sebesar $1.25 untuk input, $0.20 untuk input yang di-cache, dan $2.50 untuk output per 1 juta token. Pada 200 ribu token prompt atau lebih, xAI mencantumkan harga konteks panjang yang lebih tinggi: $2.50 untuk input, $0.40 untuk input yang di-cache, dan $5.00 untuk output per 1 juta token. xAI juga menandai Grok 4.3 sebagai mendukung batch dengan diskon batch 20%.
OpenAI mencantumkan harga GPT-5 sebesar $1.25 untuk input, $0.125 untuk input yang di-cache, dan $10 untuk output per 1 juta token. Ini membuat GPT-5 lebih mahal untuk token output yang tercantum, tetapi lebih murah untuk input yang di-cache dibandingkan baris harga input yang di-cache untuk konteks singkat milik Grok 4.3.
Keputusan harga berubah sesuai bentuk beban kerja:
| Bentuk beban kerja | Tekanan harga | Pengujian awal yang kemungkinan dilakukan |
|---|---|---|
| Prompt singkat, jawaban yang dihasilkan panjang | Harga output mendominasi. | Uji Grok 4.3 terlebih dahulu, lalu bandingkan tingkat penerimaan output. |
| Prompt sistem besar atau paket kebijakan yang berulang | Input yang di-cache penting. | Uji keduanya; input yang di-cache pada GPT-5 dapat berpengaruh jika tingkat cache hit tinggi. |
| Paket retrieval panjang di atas 200 ribu token prompt | Harga konteks panjang berlaku. | Uji Grok 4.3 dengan harga konteks panjang dan latensi disertakan. |
| Alat yang dihosting OpenAI atau alur kerja Responses API | Perilaku alat dan integrasi penting. | Uji GPT-5 terlebih dahulu karena dukungan fitur langsung dapat mengurangi kompleksitas aplikasi. |
| Evaluasi offline atau backfill | Ekonomi batch penting. | Uji kedua jalur batch jika penyelesaian tertunda dapat diterima. |
Jika Anda hanya membandingkan harga input yang tercantum, Grok 4.3 vs GPT-5: Benchmark, Harga, dan Kapan Merutekan Masing-Masing menjadi latihan spreadsheet yang menyesatkan. Panjang output, tingkat percobaan ulang, kegagalan alat, dan tinjauan manusia dapat menghapus penghematan yang tampak.
Kapan merutekan ke Grok 4.3
Mulailah dengan Grok 4.3 ketika beban kerja sensitif terhadap biaya, banyak menghasilkan output, dan tidak terikat pada alat native OpenAI.
Kandidat yang baik meliputi:
- Tugas analisis internal dengan output teks panjang dan validasi yang mudah dilakukan.
- Perangkuman konteks panjang ketika jendela konteks terdokumentasi 1 juta token berguna dan harga konteks panjang tetap mengungguli alternatif.
- Pekerjaan evaluasi ketika batch dapat diterima dan diskon batch 20% berlaku.
- Alur kerja yang menggunakan pemanggilan fungsi atau output terstruktur, tetapi tidak memerlukan alat yang dihosting OpenAI.
- Eksperimen model ketika Anda menginginkan rute keluarga Grok untuk perbandingan dengan GPT, Claude, Gemini, DeepSeek, atau Qwen.
Sebelum peluncuran, verifikasikan rute Grok yang tepat di konsol penyedia atau katalog gateway. xAI memiliki rute Grok yang lebih baru, dan pengetahuan lokal Flatkey saat ini mengonfirmasi grok-4.2, bukan grok-4.3, jadi jangan mengasumsikan Grok 4.3 tersedia melalui gateway sampai katalog langsung menyatakannya.
Kapan merutekan ke GPT-5
Mulailah dengan GPT-5 ketika beban kerja bergantung pada permukaan API OpenAI atau ketika riwayat evaluasi Anda sudah menggunakan GPT-5 sebagai baseline.
Kandidat yang baik meliputi:
- Aplikasi OpenAI Chat Completions atau Responses API yang sudah ada dan tidak seharusnya ditulis ulang demi eksperimen model.
- Beban kerja yang menggunakan alat yang dihosting OpenAI seperti pencarian web, pencarian file, pembuatan gambar, code interpreter, atau MCP melalui Responses API.
- Produk yang mengandalkan prompt caching OpenAI, output terstruktur, streaming, atau kontrol proyek khusus OpenAI.
- Pengujian regresi ketika snapshot GPT-5 sebelumnya merupakan bagian dari baseline penerimaan.
- Audit migrasi ketika GPT-5 menjadi rute referensi yang stabil sebelum berpindah ke model yang lebih baru.
Catatan berbatas waktu: OpenAI menjadwalkan gpt-5 dan gpt-5-2025-08-07 untuk dihapus pada 11 Desember 2026. Gunakan perbandingan ini untuk validasi migrasi, bukan sebagai default deployment baru. Target migrasi yang terdokumentasi adalah gpt-5.6-sol; panduan model OpenAI saat ini merekomendasikan GPT-6 Astra untuk beban kerja penalaran atau pengodean kompleks yang baru.
OpenAI mendokumentasikan GPT-5 sebagai model sebelumnya. Jika Anda memulai proyek baru, bandingkan juga model yang saat ini direkomendasikan oleh OpenAI. GPT-5 masih dapat berguna ketika rute legacy yang dipatok adalah pertanyaannya, tetapi tidak boleh diperlakukan sebagai jawaban default untuk pengembangan baru tanpa peninjauan model terkini.
Kapan router menjadi jawaban yang lebih baik
Tim sering bertanya apakah Grok 4.3 atau GPT-5 lebih baik, tetapi hambatan sebenarnya adalah kompleksitas operasional yang menyebar:
- Kunci penyedia terpisah.
- Dasbor dan faktur terpisah.
- Kebijakan rate limit terpisah.
- Pemeriksaan status terpisah.
- Ekspor penggunaan terpisah.
- ID model yang berbeda di-hardcode di berbagai agen dan layanan.
- Tidak ada aturan fallback bersama ketika salah satu penyedia mengalami penurunan layanan.
Posisi Flatkey dibangun untuk lapisan tersebut: satu kunci, satu saldo, satu faktur, akses model resmi, log penggunaan, dan router yang kompatibel dengan OpenAI. Ini bukan berarti setiap fitur native penyedia otomatis berfungsi melalui setiap rute. Artinya, tim memperoleh satu permukaan operasional untuk membandingkan model yang didukung dan meninjau bukti penggunaan.
Padukan artikel ini dengan panduan katalog model AI, kerangka kerja metrik API perutean AI, dan panduan cepat Flatkey API sebelum mengubah trafik produksi.
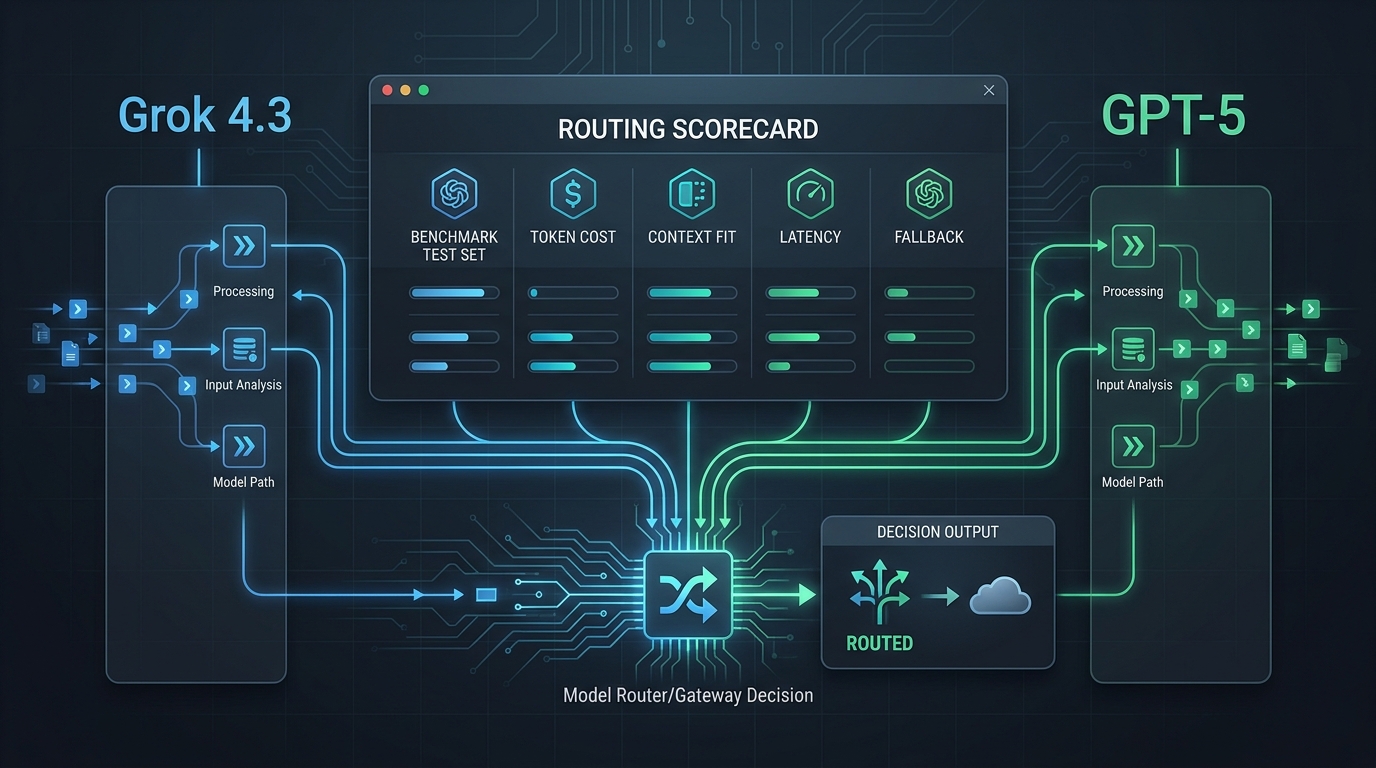
Kartu skor perutean praktis
Gunakan kartu skor ini untuk Grok 4.3 vs GPT-5: Benchmark, Harga, dan Kapan Merutekan Masing-Masing. Beri skor setiap rute dari 1 hingga 5 untuk beban kerja yang sama.
| Kriteria | Bobot | Grok 4.3 | GPT-5 | Catatan |
|---|---|---|---|---|
| Tingkat output yang diterima | 25% | Apakah jawaban lolos validator atau rubrik peninjauan Anda? | ||
| Biaya per output yang diterima | 20% | Sertakan ukuran prompt, panjang output, cache, batch, alat, percobaan ulang, dan output yang ditolak. | ||
| Keandalan alat dan skema | 15% | Hitung JSON tidak valid, pemanggilan alat yang salah, kolom yang hilang, dan parameter yang tidak didukung. | ||
| Keandalan konteks | 15% | Uji paket retrieval p50, p90, dan kasus terburuk. | ||
| Latensi dan timeout | 10% | Ukur TTFT, waktu penyelesaian penuh, dan tingkat timeout. | ||
| Observabilitas | 10% | Apakah tim engineering dan keuangan dapat memeriksa penyedia, model, token, biaya, latensi, dan error? | ||
| Kesiapan fallback | 5% | Apakah rollback telah diuji dan didokumentasikan? |
Kemudian tulis catatan rute:
route_review:
  workload: support_case_summarization
  candidates:
    - grok-4.3
    - gpt-5
  required_features:
    - structured_output
    - streaming
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
  stop_conditions:
    - schema_failure_rate_above_threshold
    - timeout_rate_above_threshold
    - cost_per_accepted_output_above_budget
Kebijakan tersebut lebih berguna daripada tangkapan layar papan peringkat karena memberi tahu aplikasi Anda apa yang harus dilakukan ketika suatu model tidak tersedia, terlalu lambat, terlalu mahal, atau tidak tepat untuk tugas tersebut.
Checklist prapenerbangan sebelum memindahkan trafik
Jalankan pemeriksaan ini sebelum merutekan pengguna nyata ke salah satu model:
- Konfirmasikan ketersediaan model. Periksa konsol penyedia langsung dan katalog gateway pada hari yang sama saat Anda meluncurkan.
- Sematkan ID model. Gunakan
grok-4.3dengan sengaja. Untuk trafik GPT-5 yang sudah ada, sematkangpt-5-2025-08-07hanya selama Anda menyelesaikan migrasi yang tervalidasi; baik model tersebut maupungpt-5dijadwalkan untuk dihapus pada 11 Desember 2026. - Verifikasi keluarga endpoint. Konfirmasikan apakah beban kerja menggunakan rute yang kompatibel dengan xAI, OpenAI Chat Completions, OpenAI Responses, batch, atau endpoint gateway.
- Uji fitur yang diperlukan. Alat, output terstruktur, input gambar, streaming, caching, dan batch hanya boleh diuji jika beban kerja Anda benar-benar membutuhkannya.
- Ukur konteks yang dapat digunakan. Periksa disiplin recall dan sitasi pada ukuran konteks yang realistis.
- Hitung biaya output yang diterima. Sertakan percobaan ulang, output yang ditolak, dan peninjauan manusia.
- Catat setiap rute. Rekam penyedia, model, ID permintaan, token input, token output, token cache, latensi, status, dan biaya.
- Tentukan fallback. Putuskan kapan harus mencoba ulang, mengganti rute, mengantrekan, menurunkan kualitas output, atau gagal tertutup.
- Tetapkan kepemilikan. Berikan seseorang tanggung jawab atas kunci, anggaran, kuota, kesehatan rute, dan rollback.
- Jalankan ulang setelah perubahan model. Rilis Grok atau GPT baru dapat dengan cepat membuat perbandingan ini usang.
FAQ: Varian GPT-5.4 dan GPT-5.5
Apa yang berubah ketika perbandingannya adalah Grok 4.3 vs GPT-5.4 atau GPT-5.5?
Jangan menggantikan gpt-5.4 atau gpt-5.5 ke dalam kolom GPT-5 dan mengasumsikan hasil yang sama. Setiap versi model memiliki ketersediaan, harga, batas konteks, dan status migrasinya sendiri. Jika Anda memindahkan beban kerja GPT-5 yang sudah ada, gunakan perbandingan ini untuk merancang evaluasi, lalu bandingkan Grok 4.3 dengan pengganti OpenAI yang didukung secara tepat pada prompt Anda sendiri. Untuk build baru, mulailah dari panduan model OpenAI saat ini, bukan ID model GPT-5 yang sudah tidak digunakan lagi.
Pemeriksaan sumber yang perlu tetap dibuka
Gunakan dokumentasi langsung saat memfinalisasi rute:
- dokumentasi model OpenAI GPT-5 untuk status, snapshot, konteks, endpoint, fitur, dan ringkasan harga GPT-5.
- harga OpenAI API untuk baris harga token teks terkini serta peringatan terkait wilayah/mode cepat.
- model dan harga xAI untuk konteks, harga, batch, modalitas, dan kontrol penalaran Grok 4.3.
- catatan rilis xAI untuk kebaruan model Grok saat ini.
- papan peringkat model Artificial Analysis untuk metrik penemuan model pihak ketiga, bukan sebagai pengganti benchmark rute Anda sendiri.
Kesimpulannya
Untuk Grok 4.3 vs GPT-5: Benchmark, Harga, dan Kapan Merutekan Masing-Masing, Grok 4.3 biasanya menjadi uji harga pertama ketika token output mendominasi dan alat native OpenAI tidak diperlukan. GPT-5 biasanya menjadi uji integrasi pertama ketika aplikasi Anda bergantung pada Responses API OpenAI, alat yang di-host, prompt caching, atau baseline GPT-5 yang sudah ada.
Untuk produksi, pisahkan kedua keputusan tersebut: pertama pilih model yang lulus untuk beban kerja Anda, lalu pilih rute yang memberi Anda log, kontrol biaya, fallback, dan jalur rollback yang jelas. Di situlah router terpadu menunjukkan nilainya.
Jika Gemini juga ada dalam daftar Anda, baca Grok vs Gemini (Oktober 2026) untuk perbandingan harga langganan dan API.