Grok 4.3 vs GPT-5: Бенчмарки, цены и когда направлять запросы к каждой модели — это вопрос маршрутизации к устаревшей модели в сентябре 2026 года. Текущая документация OpenAI описывает GPT-5 как предыдущую модель для reasoning и рекомендует GPT-6 Astra для новых задач. В примечаниях к релизам xAI теперь Grok 4.7 указан как текущий флагманский маршрут Grok. Тем не менее многим командам по-прежнему нужно сравнивать Grok 4.3 и GPT-5, потому что старые агенты, дашборды, бенчмарки и закупочные заметки были построены вокруг этих названий.
Короткий ответ: используйте Grok 4.3 в первую очередь, когда задача выигрывает от более низкой указанной цены на выход, большего задокументированного окна контекста и совместимых с xAI контролов reasoning. Используйте GPT-5 в первую очередь, когда ваше приложение зависит от поведения родного для OpenAI Responses API, размещённых инструментов, кэширования промптов, совместимости с Chat Completions или уже существующей базовой оценки OpenAI. Используйте роутер, когда реальная проблема — не только качество модели, а переключение между моделями без расползания ключей, счетов, логов и fallback-кода по всем сервисам.
Не принимайте это решение только на основе публичных меток бенчмарков. Сравните модели на своей рабочей нагрузке, а затем маршрутизируйте по стоимости за принятый выход.
Краткое сравнение: Grok 4.3 vs GPT-5
| Область решения | Grok 4.3 | GPT-5 | Примечание по маршрутизации |
|---|---|---|---|
| Статус актуальности | Более старый маршрут Grok; в примечаниях к релизам xAI теперь Grok 4.7 выделен как текущий. | В документации OpenAI GPT-5 назван предыдущей моделью, и рекомендуется GPT-6 Astra. | Считайте обе модели закреплёнными устаревшими маршрутами, если вашему продукту специально не нужны они. |
| Идентификатор модели | grok-4.3, alias grok-4.3-latest. | gpt-5, snapshot по умолчанию gpt-5-2025-08-07. | Закрепляйте точный ID модели или snapshot для воспроизводимых тестов. |
| Вход и выход | Текстовый и изображенческий ввод; текстовый вывод. | Текстовый и изображенческий ввод; текстовый вывод. | Обе модели могут подойти для text workflows с поддержкой зрения; ни одна из них не является маршрутом для видео. |
| Контекст | xAI указывает окно контекста 1M, с ценами за long-context выше 200k prompt tokens. | OpenAI указывает окно контекста 400k, максимум 272k input tokens и максимум 128k output tokens. | Тестируйте полезный контекст, а не только заявленное число контекста. |
| Указанная цена за текст | $1.25 / $0.20 cached / $2.50 output за 1M tokens ниже 200k prompt tokens; $2.50 / $0.40 / $5.00 при 200k+ prompt tokens. | $1.25 / $0.125 cached / $10 output за 1M tokens. | У Grok 4.3 ниже указанная цена на output; у GPT-5 дешевле cached input. |
| Batch | xAI отмечает Grok 4.3 как batch-enabled со скидкой 20% на batch. | OpenAI отмечает GPT-5 Batch как поддерживаемый. | Batch полезен только тогда, когда допустима задержка ответа. |
| Инструменты | В документации xAI указаны function calling, structured outputs, reasoning и options для reasoning-effort. | В документации OpenAI указаны streaming, structured outputs, function calling, file search, image input, web search, prompt caching и поддерживаемые инструменты Responses API. | GPT-5 обычно сильнее, когда требованием являются размещённые OpenAI инструменты. |
Это практическая отправная точка для Grok 4.3 vs GPT-5: Бенчмарки, цены и когда направлять запросы к каждой модели. Публичные спецификации показывают разные затраты и размеры контекста, но победителем в продакшене становится тот маршрут, который проходит ваш валидатор при наименьшей стоимости принятого результата.
Бенчмарьте маршрут, а не название модели
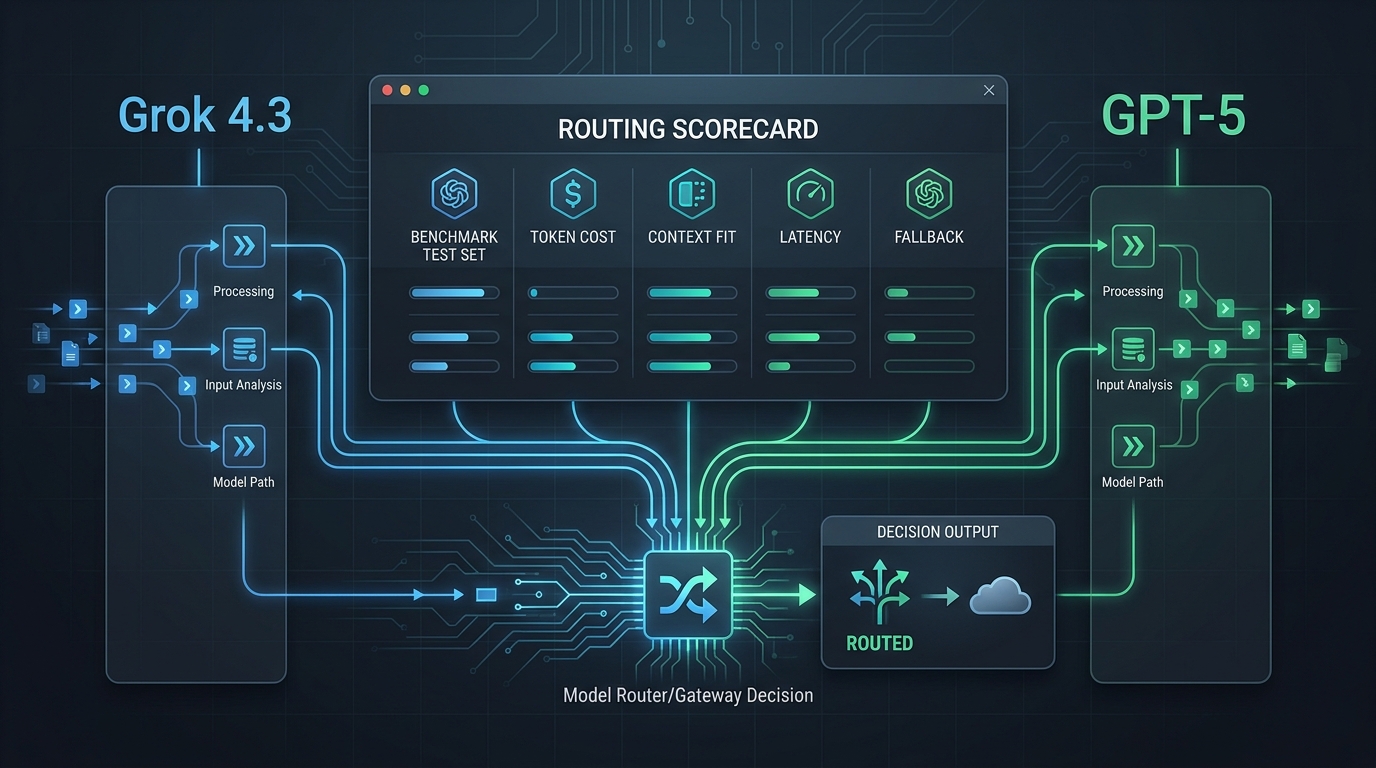
Публичные лидерборды моделей полезны для первичного отбора, но они редко отвечают на производственный вопрос. Оценка бенчмарка не говорит вам, сохраняет ли маршрут вашу точную схему, восстанавливается ли после лимитов запросов, логирует ли использование в нужном месте и укладывается ли в бюджет после повторных попыток.
Соберите небольшой набор бенчмарков перед переносом трафика:
| Бенчмарк-трек | Что тестировать | Почему это меняет маршрут |
|---|---|---|
| Рассуждения и кодинг | 50-200 реальных промптов из рабочих процессов агента, кодинга, анализа или поддержки. | Победа в общем бенчмарке может не перенестись на вашу форму промпта. |
| Структурированный вывод | Требуемая JSON-схема, поля enum, вложенные объекты и случаи с некорректным вводом. | Модель, которая лучше пишет текст, все равно может не пройти ваш парсер. |
| Вызовы инструментов | Требуемый инструмент, отсутствие инструмента, неправильный инструмент и случаи ошибки инструмента. | Одно неверное действие может стоить дороже, чем более высокая цена за токен. |
| Длинный контекст | Пакеты retrieval для p50, p90 и худшего случая. | Большое окно контекста — это не то же самое, что надежное воспроизведение. |
| Стоимость | Входные токены, кэшированные токены, выходные токены, batch-режим, повторные попытки и отклоненные результаты. | Указанная цена за токен неполна без учета процента принятия. |
| Задержка | Время до первого токена, полная задержка ответа, доля таймаутов и поведение очереди. | Пользовательским агентам может понадобиться более быстрый маршрут, даже если он дороже. |
| Fallback | Ошибки провайдера, 429, модель не найдена, сбой схемы, таймаут и деградировавший вывод. | Маршрут без правила отката не готов к продакшену. |
Метрика маршрута должна быть такой:
cost_per_accepted_output =
  (input_cost + cached_input_cost + output_cost + tool_cost + retry_cost + fallback_cost)
  / accepted_outputs
Используйте Grok 4.3, когда он выигрывает по этой формуле для нагрузки с достаточным запасом по качеству и задержке. Используйте GPT-5, когда нативное поведение OpenAI снижает риск реализации, число сбоев валидации или стоимость интеграции настолько, что это компенсирует указанную цену за выходные токены.
Цены: где Grok 4.3 дешевле и где GPT-5 все равно может выиграть
Для коротких текстовых запросов xAI указывает для Grok 4.3 цену $1.25 за вход, $0.20 за кэшированный вход и $2.50 за выход на 1 млн токенов. При 200 тыс. и более токенах промпта xAI указывает более высокие цены для длинного контекста: $2.50 за вход, $0.40 за кэшированный вход и $5.00 за выход на 1 млн токенов. xAI также отмечает, что Grok 4.3 поддерживает batch-режим со скидкой 20%.
OpenAI указывает для GPT-5 цену $1.25 за вход, $0.125 за кэшированный вход и $10 за выход на 1 млн токенов. Это делает GPT-5 более дорогим по указанной цене выходных токенов, но более дешевым по кэшированному входу, чем строка кэшированного входа Grok 4.3 для короткого контекста.
Решение по цене меняется в зависимости от формы нагрузки:
| Форма рабочей нагрузки | Давление на цену | Вероятный первый тест |
|---|---|---|
| Короткий промпт, длинный сгенерированный ответ | Цена на выходные токены доминирует. | Сначала протестируйте Grok 4.3, затем сравните долю принятых выходных результатов. |
| Повторяющийся большой системный промпт или набор политик | Кэшированный ввод имеет значение. | Протестируйте оба; у GPT-5 кэшированный ввод может иметь значение, если доля попаданий в кэш высока. |
| Длинный retrieval-пакет свыше 200k токенов промпта | Применяется ценообразование для длинного контекста. | Протестируйте Grok 4.3 с учетом цены за long-context и задержки. |
| Рабочий процесс с инструментами, размещенными у OpenAI, или с Responses API | Имеет значение поведение инструментов и интеграции. | Сначала протестируйте GPT-5, потому что прямая поддержка функции может снизить сложность приложения. |
| Офлайн-оценки или backfill-задачи | Имеет значение batch-экономика. | Протестируйте оба batch-пути, если допустимо отложенное завершение. |
Если вы сравниваете только указанную цену на вход, Grok 4.3 vs GPT-5: Бенчмарки, цены и когда направлять запросы к каждой модели превращается в вводящую в заблуждение таблицу. Длина вывода, частота повторных попыток, сбои инструментов и ручная проверка могут свести на нет видимую экономию.
Когда направлять запросы к Grok 4.3
Начинайте с Grok 4.3, когда нагрузка чувствительна к стоимости, требует большого объема вывода и не привязана к нативным инструментам OpenAI.
Хорошие кандидаты включают:
- Внутренние аналитические задачи, где текстовый вывод длинный, а проверка проста.
- Суммаризацию длинного контекста, где полезно документированное окно контекста в 1M и цена за long-context все еще ниже альтернатив.
- Пакетные задания оценки, где batch допустим и применяется скидка 20%.
- Рабочие процессы, использующие function calling или структурированные выходы, но не требующие инструментов, размещенных у OpenAI.
- Эксперименты с моделями, где нужен маршрут семейства Grok для сравнения с GPT, Claude, Gemini, DeepSeek или Qwen.
Перед запуском проверьте точный маршрут Grok в консоли провайдера или каталоге gateway. У xAI есть более новые маршруты Grok, а текущие локальные знания Flatkey подтверждают grok-4.2, а не grok-4.3, поэтому не предполагается, что Grok 4.3 доступен через gateway, пока это не подтвердит живой каталог.
Когда направлять запросы к GPT-5
Начинайте с GPT-5, когда нагрузка зависит от API OpenAI или когда история вашей оценки уже использует GPT-5 в качестве базовой линии.
Хорошие кандидаты включают:
- Существующие приложения OpenAI Chat Completions или Responses API, которые не следует переписывать ради эксперимента с моделью.
- Рабочие нагрузки, использующие инструменты, размещенные у OpenAI, такие как web search, file search, image generation, code interpreter или MCP через Responses API.
- Продукты, которые полагаются на кэширование промптов OpenAI, структурированные выходы, streaming или специфичные для OpenAI project controls.
- Регрессионные тесты, где предыдущие снимки GPT-5 входят в базовую линию приемки.
- Аудиты миграции, где GPT-5 является стабильным эталонным маршрутом перед переходом на более новую модель.
Оговорка — актуальность. В текущей документации OpenAI GPT-5 назван предыдущей моделью. Если вы начинаете новый проект, сравните также текущую рекомендованную OpenAI модель. GPT-5 все еще стоит тестировать, когда вопрос касается закрепленного legacy-маршрута, но его не следует считать ответом по умолчанию для новой разработки без актуального обзора модели.
Когда маршрутизатор — лучший ответ
Команды часто спрашивают, что лучше — Grok 4.3 или GPT-5, но реальное узкое место — операционная разрозненность:
- Отдельные ключи провайдеров.
- Отдельные дашборды и счета.
- Отдельные политики rate-limit.
- Отдельные проверки статуса.
- Отдельные выгрузки использования.
- Разные ID моделей, захардкоженные в агентах и сервисах.
- Отсутствие общего правила fallback, когда один из провайдеров деградирует.
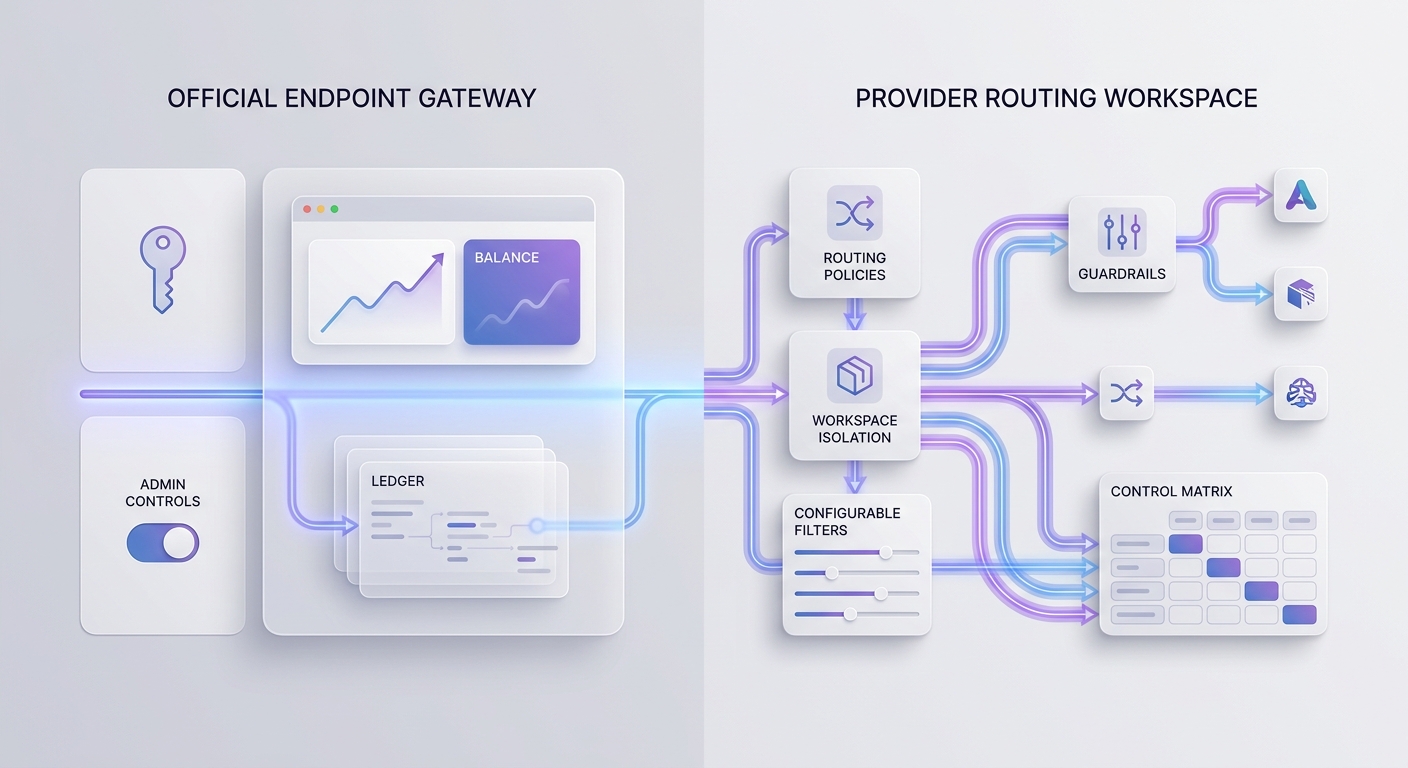
Позиционирование Flatkey построено именно для этого слоя: один ключ, один баланс, один счет, официальный доступ к моделям, журналы использования и роутер, совместимый с OpenAI. Это не означает, что каждая нативная функция провайдера автоматически работает через каждый маршрут. Это означает, что у команды есть единая операционная поверхность для сравнения поддерживаемых моделей и анализа доказательств использования.
Сопоставьте эту статью с руководством по каталогу AI-моделей, фреймворком метрик AI routing API и быстрым стартом Flatkey API перед изменением производственного трафика.
Практическая оценочная таблица для маршрутизации
Используйте эту оценочную таблицу для Grok 4.3 vs GPT-5: Бенчмарки, цены и когда направлять запросы к каждой модели. Оцените каждый маршрут от 1 до 5 для одной и той же нагрузки.
| Критерий | Вес | Grok 4.3 | GPT-5 | Примечания |
|---|---|---|---|---|
| Доля принятых ответов | 25% | Проходит ли ответ ваш валидатор или рубрику проверки? | ||
| Стоимость за принятый ответ | 20% | Учитывайте размер промпта, длину вывода, кэш, batch, инструменты, повторы и отклоненные ответы. | ||
| Надежность инструментов и схемы | 15% | Подсчитайте невалидный JSON, неверные вызовы инструментов, отсутствующие поля и неподдерживаемые параметры. | ||
| Надежность контекста | 15% | Тестируйте пакеты retrieval для p50, p90 и худшего случая. | ||
| Задержка и тайм-ауты | 10% | Измеряйте TTFT, полное время завершения и частоту тайм-аутов. | ||
| Наблюдаемость | 10% | Могут ли инженерия и финансы просматривать провайдера, модель, токены, стоимость, задержку и ошибки? | ||
| Готовность к fallback | 5% | Проверен и задокументирован ли rollback? |
Затем создайте запись о маршруте:
route_review:
  workload: support_case_summarization
  candidates:
    - grok-4.3
    - gpt-5
  required_features:
    - structured_output
    - streaming
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
  stop_conditions:
    - schema_failure_rate_above_threshold
    - timeout_rate_above_threshold
    - cost_per_accepted_output_above_budget
Эта политика полезнее, чем скриншот таблицы лидеров, потому что она подсказывает вашему приложению, что делать, когда модель недоступна, слишком медленная, слишком дорогая или не подходит для задачи.
Чек-лист перед переносом трафика
Выполните эти проверки перед тем, как направлять реальных пользователей к любой из моделей:
1. Подтвердите доступность модели. Проверьте консоль прямого провайдера и любой каталог шлюза в тот же день, когда запускаетесь.
2. Закрепляйте идентификаторы моделей. Используйте grok-4.3 или gpt-5-2025-08-07 осознанно; не полагайтесь на старый псевдоним без проверки.
3. Проверяйте семейство endpoint-ов. Убедитесь, использует ли нагрузка совместимые с xAI маршруты, OpenAI Chat Completions, OpenAI Responses, batch или gateway endpoint-ы.
4. Тестируйте требуемые функции. Tools, структурированные ответы, ввод изображений, streaming, caching и batch следует тестировать только если вашей нагрузке они действительно нужны.
5. Измеряйте полезный контекст. Проверяйте полноту recall и дисциплину цитирования при реалистичных размерах контекста.
6. Рассчитывайте стоимость принятого вывода. Учитывайте повторы, отклонённые ответы и ручную проверку.
7. Логируйте каждый маршрут. Фиксируйте провайдера, модель, request ID, входные токены, выходные токены, cache tokens, latency, статус и стоимость.
8. Определите fallback. Решите, когда повторять запрос, переключать маршруты, ставить в очередь, ухудшать качество вывода или завершать с ошибкой по принципу fail closed.
9. Назначьте владельца. Назначьте ответственного за ключи, бюджет, квоту, состояние маршрута и rollback.
10. Повторно запускайте тесты после изменений модели. Новые релизы Grok или GPT могут быстро сделать это сравнение устаревшим.
Ссылки на источники, которые стоит держать открытыми
Используйте актуальную документацию при финализации маршрута:
- Документация OpenAI по модели GPT-5 — статус GPT-5, snapshot, контекст, endpoint-ы, функции и сводка по ценам.
- Цены OpenAI API — текущие строки цен на текстовые токены и оговорки по регионам/fast-mode.
- Модели и цены xAI — контекст Grok 4.3, цены, batch, модальности и параметры управления reasoning.
- Примечания к релизам xAI — актуальная свежесть модели Grok.
- Рейтинг моделей Artificial Analysis — сторонние метрики для discovery моделей, не замена собственным бенчмаркам маршрута.
Главный вывод
Для Grok 4.3 vs GPT-5: Бенчмарки, цены и когда направлять запросы к каждой модели Grok 4.3 обычно становится первым тестом по цене, когда выходные токены доминируют и не требуются нативные инструменты OpenAI. GPT-5 обычно становится первым тестом интеграции, когда ваше приложение зависит от API OpenAI Responses, hosted tools, prompt caching или уже существующего базового уровня GPT-5.
Для production держите эти два решения раздельно: сначала выберите модель, которая проходит вашу нагрузку, затем выберите маршрут, который даёт логи, контроль затрат, fallback и чистый путь rollback. Именно здесь unified router и оправдывает своё место.