Kimi K3 vs. GPT 5.6 Sol: Preise, Kontext und welche API Sie testen sollten
Wenn Sie Kimi K3 mit GPT 5.6 Sol vergleichen, beginnen Sie nicht mit einem Leaderboard-Screenshot. Wählen Sie zunächst die exakten Modell-IDs, normalisieren Sie den Reasoning-Aufwand und messen Sie die Kosten pro akzeptiertem Ergebnis bei Ihren eigenen Aufgaben.
Beide Modelle sind für agentische Arbeit mit langem Kontext ausgelegt. Die aktuelle API-Dokumentation von Kimi positioniert kimi-k3 als Flaggschiff für Programmierung mit langem Horizont, Wissensarbeit, natives visuelles Verständnis und tiefgehendes Reasoning. OpenAI positioniert gpt-5.6-sol als Flaggschiff-Stufe der GPT-5.6-Familie für komplexe professionelle Arbeit. Der praktische Unterschied ist nicht einfach: „Welches Modell ist intelligenter?“ Entscheidend ist, welcher Weg Ihrem Produkt für einen bestimmten Workload die passende Qualität, das richtige Tool-Verhalten, die richtige Latenz und die passende Rechnung liefert.
Dieser Leitfaden vergleicht Kimi K3 mit GPT 5.6 Sol anhand der aktuellen Dokumentation der Anbieter und gibt Ihnen anschließend einen reproduzierbaren Plan zur API-Evaluierung. Er umfasst auch GPT-5.6 Terra, die günstigere GPT-5.6-Option, da diese oft die nützlichere Referenz für eine Routing-Entscheidung in der Produktion ist.
Kurzantwort: Testen Sie Kimi K3, wenn Programmierung mit langem Kontext, stets aktiviertes Reasoning und Kimis nativer Vision-Workflow zu Ihrem Produkt passen. Testen Sie GPT-5.6 Sol, wenn Sie die OpenAI-Tool-Oberfläche und eine konfigurierbare Flaggschiff-Reasoning-Stufe benötigen. Behalten Sie GPT-5.6 Terra im Testset, wenn die Stückkosten wichtig sind. Erklären Sie keinen Gewinner, bevor Sie nicht dieselben Testfälle über jede Route ausgeführt haben.
Was „GPT-5“ in diesem Vergleich bedeutet
„GPT-5“ ist im Oktober 2026 ein mehrdeutiger Suchbegriff. OpenAIs GPT-5-Modellseite beschreibt GPT-5 als vorheriges, eingestelltes Modell, während die aktuellen Hinweise zur Einstellung mehrerer älterer GPT-5-Snapshots auf die GPT-5.6-Familie verweisen. In diesem Artikel bedeutet Kimi K3 vs. GPT 5.6 Sol die aktuellen öffentlichen Modell-IDs kimi-k3 und gpt-5.6-sol, nicht einen nicht näher spezifizierten älteren GPT-5-Alias.
Wenn Ihre Anwendung auf einem älteren gpt-5-*-Snapshot festgelegt ist, behandeln Sie dies zunächst als Migrationsprojekt. Legen Sie den genauen Ersatz fest, aktualisieren Sie Ihre Tests und bestätigen Sie das Abschaltdatum des Anbieters, bevor Sie die Modellqualität vergleichen.
Kimi K3 vs. GPT 5.6 Sol auf einen Blick
| Entscheidungsfaktor | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| API-Modell-ID | kimi-k3 |
gpt-5.6-sol |
gpt-5.6-terra |
| Positionierung durch den Anbieter | Flaggschiff für Programmierung mit langem Horizont, Wissensarbeit, Reasoning und natives visuelles Verständnis | GPT-5.6-Flaggschiff-Stufe für komplexe professionelle Arbeit | GPT-5.6-Stufe, die Intelligenz und Kosten ausgleichen soll |
| Kontextfenster | Bis zu 1 Mio. Tokens | 1,05 Mio. Tokens | 1,05 Mio. Tokens |
| Reasoning-Steuerung | Immer aktiviert; low, high oder max; Standard: max |
none, low, medium, high, xhigh oder max; Standard: medium |
Dieselben dokumentierten Optionen für den Reasoning-Aufwand wie bei Sol |
| Direkter Listenpreis für Eingabe | 3,00 $ / 1 Mio. nicht gecachte Tokens | 4,00 $ / 1 Mio. Tokens | 2,00 $ / 1 Mio. Tokens |
| Direkter Listenpreis für gecachte Eingabe | 0,30 $ / 1 Mio. Tokens | 0,40 $ / 1 Mio. Tokens | 0,20 $ / 1 Mio. Tokens |
| Direkter Listenpreis für Ausgabe | 15,00 $ / 1 Mio. Tokens | 20,00 $ / 1 Mio. Tokens | 12,00 $ / 1 Mio. Tokens |
| Zu testende Tooling-Frage | Kimi-spezifisches Anfrage-, Thinking-, Vision- und Tool-Call-Verhalten auf Ihrem gewählten Endpunkt | OpenAI-Responses-Funktionen und gehostete Tools, die Ihr Produkt benötigt | Dieselbe Integrationsoberfläche mit einem günstiger bepreisten GPT-5.6-Kandidaten |
Die Kimi-Zahlen stammen von den aktuellen Plattform- und Abrechnungsseiten von Moonshot. Die GPT-Zahlen stammen von den individuellen Modellseiten von OpenAI. Es handelt sich um direkte Referenzpreise der Anbieter, geprüft am 22. Oktober 2026 — nicht um ein Angebot für jedes Gateway, jede Region, Aktion, jeden Tool-Aufruf, jede steuerliche Behandlung oder Unternehmensvereinbarung.
Bei Kimi K3 vs. GPT 5.6 Sol liegen die Kontextzahlen in den Überschriften nah genug beieinander, dass „eine Million Tokens“ allein nicht über das Ergebnis entscheiden sollte. Die entscheidenden Fragen sind, ob Ihre Testfälle mit langem Kontext die relevanten Fakten behalten, ob die Ausgabe nutzbar bleibt und was die vollständige Anfrage nach Caching und Ausgabe-Tokens kostet.
Preisvergleich: Verwenden Sie einen Workload, keinen Listenpreis
Token-Preise sind Eingaben für ein Kostenmodell, nicht das Ergebnis der Modellauswahl. Eine einfache Schätzung lautet:
geschätzte Anfragekosten =
  (nicht gecachte Eingabe-Tokens × Satz für nicht gecachte Eingabe) +
  (gecachte Eingabe-Tokens × Satz für gecachte Eingabe) +
  (Ausgabe-Tokens × Ausgaberate)
Hier ist die Rechnung mit direkten Preisen für zwei bewusst einfache Workloads. Sie schließt Steuern, Gateway-Preise, Gebühren für Tool-Aufrufe und etwaige Aufschläge für langen Kontext aus.
| Beispiel-Workload | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| 1 Mio. nicht gecachte Eingabe + 250.000 Ausgabe | 6,75 $ | 9,00 $ | 5,00 $ |
| 1 Mio. gecachte Eingabe + 250.000 Ausgabe | 4,05 $ | 5,40 $ | 3,20 $ |
Diese Berechnungen zeigen, warum Kimi K3 vs GPT 5.6 Sol kein eindimensionaler Kostenvergleich ist. Kimis veröffentlichter Listenpreis ist in diesem Beispiel niedriger als der von Sol, während Terra noch günstiger ist. Doch ein günstigerer Aufruf, der Wiederholungsversuche benötigt, mehr manuelle Prüfungsarbeit erzeugt oder einen Tool-Vertrag verfehlt, ist nicht automatisch pro akzeptierter Aufgabe günstiger.
Beim langen Kontext gibt es noch eine weitere Besonderheit. OpenAI dokumentiert für GPT-5.6 Sol und Terra bei Prompts mit mehr als 272K Input-Tokens einen Preismultiplikator: 2× für Input und 1,5× für Output für die gesamte Anfrage. Im Abrechnungsleitfaden von Kimi für K3 heißt es, dass der K3-Preis nicht nach Kontextlängenbereichen gestaffelt ist. Nehmen Sie einen realen Langdokument-Fall in Ihren Testsatz auf und erfassen Sie die auf der Rechnung sichtbare Nutzung; extrapolieren Sie nicht von einem kurzen Prompt.
Eine umfassendere Methode finden Sie in unserem Leitfaden dazu, wie Sie KI-Modellpreise vergleichen, bevor Sie den Anbieter wechseln.
Reasoning-Einstellungen sind nicht austauschbar
Kimi K3 läuft immer im Thinking-Modus. Die dokumentierten Werte für reasoning_effort sind low, high und max, wobei max die Standardeinstellung ist. GPT-5.6 Sol und GPT-5.6 Terra dokumentieren eine breitere Skala mit none, low, medium, high, xhigh und max, wobei medium die Standardeinstellung ist.
Dadurch sind Tests mit den jeweiligen Standardeinstellungen irreführend. Ein fairer Kimi K3 vs GPT 5.6 Sol-Versuch sollte eine kompatible gemeinsame Stufe wie high festlegen, sofern die Route diese unterstützt, und anschließend einen separaten budgetorientierten Vergleich mit den dokumentierten Standardwerten der Anbieter durchführen. Halten Sie diese Ergebnisse in getrennten Zeilen fest – andernfalls vermischen Sie die Modellwahl mit der Wahl des Reasoning-Budgets.
Halten Sie außerdem anbieterspezifische Parameter aus der ersten modellübergreifenden Basislinie heraus. Kimis Dokumentation beschreibt das eigene K3-Verhalten; die Responses API von OpenAI bietet eine breitere Palette gehosteter Tools. Beginnen Sie mit einer einfachen strukturierten Aufgabe und fügen Sie Tool-, Vision- und multimodale Fälle erst hinzu, nachdem der grundlegende Anfrage-/Antwort-Vertrag funktioniert.
Tools, APIs und Migrationseignung
Beide Anbieter bieten vertraute Entwickleroberflächen, doch „OpenAI-kompatibel“ sollte als Ausgangspunkt betrachtet werden, nicht als Zusage, dass jedes Feld und jedes gestreamte Ereignis identisch ist.
OpenAI dokumentiert für GPT-5.6 Sol den Zugriff über Chat Completions und Responses sowie Function Calling, strukturierte Ausgaben und zahlreiche Tools der Responses API wie Websuche, Dateisuche, Bilderzeugung, Code Interpreter, gehostete Shell, Computernutzung, MCP und Tool-Suche. Das kann einen Workflow vereinfachen, der bereits von diesen von OpenAI gehosteten Funktionen abhängt.
Kimi dokumentiert kimi-k3 für langfristige Coding- und Wissensarbeit, und die offiziellen Materialien beschreiben OpenAI-kompatible sowie Responses-orientierte Integrationen. Das stets aktive Thinking von K3, die zulässigen Reasoning-Stufen und die Details zu Vision oder Tool-Aufrufen verdienen routenspezifische Smoke-Tests, bevor Sie einen Agenten mit komplexem Nachrichtenverlauf migrieren.
Wenn Sie K3 bereits evaluieren, lesen Sie den Leitfaden zum Kimi-K3-API-Zugang mit Hinweisen zu Modell-ID, Parametern und der Einrichtung beim direkten Anbieter. Wenn Sie einen Client beibehalten und gleichzeitig Kandidaten wechseln müssen, verwenden Sie eine OpenAI-kompatible Base URL für Prompt-Tests mit mehreren Modellen und bewahren Sie die exakte Modell-ID jedes Kandidaten in Ihren Logs auf.
Ein 48-Stunden-Evaluierungsplan für Kimi K3 vs GPT 5.6 Sol
Führen Sie nicht nur einen einzigen cleveren Prompt aus und nennen Sie das Ergebnis Benchmark. Verwenden Sie eine kleine, aber repräsentative Testfallmenge.
- Kandidaten festlegen. Beginnen Sie mit
kimi-k3,gpt-5.6-solundgpt-5.6-terra. Erfassen Sie für jede Anfrage Datum, Endpunkt, SDK-Version, Modell-ID und Reasoning-Einstellung. - 20–50 reale Aufgaben auswählen. Beziehen Sie die Codeänderungen, Dokumente, Schemas, Tool-Aufrufe, Bilder und Fehlerfälle ein, die Ihre Nutzer tatsächlich erzeugen. Schwärzen Sie sensible Eingaben, bevor Sie sie irgendwohin senden.
- Akzeptanz vor der Ausführung definieren. Beispiele: Tests bestehen, JSON ist valide, zitierte Felder sind vorhanden, ein menschlicher Prüfer akzeptiert das Ergebnis oder ein Agent schließt die Aufgabe ohne unsicheren Wiederholungsversuch ab.
- Den vollständigen Betriebsdatensatz erfassen. Speichern Sie Token-Anzahlen für Input, gecachten Input, Output und Wiederholungsversuche; Latenz; HTTP- oder Tool-Fehler; Akzeptanzergebnis; und Prüfzeit. Ergänzen Sie das Verhalten bei Rate Limits für Dauerverkehr mithilfe einer Checkliste zur Planung von LLM-Rate-Limits.
- Kosten pro akzeptiertem Ergebnis bewerten. Teilen Sie die Gesamtausgaben für jeden Kandidaten durch die akzeptierten Aufgaben, nicht durch die Rohzahl der Aufrufe. Behalten Sie Fehler- und Wiederholungskosten im Zähler bei.
- Mit einem Fallback ausrollen. Leiten Sie einen kleinen Prozentsatz geeigneter Arbeit an den ausgewählten Kandidaten weiter, halten Sie einen getesteten Fallback bereit und alarmieren Sie bei Rückschritten bei Qualität, Latenz und Kosten.
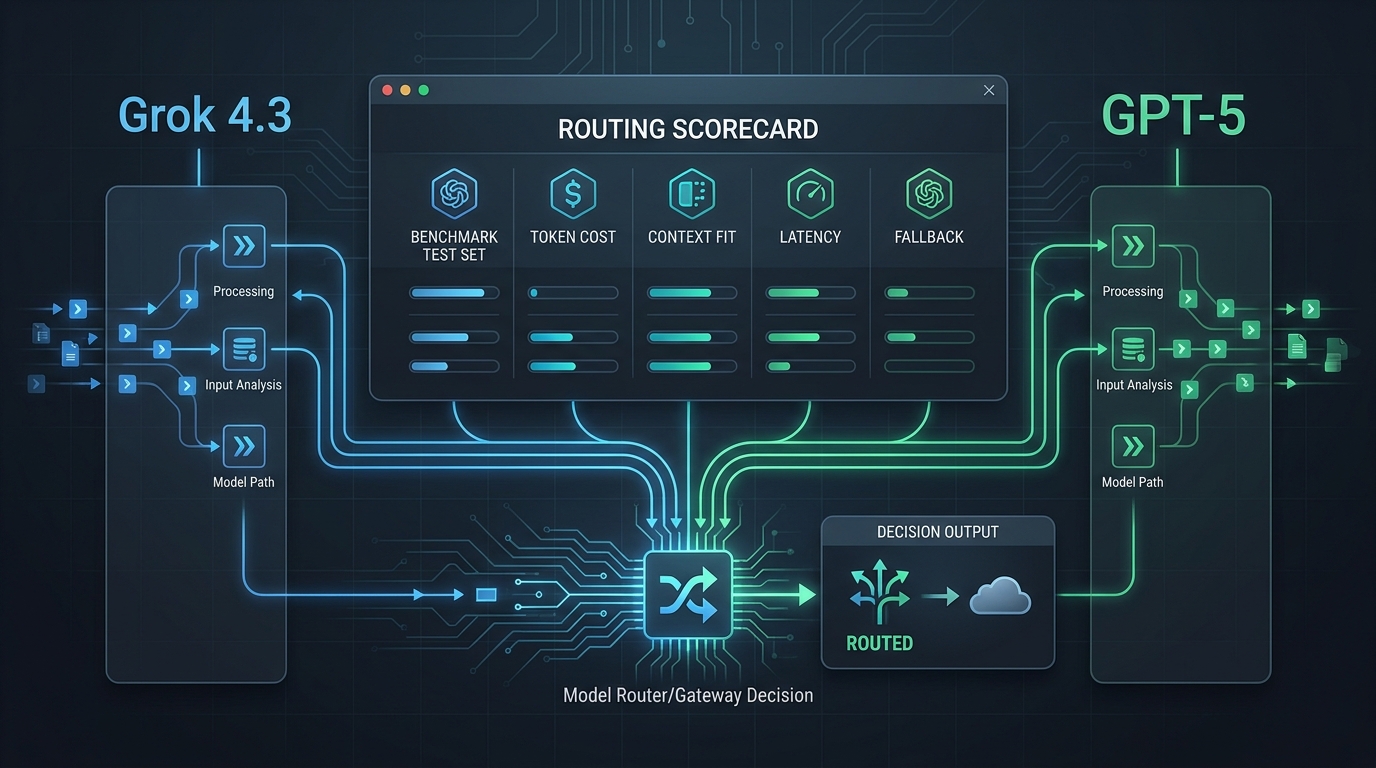
Verwenden Sie eine kompakte Scorecard, damit ein Team die Entscheidung erneut prüfen kann, wenn sich ein Modell oder Preis ändert:
| Metrik | Warum sie wichtig ist | Beispielhafte Akzeptanzregel |
|---|---|---|
| Bestehensrate von Aufgaben | Erfasst die für Nutzer sichtbare Qualität | Tests bestehen oder Prüfer genehmigt |
| Kosten pro akzeptierter Aufgabe | Umfasst Wiederholungsversuche und Ausgabevolumen | Innerhalb des Budgets für den Workload bleiben |
| P95-Latenz | Erfasst die Erfahrung am langen Ende der Verteilung | Interaktions- oder Job-SLA einhalten |
| Gültigkeit strukturierter Ausgaben | Zeigt die Zuverlässigkeit des API-Vertrags | Schema wird ohne Nachbearbeitung validiert |
| Abschluss von Tool oder Agent | Testet das Verhalten realer Workflows | Erforderliche Tools werden mit korrekter Übergabe abgeschlossen |
| Wiederherstellung durch Fallback | Schützt die Produktionsverfügbarkeit | Wiederholungsversuch oder Fallback wird sicher abgeschlossen |
Testen Sie dieselbe Anfrage über eine Routing-Schicht
Die Verwendung desselben Clients für alle Kandidaten beseitigt eine Quelle unbeabsichtigter Vergleichsverzerrungen. Der öffentliche Schnellstart von Flatkey dokumentiert einen Schlüssel und eine OpenAI-kompatible https://router.flatkey.ai/v1-Basis-URL, während die öffentlichen Preismetadaten bei der Prüfung dieses Artikels kimi-k3, gpt-5.6-sol und gpt-5.6-terra als verfügbar auswiesen. Verfügbarkeit und Feldunterstützung können sich ändern; prüfen Sie daher vor einem Produktions-Rollout den Modellvertrag.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

for model in ("kimi-k3", "gpt-5.6-sol", "gpt-5.6-terra"):
    response = client.chat.completions.create(
        model=model,
        reasoning_effort="high",  # a shared supported baseline to test first
        messages=[
            {"role": "user", "content": "Solve the evaluation fixture and return valid JSON."}
        ],
    )
    print(model, response.choices[0].message.content)
Verwenden Sie dieses Snippet als Ausgangspunkt für die Evaluierung, nicht als Produktionsvertrag. Prüfen Sie insbesondere alle Kimi-spezifischen Felder, das Tool-Verhalten, Streaming-Ereignisse, Sicherheitseinstellungen und das Ausgabeschema am genau gewählten Endpunkt. Prüfen Sie nach jedem Durchlauf die nutzungs- und ergebnisbezogenen Daten auf Anfrageebene, anstatt anzunehmen, dass ein Alias, eine Hochstufung oder eine Modellkarte unverändert bleibt.
Welches Modell sollten Sie zuerst testen?
Beginnen Sie bei Kimi K3 vs GPT 5.6 Sol mit Kimi K3, wenn Ihre kritische Aufgabe langfristiges Programmieren oder Wissensarbeit ist, Sie K3s dokumentiertes natives visuelles Verständnis nutzen möchten und bereit sind, sein K3-spezifisches Reasoning- und Anfrageverhalten zu validieren.
Beginnen Sie mit GPT-5.6 Sol, wenn der Workflow stark von den aktuellen Tools der Responses API von OpenAI abhängt oder wenn die umfassenderen reasoning_effort-Steuerungen Teil Ihres Produktdesigns sind. Fügen Sie GPT-5.6 Terra hinzu, wenn dieselbe API-Familie und ein niedrigerer direkter Tokenpreis wichtiger sind als die Nutzung der Flaggschiff-Stufe.
Die richtige Antwort für die Produktion kann „alle drei“ lauten: eine Flaggschiff-Route für schwierige Aufgaben, eine kostengünstigere Route für wiederholbare Arbeit und ein getesteter Fallback. Ein AI API Gateway ist besonders nützlich, wenn er Ihnen hilft, diese Richtlinie durchzusetzen, ohne Provider-Schlüssel und modellspezifische Routing-Regeln im gesamten Produktcode zu verteilen.
Häufig gestellte Fragen
Ist Kimi K3 günstiger als GPT-5.6 Sol?
Bei den für diesen Artikel geprüften direkten Listenpreisen ist Kimi K3 für nicht zwischengespeicherte Eingaben, zwischengespeicherte Eingaben und Ausgaben günstiger als GPT-5.6 Sol. Das beweist nicht, dass es die niedrigeren Kosten pro akzeptierter Aufgabe hat. Vergleichen Sie Wiederholungsversuche, Ausgabelänge, Preisregeln für langen Kontext, Tool-Gebühren, Gateway-Preise und menschliche Prüfungsarbeit anhand Ihrer eigenen Testfälle.
Ist GPT-5.6 Terra ein besserer Vergleich als GPT-5.6 Sol?
Es ist ein nützlicher zusätzlicher Vergleich, wenn Kostensensitivität Teil der Entscheidung ist. Terra hat dasselbe dokumentierte Kontextfenster von 1,05 Mio. Token und niedrigere direkte Listenpreise als Sol, während Sol die Flaggschiff-Stufe GPT-5.6 von OpenAI ist. Beziehen Sie beide ein, wenn Sie eine Entscheidung über die Modellfamilie von einer Entscheidung über die Preisstufe trennen müssen.
Kann ich Kimi K3 und GPT-5.6 Sol mit demselben OpenAI-Client verwenden?
Sie können einen Client im OpenAI-Stil mit einem kompatiblen Anbieter oder einer Routing-Schicht verwenden, müssen jedoch den genauen Endpunkt und die Felder validieren. Modellkompatibilität bedeutet nicht, dass Reasoning-Parameter, Tool-Ereignisse, visuelle Eingaben, Ratenlimits oder das Verhalten strukturierter Ausgaben identisch sind.
Bedeutet ein größeres Kontextfenster, dass ein Modell besser für meine Codebasis ist?
Nein. Kontextkapazität garantiert weder Retrieval, Reasoning, Ausgabequalität oder Latenz noch eine überschaubare Rechnung. Nehmen Sie ein repräsentatives Repository- oder Dokument-Testobjekt in die Evaluierung auf und bewerten Sie das akzeptierte Ergebnis, nicht die beworbene Kontextzahl.
Abschließende Empfehlung
Das nützliche Ergebnis eines Vergleichs Kimi K3 vs GPT 5.6 Sol ist eine Routing-Regel, die Sie erklären können: Welcher Kandidat welche Aufgabe übernimmt, auf welchem Reasoning-Niveau, innerhalb welcher Latenz- und Kostenleitplanken und mit welchem Fallback. Verwenden Sie die veröffentlichten Preis- und Kontextangaben, um den Testplan zu erstellen; nutzen Sie Ihre eigenen Akzeptanzdaten, um den Standard für die Produktion zu wählen.
Quellen
- Auswahl des Kimi-API-Modells
- Kimi-API-Plattform und aktuelle K3-Preiskarte
- Leitfaden zur Kimi-API-Abrechnung
- Leitfaden zur Kimi Open Platform Responses-Integration
- OpenAI GPT-5.6 Sol-Modelldokumentation
- OpenAI GPT-5.6 Terra-Modelldokumentation
- OpenAI GPT-5- und Deprecation-Dokumentation
- OpenAI-Modell-Deprecations
- Flatkey-Schnellstart