Kimi K3 vs GPT 5.6 Sol : tarifs, contexte et API à tester
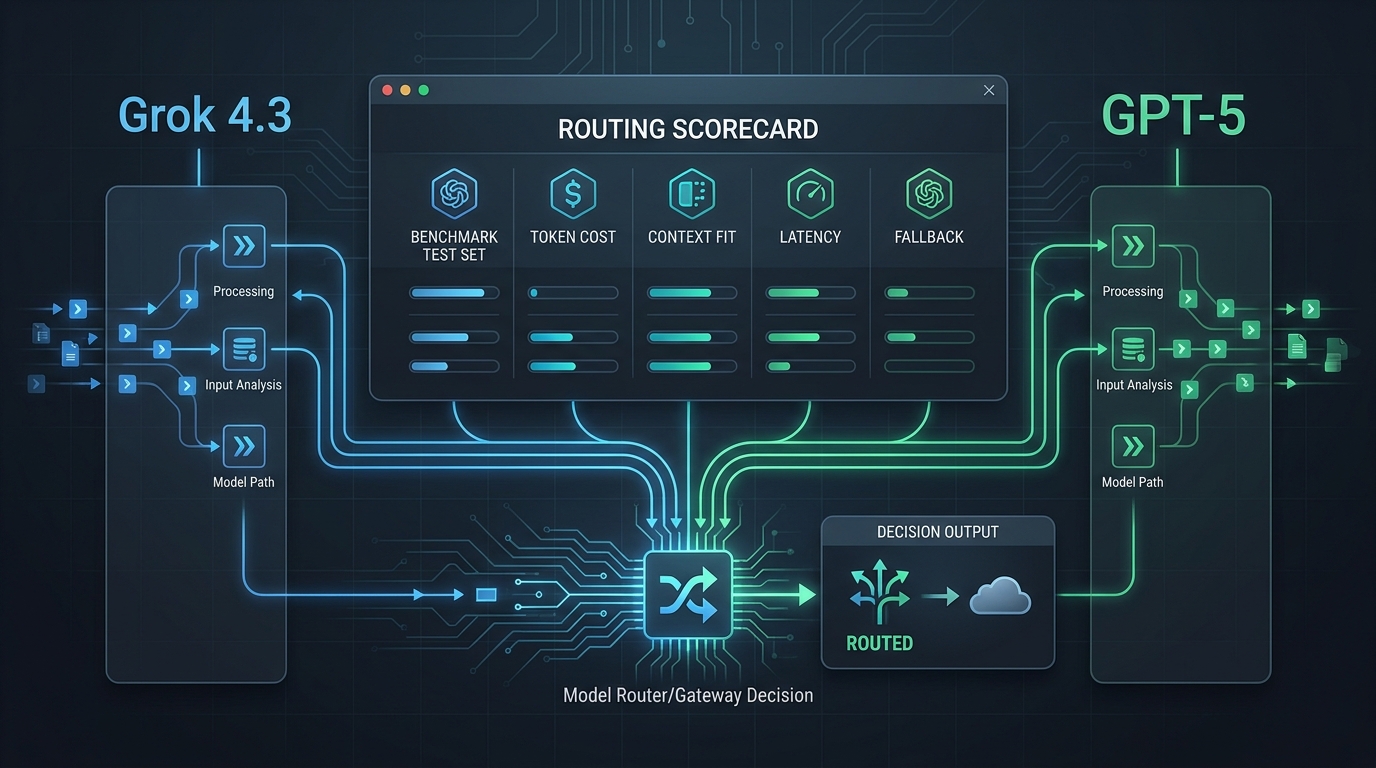
Si vous comparez Kimi K3 vs GPT 5.6 Sol, ne commencez pas par une capture d’écran de classement. Commencez par choisir les identifiants de modèle exacts, normaliser l’effort de raisonnement et mesurer le coût par résultat accepté sur vos propres tâches.
Les deux modèles sont conçus pour le travail agentique à contexte long. La documentation API actuelle de Kimi présente kimi-k3 comme son modèle phare pour le codage à long horizon, le travail de connaissance, la compréhension visuelle native et le raisonnement approfondi. OpenAI présente gpt-5.6-sol comme le niveau phare de la famille GPT-5.6 pour le travail professionnel complexe. La différence pratique ne se résume pas à « quel modèle est le plus intelligent ? ». Il s’agit de savoir quelle option apporte à votre produit la qualité, le comportement des outils, la latence et la facture adaptés à une charge de travail précise.
Ce guide compare Kimi K3 vs GPT 5.6 Sol à l’aide de la documentation actuelle des fournisseurs, puis vous propose un plan d’évaluation API reproductible. Il inclut également GPT-5.6 Terra, l’option GPT-5.6 moins coûteuse, car elle constitue souvent une référence plus utile pour une décision de routage en production.
Réponse courte : Testez Kimi K3 lorsque le codage à contexte long, le raisonnement toujours actif et le flux de travail de vision native de Kimi correspondent à votre produit. Testez GPT-5.6 Sol lorsque vous avez besoin de la surface d’outils d’OpenAI et d’un niveau phare de raisonnement configurable. Gardez GPT-5.6 Terra dans l’ensemble de tests lorsque le coût unitaire compte. Ne désignez pas de gagnant avant d’avoir exécuté les mêmes jeux de tests sur chaque option.
Ce que signifie « GPT-5 » dans cette comparaison
« GPT-5 » est un terme de recherche ambigu en octobre 2026. La page des modèles GPT-5 d’OpenAI décrit GPT-5 comme un modèle précédent et obsolète, tandis que ses instructions actuelles de dépréciation redirigent plusieurs snapshots GPT-5 plus anciens vers la famille GPT-5.6. Dans cet article, Kimi K3 vs GPT 5.6 Sol désigne les identifiants de modèles publics actuels kimi-k3 et gpt-5.6-sol, et non un alias GPT-5 historique non spécifié.
Si votre application est épinglée sur un ancien snapshot gpt-5-*, considérez d’abord cela comme un projet de migration. Épinglez le remplaçant précis, mettez à jour vos tests et confirmez la date d’arrêt du fournisseur avant de comparer la qualité des modèles.
Kimi K3 vs GPT 5.6 Sol en un coup d’œil
| Facteur de décision | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| Identifiant de modèle API | kimi-k3 |
gpt-5.6-sol |
gpt-5.6-terra |
| Positionnement du fournisseur | Modèle phare pour le codage à long horizon, le travail de connaissance, le raisonnement et la compréhension visuelle native | Niveau GPT-5.6 phare pour le travail professionnel complexe | Niveau GPT-5.6 conçu pour équilibrer intelligence et coût |
| Fenêtre de contexte | Jusqu’à 1 M de jetons | 1,05 M de jetons | 1,05 M de jetons |
| Contrôles du raisonnement | Toujours activé ; low, high ou max ; valeur par défaut : max |
none, low, medium, high, xhigh ou max ; valeur par défaut : medium |
Mêmes choix d’effort de raisonnement documentés que Sol |
| Prix catalogue direct des entrées | 3,00 $ / 1 M de jetons non mis en cache | 4,00 $ / 1 M de jetons | 2,00 $ / 1 M de jetons |
| Prix catalogue direct des entrées mises en cache | 0,30 $ / 1 M de jetons | 0,40 $ / 1 M de jetons | 0,20 $ / 1 M de jetons |
| Prix catalogue direct des sorties | 15,00 $ / 1 M de jetons | 20,00 $ / 1 M de jetons | 12,00 $ / 1 M de jetons |
| Question d’outillage à tester | Comportement propre à Kimi pour les requêtes, la réflexion, la vision et les appels d’outils sur le point de terminaison choisi | Fonctionnalités OpenAI Responses et outils hébergés nécessaires à votre produit | Même surface d’intégration, avec un candidat GPT-5.6 moins cher |
Les chiffres pour Kimi proviennent des pages actuelles de la plateforme et de facturation de Moonshot. Les chiffres pour GPT proviennent des pages de modèles individuelles d’OpenAI. Il s’agit de prix de référence directs des fournisseurs, vérifiés le 22 octobre 2026 — et non d’un devis valable pour chaque passerelle, région, promotion, appel d’outil, traitement fiscal ou accord d’entreprise.
Pour Kimi K3 vs GPT 5.6 Sol, les chiffres de contexte principaux sont suffisamment proches pour que « un million de jetons » ne décide pas à lui seul du résultat. Les questions importantes sont de savoir si vos jeux de tests à contexte long conservent les faits qui comptent, si la sortie reste utilisable et combien coûte la requête complète après prise en compte de la mise en cache et des jetons de sortie.
Comparaison des prix : utilisez une charge de travail, pas un prix affiché
Les prix des jetons sont des données d’entrée pour un modèle de coût, et non le résultat de la sélection du modèle. Une estimation simple est la suivante :
coût estimé de la requête =
  (jetons d’entrée non mis en cache × tarif des entrées non mises en cache) +
  (jetons d’entrée mis en cache × tarif des entrées mises en cache) +
  (jetons de sortie × tarif des sorties)
Voici le calcul aux prix directs pour deux charges de travail volontairement simples. Il exclut les taxes, les tarifs des passerelles, les frais d’appel d’outils et toute majoration liée au contexte long.
| Exemple de charge de travail | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| 1 M d’entrées non mises en cache + 250 k de sorties | 6,75 $ | 9,00 $ | 5,00 $ |
| 1 M d’entrées mises en cache + 250 k de sorties | 4,05 $ | 5,40 $ | 3,20 $ |
Ces calculs montrent pourquoi Kimi K3 vs GPT 5.6 Sol n’est pas une comparaison de coûts à une seule dimension. Le tarif catalogue publié de Kimi est inférieur à celui de Sol dans cet exemple, tandis que Terra est encore moins cher. Mais un appel moins cher qui nécessite des tentatives supplémentaires, produit davantage de travail de revue manuelle ou ne respecte pas un contrat d’outil n’est pas automatiquement moins cher par tâche acceptée.
Il existe une autre particularité liée aux longs contextes. OpenAI documente un multiplicateur de prix pour les prompts GPT-5.6 Sol et Terra dépassant 272K tokens d’entrée : 2× pour l’entrée et 1,5× pour la sortie sur l’ensemble de la requête. Le guide de facturation K3 de Kimi indique que le prix de K3 n’est pas échelonné par tranche de longueur de contexte. Incluez un cas réel de document long dans votre jeu de tests et consignez l’utilisation visible sur la facture ; n’extrapolez pas à partir d’un prompt court.
Pour une méthode plus large, consultez notre guide sur la comparaison des prix des modèles d’IA avant de changer de fournisseur.
Les paramètres de raisonnement ne sont pas interchangeables
Kimi K3 s’exécute toujours en mode réflexion. Ses valeurs documentées de reasoning_effort sont low, high et max, max étant la valeur par défaut. GPT-5.6 Sol et GPT-5.6 Terra documentent une échelle plus large comprenant none, low, medium, high, xhigh et max, avec medium comme valeur par défaut.
Cela rend les tests valeur par défaut contre valeur par défaut trompeurs. Une expérience équitable Kimi K3 vs GPT 5.6 Sol doit définir un niveau partagé compatible, tel que high là où la route le permet, puis exécuter une comparaison distincte orientée budget en utilisant les valeurs par défaut documentées par les fournisseurs. Conservez ces résultats dans des lignes séparées — sinon, vous mélangez le choix du modèle avec celui du budget de raisonnement.
Gardez également les paramètres spécifiques au fournisseur hors de la première référence inter-modèles. La documentation de Kimi met en avant son propre comportement K3 ; l’API Responses d’OpenAI offre un éventail plus large d’outils hébergés. Commencez par une tâche structurée simple et n’ajoutez les cas d’utilisation d’outils, de vision et multimodaux qu’une fois le contrat de base requête/réponse validé.
Outils, API et compatibilité avec la migration
Les deux fournisseurs proposent des interfaces développeur familières, mais « compatible OpenAI » doit être considéré comme un point de départ, et non comme la promesse que chaque champ et événement diffusé en continu soit identique.
OpenAI documente l’accès via Chat Completions et Responses pour GPT-5.6 Sol, ainsi que l’appel de fonctions, les sorties structurées et de nombreux outils de l’API Responses tels que la recherche web, la recherche de fichiers, la génération d’images, l’interpréteur de code, le shell hébergé, l’utilisation d’ordinateur, MCP et la recherche d’outils. Cela peut simplifier un workflow qui dépend déjà de ces capacités hébergées par OpenAI.
Kimi documente kimi-k3 pour le codage à long horizon et le travail de connaissance, et ses documents officiels décrivent des intégrations compatibles OpenAI et orientées Responses. La réflexion toujours active de K3, ses niveaux de raisonnement autorisés et les détails de ses appels de vision ou d’outils méritent des tests de bon fonctionnement spécifiques à la route avant de migrer un agent doté d’un historique de messages complexe.
Si vous évaluez déjà K3, consultez le guide d’accès à l’API Kimi K3 pour les notes sur son ID de modèle, ses paramètres et sa configuration directe chez le fournisseur. Si vous devez conserver un seul client tout en alternant les candidats, utilisez une URL de base compatible OpenAI pour tester des prompts sur plusieurs modèles et conservez l’ID exact du modèle de chaque candidat dans vos journaux.
Plan d’évaluation sur 48 heures de Kimi K3 vs GPT 5.6 Sol
Ne lancez pas un seul prompt astucieux en qualifiant le résultat de benchmark. Utilisez un ensemble de cas de test réduit mais représentatif.
- Épinglez les candidats. Commencez avec
kimi-k3,gpt-5.6-soletgpt-5.6-terra. Consignez la date, le point de terminaison, la version du SDK, l’ID du modèle et le paramètre de raisonnement pour chaque requête. - Choisissez 20 à 50 tâches réelles. Incluez les modifications de code, documents, schémas, appels d’outils, images et cas d’échec que vos utilisateurs génèrent réellement. Masquez les données sensibles avant de les envoyer où que ce soit.
- Définissez les critères d’acceptation avant l’exécution. Exemples : les tests réussissent, le JSON est valide, les champs cités sont présents, un réviseur humain accepte le résultat ou un agent termine la tâche sans nouvelle tentative non sûre.
- Capturez l’ensemble des données opérationnelles. Stockez les nombres de tokens d’entrée, d’entrée mise en cache, de sortie et de tentatives supplémentaires ; la latence ; les erreurs HTTP ou d’outil ; le résultat d’acceptation ; et le temps de revue. Ajoutez le comportement face aux limites de débit pour un trafic soutenu à l’aide d’une checklist de planification des limites de débit des LLM.
- Évaluez le coût par résultat accepté. Divisez la dépense totale pour chaque candidat par le nombre de tâches acceptées, et non par le nombre brut d’appels. Conservez les coûts des échecs et des tentatives supplémentaires dans le numérateur.
- Déployez avec une solution de repli. Acheminez un petit pourcentage du travail éligible vers le candidat choisi, conservez une solution de repli testée et déclenchez des alertes en cas de régressions de qualité, de latence et de coût.
Utilisez une fiche d’évaluation concise afin qu’une équipe puisse réexaminer la décision lorsqu’un modèle ou un prix change :
| Métrique | Pourquoi c’est important | Exemple de règle d’acceptation |
|---|---|---|
| Taux de réussite des tâches | Mesure la qualité visible par l’utilisateur | Les tests réussissent ou le réviseur approuve |
| Coût par tâche acceptée | Inclut les nouvelles tentatives et le volume de sortie | Rester dans le budget de la charge de travail |
| Latence P95 | Mesure l’expérience en queue de distribution | Respecter le SLA de l’interaction ou de la tâche |
| Validité des sorties structurées | Indique la fiabilité du contrat d’API | Le schéma est validé sans correction |
| Exécution d’outil ou d’agent | Teste le comportement réel du flux de travail | Les outils requis s’exécutent avec le bon transfert |
| Récupération par repli | Protège la disponibilité en production | La nouvelle tentative ou le repli se termine en toute sécurité |
Testez la même requête via une seule couche de routage
L’utilisation du même client pour tous les candidats élimine une source de biais de comparaison accidentel. Le guide de démarrage rapide public de Flatkey documente une clé unique et une URL de base https://router.flatkey.ai/v1 compatible avec OpenAI, tandis que ses métadonnées tarifaires publiques indiquaient que kimi-k3, gpt-5.6-sol et gpt-5.6-terra étaient disponibles lors de la vérification de cet article. La disponibilité et la prise en charge des champs peuvent évoluer ; vérifiez donc le contrat du modèle avant un déploiement en production.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

for model in ("kimi-k3", "gpt-5.6-sol", "gpt-5.6-terra"):
    response = client.chat.completions.create(
        model=model,
        reasoning_effort="high",  # a shared supported baseline to test first
        messages=[
            {"role": "user", "content": "Solve the evaluation fixture and return valid JSON."}
        ],
    )
    print(model, response.choices[0].message.content)
Utilisez cet extrait comme point de départ pour l’évaluation, et non comme contrat de production. Vérifiez en particulier les champs propres à Kimi, le comportement des outils, les événements de streaming, les paramètres de sécurité et le schéma de sortie sur le point de terminaison exact que vous choisissez. Après chaque exécution, examinez l’utilisation et les résultats au niveau de la requête plutôt que de supposer qu’un alias, une promotion ou une fiche de modèle restera inchangé.
Quel modèle devriez-vous tester en premier ?
Commencez Kimi K3 vs GPT 5.6 Sol par Kimi K3 si votre tâche critique concerne le codage ou le travail de connaissance sur un horizon long, si vous souhaitez utiliser la compréhension visuelle native documentée de K3 et si vous êtes à l’aise avec la validation de ses capacités de raisonnement et de son comportement de requête spécifiques à K3.
Commencez par GPT-5.6 Sol si le flux de travail dépend fortement des outils actuels de l’API Responses d’OpenAI, ou si les contrôles reasoning_effort plus étendus font partie de la conception de votre produit. Ajoutez GPT-5.6 Terra lorsque la même famille d’API et un tarif direct par jeton inférieur sont plus importants que l’utilisation de l’offre phare.
La bonne réponse pour la production peut être « les trois » : une route phare pour les tâches difficiles, une route à moindre coût pour le travail répétable et un repli testé. Une passerelle d’API IA est particulièrement utile lorsqu’elle vous aide à appliquer cette politique sans disperser les clés des fournisseurs et les règles de routage propres aux modèles dans le code produit.
Questions fréquentes
Kimi K3 est-il moins cher que GPT-5.6 Sol ?
Selon les prix catalogue directs vérifiés pour cet article, Kimi K3 est moins cher pour les entrées non mises en cache, les entrées mises en cache et les sorties que GPT-5.6 Sol. Cela ne prouve pas qu’il présente le coût le plus faible par tâche acceptée. Comparez les nouvelles tentatives, la longueur des sorties, les règles tarifaires relatives aux contextes longs, les frais liés aux outils, les prix des passerelles et le travail de révision humaine sur vos propres jeux de test.
GPT-5.6 Terra est-il une meilleure comparaison que GPT-5.6 Sol ?
C’est une comparaison complémentaire utile lorsque la sensibilité au coût fait partie de la décision. Terra dispose de la même fenêtre de contexte documentée de 1,05 million de jetons et de tarifs catalogue directs inférieurs à ceux de Sol, tandis que Sol est l’offre phare GPT-5.6 d’OpenAI. Incluez les deux lorsque vous devez dissocier une décision relative à une famille de modèles d’une décision relative à un niveau de prix.
Puis-je utiliser Kimi K3 et GPT-5.6 Sol avec le même client OpenAI ?
Vous pouvez utiliser un client de type OpenAI avec un fournisseur ou une couche de routage compatible, mais vous devez valider le point de terminaison et les champs exacts. La compatibilité des modèles ne rend pas identiques les paramètres de raisonnement, les événements d’outils, les entrées visuelles, les limites de débit ou le comportement des sorties structurées.
Une fenêtre de contexte plus grande signifie-t-elle qu’un modèle est meilleur pour ma base de code ?
Non. La capacité de contexte ne garantit ni la récupération d’informations, ni le raisonnement, ni la qualité des sorties, ni la latence, ni une facture maîtrisable. Placez un jeu de test représentatif de dépôt ou de document dans l’évaluation et évaluez le résultat accepté, et non le nombre de jetons de contexte annoncé.
Recommandation finale
Le résultat utile d’une comparaison Kimi K3 vs GPT 5.6 Sol est une règle de routage que vous pouvez expliquer : quel candidat traite quelle tâche, à quel niveau de raisonnement, dans quelles limites de latence et de coût, et avec quel repli. Utilisez les chiffres de prix et de contexte publiés pour élaborer le plan de test ; utilisez vos propres données d’acceptation pour choisir la valeur par défaut en production.
Sources
- Sélection du modèle d’API Kimi
- Plateforme d’API Kimi et grille tarifaire actuelle de K3
- Guide de facturation de l’API Kimi
- Guide d’intégration des réponses de Kimi Open Platform
- Documentation du modèle OpenAI GPT-5.6 Sol
- Documentation du modèle OpenAI GPT-5.6 Terra
- Documentation d’OpenAI GPT-5 et de sa dépréciation
- Dépréciations des modèles OpenAI
- Guide de démarrage rapide de Flatkey