Kimi K3 vs GPT 5.6 Sol: precios, contexto y qué API probar
Si está comparando Kimi K3 vs GPT 5.6 Sol, no empiece con una captura de pantalla de una clasificación. Empiece por elegir los ID exactos de los modelos, normalizar el esfuerzo de razonamiento y medir el costo por resultado aceptado en sus propias tareas.
Ambos modelos están diseñados para trabajo agéntico y de contexto largo. La documentación actual de la API de Kimi presenta kimi-k3 como su modelo insignia para programación de largo alcance, trabajo de conocimiento, comprensión visual nativa y razonamiento profundo. OpenAI presenta gpt-5.6-sol como el nivel insignia de la familia GPT-5.6 para trabajo profesional complejo. La diferencia práctica no es simplemente «¿qué modelo es más inteligente?». Es qué ruta proporciona a su producto la calidad, el comportamiento de herramientas, la latencia y la factura adecuados para una carga de trabajo específica.
Esta guía compara Kimi K3 vs GPT 5.6 Sol utilizando la documentación actual de los proveedores y, a continuación, le ofrece un plan reproducible de evaluación de API. También incluye GPT-5.6 Terra, la opción GPT-5.6 de menor costo, porque a menudo es la referencia más útil para una decisión de enrutamiento en producción.
Respuesta corta: Pruebe Kimi K3 cuando la programación de contexto largo, el razonamiento siempre activo y el flujo de trabajo de visión nativa de Kimi se ajusten a su producto. Pruebe GPT-5.6 Sol cuando necesite la superficie de herramientas de OpenAI y un nivel insignia de razonamiento configurable. Mantenga GPT-5.6 Terra en el conjunto de pruebas cuando el costo unitario importe. No declare un ganador antes de ejecutar los mismos casos de prueba en cada ruta.
Qué significa «GPT-5» en esta comparación
«GPT-5» es un término de búsqueda ambiguo en octubre de 2026. La página de modelos GPT-5 de OpenAI describe GPT-5 como un modelo anterior y obsoleto, mientras que sus indicaciones actuales sobre descontinuación dirigen varias instantáneas anteriores de GPT-5 a la familia GPT-5.6. En este artículo, Kimi K3 vs GPT 5.6 Sol se refiere a los ID de modelos públicos actuales kimi-k3 y gpt-5.6-sol, no a un alias heredado de GPT-5 no especificado.
Si su aplicación está fijada a una instantánea anterior de gpt-5-*, trátelo primero como un proyecto de migración. Fije el reemplazo preciso, actualice sus pruebas y confirme la fecha de cierre del proveedor antes de comparar la calidad de los modelos.
Kimi K3 vs GPT 5.6 Sol de un vistazo
| Factor de decisión | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| ID de modelo de API | kimi-k3 |
gpt-5.6-sol |
gpt-5.6-terra |
| Posicionamiento del proveedor | Modelo insignia para programación de largo alcance, trabajo de conocimiento, razonamiento y comprensión visual nativa | Nivel insignia de GPT-5.6 para trabajo profesional complejo | Nivel GPT-5.6 diseñado para equilibrar inteligencia y costo |
| Ventana de contexto | Hasta 1 millón de tokens | 1,05 millones de tokens | 1,05 millones de tokens |
| Controles de razonamiento | Siempre activado; low, high o max; valor predeterminado: max |
none, low, medium, high, xhigh o max; valor predeterminado: medium |
Las mismas opciones documentadas de esfuerzo de razonamiento que Sol |
| Precio de lista directo para entrada | 3,00 USD / 1 millón de tokens sin caché | 4,00 USD / 1 millón de tokens | 2,00 USD / 1 millón de tokens |
| Precio de lista directo para entrada en caché | 0,30 USD / 1 millón de tokens | 0,40 USD / 1 millón de tokens | 0,20 USD / 1 millón de tokens |
| Precio de lista directo para salida | 15,00 USD / 1 millón de tokens | 20,00 USD / 1 millón de tokens | 12,00 USD / 1 millón de tokens |
| Pregunta sobre herramientas que se debe probar | Comportamiento específico de Kimi para solicitudes, razonamiento, visión y llamadas a herramientas en el endpoint elegido | Funciones de OpenAI Responses y herramientas alojadas que necesita su producto | La misma superficie de integración, con un candidato GPT-5.6 de menor precio |
Las cifras de Kimi proceden de las páginas actuales de plataforma y facturación de Moonshot. Las cifras de GPT proceden de las páginas individuales de modelos de OpenAI. Son precios de referencia de proveedores directos, verificados el 22 de octubre de 2026, no una cotización para cada gateway, región, promoción, llamada a herramienta, tratamiento fiscal o acuerdo empresarial.
Para Kimi K3 vs GPT 5.6 Sol, las cifras principales de contexto son lo suficientemente cercanas como para que «un millón de tokens» no deba decidir por sí solo el resultado. Las preguntas relevantes son si sus casos de prueba de contexto largo conservan los hechos importantes, si la salida sigue siendo utilizable y cuánto cuesta la solicitud completa después de la caché y los tokens de salida.
Comparación de precios: use una carga de trabajo, no un precio de etiqueta
Los precios de los tokens son datos de entrada para un modelo de costos, no el resultado de la selección del modelo. Una estimación sencilla es:
costo estimado de la solicitud =
  (tokens de entrada sin caché × tarifa de entrada sin caché) +
  (tokens de entrada en caché × tarifa de entrada en caché) +
  (tokens de salida × tarifa de salida)
A continuación se muestra el cálculo de precios directos para dos cargas de trabajo deliberadamente simples. Excluye impuestos, precios de gateway, cargos por llamadas a herramientas y cualquier prima por contexto largo.
| Ejemplo de carga de trabajo | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| 1 millón de entrada sin caché + 250 mil de salida | 6,75 USD | 9,00 USD | 5,00 USD |
| 1 millón de entrada en caché + 250 mil de salida | 4,05 USD | 5,40 USD | 3,20 USD |
Estos cálculos muestran por qué Kimi K3 vs GPT 5.6 Sol no es una comparación de costes unidimensional. La tarifa de lista publicada de Kimi es inferior a la de Sol en este ejemplo, mientras que Terra es aún más barata. Pero una llamada más barata que necesita reintentos, genera más trabajo de revisión manual o incumple un contrato de herramientas no es automáticamente más barata por tarea aceptada.
Hay otro matiz relacionado con el contexto largo. OpenAI documenta un multiplicador de precio para los prompts de GPT-5.6 Sol y Terra que superen los 272K tokens de entrada: 2× para la entrada y 1,5× para la salida en toda la solicitud. La guía de facturación de K3 de Kimi indica que el precio de K3 no está escalonado por rango de longitud de contexto. Incluya un caso real de documento largo en su conjunto de pruebas y registre el uso visible en la factura; no extrapole a partir de un prompt corto.
Para un método más amplio, consulte nuestra guía sobre cómo comparar los precios de modelos de IA antes de cambiar de proveedor.
Las configuraciones de razonamiento no son intercambiables
Kimi K3 siempre se ejecuta en modo de pensamiento. Sus valores documentados de reasoning_effort son low, high y max, siendo max el valor predeterminado. GPT-5.6 Sol y GPT-5.6 Terra documentan una escala más amplia que incluye none, low, medium, high, xhigh y max, siendo medium el valor predeterminado.
Esto hace que las pruebas de valor predeterminado frente a valor predeterminado sean engañosas. Un experimento justo de Kimi K3 vs GPT 5.6 Sol debería establecer un nivel compartido compatible, como high, cuando la ruta lo admita, y luego ejecutar una comparación independiente orientada al presupuesto utilizando los valores predeterminados documentados de los proveedores. Mantenga esos resultados en filas separadas; de lo contrario, estará mezclando la elección del modelo con la elección del presupuesto de razonamiento.
También mantenga los parámetros específicos del proveedor fuera de la primera línea base entre modelos. La documentación de Kimi destaca su propio comportamiento de K3; la API Responses de OpenAI ofrece una superficie más amplia de herramientas alojadas. Empiece con una tarea estructurada sencilla y añada casos de herramientas, visión y multimodales solo después de que el contrato básico de solicitud/respuesta funcione correctamente.
Herramientas, API y adecuación para la migración
Ambos proveedores ofrecen interfaces conocidas para desarrolladores, pero «compatible con OpenAI» debe tratarse como un punto de partida, no como una promesa de que todos los campos y eventos transmitidos sean idénticos.
OpenAI documenta acceso mediante Chat Completions y Responses para GPT-5.6 Sol, junto con llamadas a funciones, salidas estructuradas y numerosas herramientas de la API Responses, como búsqueda web, búsqueda de archivos, generación de imágenes, intérprete de código, shell alojada, uso de computadora, MCP y búsqueda de herramientas. Esto puede simplificar un flujo de trabajo que ya depende de esas capacidades alojadas por OpenAI.
Kimi documenta kimi-k3 para programación de largo alcance y trabajo de conocimiento, y su material oficial describe integraciones compatibles con OpenAI y orientadas a Responses. El pensamiento siempre activo de K3, sus niveles de razonamiento permitidos y los detalles de sus llamadas de visión o herramientas merecen pruebas de humo específicas por ruta antes de migrar un agente con un historial de mensajes complejo.
Si ya está evaluando K3, lea la guía de acceso a la API de Kimi K3 para consultar sus notas sobre ID de modelo, parámetros y configuración con proveedor directo. Si necesita mantener un cliente mientras rota candidatos, utilice una URL base compatible con OpenAI para pruebas de prompts con varios modelos y conserve el ID exacto del modelo de cada candidato en sus registros.
Plan de evaluación de 48 horas para Kimi K3 vs GPT 5.6 Sol
No ejecute un único prompt ingenioso y considere el resultado un benchmark. Utilice un conjunto pequeño pero representativo de casos de prueba.
- Fije los candidatos. Empiece con
kimi-k3,gpt-5.6-solygpt-5.6-terra. Registre la fecha, el endpoint, la versión del SDK, el ID del modelo y la configuración de razonamiento para cada solicitud. - Elija entre 20 y 50 tareas reales. Incluya los cambios de código, documentos, esquemas, llamadas a herramientas, imágenes y casos de fallo que sus usuarios generan realmente. Oculte los datos sensibles antes de enviarlos a cualquier lugar.
- Defina la aceptación antes de ejecutar. Algunos ejemplos: las pruebas se superan, el JSON se valida, los campos citados están presentes, un revisor humano acepta el resultado o un agente completa la tarea sin un reintento inseguro.
- Capture el registro operativo completo. Almacene los recuentos de tokens de entrada, entrada en caché, salida y reintentos; la latencia; los errores HTTP o de herramientas; el resultado de aceptación; y el tiempo del revisor. Añada el comportamiento ante límites de tasa para tráfico sostenido mediante una lista de verificación de planificación de límites de tasa de LLM.
- Puntúe el coste por resultado aceptado. Divida el gasto total de cada candidato por las tareas aceptadas, no por las llamadas sin procesar. Mantenga los costes de fallos y reintentos en el numerador.
- Implemente con una alternativa de respaldo. Dirija un pequeño porcentaje del trabajo elegible al candidato elegido, mantenga una alternativa de respaldo probada y configure alertas para regresiones de calidad, latencia y coste.
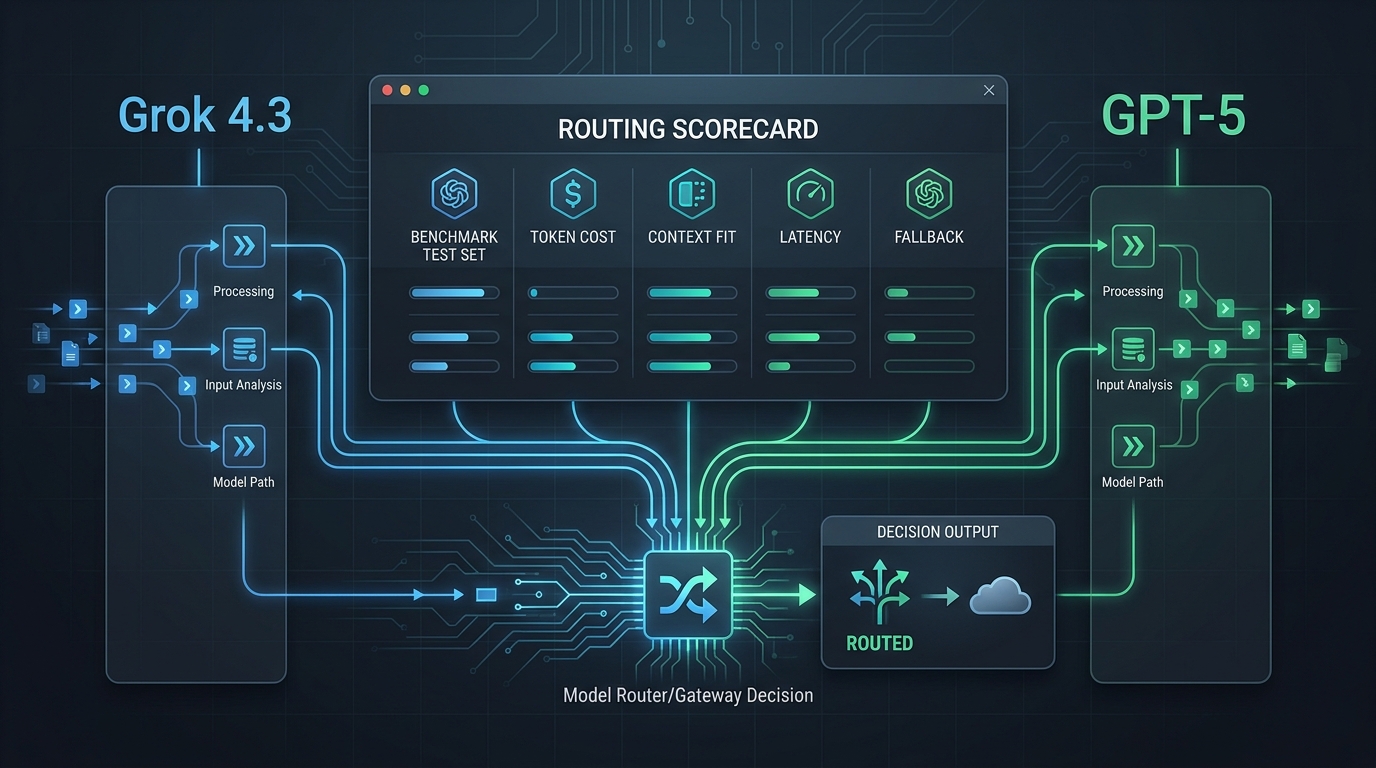
Utilice una tarjeta de puntuación compacta para que un equipo pueda revisar la decisión cuando cambie un modelo o un precio:
| Métrica | Por qué importa | Regla de aceptación de ejemplo |
|---|---|---|
| Tasa de aprobación de tareas | Captura la calidad visible para el usuario | Las pruebas se superan o el revisor aprueba |
| Coste por tarea aceptada | Incluye reintentos y volumen de salida | Mantenerse dentro del presupuesto de la carga de trabajo |
| Latencia P95 | Captura la experiencia en la cola | Cumplir el SLA de la interacción o del trabajo |
| Validez de salida estructurada | Muestra la fiabilidad del contrato de la API | El esquema se valida sin reparación |
| Finalización de herramientas o agentes | Prueba el comportamiento real del flujo de trabajo | Las herramientas requeridas se completan con la transferencia correcta |
| Recuperación mediante alternativa | Protege la disponibilidad en producción | El reintento o la alternativa se completa de forma segura |
Pruebe la misma solicitud a través de una única capa de enrutamiento
Usar el mismo cliente para todos los candidatos elimina una fuente de sesgo de comparación accidental. La guía de inicio rápido pública de Flatkey documenta una clave y una URL base compatible con OpenAI: https://router.flatkey.ai/v1, mientras que sus metadatos públicos de precios incluían kimi-k3, gpt-5.6-sol y gpt-5.6-terra como disponibles cuando se revisó este artículo. La disponibilidad y la compatibilidad de campos pueden cambiar, así que verifique el contrato del modelo antes de un despliegue en producción.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

for model in ("kimi-k3", "gpt-5.6-sol", "gpt-5.6-terra"):
    response = client.chat.completions.create(
        model=model,
        reasoning_effort="high",  # a shared supported baseline to test first
        messages=[
            {"role": "user", "content": "Solve the evaluation fixture and return valid JSON."}
        ],
    )
    print(model, response.choices[0].message.content)
Use ese fragmento como punto de partida para la evaluación, no como contrato de producción. En particular, confirme los campos específicos de Kimi, el comportamiento de las herramientas, los eventos de streaming, la configuración de seguridad y el esquema de salida en el endpoint exacto que elija. Después de cada ejecución, inspeccione el uso y los resultados a nivel de solicitud en lugar de asumir que un alias, una promoción o una tarjeta de modelo permanecerán sin cambios.
¿Qué modelo debería probar primero?
Empiece Kimi K3 vs GPT 5.6 Sol con Kimi K3 si su tarea crítica es la programación o el trabajo de conocimiento de largo alcance, desea la comprensión visual nativa documentada de K3 y se siente cómodo validando su razonamiento y comportamiento de solicitudes específicos de K3.
Empiece con GPT-5.6 Sol si el flujo de trabajo depende en gran medida de las herramientas actuales de la API Responses de OpenAI, o si los controles más amplios de reasoning_effort forman parte del diseño de su producto. Añada GPT-5.6 Terra cuando la misma familia de API y una tarifa directa por token más baja sean más importantes que usar el nivel insignia.
La respuesta correcta para producción puede ser «los tres»: una ruta insignia para las tareas difíciles, una ruta de menor coste para el trabajo repetible y una alternativa probada. Una pasarela de API de IA es más útil cuando le ayuda a aplicar esa política sin dispersar claves de proveedores y reglas de enrutamiento específicas de cada modelo por el código del producto.
Preguntas frecuentes
¿Es Kimi K3 más barato que GPT-5.6 Sol?
Según los precios directos de lista revisados para este artículo, Kimi K3 es más económico para la entrada sin caché, la entrada en caché y la salida que GPT-5.6 Sol. Eso no demuestra que tenga el menor coste por tarea aceptada. Compare los reintentos, la longitud de salida, las reglas de precios para contexto largo, los cargos por herramientas, los precios de la pasarela y el trabajo de revisión humana con sus propios casos de prueba.
¿Es GPT-5.6 Terra una comparación mejor que GPT-5.6 Sol?
Es una comparación adicional útil cuando la sensibilidad al coste forma parte de la decisión. Terra tiene la misma ventana de contexto documentada de 1,05 millones de tokens y tarifas directas de lista más bajas que Sol, mientras que Sol es el nivel insignia GPT-5.6 de OpenAI. Incluya ambos cuando necesite separar una decisión sobre la familia de modelos de una decisión sobre el nivel de precios.
¿Puedo usar Kimi K3 y GPT-5.6 Sol con el mismo cliente de OpenAI?
Puede usar un cliente de estilo OpenAI con un proveedor o una capa de enrutamiento compatibles, pero debe validar el endpoint y los campos exactos. La compatibilidad del modelo no hace que los parámetros de razonamiento, los eventos de herramientas, las entradas visuales, los límites de tasa o el comportamiento de salida estructurada sean idénticos.
¿Una ventana de contexto más grande significa que un modelo es mejor para mi base de código?
No. La capacidad de contexto no garantiza la recuperación, el razonamiento, la calidad de salida, la latencia ni una factura manejable. Incluya un repositorio o caso de prueba documental representativo en la evaluación y puntúe el resultado aceptado, no la cifra de contexto anunciada.
Recomendación final
El resultado útil de una comparación de Kimi K3 vs GPT 5.6 Sol es una regla de enrutamiento que pueda explicar: qué candidato se encarga de cada tarea, con qué nivel de razonamiento, dentro de qué límites de latencia y coste, y con qué alternativa. Use las cifras publicadas de precio y contexto para elaborar el plan de pruebas; use sus propios datos de aceptación para elegir la opción predeterminada de producción.
Fuentes
- Selección de modelos de la API de Kimi
- Plataforma de la API de Kimi y lista de precios actual de K3
- Guía de facturación de la API de Kimi
- Guía de integración de Responses de la plataforma abierta de Kimi
- Documentación del modelo GPT-5.6 Sol de OpenAI
- Documentación del modelo GPT-5.6 Terra de OpenAI
- Documentación de OpenAI GPT-5 y deprecación
- Deprecaciones de modelos de OpenAI
- Guía de inicio rápido de Flatkey