Kimi K3 与 GPT 5.6 Sol 对比:定价、上下文与该测试哪个 API
如果您正在比较 Kimi K3 与 GPT 5.6 Sol,不要从排行榜截图开始。请先选择确切的模型 ID,统一推理强度,并在您自己的任务上衡量每个被接受结果的成本。
两种模型均为长上下文、智能体工作而构建。Kimi 当前的 API 文档将 kimi-k3 定位为其面向长周期编程、知识工作、原生视觉理解和深度推理的旗舰模型。OpenAI 将 gpt-5.6-sol 定位为 GPT-5.6 系列中用于复杂专业工作的旗舰层级。实际差异并不只是“哪个模型更聪明?”而是:对于特定工作负载,哪条路线能为您的产品提供合适的质量、工具行为、延迟和费用。
本指南依据供应商当前文档比较 Kimi K3 与 GPT 5.6 Sol,随后为您提供可复现的 API 评估计划。它还纳入了成本更低的 GPT-5.6 选项 GPT-5.6 Terra,因为在生产路由决策中,它通常是更有用的基线。
简短回答:当长上下文编程、始终开启的推理以及 Kimi 的原生视觉工作流符合您的产品需求时,测试 Kimi K3。当您需要 OpenAI 工具功能集和可配置的旗舰推理层级时,测试 GPT-5.6 Sol。当单位成本很重要时,将 GPT-5.6 Terra 保留在测试集合中。在通过每条路线运行相同的测试夹具之前,不要宣布胜者。
本比较中“GPT-5”的含义
截至 2026 年 10 月,“GPT-5”是一个含义模糊的搜索词。OpenAI 的 GPT-5 模型页面将 GPT-5 描述为过去的、已弃用的模型,而其当前弃用指南则将多个较旧的 GPT-5 快照引导至 GPT-5.6 系列。在本文中,Kimi K3 与 GPT 5.6 Sol指当前公开的模型 ID kimi-k3 和 gpt-5.6-sol,而非未明确指定的旧版 GPT-5 别名。
如果您的应用固定使用较旧的 gpt-5-* 快照,请先将其视为一个迁移项目。确定精确的替代模型,更新您的测试,并在比较模型质量前确认供应商的下线日期。
Kimi K3 与 GPT 5.6 Sol 概览
| 决策因素 | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| API 模型 ID | kimi-k3 |
gpt-5.6-sol |
gpt-5.6-terra |
| 供应商定位 | 面向长周期编程、知识工作、推理和原生视觉理解的旗舰模型 | 面向复杂专业工作的旗舰 GPT-5.6 层级 | 旨在平衡智能与成本的 GPT-5.6 层级 |
| 上下文窗口 | 最高 100 万个 token | 105 万个 token | 105 万个 token |
| 推理控制 | 始终启用;low、high 或 max;默认值为 max |
none、low、medium、high、xhigh 或 max;默认值为 medium |
与 Sol 相同的已记录推理强度选项 |
| 直接标价输入价格 | $3.00 / 100 万个未缓存 token | $4.00 / 100 万个 token | $2.00 / 100 万个 token |
| 直接标价缓存输入价格 | $0.30 / 100 万个 token | $0.40 / 100 万个 token | $0.20 / 100 万个 token |
| 直接标价输出价格 | $15.00 / 100 万个 token | $20.00 / 100 万个 token | $12.00 / 100 万个 token |
| 需要测试的工具问题 | 在您选择的端点上,Kimi 特有的请求、思考、视觉和工具调用行为 | 您的产品所需的 OpenAI Responses 功能和托管工具 | 相同的集成表面,且提供价格更低的 GPT-5.6 候选模型 |
Kimi 数据来自 Moonshot 当前的平台和计费页面。GPT 数据来自 OpenAI 各个模型页面。这些是截至 2026 年 10 月 22 日核查的直接供应商参考价格,并非适用于每个网关、地区、促销活动、工具调用、税务处理或企业协议的报价。
对于 Kimi K3 与 GPT 5.6 Sol,标题中的上下文数字非常接近,因此“100 万个 token”本身不应决定结果。有意义的问题是:您的长上下文测试夹具是否能保留关键事实、输出是否仍然可用,以及计入缓存和输出 token 后完整请求的成本是多少。
价格比较:使用工作负载,而非标价
Token 价格是成本模型的输入,而不是模型选择的结果。一个简单的估算方法是:
估算请求成本 =
  (未缓存输入 token × 未缓存输入费率)+
  (缓存输入 token × 缓存输入费率)+
  (输出 token × 输出费率)
以下是两个刻意简化的工作负载按直接价格计算的结果。它不包括税费、网关定价、工具调用费用和任何长上下文溢价。
| 示例工作负载 | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| 100 万未缓存输入 + 25 万输出 | $6.75 | $9.00 | $5.00 |
| 100 万缓存输入 + 25 万输出 | $4.05 | $5.40 | $3.20 |
这些计算说明,Kimi K3 vs GPT 5.6 Sol 并不是一维的成本比较。在此示例中,Kimi 公布的标价低于 Sol,而 Terra 更低。但一次看似更便宜的调用,如果需要重试、带来更多人工审核工作,或未能满足工具契约要求,那么按已接受任务计算也不一定更便宜。
长上下文还存在另一个细节。OpenAI 说明,对于输入 token 超过 272K 的 GPT-5.6 Sol 和 Terra 提示,请求整体适用价格倍数:输入为 2×,输出为 1.5×。Kimi 的 K3 计费指南称,其 K3 价格不按上下文长度区间分级。请在测试集中加入真实的长文档案例,并记录账单中可见的用量;不要根据短提示进行外推。
如需了解更广泛的方法,请参阅我们的指南:更换提供商前如何比较 AI 模型价格。
推理设置不可互换
Kimi K3 始终以思考模式运行。其文档列出的 reasoning_effort 值为 low、high 和 max,默认值为 max。GPT-5.6 Sol 和 GPT-5.6 Terra 文档说明了一个更广的范围,包括 none、low、medium、high、xhigh 和 max,默认值为 medium。
这会使默认值对默认值的测试产生误导。公平的 Kimi K3 vs GPT 5.6 Sol 实验应在路由支持的情况下设置兼容的共享级别,例如 high,然后再使用各提供商文档中规定的默认值,进行单独的面向预算的比较。请将这些结果保存在不同的行中——否则你混合了模型选择和推理预算选择。
此外,在第一个跨模型基线测试中,不要加入提供商特定参数。Kimi 的文档重点说明了其自身的 K3 行为;OpenAI 的 Response API 则提供了更广泛的托管工具功能。先从简单的结构化任务开始,只有在基础请求/响应契约通过后,再添加工具、视觉和多模态案例。
工具、API 与迁移适配性
两家提供商都提供了开发者熟悉的接口,但“OpenAI-compatible”应被视为起点,而不是每个字段和流式事件都完全相同的承诺。
OpenAI 为 GPT-5.6 Sol 提供了 Chat Completions 和 Responses 访问,以及函数调用、结构化输出和众多 Responses API 工具,例如网页搜索、文件搜索、图像生成、代码解释器、托管 shell、计算机使用、MCP 和工具搜索。这可以简化已经依赖这些 OpenAI 托管能力的工作流。
Kimi 将 kimi-k3 定位用于长周期编程和知识工作,其官方材料描述了 OpenAI-compatible 和面向 Responses 的集成方式。对于要迁移具有复杂消息历史的智能体,K3 的始终启用思考模式、允许的推理级别,以及其视觉或工具调用细节,都值得先进行路由特定的冒烟测试。
如果你已经在评估 K3,请阅读Kimi K3 API 访问指南,了解其模型 ID、参数和直连提供商设置说明。如果需要在轮换候选模型的同时保留一个客户端,请使用用于多模型提示测试的 OpenAI-compatible base URL,并在日志中保留每个候选模型的准确模型 ID。
48 小时 Kimi K3 vs GPT 5.6 Sol 评估计划
不要只运行一个巧妙的提示,就把结果称为基准测试。请使用一组小规模但具有代表性的测试样本。
- 固定候选模型。从
kimi-k3、gpt-5.6-sol和gpt-5.6-terra开始。记录每个请求的日期、端点、SDK 版本、模型 ID 和推理设置。 - 选择 20–50 个真实任务。纳入用户实际生成的代码变更、文档、模式、工具调用、图像和失败案例。将敏感输入发送到任何地方之前,先进行脱敏处理。
- 在运行前定义验收标准。例如:测试通过、JSON 验证成功、包含已引用字段、人工审核者接受结果,或智能体无需进行不安全的重试即可完成任务。
- 捕获完整的运行记录。保存输入、缓存输入、输出和重试的 token 计数;延迟;HTTP 或工具错误;验收结果;以及审核者耗时。使用 LLM 速率限制规划清单,为持续流量补充速率限制行为记录。
- 按每个已接受结果评估成本。将每个候选模型的总支出除以已接受任务数,而不是原始调用次数。将失败和重试成本保留在分子中。
- 通过回退方案逐步发布。将一小部分符合条件的工作路由到选定候选模型,保留经过测试的回退方案,并针对质量、延迟和成本回归设置告警。
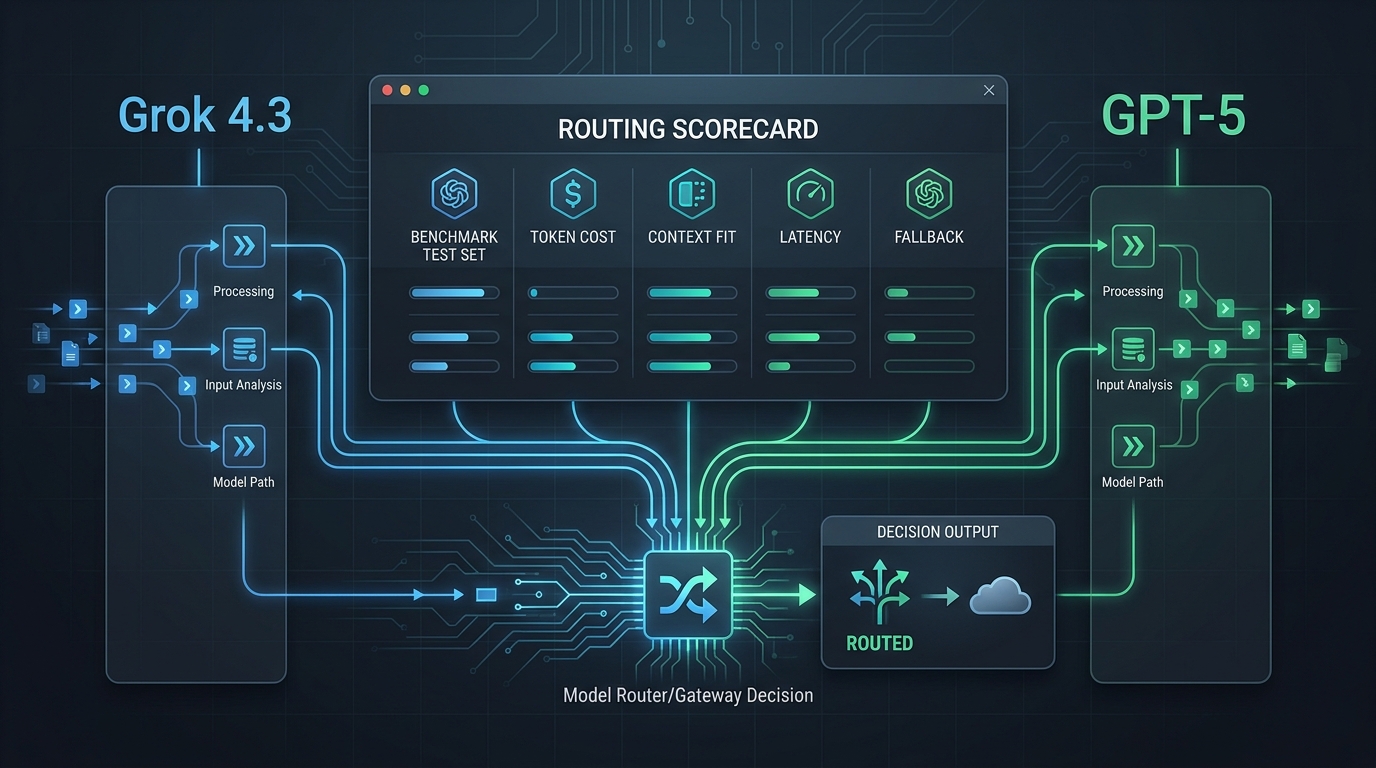
使用简明的评分卡,以便团队在模型或价格变化时重新审视该决策:
| 指标 | 重要原因 | 验收规则示例 |
|---|---|---|
| 任务通过率 | 衡量用户可见的质量 | 测试通过或审核人员批准 |
| 每个已验收任务的成本 | 包含重试和输出量 | 控制在工作负载预算内 |
| P95 延迟 | 衡量长尾体验 | 满足交互或作业 SLA |
| 结构化输出有效性 | 体现 API 合约可靠性 | Schema 无需修复即可验证通过 |
| 工具或智能体完成率 | 测试真实工作流行为 | 所需工具以正确的交接方式完成 |
| 回退恢复 | 保障生产环境可用性 | 重试或回退能够安全完成 |
通过同一路由层测试相同请求
对所有候选模型使用同一个客户端,可消除意外比较偏差的一个来源。Flatkey 的公开快速入门文档说明可使用一个密钥和 OpenAI 兼容的 https://router.flatkey.ai/v1 基础 URL;在查阅本文时,其公开定价元数据将 kimi-k3、gpt-5.6-sol 和 gpt-5.6-terra 列为可用模型。可用性和字段支持可能发生变化,因此在生产环境上线前请验证模型合约。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

for model in ("kimi-k3", "gpt-5.6-sol", "gpt-5.6-terra"):
    response = client.chat.completions.create(
        model=model,
        reasoning_effort="high",  # 首先测试的共同支持基线
        messages=[
            {"role": "user", "content": "Solve the evaluation fixture and return valid JSON."}
        ],
    )
    print(model, response.choices[0].message.content)
将该代码片段作为评估起点,而不是生产合约。尤其应确认在您选择的确切端点上,所有 Kimi 特定字段、工具行为、流式事件、安全设置和输出 schema。每次运行后,应检查请求级别的用量和结果,而不是假设别名、升级或模型卡会保持不变。
应先测试哪个模型?
如果您的关键任务是长周期编程或知识工作,希望使用 K3 已记录的原生视觉理解能力,并且能够接受验证其 K3 特定的推理和请求行为,请先在 Kimi K3 vs GPT 5.6 Sol 中测试 Kimi K3。
如果工作流高度依赖 OpenAI 当前的 Responses API 工具,或者更广泛的 reasoning_effort 控制是您产品设计的一部分,请先测试 GPT-5.6 Sol。当同一 API 系列和更低的直接 token 费率比使用旗舰层级更重要时,可加入 GPT-5.6 Terra。
正确的生产答案可能是“全部三个”:为困难任务设置旗舰路由,为可重复工作设置低成本路由,并配备经过测试的回退方案。当 AI API gateway 能帮助您实施这一策略,而无需将提供商密钥和模型特定路由规则分散到产品代码中时,它最具价值。
常见问题
Kimi K3 比 GPT-5.6 Sol 便宜吗?
根据本文核查的直接标价,Kimi K3 的未缓存输入、缓存输入和输出价格均低于 GPT-5.6 Sol。但这并不能证明其每个已验收任务的成本更低。请在您自己的测试样本上比较重试次数、输出长度、长上下文定价规则、工具费用、网关价格和人工审核工作量。
GPT-5.6 Terra 是否比 GPT-5.6 Sol 更适合作为对比对象?
当成本敏感性是决策的一部分时,它是一个有用的补充对比。Terra 拥有相同的、已记录的 105 万 token 上下文窗口,且直接标价低于 Sol;而 Sol 是 OpenAI 的旗舰 GPT-5.6 层级。当您需要将模型系列决策与价格层级决策区分开来时,应同时纳入两者。
我可以通过同一个 OpenAI 客户端使用 Kimi K3 和 GPT-5.6 Sol 吗?
您可以通过兼容的提供商或路由层使用 OpenAI 风格的客户端,但必须验证确切的端点和字段。模型兼容性并不意味着推理参数、工具事件、视觉输入、速率限制或结构化输出行为完全相同。
更大的上下文窗口是否意味着模型更适合我的代码库?
不是。上下文容量并不能保证检索、推理、输出质量、延迟或可控的账单。请将具有代表性的代码仓库或文档样本放入评估中,并对验收结果评分,而不是对宣传的上下文数字评分。
最终建议
Kimi K3 vs GPT 5.6 Sol 对比的有用结果,是一条您能够解释清楚的路由规则:哪个候选模型处理哪类任务、采用何种推理级别、遵守哪些延迟和成本护栏,以及使用何种回退方案。使用已发布的价格和上下文数据来制定测试计划;使用您自己的验收数据来选择生产环境默认模型。