Kimi K3 vs GPT 5.6 Sol: цены, контекст и какую API протестировать
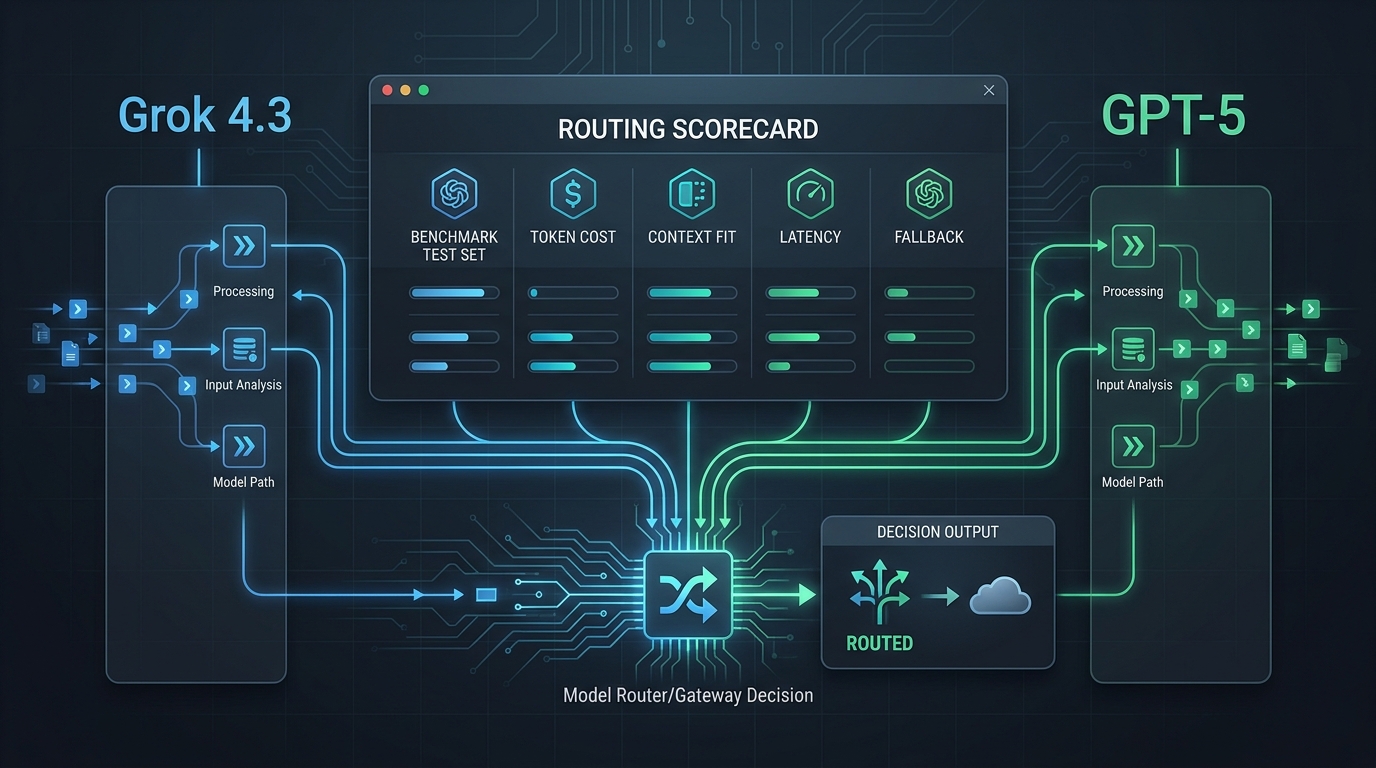
Если вы сравниваете Kimi K3 vs GPT 5.6 Sol, не начинайте со скриншота лидерборда. Начните с выбора точных идентификаторов моделей, нормализации усилий рассуждения и измерения стоимости каждого принятого результата на ваших собственных задачах.
Обе модели созданы для работы с длинным контекстом и агентных задач. В текущей документации API Kimi модель kimi-k3 позиционируется как флагманская для программирования с длинным горизонтом, работы со знаниями, нативного визуального понимания и глубокого рассуждения. OpenAI позиционирует gpt-5.6-sol как флагманский уровень семейства GPT-5.6 для сложной профессиональной работы. Практическая разница заключается не просто в вопросе «какая модель умнее?». Важно, какой вариант обеспечивает вашему продукту нужное качество, поведение инструментов, задержку и стоимость для конкретной нагрузки.
В этом руководстве сравниваются Kimi K3 vs GPT 5.6 Sol на основе текущей документации поставщиков, а затем приводится воспроизводимый план оценки API. Также рассматривается GPT-5.6 Terra — более доступный вариант GPT-5.6, поскольку именно он часто оказывается более полезной базовой моделью для решения о маршрутизации в production.
Краткий ответ: Тестируйте Kimi K3, если вашему продукту подходят программирование с длинным контекстом, постоянно включённое рассуждение и нативный рабочий процесс Kimi для зрения. Тестируйте GPT-5.6 Sol, если вам нужны набор инструментов OpenAI и настраиваемый флагманский уровень рассуждения. Оставьте GPT-5.6 Terra в наборе для тестирования, когда важна удельная стоимость. Не объявляйте победителя, пока не прогоните одни и те же тестовые наборы через каждый вариант.
Что означает «GPT-5» в этом сравнении
«GPT-5» — неоднозначный поисковый запрос в октябре 2026 года. На странице моделей GPT-5 от OpenAI GPT-5 описывается как предыдущая устаревшая модель, а текущие рекомендации по прекращению поддержки направляют несколько старых снимков GPT-5 к семейству GPT-5.6. В этой статье Kimi K3 vs GPT 5.6 Sol означает текущие публичные идентификаторы моделей kimi-k3 и gpt-5.6-sol, а не неопределённый устаревший псевдоним GPT-5.
Если ваше приложение закреплено за более старым снимком gpt-5-*, сначала рассматривайте это как проект миграции. Зафиксируйте точную замену, обновите тесты и подтвердите дату отключения у поставщика, прежде чем сравнивать качество моделей.
Kimi K3 vs GPT 5.6 Sol: краткий обзор
| Фактор выбора | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| Идентификатор модели API | kimi-k3 |
gpt-5.6-sol |
gpt-5.6-terra |
| Позиционирование поставщика | Флагман для программирования с длинным горизонтом, работы со знаниями, рассуждения и нативного визуального понимания | Флагманский уровень GPT-5.6 для сложной профессиональной работы | Уровень GPT-5.6, разработанный для баланса интеллектуальности и стоимости |
| Контекстное окно | До 1 млн токенов | 1,05 млн токенов | 1,05 млн токенов |
| Управление рассуждением | Всегда включено; low, high или max; по умолчанию max |
none, low, medium, high, xhigh или max; по умолчанию medium |
Те же документированные варианты усилий рассуждения, что и у Sol |
| Прямая прайс-листовая цена за вход | $3.00 / 1 млн некэшированных токенов | $4.00 / 1 млн токенов | $2.00 / 1 млн токенов |
| Прямая прайс-листовая цена за кэшированный вход | $0.30 / 1 млн токенов | $0.40 / 1 млн токенов | $0.20 / 1 млн токенов |
| Прямая прайс-листовая цена за выход | $15.00 / 1 млн токенов | $20.00 / 1 млн токенов | $12.00 / 1 млн токенов |
| Вопрос по инструментам для тестирования | Специфичное для Kimi поведение запросов, рассуждения, зрения и вызовов инструментов на выбранном вами endpoint | Функции OpenAI Responses и хостируемые инструменты, необходимые вашему продукту | Та же поверхность интеграции, но с более дешёвым кандидатом GPT-5.6 |
Данные по Kimi взяты с текущих страниц платформы и биллинга Moonshot. Данные по GPT взяты с индивидуальных страниц моделей OpenAI. Это справочные цены прямых поставщиков, проверенные 22 октября 2026 года, а не расценки для каждого шлюза, региона, акции, вызова инструмента, налогового режима или корпоративного соглашения.
Для Kimi K3 vs GPT 5.6 Sol ключевые показатели контекста достаточно близки, поэтому «один миллион токенов» сам по себе не должен определять результат. Важны следующие вопросы: сохраняют ли ваши тесты с длинным контекстом значимые факты, остаётся ли выходной результат пригодным к использованию и сколько стоит полный запрос с учётом кэширования и выходных токенов.
Сравнение цен: используйте нагрузку, а не цену на ценнике
Цены на токены — это входные данные для модели стоимости, а не результат выбора модели. Простая оценка выглядит так:
estimated request cost =
  (uncached input tokens × uncached-input rate) +
  (cached input tokens × cached-input rate) +
  (output tokens × output rate)
Ниже приведены расчёты по прямым ценам для двух намеренно простых нагрузок. Они не учитывают налоги, цены шлюзов, плату за вызовы инструментов и надбавки за длинный контекст.
| Пример нагрузки | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| 1 млн некэшированного входа + 250 тыс. выхода | $6.75 | $9.00 | $5.00 |
| 1 млн кэшированного входа + 250 тыс. выхода | $4.05 | $5.40 | $3.20 |
Эти расчёты показывают, почему Kimi K3 vs GPT 5.6 Sol — это не одномерное сравнение стоимости. Опубликованная прейскурантная ставка Kimi в этом примере ниже, чем у Sol, а Terra ещё дешевле. Но более дешёвый вызов, который требует повторных попыток, создаёт больше работы по ручной проверке или не соблюдает контракт инструмента, не становится автоматически дешевле в расчёте на принятую задачу.
Есть ещё один нюанс, связанный с длинным контекстом. OpenAI указывает ценовой множитель для запросов GPT-5.6 Sol и Terra с объёмом входных данных свыше 272K токенов: 2× для входных и 1,5× для выходных токенов для всего запроса. В руководстве по тарификации K3 от Kimi говорится, что цена K3 не разделяется по диапазонам длины контекста. Включите в набор тестов реальный сценарий с длинным документом и фиксируйте отражённое в счёте потребление; не экстраполируйте результаты короткого промпта.
Более широкий подход описан в нашем руководстве о том, как сравнивать цены на модели ИИ перед сменой поставщика.
Настройки рассуждений не взаимозаменяемы
Kimi K3 всегда работает в режиме мышления. Документированные значения reasoning_effort: low, high и max; по умолчанию используется max. Для GPT-5.6 Sol и GPT-5.6 Terra документирована более широкая шкала, включающая none, low, medium, high, xhigh и max; по умолчанию используется medium.
Из-за этого тестирование значений по умолчанию может вводить в заблуждение. В корректном эксперименте Kimi K3 vs GPT 5.6 Sol следует задать совместимый общий уровень, например high, если маршрут его поддерживает, а затем отдельно провести ориентированное на бюджет сравнение с документированными значениями по умолчанию от поставщиков. Храните эти результаты в отдельных строках — иначе вы смешиваете выбор модели с выбором бюджета на рассуждения.
Также не включайте специфичные для поставщика параметры в первый межмодельный базовый тест. В документации Kimi описывается собственное поведение K3; Response API от OpenAI предоставляет более широкий набор размещённых инструментов. Начните с простой структурированной задачи и добавляйте случаи с инструментами, зрением и мультимодальностью только после успешной проверки базового контракта запрос/ответ.
Инструменты, API и пригодность для миграции
Оба поставщика предлагают привычные интерфейсы для разработчиков, но «совместимость с OpenAI» следует воспринимать как отправную точку, а не как обещание идентичности каждого поля и потокового события.
OpenAI документирует доступ к Chat Completions и Responses для GPT-5.6 Sol, а также вызов функций, структурированные выходные данные и многочисленные инструменты Responses API, такие как веб-поиск, поиск по файлам, генерация изображений, интерпретатор кода, размещённая оболочка, использование компьютера, MCP и поиск инструментов. Это может упростить рабочий процесс, который уже зависит от этих размещённых возможностей OpenAI.
Kimi документирует kimi-k3 для долгосрочных задач программирования и работы со знаниями, а его официальные материалы описывают интеграции, совместимые с OpenAI и ориентированные на Responses. Всегда включённый режим мышления K3, допустимые уровни рассуждений и особенности вызовов зрения или инструментов требуют маршрутно-специфичных дымовых тестов до миграции агента со сложной историей сообщений.
Если вы уже оцениваете K3, ознакомьтесь с руководством по доступу к API Kimi K3, где приведены заметки об ID модели, параметрах и настройке прямого поставщика. Если вам нужно сохранить один клиент при ротации кандидатов, используйте OpenAI-совместимый базовый URL для тестирования промптов нескольких моделей и сохраняйте в журналах точный ID модели каждого кандидата.
48-часовой план оценки Kimi K3 vs GPT 5.6 Sol
Не запускайте один хитрый промпт и не называйте результат бенчмарком. Используйте небольшой, но репрезентативный набор тестовых сценариев.
- Зафиксируйте кандидатов. Начните с
kimi-k3,gpt-5.6-solиgpt-5.6-terra. Для каждого запроса записывайте дату, endpoint, версию SDK, ID модели и настройку рассуждений. - Выберите 20–50 реальных задач. Включите изменения кода, документы, схемы, вызовы инструментов, изображения и сценарии сбоев, которые действительно создают ваши пользователи. Перед отправкой куда-либо удалите из входных данных конфиденциальную информацию.
- Определите критерии приёмки до запуска. Например: тесты пройдены, JSON проходит валидацию, присутствуют поля с цитированием, человек-рецензент принимает результат или агент завершает задачу без небезопасной повторной попытки.
- Соберите полную операционную запись. Сохраняйте количество входных токенов, кешированных входных токенов, выходных токенов и токенов повторных попыток; задержку; ошибки HTTP или инструментов; результат приёмки; и время рецензента. Добавьте поведение при ограничении скорости для устойчивого трафика с помощью чек-листа по планированию ограничений скорости LLM.
- Оцените стоимость на принятый результат. Разделите общие расходы по каждому кандидату на количество принятых задач, а не на число исходных вызовов. Учитывайте в числителе затраты на сбои и повторные попытки.
- Разворачивайте с резервным вариантом. Направьте небольшой процент подходящей работы к выбранному кандидату, сохраните проверенный резервный вариант и настройте оповещения о регрессиях качества, задержки и стоимости.
Используйте компактную оценочную таблицу, чтобы команда могла пересмотреть решение при изменении модели или цены:
| Метрика | Почему это важно | Пример правила приемки |
|---|---|---|
| Доля успешно выполненных задач | Отражает качество, видимое пользователю | Тесты пройдены или ревьюер одобряет |
| Стоимость на принятую задачу | Включает повторные попытки и объём вывода | Не выходить за рамки бюджета рабочей нагрузки |
| Задержка P95 | Отражает качество работы на «хвосте» распределения | Соответствовать SLA для взаимодействия или задания |
| Валидность структурированного вывода | Показывает надёжность API-контракта | Схема проходит валидацию без исправлений |
| Завершение работы инструмента или агента | Проверяет поведение в реальном рабочем процессе | Необходимые инструменты завершают работу с корректной передачей |
| Восстановление при сбое | Защищает доступность в продакшене | Повторная попытка или резервный вариант безопасно завершается |
Тестируйте один и тот же запрос через единый уровень маршрутизации
Использование одного и того же клиента для всех кандидатов устраняет источник случайной предвзятости при сравнении. В публичном кратком руководстве Flatkey указаны один ключ и совместимый с OpenAI базовый URL https://router.flatkey.ai/v1, а в его публичных метаданных ценообразования на момент проверки этой статьи были указаны доступные kimi-k3, gpt-5.6-sol и gpt-5.6-terra. Доступность и поддержка полей могут меняться, поэтому перед развертыванием в продакшене проверьте контракт модели.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

for model in ("kimi-k3", "gpt-5.6-sol", "gpt-5.6-terra"):
    response = client.chat.completions.create(
        model=model,
        reasoning_effort="high",  # a shared supported baseline to test first
        messages=[
            {"role": "user", "content": "Solve the evaluation fixture and return valid JSON."}
        ],
    )
    print(model, response.choices[0].message.content)
Используйте этот фрагмент как отправную точку для оценки, а не как контракт для продакшена. В частности, подтвердите все специфичные для Kimi поля, поведение инструментов, события потоковой передачи, настройки безопасности и схему вывода на конкретном выбранном вами endpoint. После каждого запуска проверяйте использование и результаты на уровне запроса, а не исходите из того, что псевдоним, повышение или карточка модели останутся неизменными.
Какую модель следует протестировать первой?
В сравнении Kimi K3 vs GPT 5.6 Sol начните с Kimi K3, если ваша критически важная задача — программирование или работа со знаниями на длинном горизонте, вам нужно документированное нативное визуальное понимание K3 и вы готовы валидировать специфичные для K3 рассуждения и поведение запросов.
Начните с GPT-5.6 Sol, если рабочий процесс сильно зависит от текущих инструментов Responses API от OpenAI или если более широкие элементы управления reasoning_effort являются частью дизайна вашего продукта. Добавьте GPT-5.6 Terra, когда важнее одно и то же API-семейство и более низкая прямая цена за токен, чем использование флагманского уровня.
Правильным ответом для продакшена могут быть «все три»: флагманский маршрут для сложных задач, более дешёвый маршрут для повторяемой работы и протестированный резервный вариант. Шлюз AI API наиболее полезен, когда помогает применять эту политику без распределения ключей провайдеров и правил маршрутизации, специфичных для моделей, по всему коду продукта.
Часто задаваемые вопросы
Kimi K3 дешевле, чем GPT-5.6 Sol?
Согласно прямым прейскурантным ценам, проверенным для этой статьи, Kimi K3 дешевле GPT-5.6 Sol для некэшированного ввода, кэшированного ввода и вывода. Это не доказывает, что у неё ниже стоимость на принятую задачу. Сравните повторные попытки, длину вывода, правила ценообразования для длинного контекста, стоимость инструментов, цены шлюза и работу по проверке людьми на собственных тестовых сценариях.
GPT-5.6 Terra — лучшее сравнение, чем GPT-5.6 Sol?
Это полезное дополнительное сравнение, если чувствительность к стоимости является частью решения. Terra имеет то же документированное контекстное окно на 1,05 млн токенов и более низкие прямые прейскурантные ставки, чем Sol, тогда как Sol — флагманский уровень GPT-5.6 от OpenAI. Включайте обе модели, когда необходимо отделить решение о семействе моделей от решения об уровне цены.
Можно ли использовать Kimi K3 и GPT-5.6 Sol с одним и тем же клиентом OpenAI?
Вы можете использовать клиент в стиле OpenAI с совместимым провайдером или уровнем маршрутизации, но должны валидировать конкретный endpoint и поля. Совместимость моделей не делает идентичными параметры рассуждений, события инструментов, визуальные входные данные, лимиты запросов или поведение структурированного вывода.
Означает ли большее контекстное окно, что модель лучше для моей кодовой базы?
Нет. Объём контекста не гарантирует качество извлечения, рассуждений, вывода, задержку или приемлемый счёт. Поместите репрезентативный сценарий с репозиторием или документом в оценку и оценивайте принятый результат, а не заявленное число контекстных токенов.
Итоговая рекомендация
Полезный результат сравнения Kimi K3 vs GPT 5.6 Sol — правило маршрутизации, которое вы можете объяснить: какой кандидат обрабатывает какую задачу, при каком уровне рассуждений, в рамках каких ограничений по задержке и стоимости, с каким резервным вариантом. Используйте опубликованные показатели цены и контекста для составления плана тестирования; используйте собственные данные приемки, чтобы выбрать вариант по умолчанию для продакшена.
Источники
- Выбор модели Kimi API
- Платформа Kimi API и актуальная карточка цен K3
- Руководство по тарификации Kimi API
- Руководство по интеграции Kimi Open Platform Responses
- Документация по модели OpenAI GPT-5.6 Sol
- Документация по модели OpenAI GPT-5.6 Terra
- Документация по OpenAI GPT-5 и прекращению поддержки
- Прекращение поддержки моделей OpenAI
- Краткое руководство по Flatkey