Kimi K3 vs GPT 5.6 Sol:価格、コンテキスト、試すべきAPI
Kimi K3 vs GPT 5.6 Solを比較する場合、リーダーボードのスクリーンショットから始めるべきではありません。まず正確なモデルIDを選び、推論の強度を正規化し、自社のタスクにおける承認済み結果あたりのコストを測定してください。
両モデルは、長大なコンテキストを扱うエージェント型の作業向けに構築されています。Kimiの現行APIドキュメントでは、kimi-k3を長期的なコーディング、ナレッジワーク、ネイティブな視覚理解、深い推論のためのフラッグシップとして位置付けています。OpenAIは、gpt-5.6-solを複雑な専門業務向けGPT-5.6ファミリーのフラッグシップ階層として位置付けています。実務上の違いは、単純に「どちらのモデルがより賢いか」ではありません。特定のワークロードに対して、どの経路が製品に適切な品質、ツールの挙動、レイテンシー、請求額をもたらすかです。
このガイドでは、プロバイダーの現行ドキュメントに基づいてKimi K3 vs GPT 5.6 Solを比較し、再現可能なAPI評価計画を提示します。また、実運用のルーティング判断ではより有用なベースラインとなることが多いため、低コストのGPT-5.6オプションであるGPT-5.6 Terraも取り上げます。
要約:長大なコンテキストでのコーディング、常時有効な推論、Kimiのネイティブなビジョンワークフローが製品に適合する場合は、Kimi K3をテストしてください。OpenAIのツール群と構成可能なフラッグシップ推論階層が必要な場合は、GPT-5.6 Solをテストしてください。単価が重要であれば、GPT-5.6 Terraもテスト対象に含めてください。同じフィクスチャを各経路で実行する前に、勝者を決めないでください。
この比較における「GPT-5」の意味
2026年10月時点で、「GPT-5」は曖昧な検索語です。OpenAIのGPT-5モデルページではGPT-5を以前の非推奨モデルとして説明しており、現行の非推奨化ガイダンスでは、いくつかの旧GPT-5スナップショットをGPT-5.6ファミリーへ移行するよう案内しています。この記事でのKimi K3 vs GPT 5.6 Solは、指定されていない旧GPT-5エイリアスではなく、現在公開されているモデルIDのkimi-k3とgpt-5.6-solを指します。
アプリケーションが古いgpt-5-*スナップショットに固定されている場合、まずそれを移行プロジェクトとして扱ってください。正確な置換先を固定し、テストを更新してから、モデル品質を比較する前にプロバイダーの提供終了日を確認してください。
Kimi K3 vs GPT 5.6 Solの概要
| 判断要因 | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| APIモデルID | kimi-k3 |
gpt-5.6-sol |
gpt-5.6-terra |
| プロバイダーの位置付け | 長期的なコーディング、ナレッジワーク、推論、ネイティブな視覚理解のためのフラッグシップ | 複雑な専門業務向けのフラッグシップGPT-5.6階層 | 知能とコストのバランスを取るよう設計されたGPT-5.6階層 |
| コンテキストウィンドウ | 最大100万トークン | 105万トークン | 105万トークン |
| 推論の制御 | 常時有効。low、high、またはmax。デフォルトはmax |
none、low、medium、high、xhigh、またはmax。デフォルトはmedium |
Solと同じ、ドキュメントに記載された推論強度の選択肢 |
| 直接リスト価格:入力 | キャッシュなしトークン100万あたり$3.00 | トークン100万あたり$4.00 | トークン100万あたり$2.00 |
| 直接リスト価格:キャッシュ入力 | トークン100万あたり$0.30 | トークン100万あたり$0.40 | トークン100万あたり$0.20 |
| 直接リスト価格:出力 | トークン100万あたり$15.00 | トークン100万あたり$20.00 | トークン100万あたり$12.00 |
| テストすべきツールに関する問い | 選択したエンドポイントにおける、Kimi固有のリクエスト、思考、ビジョン、ツール呼び出しの挙動 | 製品に必要なOpenAI Responsesの機能とホスト型ツール | 同じ統合面で、より低価格なGPT-5.6候補 |
Kimiの数値はMoonshotの現行プラットフォームおよび請求ページに基づいています。GPTの数値はOpenAIの各モデルページに基づいています。これらは2026年10月22日に確認した、直接プロバイダーの参考価格であり、すべてのゲートウェイ、地域、プロモーション、ツール呼び出し、税務上の扱い、エンタープライズ契約に対する見積もりではありません。
Kimi K3 vs GPT 5.6 Solでは、見出しとなるコンテキスト数値は十分に近いため、「100万トークン」だけで結果を決めるべきではありません。重要な問いは、長大なコンテキストのフィクスチャが重要な事実を保持するか、出力が引き続き利用可能か、そしてキャッシュと出力トークンを含めたリクエスト全体のコストがいくらになるかです。
価格比較:表示価格ではなくワークロードを使う
トークン価格はコストモデルへの入力であり、モデル選定の結果そのものではありません。単純な見積もりは次のとおりです。
推定リクエストコスト =
  (キャッシュなし入力トークン × キャッシュなし入力レート)+
  (キャッシュ入力トークン × キャッシュ入力レート)+
  (出力トークン × 出力レート)
以下は、意図的に単純化した2つのワークロードに対する直接価格での計算です。税金、ゲートウェイ価格、ツール呼び出し料金、長大なコンテキストに対する割増料金は含まれていません。
| ワークロード例 | Kimi K3 | GPT-5.6 Sol | GPT-5.6 Terra |
|---|---|---|---|
| キャッシュなし入力100万 + 出力25万 | $6.75 | $9.00 | $5.00 |
| キャッシュ入力100万 + 出力25万 | $4.05 | $5.40 | $3.20 |
これらの計算が示すように、Kimi K3 vs GPT 5.6 Solは一次元的なコスト比較ではありません。この例では、Kimiの公表リスト料金はSolより低く、Terraはさらに低くなっています。しかし、再試行が必要になったり、手動レビュー作業が増えたり、ツール契約を満たせなかったりする低価格の呼び出しが、承認済みタスクあたりで自動的に安くなるとは限りません。
長大なコンテキストには、もう1つ注意点があります。OpenAIは、272K入力トークンを超えるGPT-5.6 SolおよびTerraのプロンプトについて、リクエスト全体に対して入力2×、出力1.5×の価格乗数を適用すると説明しています。KimiのK3課金ガイドでは、K3の価格はコンテキスト長の区分によって階層化されないとされています。実際の長文書ケースをテストセットに含め、請求書に表示される使用量を記録してください。短いプロンプトから外挿してはいけません。
より広範な方法については、プロバイダーを切り替える前にAIモデルの価格を比較する方法に関するガイドをご覧ください。
推論設定は互換ではありません
Kimi K3は常にthinkingモードで動作します。ドキュメント化されているreasoning_effortの値はlow、high、maxで、デフォルトはmaxです。GPT-5.6 SolとGPT-5.6 Terraでは、none、low、medium、high、xhigh、maxを含む、より広いスケールがドキュメント化されており、デフォルトはmediumです。
そのため、デフォルト同士のテストは誤解を招きます。公平なKimi K3 vs GPT 5.6 Solの実験では、ルートが対応している場合にhighなどの互換性のある共通レベルを設定し、その後、プロバイダーが文書化しているデフォルトを用いた予算重視の比較を別途実行する必要があります。これらの結果は別々の行に記録してください。そうしないと、モデル選択と推論予算の選択を混同することになります。
また、最初のクロスモデルのベースラインには、プロバイダー固有のパラメータを含めないでください。KimiのドキュメントではK3固有の動作が示されており、OpenAIのResponse APIはより幅広いホスト型ツールを提供しています。まずは単純な構造化タスクから始め、基本的なリクエスト/レスポンス契約を通過してから、ツール、ビジョン、マルチモーダルのケースを追加してください。
ツール、API、移行適合性
両プロバイダーは使い慣れた開発者向けインターフェースを提供していますが、「OpenAI-compatible」は出発点として扱うべきであり、すべてのフィールドとストリーミングイベントが同一であることを約束するものではありません。
OpenAIは、GPT-5.6 Sol向けにChat CompletionsおよびResponsesへのアクセスに加え、関数呼び出し、構造化出力、ウェブ検索、ファイル検索、画像生成、コードインタープリター、ホスト型シェル、コンピューター操作、MCP、ツール検索など、多数のResponses APIツールをドキュメント化しています。すでにこれらのOpenAIホスト型機能に依存しているワークフローでは、これにより簡素化できる可能性があります。
Kimiは、長期的なコーディングおよびナレッジワーク向けにkimi-k3を文書化しており、その公式資料ではOpenAI互換およびResponses指向の統合について説明しています。複雑なメッセージ履歴を持つエージェントを移行する前に、K3の常時thinking、許可される推論レベル、ビジョンまたはツール呼び出しの詳細について、ルート固有のスモークテストを行うべきです。
すでにK3を評価している場合は、モデルID、パラメータ、直接プロバイダーのセットアップに関する注記について、Kimi K3 APIアクセスガイドをお読みください。候補を切り替えながら1つのクライアントを維持する必要がある場合は、マルチモデルのプロンプトテスト向けOpenAI互換ベースURLを使用し、各候補の正確なモデルIDをログに保存してください。
48時間のKimi K3 vs GPT 5.6 Sol評価プラン
1つの巧妙なプロンプトを実行して、その結果をベンチマークと見なしてはいけません。小規模ながら代表性のあるフィクスチャセットを使用してください。
- 候補を固定する。
kimi-k3、gpt-5.6-sol、gpt-5.6-terraから始めます。すべてのリクエストについて、日付、エンドポイント、SDKバージョン、モデルID、推論設定を記録してください。 - 実際のタスクを20~50件選ぶ。ユーザーが実際に生成するコード変更、文書、スキーマ、ツール呼び出し、画像、失敗ケースを含めます。入力を送信する前に、機密情報をマスキングしてください。
- 実行前に受け入れ基準を定義する。例:テストに合格する、JSONが検証される、引用対象のフィールドが存在する、人間のレビュアーが結果を承認する、またはエージェントが安全でない再試行なしにタスクを完了する。
- 完全な運用記録を取得する。入力、キャッシュ済み入力、出力、再試行のトークン数、レイテンシ、HTTPまたはツールエラー、受け入れ結果、レビュアーの作業時間を保存します。継続的なトラフィックに対するレート制限の挙動は、LLMレート制限計画チェックリストを用いて追加してください。
- 承認済み結果あたりのコストを算出する。各候補の総支出を、生の呼び出し数ではなく承認されたタスク数で割ります。失敗および再試行のコストは分子に含めてください。
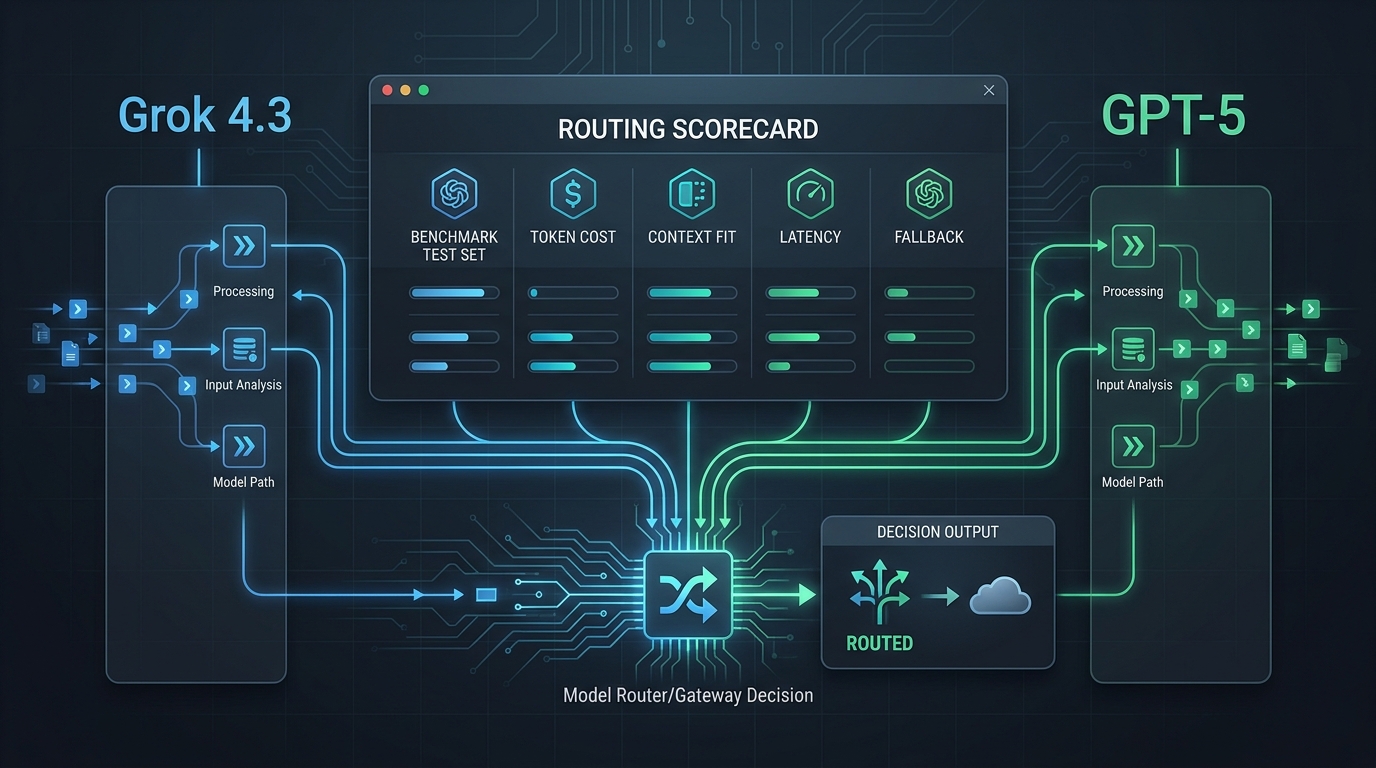
- フォールバックを用意して展開する。適格な作業の一部を選択した候補へルーティングし、テスト済みのフォールバックを維持するとともに、品質、レイテンシ、コストの劣化をアラートで監視します。
モデルや価格が変わった際にチームが判断を見直せるよう、簡潔なスコアカードを使用してください。
| 指標 | 重要である理由 | 受け入れルールの例 |
|---|---|---|
| タスク合格率 | ユーザーに見える品質を捉える | テストに合格、またはレビュアーが承認 |
| 受け入れ済みタスクあたりのコスト | 再試行と出力量を含む | ワークロードの予算内に収める |
| P95レイテンシ | テール時の体験を捉える | インタラクションまたはジョブのSLAを満たす |
| 構造化出力の妥当性 | APIコントラクトの信頼性を示す | 修復なしでスキーマ検証に通る |
| ツールまたはエージェントの完了 | 実際のワークフローの挙動をテストする | 必要なツールが正しい引き継ぎで完了する |
| フォールバック復旧 | 本番環境の可用性を保護する | 再試行またはフォールバックが安全に完了する |
同じリクエストを1つのルーティングレイヤーでテストする
すべての候補に同じクライアントを使用すると、偶発的な比較バイアスの要因を取り除けます。Flatkeyの公開クイックスタートでは、1つのキーとOpenAI互換のhttps://router.flatkey.ai/v1ベースURLが文書化されており、この記事の確認時点で、その公開価格メタデータにはkimi-k3、gpt-5.6-sol、gpt-5.6-terraが利用可能として掲載されていました。可用性とフィールドのサポートは変更される可能性があるため、本番展開前にモデルコントラクトを確認してください。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

for model in ("kimi-k3", "gpt-5.6-sol", "gpt-5.6-terra"):
    response = client.chat.completions.create(
        model=model,
        reasoning_effort="high",  # a shared supported baseline to test first
        messages=[
            {"role": "user", "content": "Solve the evaluation fixture and return valid JSON."}
        ],
    )
    print(model, response.choices[0].message.content)
このスニペットは本番用コントラクトではなく、評価の出発点として使用してください。特に、Kimi固有のフィールド、ツールの挙動、ストリーミングイベント、安全性設定、出力スキーマは、選択する正確なエンドポイントで確認してください。各実行後は、エイリアス、昇格、モデルカードが変わらないと仮定するのではなく、リクエストレベルの使用量と結果を確認してください。
最初にテストすべきモデルは?
重要なタスクが長期間にわたるコーディングまたはナレッジワークであり、K3で文書化されているネイティブの視覚理解を求め、K3固有の推論およびリクエスト挙動を検証できる場合は、Kimi K3 vs GPT 5.6 SolではKimi K3から始めてください。
ワークフローがOpenAIの現行Responses APIツール群に大きく依存している場合、またはより広範なreasoning_effortコントロールが製品設計の一部である場合は、GPT-5.6 Solから始めてください。同じAPIファミリーであることと、より低い直接トークン料金がフラッグシップ層の利用より重要な場合は、GPT-5.6 Terraを追加してください。
適切な本番環境での答えは「3つすべて」の場合もあります。つまり、難しいタスク向けのフラッグシップルート、反復可能な作業向けの低コストルート、そしてテスト済みのフォールバックです。AI APIゲートウェイは、プロバイダーキーやモデル固有のルーティングルールを製品コード全体に分散させることなく、そのポリシーを適用するのに役立つ場合に最も有用です。
よくある質問
Kimi K3はGPT-5.6 Solより安価ですか?
この記事で確認した直接の定価では、Kimi K3は、非キャッシュ入力、キャッシュ入力、出力のいずれについてもGPT-5.6 Solより低価格です。ただし、それだけでは受け入れ済みタスクあたりのコストが低いことの証明にはなりません。ご自身のフィクスチャで、再試行、出力長、長文コンテキストの料金ルール、ツール料金、ゲートウェイ料金、人手によるレビューワークを比較してください。
GPT-5.6 TerraはGPT-5.6 Solより適切な比較対象ですか?
コスト感度が意思決定の一部である場合、これは有用な追加比較です。TerraはSolと同じく、文書化された105万トークンのコンテキストウィンドウを持ち、直接の定価はSolより低くなっています。一方、SolはOpenAIのフラッグシップGPT-5.6層です。モデルファミリーの選択と価格層の選択を分ける必要がある場合は、両方を含めてください。
Kimi K3とGPT-5.6 Solを同じOpenAIクライアントで使用できますか?
互換性のあるプロバイダーまたはルーティングレイヤーであれば、OpenAIスタイルのクライアントを使用できますが、正確なエンドポイントとフィールドを検証する必要があります。モデルに互換性があっても、推論パラメータ、ツールイベント、ビジョン入力、レート制限、構造化出力の挙動まで同一になるわけではありません。
コンテキストウィンドウが大きいほど、コードベースに適したモデルということですか?
いいえ。コンテキスト容量は、検索、推論、出力品質、レイテンシ、または管理可能な請求額を保証しません。代表的なリポジトリまたはドキュメントのフィクスチャを評価に含め、宣伝されているコンテキスト数値ではなく、受け入れられた結果をスコアリングしてください。
最終的な推奨事項
Kimi K3 vs GPT 5.6 Solの比較から得るべき有用な結果は、説明可能なルーティングルールです。すなわち、どの候補がどのタスクを、どの推論レベルで、どのレイテンシおよびコストのガードレール内で、どのフォールバックとともに処理するかということです。公開されている価格とコンテキストの数値をテスト計画の策定に使用し、本番環境のデフォルトを選ぶ際には自社の受け入れデータを使用してください。