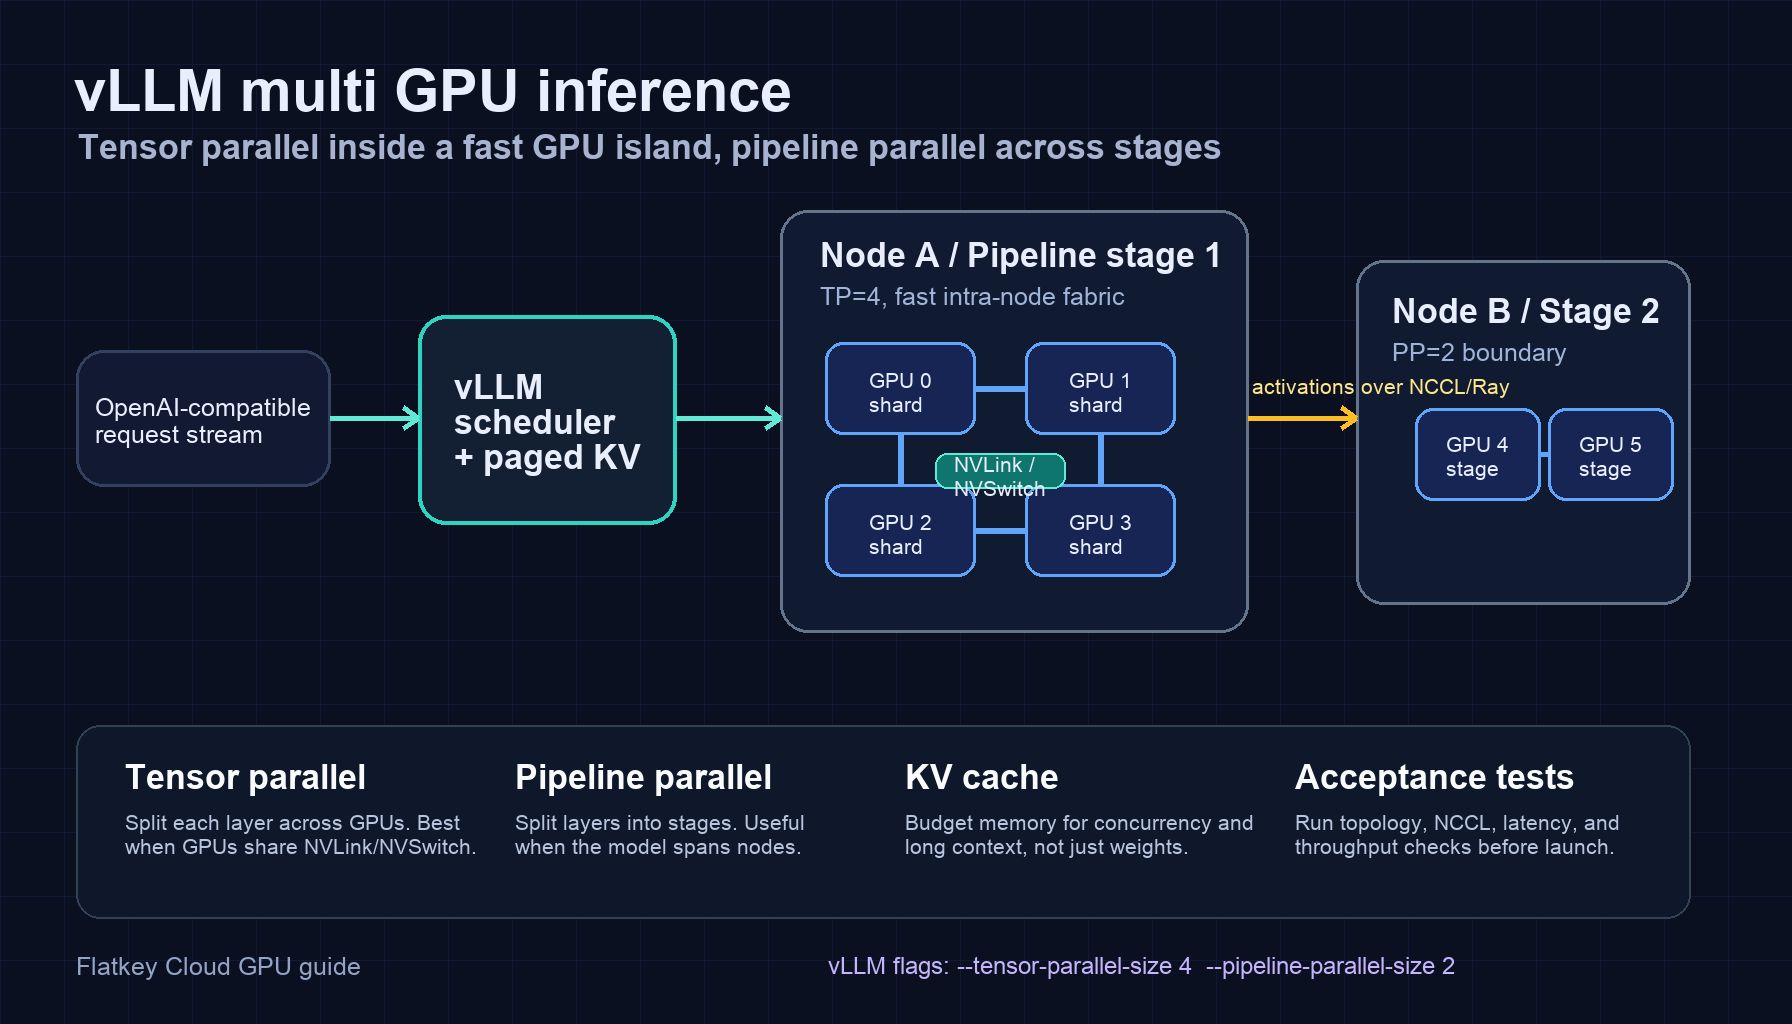
Déploiement du parallélisme expert de vLLM pour DeepSeek et d’autres modèles MoE
Le parallélisme expert de vLLM est le mode de déploiement à utiliser lorsque les couches d’experts d’un modèle MoE doivent être réparties entre plusieurs GPU plutôt que traitées comme un seul grand groupe de parallélisme tensoriel. Dans la version actuelle de vLLM, l’option est --enable-expert-parallel. Vous dimensionnez le parallélisme expert indirectement via les paramètres de parallélisme tensoriel (TP) et de parallélisme de données (DP) : la documentation vLLM indique EP_SIZE = TP_SIZE × DP_SIZE.
Ce détail est important. De nombreux runbooks recherchent un « indicateur de taille du parallélisme expert vLLM » distinct, puis tentent d’imposer un indicateur qui ne fait pas partie de leur build épinglé. Commencez par l’option prise en charge, vérifiez vllm serve --help dans l’image exacte que vous déploierez, puis faites vos choix TP/DP à partir d’un plan de capacité mesuré.
Ce guide présente un chemin sûr allant d’un déploiement DeepSeek MoE sur un seul nœud au parallélisme expert vLLM multinœud, y compris le choix du backend, l’équilibrage de charge des experts, les tests d’acceptation et l’isolation des défaillances. Il est destiné aux ingénieurs ML et d’infrastructure IA, et non à une démonstration en une seule commande.
Note de version : les noyaux MoE, les dépendances et l’interface CLI de vLLM évoluent rapidement. Les comportements et commandes documentés ci-dessous ont été vérifiés par rapport à la documentation officielle de vLLM le 16 octobre 2026. Épinglez l’image vLLM et vérifiez les options par rapport à cette version épinglée avant un déploiement en production.
La réponse courte
| Question | Réponse pratique |
|---|---|
| Qu’est-ce qui active le parallélisme expert vLLM ? | Ajoutez --enable-expert-parallel à un déploiement MoE pris en charge. |
| Comment la taille EP est-elle choisie ? | Dans la documentation actuelle du parallélisme expert vLLM, elle est calculée comme TP × DP ; définissez --tensor-parallel-size et --data-parallel-size, et non un indicateur de taille EP supposé. |
| Qu’est-ce qui change ? | Les couches d’experts MoE sont fragmentées entre les rangs EP ; les couches d’attention suivent toujours le comportement TP/DP documenté. |
| Quand faut-il l’utiliser ? | Lorsqu’un modèle MoE, la topologie des GPU, le tissu de communication et le volume de requêtes justifient de distribuer le travail des experts. Ce n’est pas un bouton générique d’accélération pour les modèles denses. |
| Par où commencer ? | Un nœud, une révision de modèle fixe, une trace de trafic fixe et une référence n’utilisant pas EP. |
Le guide officiel de déploiement du parallélisme expert vLLM fait autorité pour cette fonctionnalité. Il décrit le parallélisme expert comme la distribution des experts MoE sur les GPU, généralement associée au parallélisme de données.
Ce que le parallélisme expert vLLM change réellement
Un modèle MoE achemine chaque jeton vers un petit sous-ensemble parmi de nombreux réseaux experts. Sans parallélisme expert, le comportement MoE documenté de vLLM forme un groupe de parallélisme tensoriel sur DP × TP. Avec --enable-expert-parallel, les couches d’experts utilisent à la place le parallélisme expert, tandis que les couches d’attention conservent leur propre comportement TP/DP.
Pour une topologie concrète, considérons TP=2 et DP=4 :
| Composant | Comportement parallèle avec EP activé |
|---|---|
| Couches d’experts | Un groupe EP couvrant 8 rangs ; les experts sont répartis entre ces GPU. |
| Couches d’attention | Des groupes de parallélisme tensoriel de 2 au sein de chacun des 4 groupes DP. |
| Taille EP effective | 2 × 4 = 8. |
C’est pourquoi le parallélisme expert vLLM ne remplace pas la décision sur la manière dont les couches d’attention, la capacité du cache KV, la concurrence des requêtes et la topologie réseau s’articulent. Il ne constitue qu’une partie d’une conception de serving distribuée.
Pour une introduction plus large au modèle multi-GPU adapté à une charge de travail, consultez l’inférence vLLM multi-GPU : configuration du parallélisme tensoriel et pipeline.
L’option de parallélisme expert vLLM et la question de l’« indicateur de taille »
La documentation publique actuelle fournit l’option d’activation canonique :
--enable-expert-parallel
Elle indique également que la taille du parallélisme expert est calculée à partir des tailles de parallélisme tensoriel et de données :
EP_SIZE = TP_SIZE × DP_SIZE
Le modèle des documents de déploiement du parallélisme expert vLLM est donc :
vllm serve <MODEL> --tensor-parallel-size <TP> --data-parallel-size <DP> --enable-expert-parallel
Ne copiez pas une option --expert-parallel-size distincte depuis un ancien ticket, un wrapper interne ou une autre pile de serving, en supposant qu’elle s’applique à votre build vLLM. Considérez la question « quelle est ma taille EP ? » comme une question de topologie :
- Choisissez le nombre de GPU et de nœuds disponibles pour un groupe de serving.
- Choisissez TP pour la fragmentation des couches d’attention et le comportement local du modèle.
- Choisissez DP pour la capacité des moteurs indépendants et la distribution des requêtes.
- Activez EP pour les couches MoE.
- Confirmez la topologie de processus calculée dans les journaux de démarrage et exécutez un test de charge.
La référence de la CLI serve de vLLM fait autorité pour les options d’une version spécifique.
Avant le déploiement : le contrôle de préparation
Effectuez ces vérifications avant d’attribuer un problème de démarrage ou de débit au parallélisme expert.
| Critère | Éléments à vérifier | Pourquoi c’est important |
|---|---|---|
| Version | Épinglez le conteneur vLLM, la pile CUDA et la révision du modèle sur chaque worker. | Une image mixte ou un wheel non concordant peut transformer un problème de topologie en erreur de noyau opaque. |
| Compatibilité du modèle | Prenez en compte les poids du modèle, le cache KV, les espaces de travail d’exécution et les éventuels experts redondants avant de choisir le nombre de GPU. | EP n’élimine pas la planification de la mémoire. |
| Dépendances | Respectez les prérequis actuels des noyaux EP de vLLM, notamment DeepEP et DeepGEMM lorsque la documentation les exige. | La documentation sur le parallélisme expert les indique comme prérequis. |
| Interconnexion | Vérifiez la topologie GPU sur un nœud et les communications GPU inter-nœuds avant la première requête en production. | EP ajoute de la communication à chaque passe avant MoE. |
| Réseau de contrôle | Définissez explicitement l’adresse du nœud principal, l’accessibilité du port et la sélection de la carte réseau. | Un plan de données sain ne sert à rien lorsque la découverte du plan de contrôle pointe vers la mauvaise interface. |
| Référence | Relevez la latence, le débit, le taux d’erreur et la marge de mémoire GPU sans EP. | Vous avez besoin d’une réponse comparable à « EP a-t-il aidé ? » |
Pour l’aspect mémoire de ce critère, utilisez le guide des besoins en mémoire GPU des LLM afin de créer une feuille de calcul de capacité avant de réserver un cluster plus grand.
Gardez la première expérience simple
Utilisez une seule révision du modèle, un tokenizer connu, un seul mix de requêtes, une seule plage de concurrence et un ensemble fixe d’options de lancement. Évitez de modifier simultanément la quantification, les paramètres de cache, le matériel et le backend all-to-all dans le même test. Une référence propre permet de déterminer si le parallélisme expert de vLLM a modifié le débit utile ou seulement déplacé le goulot d’étranglement.
Déploiement DeepSeek MoE sur un seul nœud
Le guide vLLM actuel utilise DeepSeek-V3-0324 comme exemple sur un seul nœud, avec TP sur une voie, DP sur huit voies et EP activé :
vllm serve deepseek-ai/DeepSeek-V3-0324 --tensor-parallel-size 1 --data-parallel-size 8 --enable-expert-parallel
La documentation explique l’effet visé : les poids d’attention sont répliqués entre les rangs DP, tandis que les poids des experts sont répartis entre les GPU. Elle utilise comme topologie d’exemple un nœud H200 ou H20 à huit GPU et recommande aux équipes disposant d’un matériel différent de valider leur propre compatibilité plutôt que de considérer l’exemple comme une promesse universelle de dimensionnement.
Utilisez cette commande comme point de départ pour la topologie, et non comme une configuration de production à copier-coller. Avant d’exposer un endpoint :
- Confirmez que le serveur atteint un état prêt et sain, sans basculement caché vers un autre chemin de noyau.
- Exécutez un test de correction avec des prompts connus et le comportement attendu pour le schéma ou les appels d’outils.
- Appliquez une faible charge stable, puis une rafale et un échantillon à contexte long.
- Comparez les temps p50 et p99 jusqu’au premier jeton, la latence inter-jetons, le débit de sortie, la marge mémoire et les erreurs à la référence sans EP.
- Enregistrez la commande de lancement, le digest de l’image, la révision du modèle, la version du pilote et l’instantané des métriques avec le résultat du benchmark.
Si vous construisez encore la couche API environnante, ce guide de déploiement vLLM couvre le chemin de serveur compatible OpenAI séparément de la décision relative au parallélisme MoE.
Sélectionnez le backend all-to-all selon la charge de travail, pas par habitude
vLLM expose --all2all-backend pour la communication en parallélisme expert. Le guide officiel décrit actuellement une option par défaut généraliste ainsi que des modes DeepEP spécialisés. Adaptez le backend au trafic que vous avez réellement mesuré.
| Backend | Cas d’usage documenté | Implication de déploiement |
|---|---|---|
allgather_reducescatter |
Déploiements EP + DP généralistes | Une configuration de contrôle pertinente avant tout réglage spécialisé. |
deepep_high_throughput |
Charges de travail multi-nœuds dominées par le préremplissage | À évaluer lorsque les prompts longs et le débit agrégé dominent l’objectif de service. |
deepep_low_latency |
Charges de travail multi-nœuds dominées par le décodage | À évaluer lorsque la latence des jetons générés importe davantage que le débit maximal de préremplissage. |
| Modes FlashInfer NVLink | Systèmes spécifiques à MNNVL / NVLink | À utiliser uniquement lorsque le matériel et la documentation vLLM actuelle correspondent aux exigences du backend. |
L’objectif n’est pas de choisir l’étiquette qui semble la plus rapide. Il s’agit de tester un backend à la fois en fonction de votre mix de longueurs de prompts, de la concurrence, de l’interconnexion et du SLO. Mesurez l’effet sur la latence de queue ainsi que sur les jetons par seconde.
Parallélisme expert vLLM multi-nœuds : un modèle à deux nœuds
Pour un déploiement multi-nœuds, la documentation vLLM utilise un nœud principal qui gère le trafic API et un nœud worker secondaire --headless. Ce qui suit est une forme paramétrée de ce modèle documenté. Remplacez les adresses et les nombres par des valeurs correspondant au cluster que vous avez réellement testé.
Sur le nœud principal :
export GLOO_SOCKET_IFNAME=eth0
vllm serve deepseek-ai/DeepSeek-V3-0324 --all2all-backend deepep_low_latency --tensor-parallel-size 1 --enable-expert-parallel --data-parallel-size 16 --data-parallel-size-local 8 --data-parallel-address <PRIMARY_NODE_IP> --data-parallel-rpc-port 13345 --api-server-count 8
Sur le second nœud :
export GLOO_SOCKET_IFNAME=eth0
vllm serve deepseek-ai/DeepSeek-V3-0324 --all2all-backend deepep_low_latency --tensor-parallel-size 1 --enable-expert-parallel --data-parallel-size 16 --data-parallel-size-local 8 --data-parallel-start-rank 8 --data-parallel-address <PRIMARY_NODE_IP> --data-parallel-rpc-port 13345 --headless
Les chiffres sont importants :
--data-parallel-sizecorrespond à la taille DP totale de l’ensemble de serving.--data-parallel-size-localcorrespond au nombre de rangs DP lancés sur ce nœud.--data-parallel-start-rankcorrespond à la taille DP locale cumulée des nœuds précédents.- Le nœud secondaire est sans tête, car le nœud principal gère les requêtes des clients.
Pour les clusters InfiniBand, le guide vLLM actuel recommande explicitement GLOO_SOCKET_IFNAME=eth0 afin de conserver la découverte des groupes distribués sur l’interface de contrôle Ethernet sélectionnée. Cela ne remplace pas la validation de NCCL et des communications GPU-à-GPU entre les nœuds.
Liste de contrôle d’acceptation multi-nœuds
Avant d’envoyer du trafic client vers un groupe de parallélisme expert vLLM multi-nœuds, vérifiez tous les éléments suivants :
- Chaque worker résout la même révision du modèle et démarre avec le rang prévu.
- Le nœud principal peut atteindre l’adresse et le port RPC configurés depuis chaque pair.
- Le groupe distribué s’initialise de manière répétée après un redémarrage propre.
- Une requête se termine avec une faible concurrence, puis sous une trace soutenue.
- Un mélange de requêtes volontairement déséquilibré ne provoque pas de blocages silencieux ni de dégradation brutale de la latence de queue.
- Le redémarrage d’un worker de test produit un signal de défaillance observable et exploitable, plutôt que des requêtes mises en file d’attente indéfiniment.
Le guide de dépannage distribué de vLLM recommande de vérifier la communication GPU inter-nœuds et de rendre les variables d’environnement de communication disponibles sur chaque nœud. Si vous utilisez Ray, il indique également qu’il faut aligner la configuration des IP d’hôte de vLLM et de Ray.
N’ajoutez l’équilibrage de charge du parallélisme expert qu’après avoir observé un déséquilibre
Le routage MoE n’est pas toujours réparti uniformément en production. L’équilibreur de charge du parallélisme expert (EPLB) de vLLM collecte des données de charge et redistribue périodiquement les mappages d’experts entre les rangs EP. Cette fonctionnalité est activée avec --enable-eplb.
vllm serve Qwen/Qwen3-30B-A3B --enable-expert-parallel --enable-eplb --eplb-config '{"window_size":1000,"step_interval":3000,"num_redundant_experts":2,"log_balancedness":true}'
Commencez sans EPLB, sauf si vous avez des preuves d’experts sollicités de façon excessive, d’une charge inégale par rang ou d’une latence de queue persistante qui suit le déséquilibre du routage. EPLB peut utiliser des experts redondants, et ces copies d’experts supplémentaires consomment de la mémoire GPU. Considérez-le comme une optimisation avec un coût de capacité, et non comme un indicateur obligatoire du parallélisme expert vLLM.
Pour une expérience initiale :
- Enregistrez l’utilisation par rang et la latence des requêtes sans EPLB.
- Activez la journalisation de l’équilibrage pendant une fenêtre contrôlée.
- Ajoutez le plus petit paramètre de redondance compatible avec le budget mémoire.
- Comparez la latence de queue, le débit, la marge mémoire et la perturbation due au rééquilibrage avec la même trace.
- Gardez prête la commande de retour arrière ainsi que la configuration de déploiement sans EPLB.
Un plan de benchmark qui répond à la bonne question
Ne considérez pas un déploiement EP comme réussi simplement parce que le processus démarre. Utilisez la même révision du modèle, les mêmes prompts, limites de sortie, concurrence, quantification, paramètres de cache et réservation matérielle pour chaque comparaison.
| Test | Ce qu’il met en évidence | Signal de décision |
|---|---|---|
| Décodage avec prompts courts et forte concurrence | Comportement des opérations collectives et des files d’attente côté décodage | Latence inter-token p99 et débit de jetons générés |
| Préremplissage avec prompts longs | Surcharge du préremplissage et du all-to-all | Temps p99 jusqu’au premier jeton et débit de préremplissage agrégé |
| Trace de déséquilibre des experts | Si un petit ensemble d’experts crée des rangs surchargés | Déséquilibre entre rangs, croissance des files d’attente et pertinence d’EPLB |
| Test de capacité à contexte long | Marge mémoire sous une pression de cache réaliste | Taux d’OOM, échecs d’admission et concurrence sûre |
| Exercice de redémarrage / partition | Comportement opérationnel en présence d’un pair défaillant ou d’un port bloqué | Temps de détection, visibilité des erreurs et chemin de récupération |
Enregistrez davantage que le débit moyen. Un déploiement qui améliore la moyenne tout en dégradant la latence p99 ou en rendant la récupération opaque n’est pas une victoire nette pour la production.
Dépannage des déploiements de parallélisme expert vLLM
| Symptôme | Catégorie de cause probable | Première action |
|---|---|---|
Argument --expert-parallel-size inconnu |
Le guide d’exploitation et la version installée de vLLM ne correspondent pas | Exécutez vllm serve --help, épinglez la build et utilisez le dimensionnement TP/DP documenté pour cette build. |
| Le démarrage échoue au niveau d’un noyau EP ou d’un backend all-to-all | Dépendance EP / pile de conteneurs manquante ou incompatible | Vérifiez de nouveau les prérequis EP actuels et l’image de conteneur plutôt que de modifier plusieurs indicateurs de lancement à la fois. |
| Les workers multi-nœuds se bloquent pendant l’initialisation | Configuration de l’adresse du plan de contrôle, du port, de la carte réseau ou du groupe de processus | Vérifiez l’accessibilité, les interfaces sélectionnées, le calcul des rangs et la communication distribuée avant d’ajuster les noyaux. |
| La première requête se bloque après que les workers semblent prêts | La communication GPU inter-nœuds n’est pas saine | Exécutez les vérifications de communication du fournisseur/de vLLM, puis examinez la configuration de NCCL et des interfaces. |
| Le débit ne s’améliore pas | Le mix de trafic, le fabric, le comportement des lots ou la configuration côté attention reste le goulot d’étranglement | Comparez avec la référence selon la longueur des prompts et la concurrence ; modifiez une variable de topologie à la fois. |
| Manque de mémoire après l’activation d’EPLB | La mémoire des experts redondants a consommé la marge de sécurité | Réduisez la redondance ou réservez davantage de marge mémoire ; répétez le test de capacité. |
| Un rang est systématiquement plus lent | Déséquilibre du routage des experts ou performances inégales des hôtes/du fabric | Mesurez d’abord la charge au niveau des rangs ; n’envisagez EPLB que si les données le justifient. |
L’habitude importante est un diagnostic ciblé. Conservez le modèle, l’image, la trace de trafic et la topologie fixes pendant que vous modifiez un seul facteur. Cela transforme un signalement vague du type « EP est lent » en une observation exploitable.
Séquence de déploiement en production
- Établissez la référence. Exécutez le modèle MoE cible sans EP et conservez les métriques, les journaux et le manifeste de lancement.
- Activez EP sur un nœud. Utilisez
--enable-expert-parallelavec une topologie TP/DP explicitement choisie. - Vérifiez la qualité et la capacité. Contrôlez le comportement des sorties, la marge mémoire, la latence p50/p99 et le débit soutenu.
- Choisissez un backend selon la forme du trafic. Comparez le backend général à un backend spécialisé pertinent, uniquement avec la même trace.
- Ajoutez EPLB uniquement sur la base de preuves. Utilisez les données d’équilibrage et la marge mémoire pour justifier les experts redondants.
- Étendez au multi-nœuds. Vérifiez l’allocation des rangs, le réseau de contrôle et la communication GPU inter-nœuds avant d’augmenter le trafic.
- Effectuez un exercice de défaillance. Testez le redémarrage, la perte de port et un worker défaillant avant que le trafic de production ne révèle la lacune à votre place.
- Épinglez et documentez. Enregistrez les versions, les indicateurs de lancement, la topologie, les métriques et les étapes de restauration à côté du déploiement.
Quand ne pas auto-héberger la couche de service MoE
Le parallélisme expert de vLLM est le bon investissement lorsque le contrôle du placement des modèles, du chemin de données, de la réservation matérielle et du comportement de serving fait partie des exigences produit. Il convient mal lorsque l’équipe a principalement besoin d’accéder aux modèles et ne peut pas prendre en charge l’utilisation des GPU, le réseau distribué, les tests de mise à niveau et la récupération d’astreinte.
Avant de réserver un cluster plus grand, comparez le modèle opérationnel à une approche d’API managée dans GPU cloud vs. model API: when self-hosting actually saves money. La bonne réponse peut être hybride : auto-héberger la charge de travail qui nécessite le contrôle de l’infrastructure et utiliser une couche API pour le reste.
FAQ
Est-ce que --enable-expert-parallel active le parallélisme expert de vLLM ?
Oui. La CLI actuelle de vLLM documente --enable-expert-parallel comme utilisant le parallélisme expert au lieu du parallélisme tensoriel pour les couches MoE.
Quel est l’indicateur de taille du parallélisme expert de vLLM ?
Pour le flux de déploiement actuellement documenté, la taille EP est dérivée de --tensor-parallel-size et --data-parallel-size : EP_SIZE = TP × DP. Vérifiez la surface CLI exacte dans votre version épinglée de vLLM au lieu de supposer l’existence d’un indicateur de taille distinct.
Le parallélisme expert remplace-t-il le parallélisme tensoriel partout ?
Non. EP modifie la stratégie des couches d’experts MoE. Le comportement des couches d’attention dépend toujours des valeurs TP et DP que vous choisissez.
Chaque déploiement DeepSeek doit-il activer EPLB ?
Non. Démontrez d’abord un déséquilibre de charge des experts sous un trafic représentatif et confirmez que le coût mémoire des experts redondants convient au cluster. EPLB est une optimisation, pas une exigence par défaut.
Quel backend all-to-all dois-je utiliser ?
Commencez par les recommandations actuelles de vLLM, puis testez le backend correspondant à la forme de votre charge de travail : une option généraliste pour une large compatibilité, un mode DeepEP à haut débit pour un trafic principalement axé sur le prefill, ou un mode DeepEP à faible latence pour un trafic principalement axé sur le décodage.
Références
- Documentation sur le déploiement du parallélisme expert de vLLM
- Documentation sur le déploiement du parallélisme des données de vLLM
- Référence de la CLI vLLM serve
- Dépannage des déploiements distribués de vLLM
Étape suivante : utilisez la commande sur un seul nœud comme environnement de validation contrôlé, établissez une référence, puis ne déployez que la topologie qui améliore le SLO qui vous importe réellement. C’est ainsi que le parallélisme expert de vLLM devient une décision de production plutôt qu’un indicateur dont vous espérez qu’il sera plus rapide.