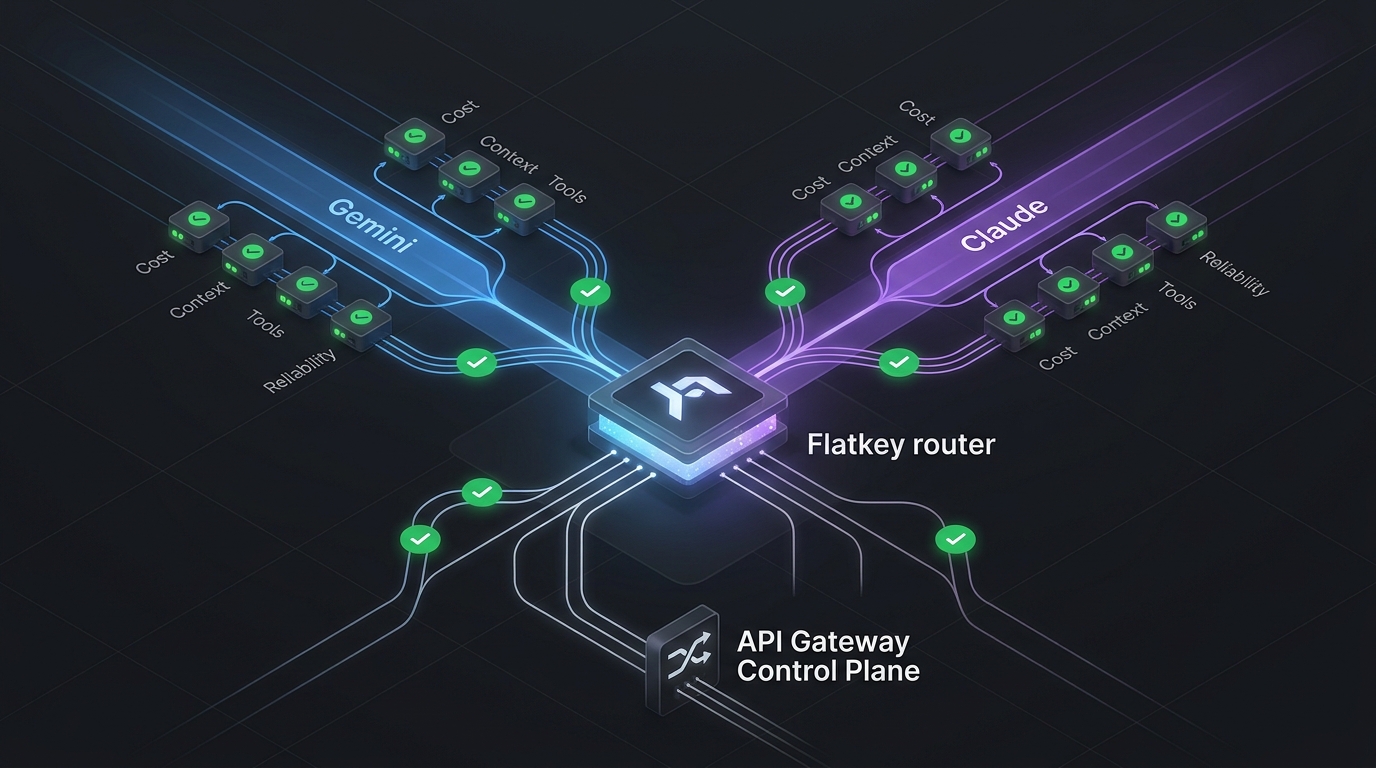
Si vous comparez Gemini et Claude pour un flux de travail API, ne vous arrêtez pas à « quel modèle est le meilleur ». En production, la vraie question est : quelle route doit recevoir cette classe de requête, que doit-il se passer en cas d’échec, et comment allez-vous prouver le coût et la qualité du résultat après l’appel ?
C’est le rôle pratique de Routage API Gemini vs Claude : coût, contexte, outils et vérifications de fiabilité. Gemini et Claude prennent tous deux en charge des charges de travail applicatives sérieuses, mais ils font des arbitrages différents en matière d’unités de prix, de fenêtres de contexte, d’appel d’outils, de sortie structurée, de traitement par lots, de mise en cache, de limites de débit et de vérification opérationnelle. Une politique de routage doit rendre ces arbitrages explicites avant le déplacement du trafic.
Ce guide fournit aux équipes une liste de contrôle appuyée par des sources pour décider quand router vers Gemini, quand router vers Claude, et quand placer les deux derrière une passerelle compatible avec OpenAI comme Flatkey. Utilisez-le avant une migration, le lancement d’un agent, une revue du coût des prompts ou un déploiement de solution de secours.
Si vous êtes encore en train de choisir le modèle de passerelle lui-même, associez cet article aux guides de Flatkey sur l’utilisation d’une API IA unifiée et l’utilisation d’une alternative à l’API OpenAI. Si la question principale est la mesure, commencez d’abord par le cadre des métriques des API de routage IA.
La réponse rapide pour le routage API Gemini vs Claude
Utilisez Gemini comme première route lorsque la charge de travail est sensible au prix, à contexte large, multimodale ou adaptée au traitement par lots, et que votre jeu d’évaluation confirme une qualité de sortie acceptable. Utilisez Claude comme première route lorsque la charge de travail nécessite un raisonnement long et solide, un suivi rigoureux des instructions, une utilisation des outils avec un haut niveau de confiance, ou des fonctionnalités d’agent propres à Anthropic. Utilisez une route de passerelle lorsque l’application doit changer de modèle sans réécrire le code du SDK, comparer les journaux d’utilisation en un seul endroit ou garder prête une solution de secours testée.
| Question de routage | Le routage Gemini est généralement attrayant lorsque... | Le routage Claude est généralement attrayant lorsque... | Vérifier avant la mise en production |
|---|---|---|---|
| Coût | La tâche peut utiliser des modèles de type Flash / Flash-Lite, des remises sur le traitement par lots ou des unités d’entrée multimodales moins coûteuses. | La tâche justifie des tarifs par jeton plus élevés grâce à un meilleur taux d’acceptation, à moins de retries ou à un coût de revue plus faible. | Normalisez au coût par sortie acceptée, et non au prix d’entrée affiché. |
| Contexte | Vous avez besoin d’un contexte large pour des documents, des bases de code, des transcriptions ou des lots de récupération. | Vous avez besoin d’un raisonnement à long contexte avec la gamme actuelle de modèles Claude et les limites de sortie. | Testez la rétention, la discipline de citation, la latence et le mode de défaillance à des tailles de contexte réelles. |
| Outils | Vous avez besoin de l’appel de fonction ainsi que des options de l’écosystème d’outils natifs de Google. | Vous avez besoin des schémas d’utilisation d’outils de Claude pour les agents, les outils client, les outils serveur et les appels d’outils structurés. | Exécutez le même schéma d’outil et vérifiez les arguments, les retries et les appels invalides. |
| Sortie structurée | Vous avez besoin du respect du schéma JSON pour des flux applicatifs typés. | Vous avez besoin de contrôles de sortie JSON ou de schémas stricts d’utilisation d’outils pour la conformité au schéma. | Validez la sortie analysée par rapport à votre schéma, pas seulement sa conformité visuelle. |
| Fiabilité | Vous pouvez absorber la variabilité des limites de débit du fournisseur grâce à la mise en file d’attente ou à un repli. | Vous pouvez absorber les limites d’Anthropic et la surcharge de jetons des outils avec des contrôles de déploiement progressif. | Consignez le fournisseur, le modèle, les comptes de jetons, la latence, le statut et la raison du repli. |
En bref : le gagnant n’est rarement pas « Gemini » ou « Claude » à l’échelle globale. Le gagnant est le routage qui passe vos vérifications spécifiques à la charge de travail avec le coût par sortie acceptée le plus faible et le moins de surprises opérationnelles.
Normaliser le coût avant de comparer les prix des modèles
La partie la plus difficile du routage API Gemini vs Claude est que les pages de tarification ne sont pas structurées de la même façon. Google affiche les prix de Gemini par modèle, modalité, unité d’entrée/sortie, mode batch et parfois niveau de contexte. Anthropic affiche les prix de Claude par famille de modèles, jetons d’entrée/sortie, mise en cache des invites, traitement par lots et surcharge en jetons spécifique aux fonctionnalités.
Commencez par une feuille de calcul des coûts plutôt que par un débat :
| Champ de coût | Pourquoi c’est important |
|---|---|
| Jetons d’entrée | Les prompts longs, les documents récupérés, les schémas d’outils et les instructions système peuvent dominer le coût d’une requête. |
| Jetons de sortie | Les plans d’agent, les diffs de code, les charges utiles JSON et les résumés peuvent faire basculer le coût vers les jetons de complétion. |
| Écriture du cache et lecture du cache | Le cache de prompts Claude peut modifier l’économie pour un contexte répété ; le cache de contexte Gemini doit être vérifié lorsque le contexte répété est important. |
| Remise par lot | Google et Anthropic documentent tous deux des remises pour le traitement par lot, mais le lot n’est utile que lorsque des réponses différées sont acceptables. |
| Surcoût des outils | Les définitions d’outils, les schémas et les appels d’outils intermédiaires ajoutent des jetons. Anthropic documente explicitement les coûts en jetons liés à l’utilisation des outils ; les charges utiles d’outils Gemini nécessitent également un comptage mesuré des jetons. |
| Taux de retry | Un modèle moins cher peut devenir coûteux si la validation rejette davantage de sorties. |
| Coût de revue humaine | Pour les workflows de support, juridiques, financiers ou de revue de code, le taux d’acceptation peut compter davantage que le prix brut des jetons. |
Pour Gemini, gardez la page tarification de l’API Gemini ouverte pendant la construction de la feuille de calcul. À la date de cette vérification de source, Google liste des prix différents pour Gemini Flash, Flash-Lite, Pro, batch et les cas à paliers de contexte, y compris les nouvelles lignes Gemini 3.x et Gemini 2.5. Pour Claude, utilisez la page tarification de Claude d’Anthropic et tenez compte des niveaux de modèle, du cache des prompts, du comportement sur long contexte et du traitement par lot.
Pour un travail de tarification plus approfondi, utilisez les guides Flatkey sur la tarification de l’API Gemini et la tarification de l’API Claude comme compléments, puis ramenez les chiffres finaux dans cette feuille de routage.
La métrique de routage devrait être :
accepted_output_cost =
  (input_cost + output_cost + cache_write_cost + cache_read_cost + tool_overhead_cost + retry_cost)
  / accepted_outputs
Cette formule évite une erreur fréquente : choisir le prix d’entrée le plus bas affiché tout en ignorant des sorties plus longues, du JSON invalide, des retries d’outils ou un nettoyage manuel.
Vérifiez les fenêtres de contexte avec des charges utiles réelles
Les affirmations sur la fenêtre de contexte sont utiles, mais elles ne sont pas identiques au contexte exploitable. Un modèle peut accepter un grand contexte et pourtant rater une instruction enfouie, perdre le fil d’une entité, ralentir au-delà de votre SLA ou produire une réponse qui ne peut pas être validée.
La page des modèles Gemini de Google documente des options de modèles à long contexte, y compris Gemini 2.5 Flash avec une fenêtre de contexte de 1M de jetons. La page aperçu des modèles Claude d’Anthropic documente les limites actuelles de contexte et de sortie des modèles Claude, y compris un contexte de 1M de jetons pour plusieurs modèles actuels et une fenêtre plus petite pour les routes de classe Haiku. Ces chiffres comptent, mais la décision de routage doit provenir de tests.
Faites passer le même pack de contexte par les routes candidates :
- Une requête courte sans contexte récupéré.
- Une requête de longueur moyenne avec le pack de récupération typique.
- Une requête au p90 avec du contexte réel client ou de base de code.
- Une requête au pire cas, proche de votre limite.
- Une requête dégradée avec des fragments récupérés non pertinents.
Pour chaque exécution, consignez :
| Métrique de contexte | Ce qu’il faut capturer |
|---|---|
| Taux de réponses acceptées | La réponse a-t-elle passé votre grille d’évaluation ou votre validateur en aval ? |
| Latence au p50 / p90 / p99 | La longue requête est-elle restée dans le SLA du produit ? |
| Défaillances liées à la perte dans le contexte | Le modèle a-t-il ignoré des faits en position basse, des contraintes d’outil ou les instructions finales ? |
| Dérive de la longueur de sortie | Le contexte long a-t-il entraîné une verbosité inutile ou une sortie tronquée ? |
| Coût par sortie acceptée | La requête plus volumineuse a-t-elle été rentable ? |
Si Gemini gère tout le contexte à moindre coût mais nécessite davantage de relances, orientez vers lui les tâches plus étroites et réservez Claude aux raisonnements à haut risque. Si Claude obtient un meilleur taux d’acceptation sur le même pack de contexte long, son prix brut par jeton plus élevé peut malgré tout revenir moins cher après les coûts de revue et de relance.
Comparez directement l’appel d’outils et les sorties structurées
Les charges de travail d’agent échouent généralement de manière banale : un argument mal formé, une enum inventée, une clé supplémentaire dans le JSON, un appel d’outil effectué au mauvais moment, ou une réponse qui semble correcte mais ne peut pas être analysée. C’est pourquoi le routage API Gemini vs Claude nécessite des vérifications d’outils et de schéma, et pas seulement des scores de benchmark.
Google documente l’appel de fonctions pour connecter les modèles Gemini à des outils et renvoyer des paramètres, ainsi que les sorties structurées pour des réponses basées sur JSON Schema. Anthropic documente l’utilisation d’outils Claude pour les outils côté client et côté serveur, ainsi que les sorties structurées pour des réponses orientées schéma.
Utilisez un seul banc d’essai partagé :
| Test | Comportement attendu |
|---|---|
| Appel d’outil requis | Le modèle appelle l’outil correct et ne répond pas directement. |
| Cas sans outil | Le modèle refuse d’appeler un outil lorsque suffisamment d’informations sont déjà présentes. |
| Champ enum | Le modèle ne renvoie que les valeurs enum autorisées. |
| Objet imbriqué | Le modèle renseigne les champs imbriqués requis sans ajouter de champs non pris en charge. |
| Erreur d’outil | Le modèle réessaie, demande les données manquantes ou échoue avec élégance selon la politique. |
| Streaming | La sortie partielle ne casse pas votre analyseur ni l’expérience utilisateur. |
| Tentative d’injection | Le modèle suit la politique système et outil au lieu du texte récupéré hostile. |
Ne notez pas d’abord la réponse en langage naturel. Analysez la sortie, validez le JSON, inspectez les arguments d’outil, puis évaluez la réponse. La route qui produit la prose la plus séduisante peut quand même être la mauvaise pour un agent si elle entraîne davantage d’actions invalides.
Utilisez le traitement par lots et la mise en cache uniquement lorsque le flux de travail le permet
Les deux fournisseurs documentent des mécanismes de réduction des coûts qui peuvent modifier une décision de routage.
Le Batch API de Google est conçu pour les requêtes asynchrones à grand volume et documente un objectif de coût standard réduit de 50 % pour les charges de travail batch éligibles. La documentation des Message Batches d'Anthropic décrit également une réduction de coût de 50 % pour le traitement batch, avec la plupart des lots terminant en moins d'une heure et des limites de taille de requête documentées.
Le batch convient bien pour :
- La classification hors ligne.
- Les rattrapages de données.
- L'annotation de jeux de données.
- Les grandes séries d'évaluation.
- La génération de rapports hebdomadaires.
- La synthèse non urgente.
Le batch convient mal pour :
- Les tours de chat.
- Le support en temps réel.
- Les boucles internes d'agents de codage.
- Les nouvelles tentatives côté utilisateur.
- Tout flux de travail où une sortie obsolète est coûteuse.
La mise en cache a une forme différente. Si vos prompts répètent une politique volumineuse, une cartographie de base de code, un catalogue de produits ou un modèle de contrat, les lectures de cache peuvent rendre économiquement raisonnable un routage de meilleure qualité. Si les prompts sont le plus souvent uniques, la mise en cache peut ne pas aider. Pour Claude, la page tarifaire d'Anthropic inclut des multiplicateurs d'écriture et de lecture du cache de prompts ; pour Gemini, consultez la documentation et la ligne de tarification actuelles sur le caching de contexte avant de supposer que les économies s'appliquent à votre charge de travail.
La règle de routage doit être simple :
route_policy:
  realtime_user_request:
    primary: low_latency_model_that_passes_schema_tests
    fallback: safest_validated_model
    batch: false
  offline_backfill:
    primary: lowest_accepted_output_cost
    fallback: retry_later_or_second_provider
    batch: true
  repeated_context_agent:
    primary: best_cache_adjusted_acceptance_rate
    fallback: model_with_shorter_context_pack
    batch: false
Vérifications de fiabilité avant la mise en production d'un routage Gemini ou Claude
L'état des fournisseurs et les limites publiées ne sont que des points de départ. Google documente les limites de débit de Gemini selon des dimensions telles que les requêtes par minute, les jetons d'entrée par minute, les requêtes par jour et les limites basées sur les dépenses, avec des limites appliquées par projet et aucune garantie de capacité réelle. La documentation d'Anthropic décrit les contraintes de tarification, de contexte, d'outils, de mise en cache et de batch des modèles qui influencent le nombre d'appels que votre flux de travail peut envoyer en toute sécurité.
Avant le déplacement du trafic de production, exécutez une liste de contrôle du routage :
| Vérification | À vérifier |
|---|---|
| Authentification | La clé fournisseur directe ou la clé de passerelle est limitée au bon environnement. |
| ID du modèle | L’ID exact du modèle est à jour et pris en charge par la route du compte. |
| Structure de la requête | Les messages, outils, schéma JSON, streaming et champs de modalité correspondent à la route. |
| Limites de débit | La classe de trafic reste dans les contraintes de RPM, TPM, quotas journaliers et dépenses. |
| Mappage des erreurs | Les cas 400, 401, 403, 429, 5xx, timeout et de surcharge du fournisseur sont mappés vers un comportement applicatif exploitable. |
| Politique de repli | L’application sait quand réessayer la même route, changer de fournisseur, mettre en file d’attente ou échouer de manière fermée. |
| Journal des coûts | Chaque requête enregistre le modèle, les comptages de tokens, l’utilisation du cache, le mode batch, la latence, le statut et le coût. |
| Validateur de sortie | Le produit dispose d’un validateur pour le JSON, les appels d’outils, les citations ou l’exactitude propre à la tâche. |
Le guide de démarrage rapide de Flatkey montre le modèle du SDK OpenAI : conservez le SDK et modifiez le base_url pour https://router.flatkey.ai/v1. La présentation de l’API REST Flatkey documente le même URL de base compatible OpenAI, et l’index de la documentation Flatkey décrit une clé, un solde partagé, un catalogue de modèles, ainsi que de la documentation pour GPT, Claude, Gemini, DeepSeek et d’autres modèles. Après la première requête, le guide de démarrage rapide de Flatkey indique aux utilisateurs de vérifier les journaux d’utilisation pour le modèle, le nombre de tokens, la latence et le coût.
Flatkey est donc utile dans un déploiement de routage : vous pouvez conserver un format de requête stable dans l’application, comparer le comportement des routes Gemini et Claude dans les journaux d’utilisation, et promouvoir un repli testé sans disperser les clés fournisseurs entre les services.
Pour des modèles de planification de routage adjacents, comparez ce workflow avec la checklist Gemini API for agents de Flatkey et l’article DeepSeek vs Qwen API routing checks.
Une fiche d’évaluation pratique du routage
Utilisez cette fiche d’évaluation pour la décision finale. Attribuez à chaque ligne un score de 1 à 5 pour Gemini et Claude, puis pondérez selon la charge de travail.
| Critère | Poids | Score Gemini | Score Claude | Remarques |
|---|---|---|---|---|
| Coût de l’output accepté | 25% | Inclure les retries, le cache, le batch et la surcharge des outils. | ||
| Validité du schéma | 15% | Compter les échecs du parseur et les valeurs d’énumération invalides. | ||
| Précision des appels d’outils | 15% | Compter le mauvais outil, le champ manquant et l’utilisation inutile d’outils. | ||
| Fiabilité du contexte | 15% | Tester aux tailles de prompt p50, p90 et au pire des cas. | ||
| Latence | 10% | Mesurer la latence du streaming et de la réponse complète. | ||
| Marge de manœuvre face aux limites de taux | 10% | Vérifier les limites du projet/compte avant le lancement. | ||
| Récupération après échec | 10% | Vérifier les chemins de retry, de fallback et de revue humaine. |
Par exemple :
- Un pipeline de synthèse en arrière-plan pourrait accorder le poids le plus élevé au coût de l’output accepté et à la prise en charge du batch.
- Un agent de codage pourrait accorder le poids le plus élevé à la précision des appels d’outils, à la latence et à la fiabilité du contexte.
- Un workflow de support client pourrait accorder le poids le plus élevé à la validité du schéma, au comportement d’escalade et au coût de revue.
Le résultat de Gemini vs Claude API Routing doit être un fichier de politique, pas un compte rendu de réunion.
routes:
  support_triage:
    primary: gemini-or-claude-route-that-wins-scorecard
    fallback: second-provider-route
    validator: support_ticket_schema_v3
    retry_limit: 1
    fail_closed_when:
      - missing_required_field
      - unsafe_escalation_label
  code_review_agent:
    primary: route-that-wins-tool-and-context-tests
    fallback: route-with-best-safe-summary
    validator: diff_comment_schema_v2
    retry_limit: 0
    fail_closed_when:
      - tool_argument_invalid
      - repository_path_not_in_context
Comment exécuter une comparaison Flatkey sûre
Flatkey ne remplace pas l’évaluation. C’est le plan de contrôle qui facilite l’évaluation et le déploiement.
- Choisissez un workload, comme le triage du support, les commentaires de revue de code, la synthèse de rapports ou l’extraction.
- Construisez un ensemble figé de 50 à 200 prompts réels avec des règles de sortie attendues.
- Choisissez un route Gemini et un route Claude dans le catalogue de modèles actuel.
- Envoyez les deux via le même format de requête compatible OpenAI lorsque c’est possible.
- Consignez les comptes de tokens, la latence, le statut, le fournisseur, le modèle, le coût et le résultat du validateur.
- Comparez le coût par output accepté, et non le prix par million de tokens.
- Déployez le gagnant comme primaire et gardez l’autre comme solution de secours surveillée.
- Relancez le test après des changements de tarification du fournisseur, d’ID de modèle, de limites de contexte ou d’état de santé de la route.
C’est là qu’une passerelle mérite son prix. Si l’application utilise déjà un client compatible OpenAI, Flatkey peut rendre le premier test aussi petit qu’un changement de base_url plus un changement de sélection de modèle. Si la route échoue, vous revenez à la politique de route au lieu de réécrire le code de l’application.
Erreurs courantes dans le routage API Gemini vs Claude
Erreur 1 : comparer uniquement les modèles phares.
La plupart des workflows de production n’ont pas besoin du modèle le plus coûteux pour chaque requête. Comparez les classes de routage : rapide, économique, long contexte, forte capacité de raisonnement, lot et secours.
Erreur 2 : ignorer les schémas d’outils.
Les prompts d’agent incluent souvent de grandes définitions d’outils. Mesurez ces tokens et validez les arguments des outils.
Erreur 3 : prendre la fenêtre de contexte pour la qualité de la réponse.
Une fenêtre de contexte plus grande n’est utile que lorsque le modèle utilise de manière fiable les bonnes parties de celle-ci.
Erreur 4 : oublier la sémantique de secours.
Un modèle de secours peut être pire que pas de secours du tout s’il change la forme de sortie, ignore les outils requis ou enfreint une politique produit.
Erreur 5 : publier un routage sans revue des journaux d’utilisation.
Vos journaux doivent afficher le modèle réel, les comptes de tokens, la latence, le statut, le coût et la raison du basculement. Si ces champs sont absents, vous ne pouvez pas déboguer le routage sous charge.
FAQ
Gemini est-il moins cher que Claude ?
Parfois, mais pas toujours après validation. Gemini propose souvent des tarifs affichés attractifs pour les charges de travail de type Flash, tandis que Claude peut l’emporter lorsque un taux d’acceptation plus élevé, moins de relances, un meilleur comportement des outils ou un coût de revue plus faible compensent des tarifs de tokens plus élevés. Utilisez les pages de tarification des fournisseurs et calculez le coût par sortie acceptée.
Claude est-il meilleur que Gemini pour l’appel d’outils ?
Pas universellement. Claude dispose d’une documentation solide sur l’utilisation des outils et de schémas orientés agent, tandis que Gemini prend en charge l’appel de fonctions et les sorties structurées. La bonne réponse dépend de votre schéma d’outils, de la gestion des erreurs, des besoins de streaming et des résultats du validateur.
Dois-je faire passer chaque requête d’abord par un seul fournisseur ?
En général non. Répartissez le trafic par classe de charge de travail. Un routage batch peu coûteux, un routage de chat en temps réel, un routage long contexte et un routage de secours peuvent tous utiliser des modèles différents.
Les API batch rendent-elles les routes temps réel moins chères ?
Non. Les remises batch aident les charges de travail différées. Elles n’aident pas un utilisateur qui attend une réponse de chat, de support ou d’agent de codage.
Pourquoi utiliser Flatkey pour le routage API Gemini vs Claude ?
Utilisez Flatkey lorsque vous souhaitez un plan de contrôle unique, compatible OpenAI, pour la sélection des modèles, les journaux d’utilisation, la revue des coûts et le déploiement du basculement. C’est particulièrement utile lorsqu’une application utilise déjà un SDK de type OpenAI et doit comparer Gemini et Claude sans disperser les clés fournisseurs et les vues de facturation entre plusieurs services.
Synthèse finale
Routage API Gemini vs Claude : coût, contexte, outils et vérifications de fiabilité n’est pas une comparaison ponctuelle de fournisseurs. C’est un workflow opérationnel. Commencez par les tarifs et la documentation officielle des modèles, testez le contexte et le comportement des outils sur des invites réelles, évaluez le coût par sortie acceptée et gardez une politique de secours prête avant que le trafic de production n’arrive.
Si votre équipe souhaite comparer Gemini et Claude derrière une seule passerelle compatible OpenAI, commencez par le guide de démarrage rapide Flatkey, choisissez les candidats de routage dans le catalogue des modèles actuel, et vérifiez les premiers appels dans les journaux d’utilisation avant d’augmenter le trafic.