« LLM Rate Limits Explained: RPM, TPM, and Retries » est d’abord un sujet de fiabilité de production, avant d’être un réglage SDK. Les limites de débit déterminent combien de requêtes, de jetons, de jobs ou de générations simultanées votre application peut faire passer via un fournisseur ou une passerelle dans une fenêtre temporelle. Les retries déterminent ce qui se passe lorsqu’une limite est atteinte. La mauvaise politique de retry peut transformer une petite rafale en panne prolongée.
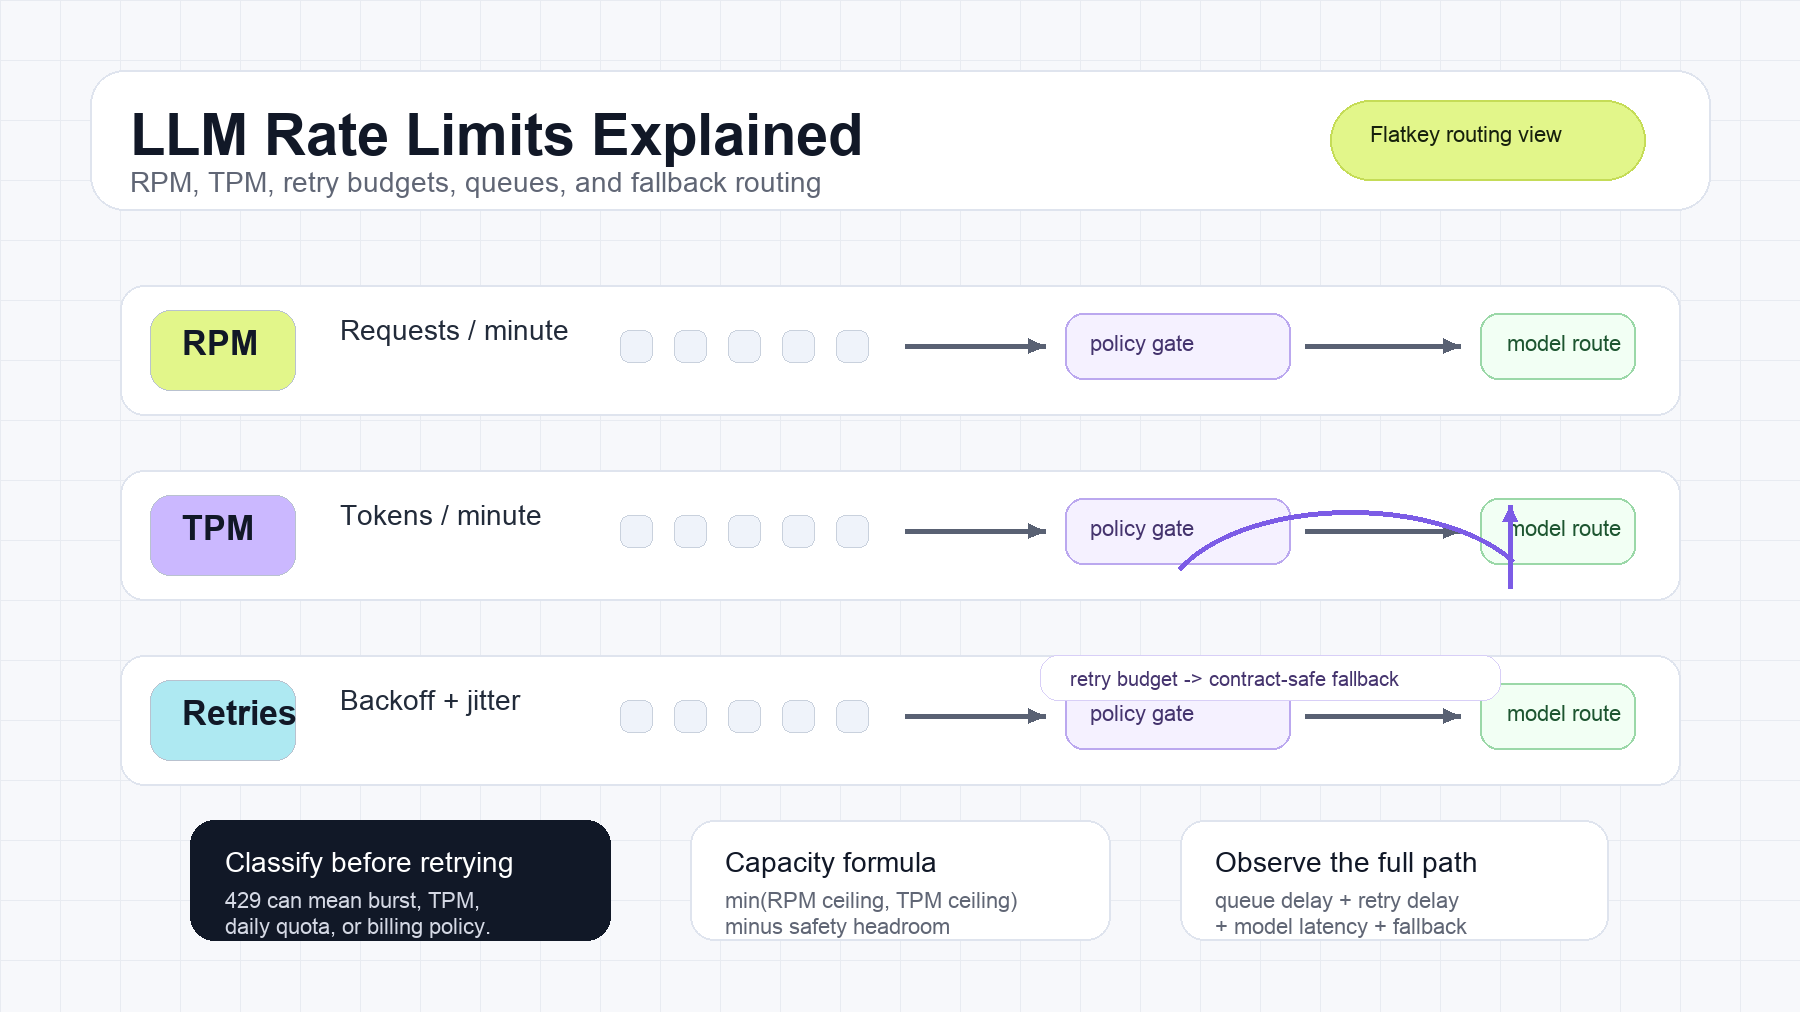
La règle pratique est simple : le RPM contrôle la fréquence des requêtes, le TPM contrôle le débit de jetons, la concurrence contrôle le travail en cours, et les retries consomment la même capacité rare sauf s’ils sont bornés. Un système de production doit d’abord identifier la ressource contrainte, puis choisir entre l’étalement, la mise en file d’attente, la réduction des jetons, une nouvelle tentative brève, ou le routage vers un autre modèle compatible en contrat.
Ce guide considère LLM Rate Limits Explained: RPM, TPM, and Retries comme un manuel d’exploitation pour les équipes produit et plateforme IA. Il couvre les termes, les calculs de capacité, la politique de retry, les champs d’observabilité, et les contrôles de passerelle à la Flatkey qui empêchent les limites de débit des API LLM de devenir un incident client.
Réponse rapide sur LLM Rate Limits Explained: RPM, TPM, and Retries
Utilisez ce tableau lorsque vous traitez un incident de limite de débit LLM.
| Signal | Ce qu’il mesure | Symptôme typique | Premier contrôle |
|---|---|---|---|
| RPM | Requêtes admises par minute ou par fenêtre définie par le fournisseur | De nombreux petits appels échouent avec 429 |
Échelonner les requêtes, mettre les rafales en file d’attente, regrouper les petites tâches |
| TPM | Jetons d’entrée et/ou de sortie admis par minute ou par fenêtre | Les prompts longs, les sorties longues ou les exécutions d’évaluation sont bridés | Réserver les jetons, raccourcir le contexte, plafonner la sortie |
| RPD / TPD | Requêtes ou jetons admis par jour | Le travail s’arrête jusqu’à la réinitialisation du quota | Arrêter les retries, replanifier, demander un niveau supérieur |
| Concurrence | Requêtes ou jobs en cours simultanément | Les générations lentes s’accumulent même avec un RPM modeste | Bornes sur les workers, ajout de backpressure |
| Budget de retry | Quantité de travail supplémentaire qu’un appelant peut consommer après un échec | Tempête de retries, latence gonflée, effets de bord dupliqués | Limiter les tentatives, le temps écoulé et les statuts retentables |
| Route de secours | Modèle ou fournisseur alternatif éligible | La route principale est contrainte, mais le produit a toujours besoin d’une sortie | Router uniquement si la capacité, la politique et le coût conviennent |
LLM Rate Limits Explained: RPM, TPM, and Retries se résume à une décision d’exploitation : ne retryez pas à l’aveugle. Un 429 n’est pas une instruction pour renvoyer immédiatement la même requête. C’est le signal qu’un bucket de capacité, une politique de quota, un état de facturation ou un mécanisme de protection du fournisseur a rejeté la requête.
Pourquoi les limites de débit existent
Les fournisseurs appliquent des limites de débit des API LLM pour protéger la capacité partagée, empêcher les comptes incontrôlés et maintenir la cohérence de la facturation ou de la politique de niveau de service. OpenAI, Anthropic et Gemini documentent tous des concepts de limite de débit, mais exposent des noms de buckets, des périmètres, des en-têtes et des tableaux de bord différents. OpenAI documente les limites de débit et recommande aux clients de gérer les erreurs de limite avec du backoff. Anthropic documente les limites de dépense au niveau de l’organisation et de l’espace de travail, ainsi que des limites de débit au niveau du modèle pouvant inclure les requêtes et les jetons. Gemini documente des niveaux avec des concepts de limites de requêtes, de jetons et journalières.
Ces contrôles côté fournisseur sont nécessaires, mais ils ne constituent pas une politique produit complète. Ils répondent généralement à la question côté fournisseur : « Ce projet peut-il envoyer plus de trafic maintenant ? » Votre application doit encore répondre aux questions côté produit :
- Quel client, espace de travail, équipe ou fonctionnalité a provoqué la rafale ?
- La ressource contrainte était-elle les requêtes, les jetons d’entrée, les jetons de sortie, la concurrence, le quota journalier ou la dépense ?
- Cette charge de travail doit-elle attendre, se dégrader, réduire son rythme ou échouer rapidement ?
- Une route de secours est-elle autorisée par la capacité, la politique de données, le prix et le contrat client ?
- Les retries aggravent-ils la limite ?
Pour les contrôles de quota adjacents, associez cet article à AI API quota management et AI API spend management.
Le RPM, le TPM et la concurrence sont des limites différentes
Les équipes traitent souvent les limites de débit comme un seul nombre. Cela masque le vrai goulot d’étranglement.
RPM : requêtes par minute
Le RPM limite le nombre de requêtes admises pendant une fenêtre temporelle définie par le fournisseur. Les petits prompts, les checks de santé, les boucles d’outils d’agents et les jobs d’évaluation à forte diffusion sollicitent généralement d’abord le RPM. Une charge de travail peut être bien en dessous du TPM et quand même atteindre le RPM si elle envoie trop de petites requêtes.
TPM : jetons par minute
Le TPM limite le débit de jetons. Selon le fournisseur et le modèle, la limite peut prendre en compte les jetons d’entrée, les jetons de sortie, les jetons mis en cache, ou des buckets d’entrée et de sortie séparés. La récupération en contexte long, l’historique de conversation, les sorties verbeuses, la génération multi-candidats et les évaluations parallèles sollicitent généralement le TPM avant le RPM.
Concurrence : travail en cours
La concurrence n’est pas le RPM. Un système peut envoyer seulement 60 requêtes par minute et avoir malgré tout une concurrence élevée si chaque génération prend 20 secondes. Le streaming et les appels d’outils longs rendent cela visible. Des pools de workers bornés et la profondeur de file d’attente sont généralement de meilleurs contrôles que davantage de retries.
Limites journalières et limites de dépense
Certaines limites ne se rétablissent pas après un court sommeil. Les limites quotidiennes de requêtes, les limites quotidiennes de jetons, les limites mensuelles de dépenses et les restrictions de facturation devraient généralement arrêter les retries. L’action correcte consiste à replanifier, augmenter le niveau, ajuster le budget ou indiquer à l’utilisateur que la capacité est épuisée.
Pourquoi vous pouvez obtenir un 429 en dessous de la limite annoncée
Une limite publiée telle que « 1 000 RPM » signifie rarement qu’un client peut envoyer 1 000 requêtes dans la première seconde d’une minute. Les fournisseurs peuvent appliquer des fenêtres glissantes, des token buckets, des pools de modèles, des règles de burst spécifiques au niveau, des limites d’accélération ou des quotas de projet partagés.
Une requête peut recevoir 429 Too Many Requests même lorsqu’un compteur local semble sûr, parce que :
- Plusieurs workers, utilisateurs, services ou environnements partagent la même limite de compte.
- Les jetons d’entrée et de sortie sont comptés dans des compartiments différents.
- Un modèle a un pool plus restreint qu’un autre modèle.
- Les retries provenant d’échecs précédents consomment encore de la capacité de requêtes.
- La montée en charge du trafic est trop rapide pour les contrôles d’accélération.
- Une règle quotidienne, de dépenses, d’espace de travail ou de niveau de service est active.
- Le fournisseur renvoie un
429générique pour plusieurs politiques de capacité.
C’est pourquoi Comprendre les limites de débit des LLM : RPM, TPM et retries devrait commencer par la classification, pas par le code. Journalisez le code d’état, le type d’erreur du fournisseur, les en-têtes de réponse, le modèle, le compte ou projet, l’estimation de jetons, les jetons réels, le numéro de tentative, le délai dans la file d’attente et l’ID de requête du fournisseur lorsqu’il est disponible.
Formule de planification de capacité
Commencez par des plafonds indépendants pour les requêtes et les jetons, puis opérez en dessous du maximum.
request_ceiling = RPM * safety_factor

token_ceiling = (TPM * safety_factor) / average_total_tokens_per_request

safe_requests_per_minute = min(request_ceiling, token_ceiling)
Utilisez un facteur de sécurité tel que 0.70 à 0.90, selon la variance des jetons, les consommateurs partagés, le comportement des retries et le coût d’un objectif de latence manqué.
Exemple :
RPM = 1,000
TPM = 2,000,000
average_total_tokens_per_request = 4,000
safety_factor = 0.80

request_ceiling = 1,000 * 0.80 = 800 requests/minute

token_ceiling = (2,000,000 * 0.80) / 4,000 = 400 requests/minute

safe_requests_per_minute = min(800, 400) = 400 requests/minute
Dans cet exemple, le TPM est la contrainte limitante. Ajouter davantage de workers n’augmentera pas le débit soutenable. Cela créera davantage d’attente en file, davantage de retries ou davantage d’erreurs 429.
Pour les systèmes en ligne, traduisez le débit de requêtes sûr en point de départ pour la concurrence :
target_concurrency ~= requests_per_second * average_request_seconds
Si le débit sûr est de 400 requêtes par minute, cela représente environ 6,67 requêtes par seconde. Si la latence moyenne du modèle est de 3 secondes, une concurrence de départ est d’environ 20. Ajustez en fonction de la latence p95 et p99, pas seulement des moyennes.
Réservation de jetons pour la sécurité TPM
Les incidents liés au TPM proviennent souvent d’une planification trop optimiste. L’application accepte le travail en fonction des jetons attendus, mais le modèle produit une sortie plus longue que prévu.
Un ordonnanceur plus sûr réserve les jetons avant d’envoyer la requête :
reservation:
  workload: support_answer
  model_route: primary_chat_route
  request_id: req_8f3a
  estimated_input_tokens: 3200
  max_output_tokens: 900
  reserved_total_tokens: 4100
  reservation_expires_at: 2026-10-10T11:03:00Z
Après la réponse, rapprochez les jetons réservés des jetons réels :
actual_usage:
  input_tokens: 3014
  output_tokens: 622
  total_tokens: 3636
  retry_attempts: 0
  accepted_result: true
Réservez sur la base du p95 ou d’estimations spécifiques à la charge de travail pour la production. Utilisez l’utilisation réelle pour l’attribution des coûts et les prévisions. Cette séparation rend les limites de débit de l’API LLM plus faciles à exploiter : le contrôle d’admission utilise une estimation sûre, tandis que la finance et le produit examinent le coût réel par résultat accepté.
Un arbre de décision pour les limites de débit
Lorsqu’une requête est rejetée ou qu’une file grossit, déterminez le contrôle à appliquer à partir de la cause.
Did the provider return Retry-After or a reset header?
  yes -> wait for the hint if it fits the caller latency budget
  no  -> use bounded exponential backoff with jitter for transient classes

Is the cause daily quota, billing, permission, or hard spend limit?
  yes -> do not retry; fail, reschedule, or request capacity
  no  -> continue

Is RPM the binding constraint?
  yes -> pace requests, batch small work, or queue low priority traffic
  no  -> continue

Is TPM the binding constraint?
  yes -> shorten context, cap output, reserve tokens, or delay long jobs
  no  -> continue

Is concurrency the binding constraint?
  yes -> reduce workers, set queue deadlines, and apply backpressure
  no  -> continue

Is an eligible fallback route healthy and policy-approved?
  yes -> route after the retry budget is spent
  no  -> return a controlled failure
Cet arbre de décision est l’actif de valeur pour Comprendre les limites de débit des LLM : RPM, TPM et retries. Il évite que la gestion des 429 ne devienne une boucle sans fin, et transforme Comprendre les limites de débit des LLM : RPM, TPM et retries d’un sujet de définitions en un flux de travail de réponse aux incidents.
Comment utiliser Retry-After
HTTP Retry-After indique au client combien de temps attendre avant d’effectuer une autre requête. La RFC le définit soit comme un délai en secondes, soit comme une date HTTP. La référence MDN de 429 Too Many Requests décrit également l’utilisation de Retry-After pour indiquer quand le client peut réessayer.
Règles pratiques :
- Respectez un
Retry-Aftervalide lorsqu’il s’inscrit dans le budget de latence de l’appelant. - Plafonnez les valeurs très longues pour les appels interactifs ; ne laissez pas une requête utilisateur ouverte indéfiniment.
- Traitez les valeurs invalides ou manquantes comme une raison d’utiliser un backoff côté client.
- Ne réessayez pas des causes non réessayables simplement parce que
Retry-Afterest absent. - Enregistrez l’indication du fournisseur et le délai réellement utilisé.
Pour les flux utilisateur interactifs, le budget de retry est souvent plus petit que l’indication du fournisseur. Dans ce cas, échouez rapidement avec un message utile ou redirigez ailleurs. Pour les traitements par lot, une mise en file d’attente peut être préférable au renvoi d’une erreur.
Backoff exponentiel avec jitter
Le backoff exponentiel augmente le délai après chaque tentative échouée. Le jitter randomise ce délai afin que les workers ne se synchronisent pas et ne réessaient pas ensemble. Les recommandations AWS sur le backoff et le jitter sont utiles car elles expliquent pourquoi un backoff exponentiel plafonné classique peut encore provoquer des regroupements de retries en l’absence d’aléa.
Une formule courante de full jitter :
delay_ms = random(0, min(cap_ms, base_ms * 2^attempt))
Une politique de retry en production doit prévoir davantage que la seule formule de délai :
| Champ de politique | Contrôle recommandé |
|---|---|
| Statuts réessayables | 429, certains 5xx et les échecs réseau transitoires |
| Statuts non réessayables | erreurs de validation, erreurs d’authentification, erreurs d’autorisation, erreurs de facturation, épuisement du quota quotidien |
| Nombre maximal de tentatives | Petit nombre pour les appels interactifs ; plus élevé uniquement pour les jobs hors ligne |
| Temps écoulé maximal | Borné par le budget de latence visible par l’utilisateur ou la deadline du job |
| Jitter | Requis pour les systèmes multi-workers |
| Retry-After | À utiliser lorsqu’il est valide et acceptable |
| Annulation | Arrêter immédiatement lorsque l’appelant interrompt |
| Observabilité | Nombre de tentatives, temps d’attente, statut final, ID de requête, délai de file d’attente |
Les requêtes infructueuses peuvent malgré tout consommer de la capacité de rate limit. C’est pourquoi les retries doivent faire partie de la planification des rate limits, et non être une réflexion tardive.
Helper de retry TypeScript pour les API compatibles OpenAI
Ce helper utilise Retry-After lorsqu’il est présent, sinon le full jitter. Il s’arrête lorsque le nombre de tentatives ou le temps écoulé est épuisé.
type ChatRequest = {
  model: string;
  messages: Array<{ role: "system" | "user" | "assistant"; content: string }>;
  max_tokens?: number;
};

const sleep = (milliseconds: number) =>
  new Promise((resolve) => setTimeout(resolve, milliseconds));

function retryAfterMilliseconds(response: Response): number | null {
  const value = response.headers.get("retry-after");
  if (!value) return null;

  const seconds = Number(value);
  if (Number.isFinite(seconds)) return Math.max(0, seconds * 1_000);

  const date = Date.parse(value);
  return Number.isNaN(date) ? null : Math.max(0, date - Date.now());
}

export async function createChatCompletion(
  apiKey: string,
  request: ChatRequest,
  options: { maxAttempts?: number; maxElapsedMs?: number } = {},
) {
  const maxAttempts = options.maxAttempts ?? 4;
  const maxElapsedMs = options.maxElapsedMs ?? 30_000;
  const startedAt = Date.now();

  for (let attempt = 0; attempt < maxAttempts; attempt += 1) {
    const response = await fetch("https://router.flatkey.ai/v1/chat/completions", {
      method: "POST",
      headers: {
        Authorization: `Bearer ${apiKey}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify(request),
    });

    if (response.ok) return response.json();

    const retryable = response.status === 429 || response.status >= 500;
    const finalAttempt = attempt === maxAttempts - 1;
    if (!retryable || finalAttempt) {
      throw new Error(`La requête LLM a échoué avec ${response.status} : ${await response.text()}`);
    }

    const serverDelay = retryAfterMilliseconds(response);
    const exponentialCap = Math.min(8_000, 500 * 2 ** attempt);
    const jitteredDelay = Math.random() * exponentialCap;
    const delayMs = serverDelay ?? jitteredDelay;

    if (Date.now() + delayMs - startedAt >= maxElapsedMs) {
      throw new Error("Budget de retry LLM épuisé");
    }

    await sleep(delayMs);
  }

  throw new Error("État de retry inatteignable");
}
Ajoutez des timeouts de requête, des classes d’erreur structurées, de la télémétrie et l’annulation avant utilisation en production. Si l’appel peut créer des effets de bord externes, rendez l’opération métier idempotente avant de réessayer.
Réessayer, mettre en file, réduire ou router ?
Un système résilient dispose de plus d’une réponse au throttling.
| Situation | Retry | File d’attente | Réduire les jetons | Rediriger ailleurs |
|---|---|---|---|---|
Un seul 429 transitoire et bref |
Oui, de façon bornée | Facultatif | Non | Généralement non |
| Épuisement soutenu du RPM | Très limité | Oui | Généralement non | Parfois |
| Épuisement soutenu du TPM | Très limité | Oui | Oui | Parfois |
| Quota quotidien épuisé | Non | Seulement si une réinitialisation ultérieure est acceptable | Non | Peut-être |
| Erreur de facturation ou d’autorisation | Non | Non | Non | Non, corrigez d’abord l’accès |
| Surcharge du fournisseur avec solution de secours saine | Brièvement | Facultatif | Non | Oui, après vérification de la politique |
| Flux partiel déjà livré | Généralement pas de reprise | Peut-être continuer ou redémarrer explicitement | Peut-être | Uniquement avec une sémantique claire |
La mise en file d’attente protège le fournisseur et l’expérience utilisateur lorsque le travail peut attendre. La réduction des jetons protège le TPM. Le routage protège la disponibilité uniquement lorsque le chemin alternatif satisfait le même contrat produit.
Pour les schémas spécifiques à la surcharge, utilisez le playbook API Error 529 overloaded. Pour les implications sur les coûts, reliez le comportement de retry et de fallback à AI gateway pricing et à how to compare AI model prices.
Les limites de débit dans les évaluations de modèles
Les limites de débit peuvent invalider une comparaison de modèles.
Si le modèle A est testé avec 10 workers et le modèle B avec 100 workers, le modèle B peut sembler plus lent parce que le banc d’essai a provoqué de la mise en file d’attente et des retries. Cette mesure en dit plus sur la configuration du test que sur la latence du modèle.
Pour des évaluations défendables :
- Séparez la latence du modèle, le délai de file d’attente et le délai de retry.
- Utilisez le même processus d’arrivée ou un niveau d’utilisation normalisé pour chaque route.
- Réchauffez progressivement le trafic lorsque les fournisseurs utilisent des contrôles d’accélération.
- Consignez les jetons et les tentatives par tâche terminée.
- Indiquez séparément le taux de réussite au premier essai et le taux de réussite final.
- Comparez le coût par tâche acceptée, pas seulement le prix des jetons.
- Exécutez les tests de surcharge séparément des tests de qualité.
C’est particulièrement important pour les comptes gratuits ou de faible niveau. L’article free LLM APIs est utile pour le contexte, car les limites gratuites sont souvent conçues pour l’exploration, et non pour une charge de production.
Métriques à surveiller pour les alertes
Suivez ces métriques par fournisseur, modèle, route, locataire, charge de travail et environnement :
- Requêtes par minute.
- Jetons d’entrée par minute et jetons de sortie par minute.
- Jetons estimés réservés versus jetons réellement utilisés.
- Profondeur de la file d’attente et ancienneté de l’élément le plus ancien en attente.
- Temps d’attente pour la capacité de débit.
- Taux de réussite au premier essai.
- Tentatives de retry par requête réussie.
- Taux de
429par cause classée. - Amplification des retries : total des tentatives divisé par les résultats réussis.
- Taux de fallback et résultat du fallback.
- Latence de bout en bout p50, p95 et p99.
- Coût par tâche réussie ou acceptée.
Les conventions sémantiques d’IA générative d’OpenTelemetry peuvent aider à standardiser la télémétrie du modèle, de l’opération, des jetons, des réponses et des erreurs. Conservez aussi les dimensions propres au produit : client, espace de travail, classe de trafic, environnement, fonctionnalité et propriétaire.
Une alerte basée uniquement sur le nombre total de 429 est bruyante. Un meilleur signal combine le taux de throttling, l’âge de la file d’attente, l’amplification des retries et le taux final d’échec.
Une architecture de limites de débit en production
Un chemin de requête robuste comporte généralement sept couches de contrôle :
client
  -> contrôle d’admission
  -> file d’attente prioritaire
  -> réservation de jetons
  -> limiteur RPM + TPM
  -> route fournisseur/modèle
  -> contrôleur de retry borné
  -> fallback sûr pour le contrat
  -> registre d’utilisation, de coût et de latence
Utilisez le contrôle d’admission lorsque la file d’attente ne peut pas respecter l’échéance de l’appelant. Utilisez des files d’attente prioritaires pour que les évaluations non critiques ne prennent pas la place du trafic de production. Utilisez la réservation de jetons pour maintenir la rigueur du TPM. Utilisez un contrôleur de retry centralisé afin que les couches SDK, file d’attente, passerelle et worker ne relancent pas toutes indépendamment.
Le registre d’utilisation doit enregistrer :
rate_limit_event:
  request_id: req_8f3a
  workspace_id: ws_42
  environment: production
  workflow: support_answer
  route_requested: primary_chat_route
  route_final: fallback_chat_route
  estimated_input_tokens: 3200
  max_output_tokens: 900
  actual_input_tokens: 3014
  actual_output_tokens: 622
  attempt_count: 2
  retry_delay_ms: 740
  queue_delay_ms: 1180
  final_status: success
  classified_limit: transient_rpm_burst
  accepted_result: true
Cela rend les limites de débit des API LLM auditables après l’incident. Cela donne aussi aux équipes finance et produit les éléments nécessaires lorsque les retries ou les fallbacks modifient le coût par résultat accepté.
Comment Flatkey s’intègre
Flatkey offre aux équipes une seule clé API et une URL de base compatible avec OpenAI pour les routes de modèles prises en charge. Cela ne supprime pas les limites de débit LLM en amont. Cela donne aux équipes une surface d’intégration unique où le routage, la revue d’utilisation et les politiques peuvent être rendus cohérents entre les fournisseurs.
Pour le workflow LLM Rate Limits Explained: RPM, TPM, and Retries, une couche de passerelle est utile lorsque :
- Votre application a besoin d’une politique unique de retry, de file d’attente et de repli, au lieu d’une logique par fournisseur dispersée entre les services.
- Les équipes produit doivent pouvoir comparer, dans un seul registre, la santé des routes, la latence, les tokens et le coût des résultats acceptés.
- Les équipes plateforme ont besoin de listes d’autorisation de modèles, de budgets par sous-clé et de contrôles d’utilisation par environnement ou flux de travail.
- La finance a besoin d’un seul solde, d’une seule facture et d’éléments de preuve au niveau des requêtes, plutôt que de tableaux de bord fournisseurs déconnectés.
- Les opérateurs doivent pouvoir déplacer le trafic éligible lorsqu’une route est contrainte, sans réécrire le SDK de l’application.
La passerelle doit toutefois préserver les contrats spécifiques aux modèles. Ne routez pas d’un modèle vers un autre sauf si la fenêtre de contexte, le comportement des outils, la sortie structurée, la politique de sécurité, les contrôles des données, la latence et le coût sont acceptables pour cette charge de travail. Vérifiez la disponibilité actuelle des routes et les tarifs dans le répertoire de modèles Flatkey et la tarification Flatkey avant le lancement en production.
Erreurs courantes
Considérer le RPM comme de la concurrence
Le RPM mesure les admissions dans le temps. La concurrence mesure le travail en cours. Des générations lentes peuvent créer une forte concurrence avec un RPM modeste.
Réessayer immédiatement chaque 429
Les retries immédiats synchronisent les workers et consomment davantage de capacité. Respectez Retry-After lorsqu’il est valide, ajoutez du jitter et plafonnez le budget de retry.
Utiliser un seul limiteur pour tous les modèles
Les fournisseurs peuvent utiliser des pools de modèles distincts ou des pools de compte partagés. Le limiteur doit suivre le périmètre de quota documenté et les en-têtes de réponse observés.
Ignorer les consommateurs partagés
Un tableau de bord, un moteur d’évaluation, un agent de codage et une API de production peuvent partager un même projet. Réservez la capacité par charge de travail et isolez le trafic critique autant que possible.
Réessayer des flux partiels
Une fois que des tokens ont atteint l’utilisateur ou qu’une action d’outil a été exécutée, une relecture silencieuse peut dupliquer la sortie ou les effets de bord. Définissez explicitement la sémantique de continuation, de redémarrage ou d’idempotence.
Mesurer uniquement la latence du fournisseur
La latence ressentie par l’utilisateur final inclut le délai de file d’attente, le délai de retry, le délai de repli et la latence du modèle. Alertez sur l’ensemble du parcours et gardez les composantes séparées.
FAQ
Quelle est la différence entre le RPM et le TPM ?
Le RPM limite le nombre de requêtes admises dans le temps. Le TPM limite le nombre de tokens d’entrée et/ou de sortie admis. Les petits prompts atteignent généralement d’abord le RPM ; les charges à long contexte ou à forte sortie atteignent souvent d’abord le TPM.
Pourquoi ai-je des erreurs 429 en dessous de ma limite de RPM ?
Le fournisseur peut appliquer des fenêtres glissantes, des token buckets, des quotas de compte partagés, des limites de tokens séparées, des pools spécifiques à un modèle, des limites journalières ou des contrôles d’accélération. Votre compteur de requêtes local ne représente peut-être pas l’ensemble du périmètre du quota.
Dois-je réessayer chaque 429 ?
Non. Réessayez les limitations temporaires avec un petit budget et du jitter. Ne réessayez pas de façon répétée l’épuisement du quota journalier, les restrictions de facturation, les erreurs d’autorisation, les erreurs de validation ou une surcharge soutenue sans fenêtre de rétablissement réaliste.
Le backoff exponentiel garantit-il le succès ?
Non. Le backoff réduit les collisions et laisse le temps à la capacité transitoire de se rétablir. Il ne peut pas créer de quota. Un épuisement persistant nécessite une demande plus faible, davantage de capacité, un travail différé ou une autre route éligible.
Les retries comptent-ils dans les limites de débit ?
Oui, cela peut arriver. Les fournisseurs peuvent compter les requêtes ou tentatives infructueuses dans les limites actives, donc la multiplication des retries doit être surveillée et bornée.
Combien de retries une requête LLM doit-elle utiliser ?
Il n’existe pas de nombre universel. Définissez le nombre de tentatives à partir du budget de latence visible pour l’utilisateur et du mode de défaillance. Les applications interactives n’ont généralement besoin que de quelques tentatives courtes avant d’échouer ou de basculer ; les tâches hors ligne peuvent tolérer des files d’attente plus longues.
Liste de vérification finale
Utilisez cette liste de vérification lors de l’implémentation de LLM Rate Limits Explained: RPM, TPM, and Retries en production :
- Modélisez séparément le RPM, le TPM, les limites journalières, les limites de dépenses et la concurrence.
- Calculez la capacité à partir du minimum des plafonds de requêtes et de tokens.
- Exploitez en dessous du maximum publié avec un facteur de sécurité.
- Réservez les tokens avant d’envoyer des requêtes à forte variance.
- Utilisez des files d’attente et un lissage du débit pour les charges soutenues.
- Respectez
Retry-Afterlorsqu’il est valide et économiquement acceptable. - Utilisez un backoff exponentiel avec jitter lorsqu’aucun indice serveur valide n’existe.
- Plafonnez les tentatives et le temps total de retry.
- Arrêtez les retries pour les erreurs de quota, de facturation, d’autorisation et de validation.
- Évitez de rejouer des flux partiels ou des effets de bord non idempotents.
- Ne routez que vers des modèles qui préservent le contrat produit requis.
- Séparez le délai de file d’attente et le délai de retry de la latence du modèle dans les évaluations.
- Alertez sur l’amplification des retries et l’ancienneté de la file d’attente, pas seulement sur le nombre brut de
429. - Enregistrez les ID de requête, les estimations de tokens, les tokens réels, les tentatives, la route de repli et le résultat final dans le registre d’utilisation.
Les limites de débit sont d’abord des contrôles de planification de capacité, avant d’être des messages d’erreur. L’enseignement durable de LLM Rate Limits Explained: RPM, TPM, and Retries est de mesurer indépendamment la fréquence des requêtes, le débit de tokens, la concurrence, les retries et les résultats de repli afin que 429 devienne un signal exploitable plutôt qu’un bruit de production.
Sources
- Documentation sur les limites de débit d’OpenAI : https://platform.openai.com/docs/guides/rate-limits
- OpenAI Cookbook, gestion des limites de débit : https://cookbook.openai.com/examples/how_to_handle_rate_limits
- Limites de débit d’Anthropic : https://docs.anthropic.com/en/api/rate-limits
- Limites de débit de l’API Gemini : https://ai.google.dev/gemini-api/docs/rate-limits
- RFC 9110 Retry-After : https://www.rfc-editor.org/rfc/rfc9110.html#name-retry-after
- MDN 429 Trop de requêtes : https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/429
- Blog AWS Architecture, backoff exponentiel et jitter : https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
- Conventions sémantiques OpenTelemetry pour l’IA générative : https://opentelemetry.io/docs/specs/semconv/gen-ai/
- Tarifs Flatkey : https://flatkey.ai/pricing
- Répertoire des modèles Flatkey : https://flatkey.ai/models