
Fiabilité et routage
Derniers articles dans Fiabilité et routage.
Accès à l’API Claude en dehors des architectures mono-région : guide axé conformité
Un guide axé conformité pour l’accès à l’API Claude entre plusieurs régions, couvrant Anthropic en direct, Bedrock, Vertex AI, les passerelles, les tests, l’observabilité et le basculement approuvé.
API Seedance 2.0 en 2026 : accès, tarification et routage de secours
Un guide actualisé sur l’accès à l’API Seedance 2.0, la vérification des tarifs, les tâches asynchrones et le routage de secours sécurisé entre des versions de modèles vidéo en évolution.
Checklist de production Seedance API pour les équipes texte-vers-vidéo
Une checklist de production pratique pour exécuter des jobs texte-vers-vidéo Seedance avec des files d’attente durables, des états normalisés, des reprises sûres, du stockage et des contrôles de coûts.
API Gemini pour les agents IA : checklist d’intégration en production
Une checklist de production pour les agents propulsés par Gemini, couvrant des points de terminaison stables, un changement de modèle contrôlé, la sécurité des outils, les tentatives de relance, le routage de secours et la visibilité des coûts.
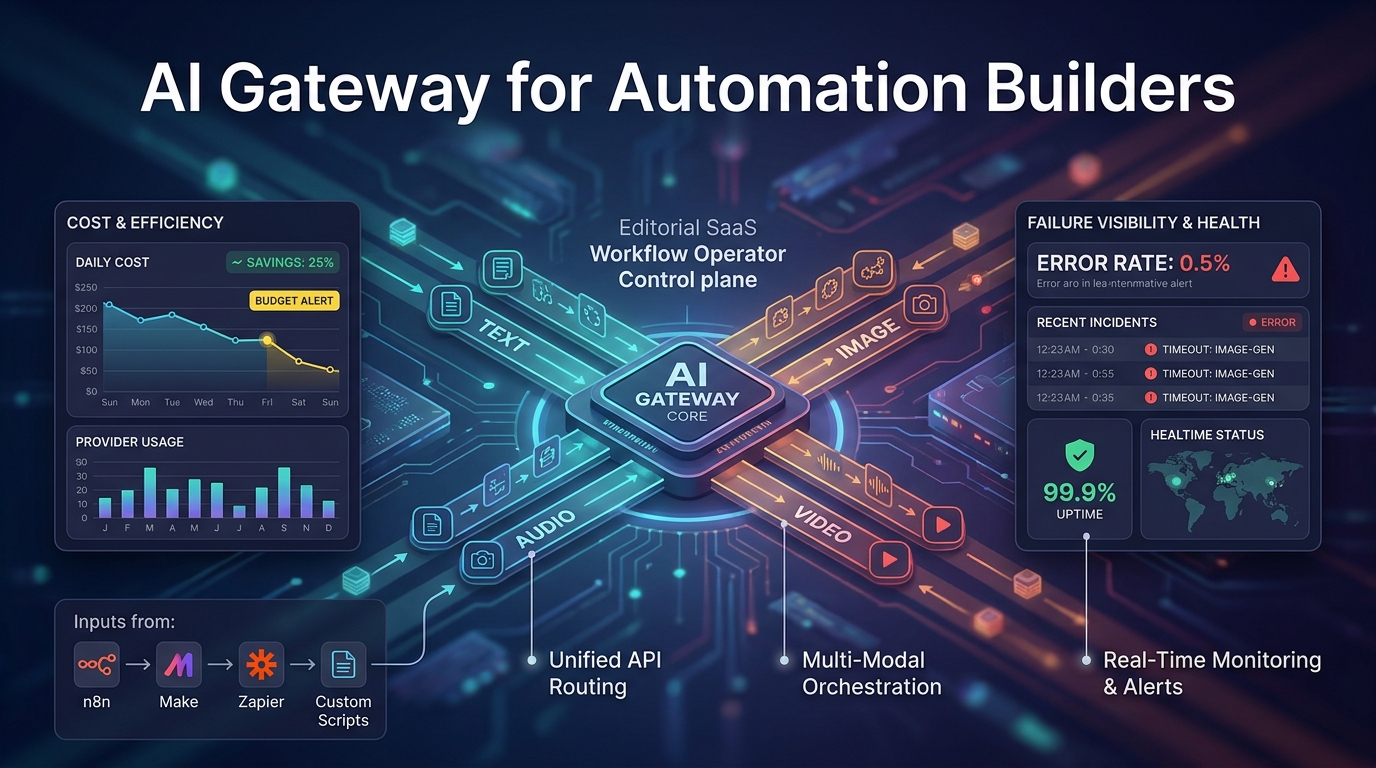
Passerelle IA pour les créateurs d’automatisation : routage de secours, visibilité des coûts et une seule URL de base
Pourquoi les créateurs d’automatisation ont besoin d’une passerelle IA unique pour des URL de base stables, un routage de secours plus sûr et une revue des coûts plus simple sur les workflows à fort volume.

Tests de qualité du fallback de modèle : quand des modèles moins chers ou plus rapides ne sont pas équivalents
Un plan pratique de tests de qualité pour le fallback de modèle afin de prouver que des modèles de secours moins chers ou plus rapides préservent la qualité, les outils, les coûts, la politique et l’observabilité avant le routage en production.

Regroupement de comptes multi-source : vérifications de fiabilité avant de partager le trafic des modèles
Une checklist de production pour un regroupement sécurisé de comptes multi-source sur plusieurs comptes de modèles d’IA, avec contrôles de santé, quotas, preuves de facturation et règles de routage en échec fermé.

LLM router : fonctionnement du routage de modèles, stratégies et déploiements canary sûrs (2026)
Guide complet du LLM router : fonctionnement, différences avec un LLM gateway, cinq stratégies (règles, cascades, classifieurs), économies réelles liées aux écarts de prix, code fonctionnel et runbook de déploiement canary.

Stratégie de mise en file d'attente pour les API d'IA : Protéger les workflows orientés utilisateur pendant les pannes de fournisseur
Un guide de fiabilité en production pour protéger les workflows d'IA orientés utilisateur avec des queue lanes, du backpressure, des contrats de repli, des règles de lettre morte et des preuves de routage.

Taxonomie des erreurs de passerelle LLM : Distinguer les échecs d'authentification, de quota, de fournisseur et de sécurité
Un guide de fiabilité en production pour classifier les échecs de passerelle LLM en chemins d'authentification, de quota, de fournisseur, de requête, de sécurité et d'annulation avant une nouvelle tentative ou un repli.

Limite de débit API dépassée : comprendre et résoudre le problème (2026)
Comprendre le dépassement des limites de débit API, les limites des principaux fournisseurs en 2026 et les solutions pas à pas : Retry-After, code de reprise avec temporisation exponentielle en Python et Node, limiteurs de débit, cache, files d’attente et niveaux supérieurs.

Stratégie de timeout pour les API d'IA : Budgets de connexion, lecture, streaming et file d'attente
Définissez des budgets de timeout pour les API d'IA en production pour la connexion, la lecture, le streaming, la file d'attente, la relance, le repli et l'observabilité avant que les incidents ne deviennent coûteux.
Disjoncteurs pour les passerelles API LLM : protégez les applications des boucles de défaillance des fournisseurs
Utilisez un disjoncteur de passerelle API LLM pour arrêter les boucles de défaillance des fournisseurs, classer les erreurs, protéger les tentatives de réessai et rediriger vers un système de secours, une file d’attente ou un échec fermé.
Liste de contrôle de repli de modèle : qualité, coût, outils et limites de conformité
Utilisez cette liste de contrôle de repli de modèle pour évaluer la qualité, le coût, les outils, le streaming, la conformité, les journaux et le retour arrière avant le repli automatique de la passerelle IA.
Fiabilité des API d’IA en streaming : SSE, timeouts et modes de défaillance au niveau du routeur
Utilisez des tests de fiabilité des API d’IA en streaming pour détecter les blocages SSE, les timeouts de proxy, les sorties partielles, les risques de retry et les lacunes de basculement du routeur avant la mise en production.
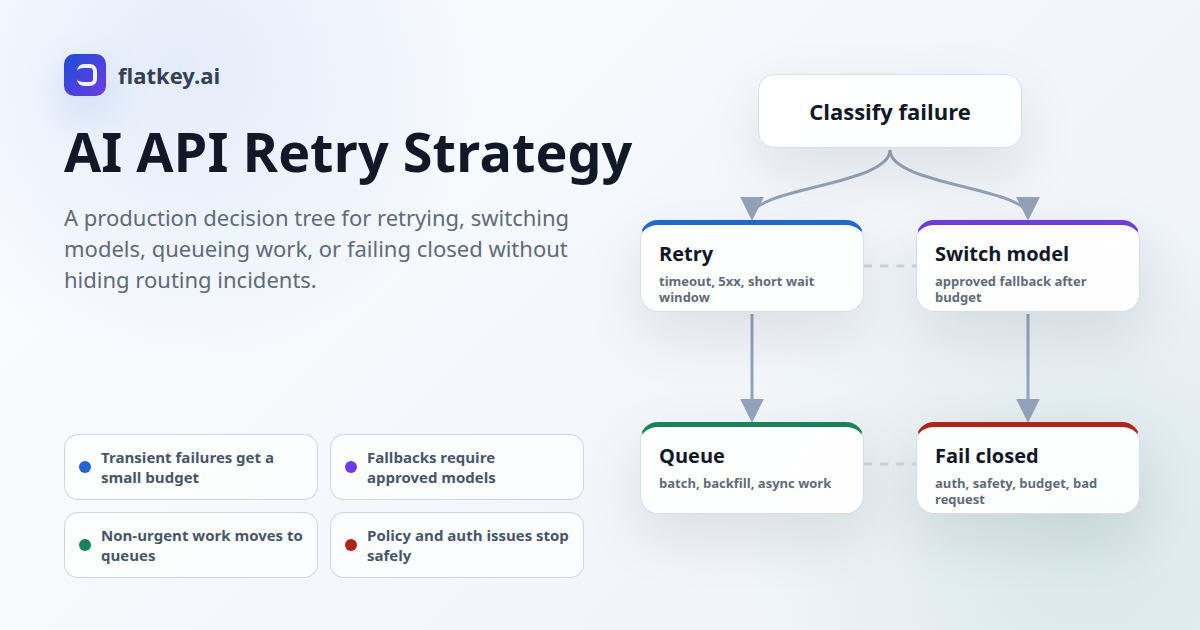
Stratégie de retry pour les API d’IA : quand réessayer, changer de modèle, mettre en file d’attente ou échouer en mode fermé
Utilisez une stratégie de retry pour les API d’IA afin de décider quand réessayer, changer de modèle, mettre le travail en file d’attente ou échouer en mode fermé, sans masquer des incidents de quota, d’authentification ou de routage.
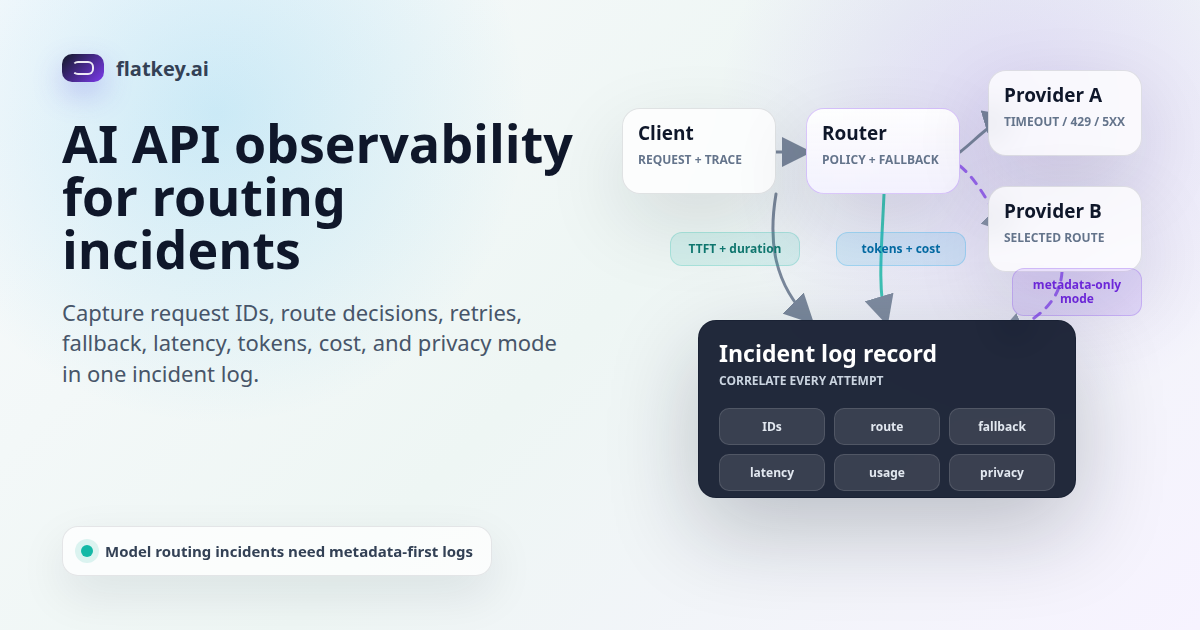
Plateformes d'observabilité IA : rôle et critères de choix (2026)
Les plateformes d'observabilité IA enregistrent prompts, tokens, coûts, étapes d'agents et scores de qualité. Comparez Langfuse, LangSmith, Arize, Datadog, Helicone, Braintrust et Logfire sur les fonctionnalités et les tarifs d'octobre 2026, avec du code OpenTelemetry.
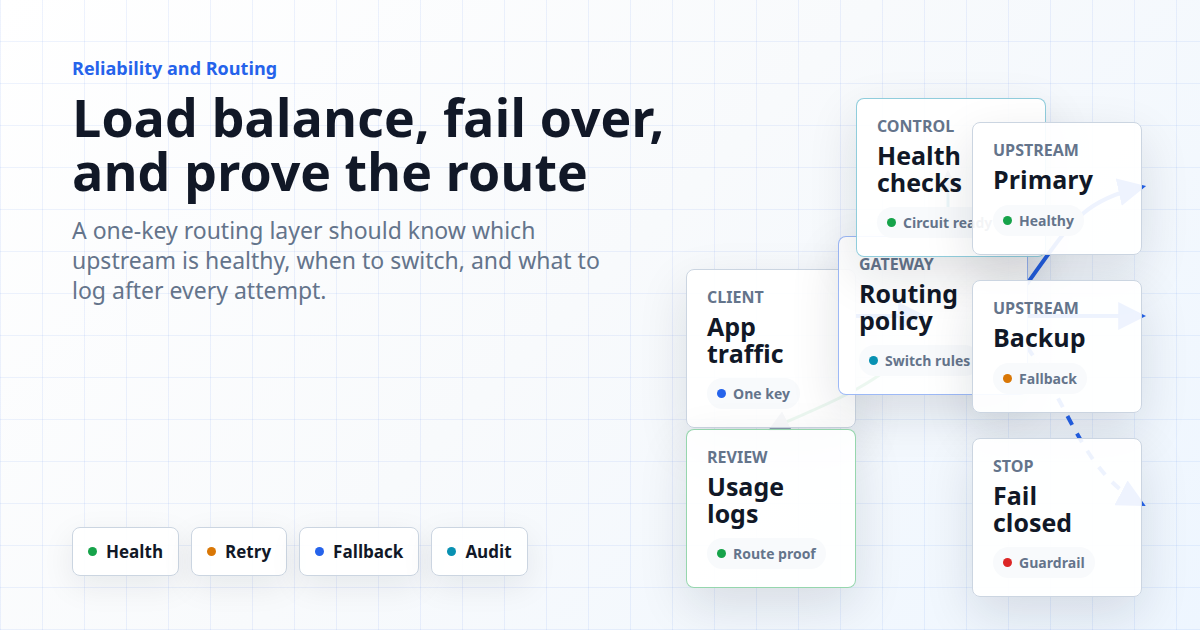
Équilibrage de charge et basculement des API IA derrière une seule clé
Planifiez l’équilibrage de charge et le basculement des API IA avec des règles de routage, des vérifications d’état, des chemins de nouvelle tentative, des journaux d’utilisation, des quotas, des tests de rollback et des passerelles à clé unique.
Construisez plus vite avec une seule passerelle IA.
Utilisez flatkey.ai pour gérer modèles, clés, facturation et observabilité depuis une plateforme API.
Commencer