Jika Anda sudah memiliki kapasitas GPU, inference server yang kompatibel dengan OpenAI memungkinkan aplikasi Anda mempertahankan bentuk client yang sama sambil Anda mengganti backend dari model API terkelola ke infrastruktur milik sendiri. Jalur yang umum cukup sederhana secara konsep: jalankan vLLM atau LocalAI di node GPU, ekspos API /v1, arahkan base_url SDK Anda ke endpoint tersebut, lalu perkuat layanan untuk autentikasi, routing, monitoring, dan kapasitas.
Panduan ini berfokus pada build praktis: cara menyiapkan vllm inference server openai compatible api, apa yang perlu diuji sebelum menempatkannya di belakang traffic produksi, dan kapan lebih cerdas mempertahankan self-hosting sebagai benchmark sambil merutekan sebagian besar workload melalui model API terkelola seperti Flatkey.
Jawaban Singkat
Untuk sebagian besar workload teks LLM, mulailah dengan vLLM. Ini menyediakan HTTP server yang kompatibel dengan OpenAI, mendukung endpoint bergaya OpenAI yang umum seperti chat completions, completions, embeddings, dan daftar model tergantung pada tipe model yang dimuat, serta menyediakan image Docker resmi untuk deployment.
Stack self-hosted minimal terlihat seperti ini:
| Lapisan | Pilihan produksi | Mengapa ini penting |
|---|---|---|
| Host GPU | H100, H200, B200, A100, L40S, atau akselerator lain yang didukung | Menentukan ukuran model, concurrency, panjang konteks, dan batas latensi. |
| Runtime container | Driver NVIDIA plus NVIDIA Container Toolkit | Memungkinkan container Docker melihat GPU melalui --gpus all. |
| Mesin inference | vLLM untuk serving teks throughput tinggi; LocalAI untuk use case OpenAI-compatible lokal yang lebih luas | vLLM adalah titik awal default untuk menyajikan LLM transformer di GPU. |
| Permukaan API | /v1/chat/completions, /v1/completions, /v1/models, dan hanya endpoint tambahan yang didukung model Anda |
Menjaga migrasi client tetap kecil dan mencegah asumsi kompatibilitas yang keliru. |
| Edge | Nginx, Envoy, Caddy, atau load balancer cloud | Menangani TLS, auth, batas permintaan, dan routing. |
| Ops | Metrics, log, telemetri GPU, canary, dan fallback routing | Mencegah server menjadi sumber outage yang tak terlihat. |
Gunakan vllm inference server openai compatible api ketika Anda membutuhkan kontrol hardware langsung, locality data, weights model kustom, atau ekonomi serving volume tinggi yang dapat diprediksi. Gunakan baseline gateway/model API ketika Anda terutama membutuhkan output yang andal dan tidak ingin mengurus utilisasi GPU, drift driver, pemuatan model, dan failover.
Sebelum Anda Membangun: Putuskan Apakah Self-Hosting Layak
Menjalankan inference server Anda sendiri yang kompatibel dengan OpenAI tidak otomatis lebih murah. Ini bisa sangat baik ketika GPU Anda tetap sibuk dan workload Anda cocok dengan model yang Anda host. Ini bisa mahal ketika utilisasi bersifat sporadis, prompt sangat bervariasi, kualitas model sering berubah, atau tim menghabiskan lebih banyak waktu untuk debugging infrastruktur daripada mengirim produk.
Gunakan tabel keputusan ini sebelum menyewa atau membeli hardware:
| Pertanyaan | Self-host jika jawabannya ya | Lebih pilih managed API atau gateway jika jawabannya ya |
|---|---|---|
| Apakah Anda memiliki traffic yang stabil? | GPU dapat tetap hangat dan sangat terutilisasi. | Traffic bersifat bursty, musiman, atau eksperimental. |
| Apakah Anda memerlukan weights kustom? | Anda menyajikan model yang telah di-fine-tune, di-quantize, atau private. | Model frontier publik atau model open-weight yang di-host sudah cukup. |
| Apakah diperlukan locality data? | Request harus tetap berada di dalam VPC Anda atau jaringan on-prem. | Kontrol keamanan API standar memenuhi kebutuhan. |
| Apakah Anda bisa mengoperasikan infrastruktur GPU? | Anda sudah memonitor driver, CUDA, container, memori, antrean, dan risiko rollout. | Anda tidak ingin operasi GPU menjadi roadmap produk. |
| Apakah kualitas output stabil? | Satu keluarga model sudah cukup untuk workflow tersebut. | Anda perlu membandingkan, merutekan, atau melakukan failover lintas banyak model. |
Flatkey cocok sebagai baseline di kolom terakhir: satu endpoint yang kompatibel dengan OpenAI, satu saldo, dan akses ke banyak model resmi. Bahkan jika Anda membangun vllm inference server openai compatible api, tetap gunakan baseline model API di benchmark Anda agar Anda bisa membandingkan latensi, kualitas, dan biaya per output yang diterima, bukan hanya biaya per jam GPU.
Arsitektur Referensi
Inference server produksi yang kompatibel dengan OpenAI sebaiknya tidak mengekspos mesin model secara langsung ke internet publik. Letakkan lapisan kontrol tipis di depannya.
flowchart LR
  A[OpenAI SDK / app workers] --> B[API edge: TLS, auth, rate limits]
  B --> C[OpenAI-compatible /v1 route]
  C --> D[vLLM inference server]
  D --> E[GPU node or GPU pool]
  D --> F[Metrics and logs]
  B --> G[Fallback route: Flatkey or another model API]
Keputusan desain yang penting adalah memisahkan kompatibilitas dari operasi. vLLM dapat berbicara dengan API bergaya OpenAI. Edge Anda harus menangani autentikasi, kuota, batas ukuran request, TLS, audit log, dan perilaku fallback.
Langkah 1: Siapkan Host GPU
Mulailah dengan mesin Linux GPU yang bersih. Pastikan host memiliki:
- Driver NVIDIA yang kompatibel untuk GPU dan stack CUDA yang akan Anda jalankan.
- Docker atau runtime container lain yang didukung.
- NVIDIA Container Toolkit yang dikonfigurasi agar container dapat mengakses GPU.
- Penyimpanan lokal atau jaringan yang cukup untuk weights model.
- Jalur jaringan yang tidak mengekspos port inference sampai autentikasi dan TLS tersedia.
Alur instalasi NVIDIA container toolkit mengonfigurasi Docker dengan nvidia-ctk runtime configure --runtime=docker, lalu me-restart Docker. Setelah itu, container dapat dijalankan dengan akses GPU menggunakan flag GPU milik Docker.
Jalankan pengecekan ini sebelum menginstal model server:
nvidia-smi
docker run --rm --gpus all nvidia/cuda:12.6.0-base-ubuntu22.04 nvidia-smi
Jika salah satu perintah gagal, perbaiki dulu lapisan driver/runtime. Sebuah vllm inference server openai compatible api tidak akan stabil jika runtime GPU dasarnya tidak stabil.
Langkah 2: Memulai vLLM Inference Server OpenAI Compatible API
Dokumentasi deployment Docker resmi vLLM menyebut vllm/vllm-openai sebagai image untuk menjalankan server yang kompatibel dengan OpenAI. Percobaan pertama yang praktis terlihat seperti ini:
docker run --rm --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -e HUGGING_FACE_HUB_TOKEN="$HUGGING_FACE_HUB_TOKEN" \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --served-model-name llama-3.1-8b-instruct
Untuk model privat, ganti model id dengan repository Anda sendiri atau path lokal. Untuk produksi, pin tag image dan revisi model alih-alih men-deploy latest.
Lalu uji daftar model:
curl http://localhost:8000/v1/models
Dan uji chat completions:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-8b-instruct",
    "messages": [
      {"role": "system", "content": "Anda adalah asisten yang ringkas."},
      {"role": "user", "content": "Balas dengan satu kalimat tentang inference yang di-host sendiri."}
    ],
    "temperature": 0.2
  }'
Itulah milestone kerja pertama: sebuah vllm inference server openai compatible api lokal yang dapat dipanggil aplikasi Anda dengan bentuk request yang sama seperti yang sudah digunakan untuk chat bergaya OpenAI.
Langkah 3: Arahkan SDK yang Sudah Ada ke Endpoint Lokal
Sebagian besar pekerjaan migrasi OpenAI-compatible seharusnya terjadi di konfigurasi, bukan di logika aplikasi. Dengan pola Python SDK, set base_url dan API key khusus:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local-dev-key",
)

response = client.chat.completions.create(
    model="llama-3.1-8b-instruct",
    messages=[
        {"role": "user", "content": "Berikan saya daftar periksa deployment."}
    ],
)

print(response.choices[0].message.content)
Di produksi, jangan arahkan worker aplikasi langsung ke proses vLLM mentah. Arahkan mereka ke gateway internal atau load balancer Anda sendiri:
OPENAI_BASE_URL=https://inference.example.com/v1
OPENAI_API_KEY=<your-internal-service-token>
Gateway itu dapat merutekan ke vLLM, memblokir field request yang tidak didukung, menormalkan alias model, dan melakukan failover ke Flatkey atau API model lain ketika pool yang di-host sendiri penuh.
Langkah 4: Pahami Apa Arti "OpenAI-Compatible" dan Apa yang Tidak Termasuk
OpenAI-compatible tidak berarti setiap endpoint, perilaku model, panggilan tool, event streaming, atau opsi khusus penyedia akan berperilaku persis seperti OpenAI. Artinya server menerima bentuk yang familiar untuk endpoint tertentu.
Sebelum Anda menganggap migrasi selesai, uji:
| Area kompatibilitas | Apa yang perlu diverifikasi |
|---|---|
| Pesan chat | Penanganan role, pesan system, konteks panjang, payload multimodal jika digunakan. |
| Streaming | Format event, perilaku disconnect, timeout klien, penanganan output parsial. |
| Tools/function calling | Apakah model yang dimuat dan server mendukung pola tool-call Anda. |
| Embeddings | Apakah model yang dimuat memang model embedding. |
| Kode error | Perilaku 400, 401, 404, 408, 429, 500, 503 di edge dan engine. |
| Parameter request | Temperature, max tokens, top-p, stop sequences, parameter tambahan dari penyedia. |
| Akuntansi token | Jumlah token prompt/output dan atribusi biaya. |
Pola yang paling aman adalah memelihara test suite kompatibilitas. Kirim serangkaian prompt aplikasi nyata yang tetap ke OpenAI, Flatkey, dan vllm inference server openai compatible api Anda. Bandingkan latensi, validitas skema, perilaku penolakan, kualitas output, dan tingkat accepted-output.
Langkah 5: Ukur Kapasitas Memori GPU untuk Model dan Trafik
Mode kegagalan utama layanan model bukanlah "server lambat saat mulai." Melainkan "server berhasil mulai, lalu kolaps di bawah panjang konteks dan konkurensi nyata."
Rencanakan memori berdasarkan:
- Bobot model.
- KV cache untuk konteks dan sequence yang berjalan bersamaan.
- Overhead runtime.
- Fragmentasi dan ruang cadangan.
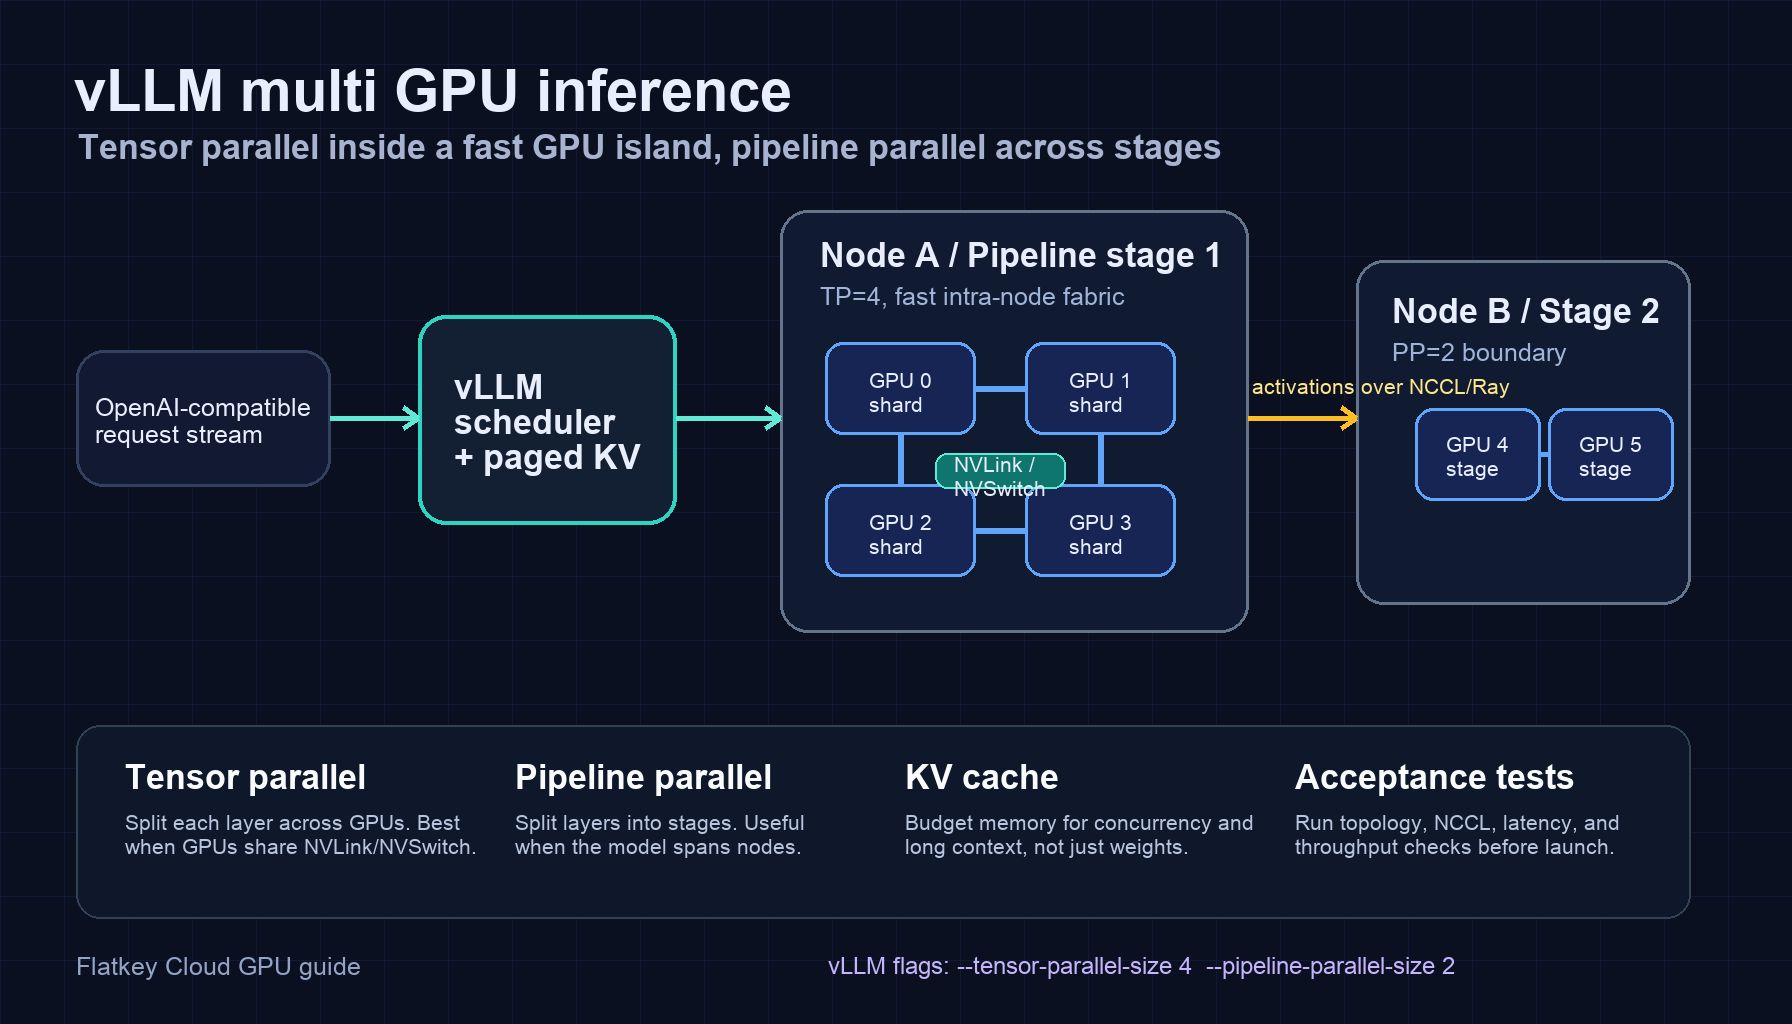
- Tensor parallelism saat model tidak muat di satu GPU.
- Tradeoff quantization jika Anda memakai presisi lebih rendah.
Untuk worksheet yang lebih mendalam, gunakan panduan Flatkey tentang persyaratan memori GPU LLM. Untuk perencanaan tingkat klaster, padukan ini dengan analisis bergaya arsitektur klaster GPU dan TCO klaster GPU.
Aturan penerimaan kasar:
usable_capacity = model_fit + target_context + target_concurrency + 20-30% headroom
Jika Anda tidak dapat mempertahankan headroom tersebut, kurangi panjang konteks, kurangi concurrency, gunakan model yang lebih kecil, bagi ke beberapa GPU, atau alihkan traffic overflow menjauh dari pool self-hosted.
Langkah 6: Tambahkan API Edge Sebelum Produksi
Server vLLM mentah bukanlah control plane produksi Anda secara penuh. Letakkan edge di depannya dan jadikan edge bertanggung jawab atas:
- Terminasi TLS.
- Autentikasi antar layanan.
- Batas ukuran body request.
- Batas rate per tim atau per aplikasi.
- Pemetaan alias model.
- Log request terstruktur.
- Batas timeout dan retry.
- Canary routing.
- Fallback routing.
Contoh bentuk Nginx:
server {
  listen 443 ssl;
  server_name inference.example.com;

  client_max_body_size 4m;

  location /v1/ {
    proxy_pass http://vllm_backend:8000/v1/;
    proxy_http_version 1.1;
    proxy_set_header Host $host;
    proxy_set_header X-Request-Id $request_id;
    proxy_read_timeout 120s;
  }
}
Itu baru titik awal. Tim produksi harus menambahkan autentikasi, mTLS atau private networking, kebijakan logging request, dan batas eksplisit untuk ukuran prompt serta panjang output.
Langkah 7: Ukur Output yang Diterima, Bukan Hanya Token per Detik
Dashboard penyajian GPU sering terlalu berfokus pada throughput. Token per detik memang penting, tetapi tim produk biasanya peduli pada output yang diterima: respons yang cukup cepat, cukup valid, dan cukup baik untuk dikirim ke pengguna atau workflow downstream.
Lacak:
| Metrik | Mengapa ini penting |
|---|---|
| Waktu ke token pertama | Latensi yang dirasakan pengguna untuk aplikasi streaming. |
| Latensi end-to-end | Waktu antrean ditambah waktu generasi. |
| Kedalaman antrean | Peringatan dini bahwa pool GPU sudah jenuh. |
| Utilisasi memori GPU | Apakah asumsi konteks/concurrency realistis. |
| Rasio error per alias model | Mendeteksi kegagalan spesifik model. |
| Rasio lolos skema output | Kritis untuk agent, ekstraksi, dan workflow tool. |
| Rasio output yang diterima | Menggabungkan kualitas, latensi, dan validitas. |
| Rasio fallback | Menunjukkan kapan pool self-hosted tidak cukup. |
Kemudian hitung biaya per output yang diterima:
cost_per_accepted_output =
  (gpu_cost + storage + network + ops_time + fallback_api_cost)
  / accepted_outputs
Di sinilah vllm inference server openai compatible api mendapatkan perbandingan yang jujur dengan managed API. Jika GPU lokal lebih murah per token mentah tetapi lebih buruk pada retry, kegagalan, atau waktu operator, biaya output yang diterima mungkin lebih tinggi dari yang diperkirakan.
Langkah 8: Tambahkan Fallback daripada Menganggap Kotak GPU sebagai Single Point of Failure
Aplikasi Anda seharusnya tidak peduli apakah respons datang dari vLLM self-hosted, Flatkey, atau rute model lainnya. Aplikasi cukup meminta alias model dan menerima respons atau kegagalan yang terkontrol.
Gunakan aturan routing seperti:
| Kondisi | Rute |
|---|---|
| Traffic normal, GPU sehat | vLLM self-hosted. |
| Antrian GPU di atas ambang batas | Dialihkan ke Flatkey model API. |
| Model sedang loading atau restart | Arahkan semua traffic ke Flatkey sampai warm. |
| Lonjakan kegagalan skema | Canary kembali ke managed API. |
| Evaluasi prompt eksperimental | Jalankan pada model lokal dan managed untuk perbandingan. |
Desain ini memungkinkan tim mempertahankan ekonomi dan kontrol self-hosting tanpa mengikat ketersediaan produk pada satu inference server.
vLLM vs LocalAI untuk Inference Lokal yang OpenAI-Compatible
vLLM dan LocalAI sama-sama muncul dalam pencarian untuk inference server yang OpenAI-compatible, tetapi keduanya cocok untuk pekerjaan yang berbeda.
| Opsi | Paling cocok untuk | Perlu diwaspadai |
|---|---|---|
| vLLM | Penyajian LLM ber-throughput tinggi di GPU, terutama model teks transformer. | Kompatibilitas bergantung pada jenis model dan endpoint; hardening produksi tetap perlu dibangun di sekelilingnya. |
| LocalAI | API lokal yang OpenAI-compatible di berbagai backend model lokal dan modality. | Throughput dan perilaku GPU sangat bergantung pada backend, model, dan perangkat keras. |
| Flatkey | Baseline API model managed yang OpenAI-compatible untuk banyak model resmi. | Anda kehilangan kontrol langsung atas engine penyajian tetapi tidak perlu mengelola operasi GPU sendiri. |
Untuk workload target artikel ini, mulai dengan vllm inference server openai compatible api. Evaluasi LocalAI ketika tujuan Anda adalah eksperimen lokal yang lebih luas atau satu API lokal di atas beberapa backend, bukan throughput penyajian GPU maksimum untuk satu keluarga LLM.
Checklist Produksi
Gunakan ini sebelum Anda merutekan pengguna sungguhan:
- [ ] Driver GPU dan runtime container telah diverifikasi dengan
nvidia-smidi dalam container. - [ ] Tag image vLLM dan revisi model telah dipin.
- [ ] Alias model stabil dan terdokumentasi.
- [ ]
/v1/modelsdan/v1/chat/completionstelah diuji melalui URL edge final. - [ ] Streaming telah diuji dengan pemutusan koneksi klien.
- [ ] Pengujian konteks panjang dan konkurensi dijalankan pada bentuk produksi yang diharapkan.
- [ ] Autentikasi ditambahkan di edge; port raw vLLM tidak dipublikasikan.
- [ ] Ukuran body request, max output token, dan timeout diberlakukan.
- [ ] Log tidak menyertakan data prompt sensitif kecuali disetujui secara eksplisit.
- [ ] Metrik menangkap latensi, antrean, memori GPU, tingkat error, dan tingkat output yang diterima.
- [ ] Rute fallback dikonfigurasi untuk saturasi dan insiden.
- [ ] Baseline API terkelola diukur dengan prompt yang sama.
- [ ] Rencana rollback telah diuji.
Kesalahan Umum
Kesalahan terbesar adalah menganggap curl pertama yang berhasil sebagai akhir pekerjaan. Itu baru permulaan.
Kegagalan umum lainnya:
- Menjalankan image
latestdi produksi tanpa mengunci versi. - Mengekspos port inference mentah ke internet.
- Mengasumsikan setiap parameter request OpenAI didukung.
- Benchmark satu prompt pendek lalu menyebut hasilnya "siap produksi."
- Mengabaikan pertumbuhan cache KV dari panjang konteks yang sebenarnya.
- Lupa bahwa waktu pemuatan model memengaruhi deployment dan pemulihan.
- Mengukur biaya GPU-hour tanpa waktu operator, retry, dan kegagalan kualitas.
- Melompati fallback karena endpoint lokal "OpenAI-compatible."
Sebuah vllm inference server openai compatible api untuk produksi adalah infrastruktur yang berguna. Itu bukan kompatibilitas ajaib, dan bukan pengganti disiplin operasional.
Kapan Menggunakan Flatkey Bersama GPU Anda Sendiri
Flatkey paling berguna dalam arsitektur ini sebagai baseline model/API terkelola dan jalur fallback. Pertahankan aplikasi Anda pada bentuk klien OpenAI-compatible, lalu arahkan sebagian trafik ke pool GPU lokal Anda dan sebagian ke Flatkey.
Itu memberi Anda:
- Cara membandingkan kualitas output self-hosted dengan model hosted.
- Kapasitas overflow saat GPU lokal jenuh.
- Rute fallback selama insiden driver, model, atau deployment.
- Akses ke family model lain tanpa menambah lebih banyak kunci provider.
- Jalur yang lebih bersih kembali ke API terkelola jika model self-hosted berkinerja buruk.
Keputusannya bukan "memiliki GPU sendiri atau menggunakan API." Bagi banyak tim, pengaturan yang tahan lama adalah keduanya: miliki jalur GPU sendiri di tempat yang memberi kontrol atau keunggulan biaya, dan pertahankan jalur terkelola untuk ketahanan dan pilihan model.
FAQ
Apa itu server inference OpenAI-compatible?
Server inference OpenAI-compatible mengekspos endpoint HTTP dengan bentuk request dan response ala OpenAI, biasanya di bawah /v1. Itu memungkinkan aplikasi menggunakan konfigurasi SDK yang familiar seperti base_url kustom sambil mengirim trafik ke backend yang berbeda.
Apakah vLLM merupakan server inference OpenAI-compatible?
Ya. vLLM menyediakan server OpenAI-compatible dan mendokumentasikan dukungan untuk endpoint umum ala OpenAI seperti chat completions, completions, embeddings, dan listing model, tergantung pada jenis model dan fiturnya.
Bisakah saya menjalankan server vLLM OpenAI-compatible secara lokal?
Ya. Anda dapat menjalankan vLLM secara lokal di workstation atau server GPU, lalu mengekspos endpoint /v1 ke aplikasi Anda. Untuk produksi, tempatkan edge atau gateway internal yang terautentikasi di depannya.
Perangkat keras apa yang saya perlukan?
Tergantung pada ukuran model, presisi, panjang konteks, dan target konkurensi. Mulailah dengan menghitung bobot model ditambah cache KV dan headroom, lalu uji dengan prompt nyata. Model instruct kecil mungkin muat di satu GPU; model 70B atau workload dengan konkurensi tinggi mungkin memerlukan GPU dengan memori lebih besar atau tensor parallelism.
Haruskah saya menggunakan vLLM atau LocalAI?
Gunakan vLLM terlebih dahulu ketika pekerjaannya adalah inference LLM ber-throughput tinggi di GPU. Evaluasi LocalAI ketika Anda menginginkan server OpenAI-compatible lokal yang lebih luas di berbagai backend lokal atau modalitas.
Apakah OpenAI-compatible berarti identik dan bisa langsung dipakai?
Tidak. Bentuk endpoint mungkin cocok, tetapi perilaku model, parameter yang didukung, tools, streaming, embeddings, error, dan penghitungan token dapat berbeda. Jalankan pengujian kompatibilitas sebelum mengalihkan trafik produksi.
Kesimpulan
Membangun vllm inference server openai compatible api adalah cara praktis tercepat untuk mengubah GPU Anda sendiri menjadi endpoint bergaya OpenAI. Pembuatan inti cukup sederhana: siapkan runtime GPU, jalankan vLLM, arahkan SDK ke /v1, lalu tambahkan edge, monitoring, pengujian kompatibilitas, dan rute fallback yang membuatnya layak produksi.
Tim terbaik tidak berhenti pada "ini berjalan." Mereka membandingkan inference self-hosted dengan baseline API model terkelola, mengukur output yang diterima, dan menjaga rute fallback tetap siap. Itulah cara Anda mendapatkan kontrol atas GPU sendiri tanpa membuat setiap permintaan produk bergantung pada satu inference server yang rapuh.
Referensi Resmi
- Dokumentasi server vLLM yang kompatibel dengan OpenAI: https://docs.vllm.ai/en/latest/serving/online_serving/
- Dokumentasi deployment Docker vLLM: https://docs.vllm.ai/en/latest/deployment/docker/
- Panduan instalasi NVIDIA Container Toolkit: https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html
- README OpenAI Python SDK: https://github.com/openai/openai-python
- Dokumentasi proyek LocalAI: https://localai.io/