
Harga Sewa GPU Dijelaskan: On-Demand, Spot, Reserved, dan Biaya Tersembunyi
Harga sewa GPU terlihat sederhana sampai Anda mencoba memperkirakan sebuah proses training nyata, peluncuran inferensi, atau batch pembuatan gambar. Tarif per jam yang ditampilkan di depan hanyalah satu komponen biaya. Tagihan akhir Anda juga bergantung pada apakah GPU tersebut on-demand, spot atau interruptible, reserved, serverless, atau dedicated; berapa lama mesin menganggur; di mana penyimpanan berada; berapa banyak data yang keluar dari region; dan seberapa banyak pekerjaan reliabilitas yang harus ditanggung tim Anda.
Panduan ini memberi developer, pendiri AI, tim platform, dan reviewer pengadaan cara praktis untuk membandingkan harga sewa GPU tanpa terjebak pada satu angka per jam yang tampak menarik.
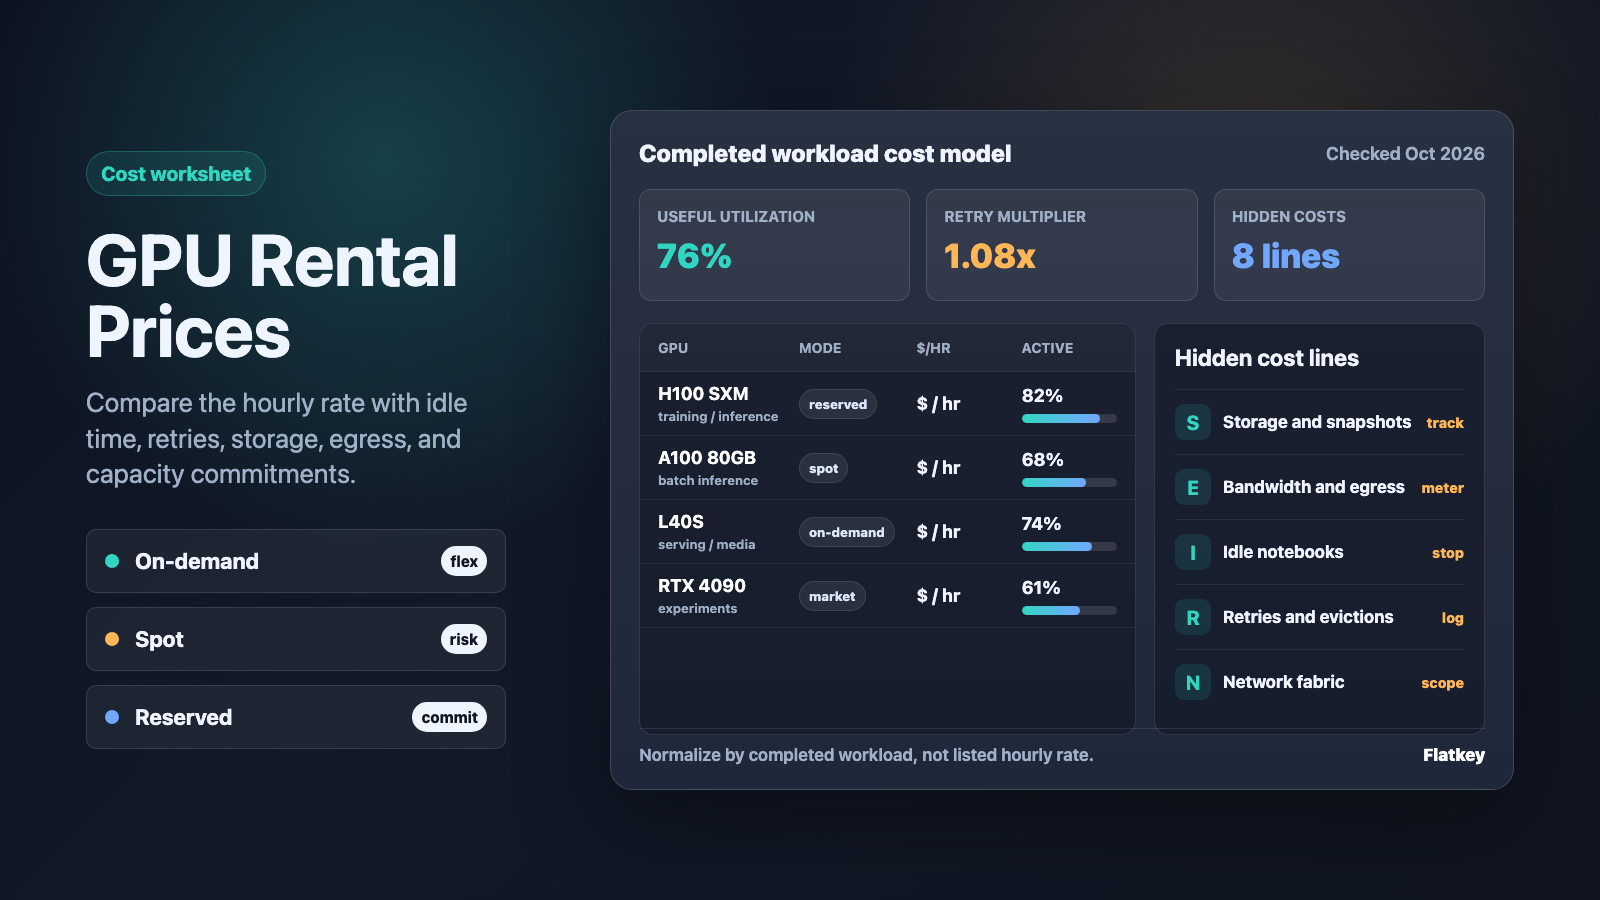
Ringkasnya: bandingkan biaya per jam beban kerja yang selesai, bukan hanya harga GPU per jam jam kalender.
Kerangka cepat harga sewa GPU
Mulailah setiap perbandingan harga sewa GPU dengan satu rumus ternormalisasi:
effective GPU cost per completed workload =
  (GPU compute + storage + snapshots + bandwidth + idle time + retries + support + engineering overhead)
  / completed training, inference, batch, or media job units
Kemudian pecah keputusan menjadi empat pertanyaan:
| Pertanyaan | Mengapa ini mengubah harga sewa GPU |
|---|---|
| Jenis GPU apa yang Anda butuhkan? | Mesin kelas H100, H200, B200, A100, L40S, RTX 4090, dan RTX 6000 memiliki kurva memori, jaringan, suplai, dan harga yang berbeda. |
| Seberapa dapat diprediksi beban kerjanya? | Inferensi produksi yang stabil dapat membenarkan kapasitas reserved atau committed; eksperimen dan pekerjaan yang meledak-ledak sering lebih cocok menggunakan on-demand atau spot. |
| Seberapa mudah pekerjaan ini diinterupsi? | Kapasitas spot dan marketplace komunitas bisa lebih murah, tetapi retry dan checkpointing menentukan apakah benar-benar lebih murah. |
| Apa saja yang berada di luar jam GPU? | Penyimpanan, snapshot, egress, notebook yang idle, pull container, paket dukungan, dan networking cluster dapat mengubah biaya nyata. |
Bagi sebagian besar tim, jawaban yang tepat bukanlah "temukan GPU termurah." Jawaban yang tepat adalah "sewa kapasitas paling murah yang andal, yang menyelesaikan pekerjaan dengan waktu antre yang dapat diterima, risiko restart, dan overhead operasional yang wajar."
Tabel sumber harga saat ini
Harga sewa GPU berubah sering dan halaman marketplace bisa bergerak lebih cepat daripada tinjauan pengadaan. Perlakukan tabel di bawah sebagai daftar cek sumber, bukan kartu tarif yang beku. Catat tanggal pengecekan, model GPU, region, ukuran memori, unit penagihan, dan apakah harganya on-demand, spot, reserved, community, secure cloud, serverless, atau dedicated.
| Provider atau pasar | Sumber harga resmi yang harus dicek | Apa yang harus dicatat | Catatan untuk perbandingan |
|---|---|---|---|
| Vast.ai | Harga Vast.ai dan FAQ Vast.ai | Model GPU, reliabilitas host, status interruptible, storage, bandwidth, tier verifikasi, datacenter atau host komunitas | Harga sewa GPU Vast.ai ditentukan oleh pasar, jadi dua penawaran RTX 4090 atau H100 bisa berbeda menurut lokasi, host, reliabilitas, storage, dan jaringan. |
| RunPod | Harga RunPod dan dokumentasi storage dan volume jaringan RunPod | Secure Cloud vs Community Cloud, model GPU, storage pod, volume jaringan, harga worker serverless, waktu idle | Harga sewa GPU RunPod bervariasi menurut jenis cloud dan mode produk. Bandingkan pod, serverless, dan storage secara terpisah. |
| Massed Compute | Harga Massed Compute | Tarif GPU per jam on-demand, reservasi jangka panjang atau penawaran cluster, memori GPU, region, cakupan dukungan | Harga sewa GPU Massed Compute berguna sebagai pembanding kapasitas cloud AI dedicated, tetapi cluster privat atau reserved mungkin memerlukan penawaran harga. |
| Lambda Cloud | Harga Lambda Cloud | Instance GPU on-demand, jumlah GPU, storage lokal, ketersediaan region, syarat cluster reserved | Lambda mempublikasikan tarif cloud GPU per jam yang sederhana untuk instance NVIDIA umum; pastikan ketersediaan saat ini sebelum merencanakan pekerjaan yang sensitif terhadap waktu. |
| AWS EC2 | Harga Amazon EC2 dan EC2 Spot Instances | Family instance, region, On-Demand, Spot, Savings Plans, Reserved Instances, EBS, transfer data, dukungan | AWS sering menjadi model acuan untuk ekonomi on-demand, spot, dan committed-use, tetapi family instance GPU dan ketersediaan regional tetap penting. |
| Google Cloud | Harga GPU Compute Engine dan Spot VMs | Jenis GPU, family mesin, region, status Spot VM, committed use discount, persistent disk, network egress | Google Cloud memisahkan mekanisme GPU, mesin, disk, jaringan, dan diskon. Normalisasikan semuanya sebelum membandingkan dengan cloud GPU spesialis. |
Tambahkan satu baris ke setiap sumber: dicek pada 12 Oktober 2026. Jika Anda menggunakan kembali lembar kerja ini nanti, perbarui tanggal pengecekan sebelum menggunakan angka apa pun.
Harga sewa GPU On-Demand
Harga sewa GPU on-demand adalah titik awal yang paling bersih: Anda membayar kapasitas GPU selama instance, pod, atau server berjalan, biasanya tanpa komitmen jangka panjang. Ini adalah mode yang sebaiknya dipakai sebagian besar tim untuk benchmark awal karena menjaga variabel rekayasa tetap sederhana.
On-demand biasanya menjadi pilihan default yang tepat ketika:
- Anda sedang menguji model, framework, dataset, atau pipeline prompt baru.
- Pekerjaan bersifat mendesak dan tidak bisa menunggu kapasitas spot.
- Anda membutuhkan endpoint yang stabil untuk demo, QA, atau trafik pelanggan awal.
- Anda belum mengetahui utilisasi dengan cukup baik untuk melakukan reservasi kapasitas.
- Anda membutuhkan dukungan penyedia dan jaringan yang dapat diprediksi lebih dari tarif per jam terendah.
Risikonya adalah waktu menganggur. Notebook GPU yang biayanya lebih rendah per jam tetap bisa mahal jika berjalan sepanjang akhir pekan tanpa pekerjaan yang menempel. Untuk on-demand, ukur waktu berjalan yang ditagihkan terhadap waktu komputasi yang berguna.
tingkat pemborosan on-demand =
  1 - menit GPU aktif yang berguna / menit instance yang ditagihkan
Jika tingkat pemborosan tinggi, jangan negosiasikan tarif GPU terlebih dahulu. Perbaiki otomasi shutdown, penjadwalan antrean, autoscaling, dan packing job.
Harga GPU spot, interruptible, dan marketplace
Harga GPU spot memanfaatkan kapasitas yang tidak terpakai dan dapat menawarkan diskon yang signifikan dibandingkan on-demand, tetapi kapasitasnya bisa hilang. AWS menjelaskan EC2 Spot Instances sebagai kapasitas EC2 cadangan yang tersedia dengan diskon hingga 90% dibandingkan harga On-Demand. Google Cloud Spot VM juga didiskon tetapi dapat dipreempt. Marketplace komunitas seperti Vast.ai menambahkan variasi lain: harga ditentukan oleh penawaran dan permintaan host, dan profil keandalannya tidak sama dengan instance on-demand hyperscaler.
Harga sewa GPU spot atau interruptible bisa lebih menguntungkan ketika:
- Job training sering melakukan checkpoint.
- Batch inference dapat retry tanpa kegagalan yang terlihat oleh pengguna.
- Antrian pembuatan gambar atau video dapat menoleransi penundaan.
- Anda dapat membagi pekerjaan di banyak worker.
- Anda memiliki orkestrasi yang mendeteksi eviction, memulai ulang job, dan menghindari penagihan ganda.
Spot bisa merugikan ketika:
- Satu training run multi-hari dimulai ulang dari checkpoint lama.
- Data loading memakan waktu cukup lama sehingga setiap gangguan membuang waktu berjam-jam.
- Model membutuhkan networking multi-node dan satu worker yang hilang membatalkan job.
- Engineer menghabiskan berhari-hari untuk memelihara logika retry dan checkpoint.
- Anda menjanjikan latensi yang berhadapan dengan pelanggan pada kapasitas yang tidak Anda kendalikan.
Untuk spot, hitung tarif efektif dengan pemborosan restart:
tarif efektif per jam spot =
  tarif spot per jam / (1 - porsi pemborosan akibat interupsi)
Jika H100 spot 45% lebih murah tetapi interupsi membuang 35% waktu job yang berlalu, keunggulan nyatanya jauh lebih kecil daripada diskon yang terlihat.
Kapasitas GPU reserved, committed, dan dedicated
Kapasitas reserved menukar fleksibilitas dengan prediktabilitas. Anda berkomitmen pada jangka waktu, level pengeluaran, atau cluster khusus sehingga penyedia dapat mengalokasikan perangkat keras dan Anda dapat menurunkan tarif efektif per jam atau mengamankan GPU yang langka.
Harga sewa GPU reserved masuk akal ketika:
- Inference produksi memiliki utilisasi dasar yang stabil.
- Jadwal training dapat diprediksi selama berbulan-bulan.
- Pengadaan membutuhkan anggaran bulanan yang diketahui.
- Anda membutuhkan kapasitas terjamin untuk jendela peluncuran.
- Networking multi-node, kedekatan storage, dan dukungan adalah bagian dari kebutuhan.
Kapasitas reserved dapat menjadi bumerang ketika:
- Pilihan model berubah sebelum masa kontrak berakhir.
- Permintaan bersifat lonjakan dan utilisasi dasar tetap rendah.
- Kelas GPU yang lebih baru mengubah kurva performa per dolar.
- Kontrak mengecualikan storage, dukungan, atau tier jaringan yang sebenarnya Anda butuhkan.
Sebelum Anda melakukan reservasi, hitung titik impas utilisasi:
utilisasi titik impas reserved =
  biaya bulanan reserved / (tarif per jam on-demand * jam dalam sebulan)
Jika titik impasnya adalah utilisasi 58% dan baseline riil Anda 30%, reservasikan kapasitas lebih sedikit dan sisanya lakukan burst dengan on-demand atau spot.
Harga sewa GPU Vast.ai
Orang mencari harga sewa GPU Vast.ai karena Vast adalah marketplace, bukan kartu tarif cloud tetap tunggal. Itulah daya tarik dan risikonya. Anda mungkin menemukan penawaran RTX 4090, A100, atau H100 yang agresif, tetapi setiap listing perlu pemeriksaan kualitas.
Saat membandingkan harga sewa GPU Vast.ai, catat:
- Model GPU dan VRAM.
- Jumlah GPU di mesin.
- Keandalan host dan status verifikasi.
- Konteks datacenter vs host komunitas.
- Status interruptible atau non-interruptible.
- Ukuran disk lokal dan bandwidth disk.
- Bandwidth upload/download dan kebutuhan public IP.
- Waktu startup image container.
- Apakah job Anda dapat checkpoint dan resume.
Untuk vast.ai gpu rental prices rtx 4090, jangan hanya membandingkan tarif per jam RTX 4090. Bandingkan juga VRAM, riwayat host, ukuran disk, biaya penyimpanan, dan apakah job tersebut training, inference, ComfyUI, labeling data, atau eksperimen sekali jalan. RTX 4090 yang sangat murah bisa menjadi pilihan tepat untuk eksperimen singkat dan pilihan yang salah untuk inference produksi.
Harga sewa GPU RunPod
Harga sewa GPU RunPod perlu dipisahkan berdasarkan mode produk. Pod RunPod bukan unit ekonomi yang sama dengan serverless endpoint, dan Secure Cloud bukan profil risiko yang sama dengan Community Cloud.
Saat membandingkan harga sewa GPU RunPod, catat:
- Secure Cloud atau Community Cloud.
- Tarif per jam pod GPU.
- Harga worker serverless jika Anda menggunakan endpoint alih-alih pod.
- Biaya persistent volume dan network volume.
- Perilaku cold start dan minimum worker.
- Perilaku pod yang idle.
- Lokasi data dan apakah workload berulang kali menarik model besar.
RunPod dapat menjadi hemat biaya bagi tim aplikasi AI yang menginginkan akses GPU cepat tanpa mengoperasikan cluster penuh. Pemeriksaan biaya tersembunyi ada pada startup dan penyimpanan: jika setiap worker berulang kali mengunduh bobot besar atau membiarkan volume tetap terpasang setelah eksperimen, tagihan akan lebih tinggi daripada yang tercermin di baris biaya GPU per jam.
Harga sewa GPU Massed Compute
Harga sewa GPU Massed Compute merupakan referensi yang berguna bagi pembeli yang membandingkan penyedia cloud GPU spesialis, terutama ketika pertanyaannya tidak lagi hanya satu pod dev dan mulai melibatkan kapasitas AI khusus. Untuk eksperimen sederhana, bandingkan tarif per jam yang dipublikasikan. Untuk inference produksi atau training multi-node, tanyakan apa saja yang sudah termasuk dalam harga cluster.
Catat:
- Model GPU dan memori.
- Harga on-demand per jam versus penawaran reservasi.
- Komitmen minimum.
- Fabric jaringan.
- Tingkat penyimpanan.
- Syarat dukungan dan SLA.
- Wilayah dan persyaratan kepatuhan.
- Apakah penawaran mencakup setup, migrasi, atau layanan terkelola.
Di sinilah bahasa pengadaan menjadi penting. "Reserved GPU cluster" bisa berarti tarif lebih rendah, hardware terjamin, jaringan privat, akses dukungan, atau semuanya. Minta setiap item biaya dipisahkan.
Harga sewa GPU dari waktu ke waktu
Harga sewa GPU dari waktu ke waktu tidak bergerak dalam garis lurus. Biasanya ada tiga kekuatan yang menarik ke arah berbeda:
| Kekuatan | Dampak pada harga |
|---|---|
| Pasokan hardware baru | GPU yang lebih lama bisa menjadi lebih murah ketika H200, B200, B300, atau kelas yang lebih baru tersedia. |
| Lonjakan permintaan AI | Kapasitas kelas H100/H200 bisa tetap mahal atau langka selama lonjakan peluncuran model, training, atau inference. |
| Peningkatan efisiensi | Quantization yang lebih baik, batching, mesin serving, dan routing model dapat menurunkan biaya per tugas meskipun harga GPU per jam tetap. |
Jangan bergantung pada satu cerita bahwa "harga GPU sedang turun" atau "harga GPU sedang naik". Lacak keluarga GPU yang Anda gunakan secara spesifik, wilayah, ketentuan komitmen, dan efisiensi workload Anda. Biaya per token, gambar, fine-tune, atau sampel training dapat membaik meskipun harga sewa GPU per jam tetap sama.
Biaya tersembunyi dalam sewa GPU cloud
Biaya tersembunyi tidak selalu bersifat jahat. Sering kali itu adalah komponen cloud normal yang menjadi besar karena workload GPU memindahkan file besar dan menganggur saat debugging.
| Biaya tersembunyi | Cara munculnya | Cara mengendalikannya |
|---|---|---|
| Waktu idle | Pod, notebook, atau instance yang berjalan tanpa job aktif | Auto-stop resource yang idle; beri tag pada eksperimen; buat alert untuk GPU yang berjalan lama. |
| Penyimpanan persisten | Volume, disk, snapshot, cache model, dataset | Pisahkan bobot model yang dapat digunakan ulang dari output sementara; bersihkan volume yang terbengkalai. |
| Network egress | Memindahkan dataset, checkpoint, output, atau artefak model lintas wilayah atau keluar ke internet | Simpan data, GPU, dan object storage di wilayah yang sama jika memungkinkan. |
| Cold start | Menarik container dan bobot model sebelum pekerjaan yang berguna dimulai | Prebuild image; gunakan cache lokal; ukur waktu startup sebagai waktu yang dapat ditagihkan. |
| Retry dan job gagal | Gagal out-of-memory, eviction, driver buruk, host yang tidak stabil | Jalankan canary kecil; checkpoint; pin image yang sudah terbukti baik; catat biaya kegagalan. |
| Jaringan multi-node | Premi InfiniBand, RoCE, placement, atau fabric cluster | Reservasi hanya ketika workload benar-benar membutuhkan distributed training. |
| Dukungan dan kepatuhan | Paket dukungan berbayar, cluster privat, kebutuhan audit, layanan terkelola | Tentukan workload mana yang memerlukan ketentuan enterprise dan mana yang bisa tetap eksperimen. |
| Overhead engineering | Waktu yang dihabiskan untuk memelihara skrip, scheduler, dan setup khusus cloud | Masukkan jam setup dan insiden ke dalam worksheet TCO. |
Untuk harga sewa GPU, penyimpanan dan waktu idle adalah dua biaya tersembunyi yang paling mungkin mengejutkan tim kecil. Untuk tim yang lebih besar, dukungan, jaringan, dan kapasitas reservasi yang kurang dimanfaatkan biasanya menjadi risiko anggaran yang lebih besar.
Worksheet harga sewa GPU
Gunakan worksheet ini sebelum Anda menyetujui penyedia, memesan cluster, atau memigrasikan workload.
| Bidang | Contoh | Mengapa ini penting |
|---|---|---|
| Penyedia | RunPod, Vast.ai, Massed Compute, AWS, Google Cloud, Lambda | Memisahkan ekonomi marketplace, cloud spesialis, dan hyperscaler. |
| Mode produk | Pod on-demand, instance spot, cluster reserved, endpoint serverless | Unit penagihan dan profil keandalan berubah حسب mode. |
| Model GPU | H100 SXM, H100 PCIe, A100 80GB, L40S, RTX 4090 | Memori dan interkoneksi sering kali lebih penting daripada nama merek. |
| Region atau host | US-East, EU, community host, datacenter host | Ketersediaan, aturan data, latensi, dan bandwidth berbeda حسب lokasi. |
| Harga GPU per jam | $x.xx/hour |
Hanya titik awal. |
| Unit penagihan minimum | detik, menit, jam, bulan | Pekerjaan singkat sensitif terhadap pembulatan dan cold start. |
| Biaya penyimpanan | volume, disk, snapshot, object storage | Bobot model dan checkpoint dapat menjadi biaya bulanan yang permanen. |
| Bandwidth atau egress | inbound, outbound, public IP, cross-region | Dataset besar dan media yang dihasilkan mengubah total biaya. |
| Persentase idle | 22% |
Ukuran langsung dari waktu sewa yang terbuang. |
| Tingkat kegagalan/retry | 1.08x |
Mencakup eviction, OOM, image buruk, dan restart. |
| Unit output yang berguna | epoch terlatih, gambar yang diterima, 1M token, pekerjaan selesai | Mengonversi harga per jam menjadi nilai bisnis. |
| Dukungan dan operasi | self-managed, managed, SLA, private cluster | Biaya pengadaan dan keandalan harus berada dalam model yang sama. |
Untuk lembar kerja biaya yang lebih mendalam di level model setelah workload disajikan melalui API, bandingkan ini dengan perbandingan harga model AI dan cara membandingkan harga model AI.
Kapan API model lebih murah daripada menyewa GPU
Menyewa GPU tidak otomatis lebih murah daripada menggunakan API model. Sewa GPU menang ketika Anda memiliki utilisasi tinggi, kebutuhan kepemilikan model yang jelas, stack inferensi kustom, batasan privasi, atau workload training yang tidak bisa didelegasikan ke API.
API model bisa lebih murah ketika:
- Utilisasi rendah atau berfluktuasi.
- Tim sering berganti model.
- Keandalan, scaling, dan upgrade akan mengganggu pekerjaan produk.
- Workload membutuhkan banyak keluarga model, bukan satu model yang di-self-host.
- Finance membutuhkan ledger penggunaan, bukan proyek operasi cluster.
Flatkey berada di sisi API dari keputusan tersebut. Flatkey memberi tim satu API key, satu saldo, satu invoice, dan ledger penggunaan di banyak model dan tool resmi. Jika worksheet Anda menunjukkan bahwa GPU yang di-self-host belum menjadi bottleneck sebenarnya, mulailah dengan API multi-provider dan bandingkan biaya per hasil yang diterima sebelum berkomitmen pada operasi cluster. Untuk lapisan tata kelola API, lihat harga AI gateway, manajemen pengeluaran AI API, dan kontrol kuota AI API.
Panduan keputusan: on-demand, spot, reserved, atau API
| Workload | Opsi awal yang lebih baik | Mengapa |
|---|---|---|
| Benchmark model pertama | GPU on-demand | Pengukuran paling bersih, lebih sedikit variabel gangguan. |
| Workflow ComfyUI sekali pakai atau image workflow | GPU on-demand atau marketplace | Setup cepat; kapasitas kelas RTX 4090 mungkin sudah cukup. |
| Batch inference dengan retry | GPU spot atau interruptible | Diskon bisa menguntungkan jika logika retry kuat. |
| Baseline inferensi produksi | GPU reserved atau committed | Utilisasi stabil dapat membenarkan komitmen. |
| Training multi-node | Cluster dedicated atau kapasitas reserved | Jaringan dan penempatan sama pentingnya dengan tarif per jam. |
| Fitur AI volume rendah | API model melalui gateway | Menghindari kapasitas GPU idle dan overhead operasi. |
| Workflow agent multi-model | API model melalui Flatkey | Satu key dan ledger bisa lebih baik daripada mengoperasikan banyak endpoint GPU. |
Kesalahan umum dalam harga sewa GPU
| Kesalahan | Apa yang sebaiknya dilakukan |
|---|---|
| Membandingkan hanya harga GPU per jam yang tercantum | Bandingkan biaya workload yang selesai setelah storage, bandwidth, waktu idle, dan retry. |
| Menganggap diskon spot sebagai penghematan yang pasti | Tambahkan kerugian akibat gangguan dan overhead checkpoint. |
| Memesan kapasitas sebelum mengukur utilisasi | Jalankan on-demand cukup lama untuk mengetahui permintaan dasar. |
| Mengabaikan pembersihan storage | Buat alert untuk volume yang tidak terpasang, snapshot, dan checkpoint lama. |
| Menganggap RTX 4090, L40S, A100, H100, dan H200 dapat dipertukarkan | Sesuaikan VRAM, performa tensor, interconnect, dan stack software dengan workload. |
| Lupa akan gravitasi data | Tempatkan dataset, object storage, dan GPU berdekatan. |
| Menggunakan sewa GPU untuk setiap workload AI | Bandingkan dengan API model saat overhead operasi mendominasi. |
FAQ
Apa cara terbaik untuk membandingkan harga sewa GPU?
Cara terbaik untuk membandingkan harga sewa GPU adalah dengan menghitung biaya per beban kerja yang selesai. Sertakan tarif GPU per jam, penyimpanan, egress, waktu idle, retry, pekerjaan yang gagal, dukungan, dan overhead engineering. Tarif per jam yang lebih rendah bisa jadi lebih mahal jika menyebabkan lebih banyak restart atau waktu idle.
Apakah harga sewa GPU Vast.ai lebih murah daripada penyedia cloud?
Harga sewa GPU Vast.ai bisa lebih rendah untuk beberapa GPU karena merupakan marketplace, tetapi perbandingannya bergantung pada keandalan host, sifat mudah terputus, disk, bandwidth, tier verifikasi, dan toleransi beban kerja. Perlakukan setiap listing sebagai penawaran spesifik, bukan harga universal.
Apakah harga sewa GPU RunPod bersifat on-demand atau spot?
Harga sewa GPU RunPod bergantung pada produk dan jenis cloud yang Anda pilih. Bandingkan Secure Cloud, Community Cloud, pod, serverless endpoint, storage, network volumes, dan perilaku idle secara terpisah.
Kapan saya harus menggunakan kapasitas GPU reserved?
Gunakan kapasitas GPU reserved ketika utilisasi dapat diprediksi, jenis GPU akan tetap berguna selama periode komitmen, dan kapasitas yang terjamin penting. Jika utilisasi baseline Anda rendah, reserve hanya baseline dan lakukan burst sisanya melalui on-demand atau spot.
Mengapa harga sewa GPU dari waktu ke waktu berubah begitu banyak?
Harga sewa GPU dari waktu ke waktu berubah karena pasokan perangkat keras, permintaan AI, kapasitas regional, persaingan penyedia, dan efisiensi serving semuanya bergerak sekaligus. Lacak keluarga GPU yang tepat dan efisiensi beban kerja Anda, bukan hanya rata-rata pasar.
Biaya tersembunyi apa yang paling penting dalam layanan cloud GPU?
Biaya tersembunyi yang paling penting adalah waktu idle, persistent storage, snapshot, egress, cold start, retry, pekerjaan yang gagal, network fabric, dukungan, dan overhead engineering. Tim kecil biasanya paling merasakan idle dan storage terlebih dahulu; tim yang lebih besar biasanya merasakan jaringan, dukungan, dan kapasitas reserved yang kurang dimanfaatkan.
Daftar periksa akhir
Sebelum Anda memilih penyedia sewa GPU, pastikan:
- Model GPU, ukuran memori, region, dan unit penagihan dicatat.
- Mode harga adalah on-demand, spot, reserved, serverless, marketplace, atau dedicated.
- Storage, bandwidth, snapshot, dan waktu idle sudah termasuk.
- Interupsi spot dan pemborosan retry dimodelkan.
- Kapasitas reserved memiliki titik impas utilisasi.
- URL sumber dan tanggal pengecekan dilampirkan pada setiap harga.
- Keputusan akhir didasarkan pada biaya beban kerja yang selesai, bukan hanya harga sewa GPU per jam.
Itulah cara praktis untuk mengevaluasi harga sewa GPU: halaman sumber saat ini, lembar kerja yang disesuaikan dengan beban kerja, dan keputusan yang jelas tentang kapan menyewa perangkat keras sepadan dengan kompleksitas operasionalnya.


