
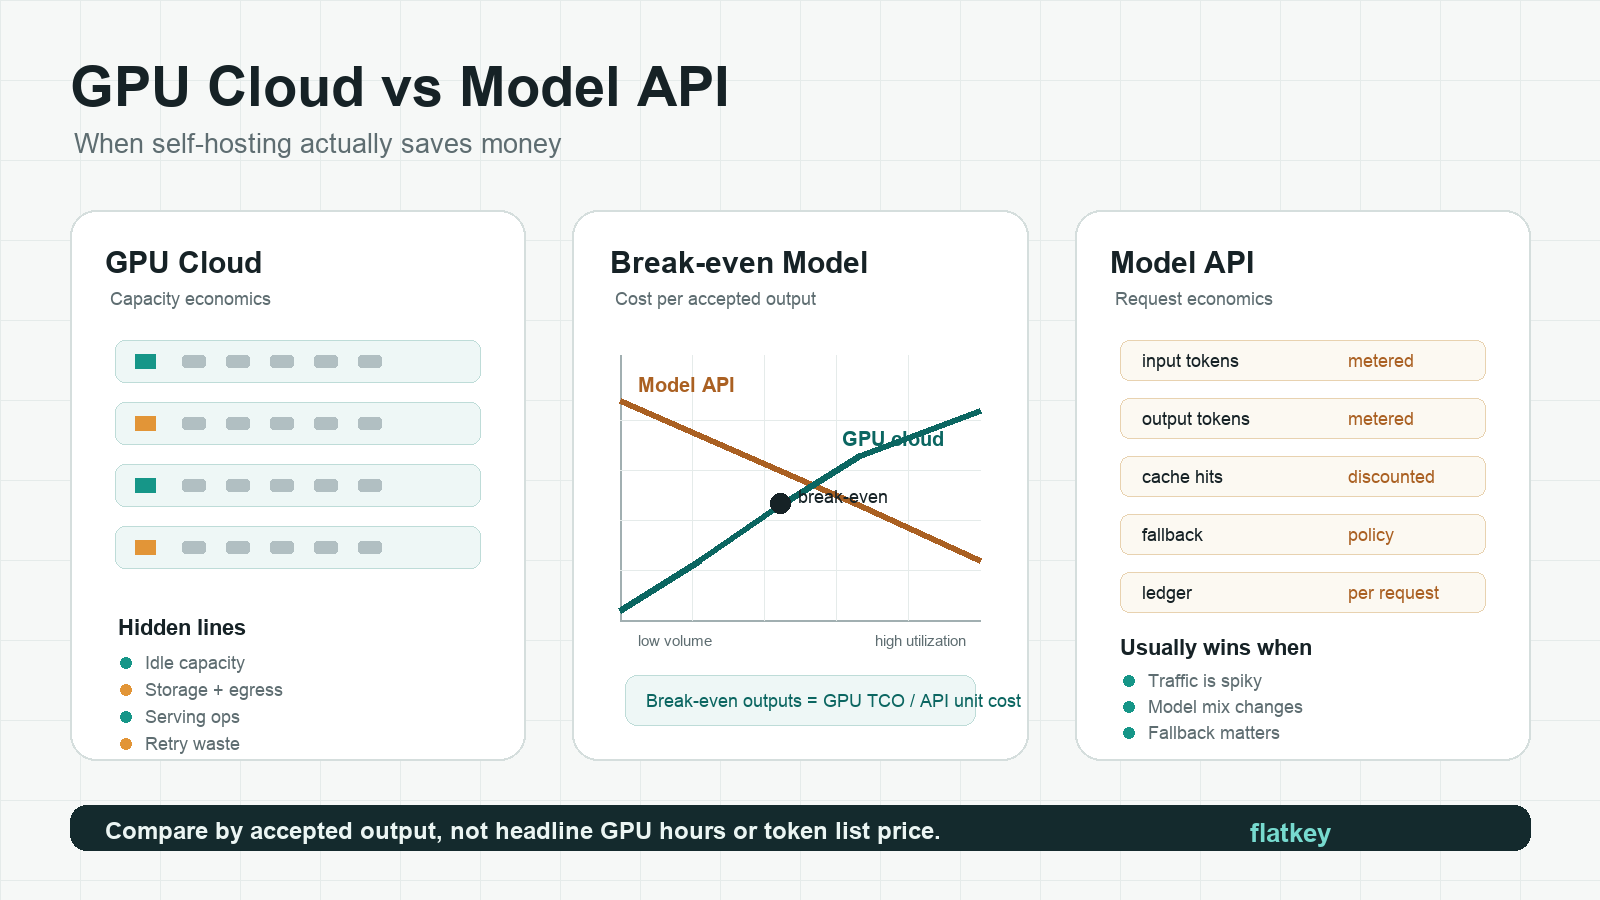
Kebanyakan tim menanyakan soal GPU cloud vs model API terlalu terlambat. Mereka menyewa GPU, men-deploy serving stack, menyesuaikan batching, merekrut dukungan platform, dan baru kemudian membandingkan tagihan dengan model API terkelola. Pada titik itu, perbandingan sudah bias ke arah jalur yang telah mereka investasikan tenaganya.
Pertanyaan yang lebih baik lebih sederhana: apakah Anda membutuhkan kontrol atas lapisan GPU, atau Anda membutuhkan output model yang andal dengan biaya terendah yang dapat diterima?
Bagi tim AI enterprise, GPU cloud mulai menghemat biaya ketika Anda memiliki permintaan yang berkelanjutan, pilihan model yang stabil, utilisasi efektif yang tinggi, dan tim engineering untuk menjalankan inferensi. Model API biasanya lebih murah ketika trafik bersifat spike, pilihan model sering berubah, retry dan failover lebih penting daripada kontrol perangkat keras, atau Anda membutuhkan model frontier yang tidak dapat di-self-host.
Aturan praktis Flatkey: bandingkan GPU cloud vs model API berdasarkan biaya per output yang diterima, bukan hanya berdasarkan tarif GPU per jam atau harga daftar token.
Jawaban cepat GPU cloud vs model API
Gunakan tabel ini sebelum membuat spreadsheet.
| Situasi | Biasanya mulai dengan | Mengapa |
|---|---|---|
| Produk awal, prompt berubah-ubah, permintaan tidak pasti | Model API | Anda menghindari GPU menganggur saat mempelajari trafik, kualitas, dan kecocokan model. |
| Inferensi batch volume tinggi pada satu model open yang stabil | GPU cloud | Utilisasi yang berkelanjutan dapat mengamortisasi serving stack. |
| Chat yang berhadapan dengan pelanggan dengan lonjakan tak terduga | Model API atau hybrid | Autoscaling, fallback, dan tidak adanya kapasitas menganggur sering kali lebih penting daripada harga unit mentah. |
| Bobot proprietari, kernel kustom, locality data yang ketat | GPU cloud | Kebutuhan bisnisnya adalah kontrol, bukan sekadar biaya. |
| Routing model multi-provider, model frontier, atau pergantian model yang sering | Model API | Anda menghindari membangun ulang infrastruktur serving untuk setiap perubahan model. |
| Beban kerja stabil jangka panjang dengan utilisasi yang terbukti | Reserved GPU cloud, dedicated GPU cluster, atau GPU kolokasi | Komitmen dapat menurunkan biaya kapasitas efektif setelah permintaan terbukti. |
Bagian selanjutnya dari panduan ini memberi model yang bisa disalin untuk membandingkan GPU cloud vs model API tanpa menyembunyikan waktu idle, retry, operasi, atau filter kualitas.
Unit biaya yang benar-benar penting
Jangan membandingkan:
- Tarif GPU per jam vs harga token.
- Kutipan cloud vs benchmark pada kondisi terbaik.
- Harga daftar model API vs cluster self-hosted yang sepenuhnya terpakai.
Sebaliknya, bandingkan salah satu penyebut berikut:
| Beban kerja | Penyebut terbaik |
|---|---|
| Chat LLM atau agent | Biaya per respons yang diterima, tugas yang diterima, atau token output yang diterima |
| Klasifikasi batch atau ekstraksi | Biaya per record yang diterima |
| Generasi kode | Biaya per patch yang diterima atau tugas coding yang selesai |
| Generasi gambar | Biaya per gambar yang diterima setelah filter kualitas |
| Generasi video | Biaya per detik yang diterima atau klip yang diterima |
| Fine-tuning atau training | Biaya per run yang selesai |
Untuk sebagian besar tim inferensi:
effective_unit_cost =
  all_in_monthly_cost
  / accepted_outputs_after_retries_quality_filters_and_failures
Di sinilah banyak perbandingan GPU cloud vs model API berbalik. Endpoint self-hosted bisa menunjukkan throughput benchmark yang sangat baik namun tetap kalah jika utilisasi rendah, model gagal pada pemeriksaan kualitas, atau engineer terlalu banyak menghabiskan waktu menjaga stack tetap sehat.
Model biaya Model API
Model API terlihat sederhana karena tagihan biasanya diukur berdasarkan request, token, gambar, detik video, atau panggilan tool. Namun model model API yang adil tetap membutuhkan lebih dari sekadar harga unit yang dipublikasikan.
Gunakan model ini:
monthly_model_api_cost =
  input_token_cost
  + cached_input_or_context_cost
  + output_token_cost
  + tool_or_media_cost
  + retry_and_fallback_cost
  + gateway_or_router_cost
  + observability_and_finops_cost
Lalu normalkan:
model_api_cost_per_accepted_output =
  monthly_model_api_cost
  / accepted_outputs
Yang perlu dicatat:
| Pos biaya | Apa yang perlu dicek |
|---|---|
| Token input dan output | Halaman harga resmi penyedia, model ID, context window, output cap, dan tanggal pengecekan. |
| Input yang di-cache | Apakah penyedia mendukung prompt caching atau diskon cache-hit, dan apakah beban kerja Anda benar-benar menggunakan kembali konteks. |
| Harga batch | Apakah pemrosesan batch atau async sesuai dengan kebutuhan latensi Anda. |
| Retry | Retry karena rate limit, error sementara, pemeriksaan kualitas yang gagal, dan request fallback. |
| Lapisan router/gateway | Biaya gateway apa pun, ledger penggunaan, model allowlist, anggaran sub-key, atau workflow invoice. |
| Operasi | Integrasi, monitoring, penanganan status penyedia, dan rekonsiliasi keuangan. |
Gunakan halaman sumber resmi untuk angka saat ini, bukan tabel tarif yang disalin. Mulailah dengan OpenAI API pricing, Anthropic pricing, Google Gemini API pricing, dan halaman harga terkini dari gateway atau router Anda.
Bagi Flatkey, sisi model API adalah tentang satu key, satu saldo, dan satu buku besar penggunaan di seluruh model dan alat resmi. Itu penting ketika masalah biaya yang sebenarnya bukan satu panggilan model, melainkan key yang tersebar, beberapa invoice, kontrol anggaran per tim, dan fallback lintas penyedia.
Model biaya cloud GPU
Cloud GPU bukan hanya harga GPU per jam. Sebuah API model yang di-self-host untuk produksi memiliki biaya kapasitas, software serving, storage, networking, monitoring, pekerjaan menjaga uptime, dan kapasitas menganggur.
Gunakan model ini:
monthly_gpu_cloud_cost =
  gpu_compute_hours
  + storage_and_snapshot_cost
  + bandwidth_and_egress_cost
  + load_balancing_and_network_cost
  + serving_stack_cost
  + observability_and_logging_cost
  + platform_engineering_cost
  + support_plan_or_managed_service_cost
  + idle_capacity_cost
  + retry_failure_and_redeployment_waste
Lalu normalkan:
self_hosted_cost_per_accepted_output =
  monthly_gpu_cloud_cost
  / accepted_outputs
Yang perlu ditangkap:
| Komponen biaya | Mengapa itu mengubah jawaban |
|---|---|
| Model GPU dan memori | GPU kelas H100, H200, B200, A100, L40S, dan RTX memiliki kurva memori, throughput, pasokan, dan harga yang berbeda. |
| Mode produk | On-demand, spot, reserved, marketplace, serverless GPU, cluster khusus, dan bare metal memiliki profil reliabilitas yang berbeda. |
| Utilisasi | Endpoint self-hosting yang lebih murah cepat kalah jika GPU dibiarkan menganggur. |
| Serving stack | vLLM, SGLang, TensorRT-LLM, NIM, atau server kustom membutuhkan dukungan operasi yang nyata. |
| Storage dan pemuatan model | Bobot besar, snapshot, volume, dan pull berulang bisa menjadi biaya yang material. |
| Networking | Egress, private link, public IP, dan load balancing dapat mengubah ekonomi unit. |
| Kegagalan | Error out-of-memory, preemption, container yang buruk, dan cold start meningkatkan biaya yang diterima. |
Gunakan halaman penyedia saat ini sebagai titik cek: harga AWS EC2, instance AWS P5, harga GPU Google Cloud, harga RunPod, Lambda GPU Cloud, dan harga Vast.ai.
Perlakukan setiap harga GPU sebagai informasi bertimestamp. Pasokan marketplace, ketersediaan regional, dan penawaran komitmen bisa berubah lebih cepat daripada artikel yang sedang Anda baca.
Rumus titik impas
Ini adalah titik ketika keputusan GPU cloud vs model API menjadi layak secara finansial, bukan didorong opini.
Model break-even yang paling sederhana adalah:
break_even_outputs =
  monthly_gpu_cloud_cost
  / model_api_cost_per_accepted_output
Jika workload Anda menghasilkan accepted output lebih banyak daripada break_even_outputs, self-hosting mungkin menghemat biaya. Jika lebih sedikit, model API kemungkinan lebih murah.
Anda juga bisa mengekspresikan ide yang sama dalam bentuk utilisasi:
required_utilization =
  monthly_gpu_cloud_cost
  / equivalent_model_api_cost_at_expected_volume
Rumus itu hanya berguna jika workload stabil. Jika volume, model, panjang konteks, atau target kualitas berubah setiap bulan, sisi model API memiliki nilai opsi yang tidak ditangkap oleh rumus utilisasi.
Contoh perhitungan: mengapa harga GPU per jam bisa menyesatkan
Misalkan sebuah tim sedang memutuskan apakah akan self-host model open yang stabil.
| Input | Contoh nilai |
|---|---|
| Total biaya cloud GPU | $24.000 per bulan |
| Volume accepted output | 30 juta accepted output per bulan |
| Biaya self-hosting per accepted output | $0,0008 |
| Biaya model API per accepted output | $0,0012 |
| Biaya model API bulanan pada volume yang sama | $36.000 |
| Penghematan self-hosting yang tampak | $12.000 per bulan |
Pada kasus dasar itu, cloud GPU terlihat menghemat biaya.
Sekarang stres asumsi-asumsinya.
| Perubahan | Dampak |
|---|---|
| Utilisasi yang berguna turun 35% | Biaya unit self-hosting naik karena pool GPU tetap melakukan lebih sedikit pekerjaan yang diterima. |
| Tingkat retry atau kegagalan kualitas menjadi dua kali lipat | Kedua jalur menjadi lebih mahal, tetapi self-hosting juga menyerap pemborosan kapasitas. |
| Produk beralih ke model yang lebih besar | GPU yang ada mungkin memerlukan sharding, memori lebih besar, atau serving stack baru. |
| Permintaan menjadi sporadis | Model API dapat menyesuaikan skala dengan permintaan; pool GPU harus berukuran untuk puncak atau menerima antrean. |
Jika skenario buruk menghapus penghematan itu, self-hosting sebenarnya tidak lebih murah. Itu adalah taruhan kapasitas.
Kapan cloud GPU benar-benar menghemat biaya
Cloud GPU dapat menghemat biaya ketika sebagian besar dari hal-hal ini benar:
- Anda memiliki permintaan yang berkelanjutan, bukan lonjakan sesekali.
- Keluarga model stabil selama berbulan-bulan, bukan berhari-hari.
- Model bersifat open-weight atau tersedia untuk di-self-host dengan cara lain.
- Beban kerja memiliki pemanfaatan yang tinggi dan berguna setelah jeda antrean dan kegagalan.
- Target latensi dapat dipenuhi dengan stack serving Anda.
- Anda dapat menjalankan vLLM, SGLang, TensorRT-LLM, NIM, atau stack lain secara andal.
- Tim dapat memantau utilisasi GPU, tekanan memori, latensi p95/p99, tingkat error, dan amplifikasi retry.
- Anda memiliki rencana untuk pemuatan model, cache warming, otomatisasi shutdown, dan keamanan rollout.
- Penawaran mencakup asumsi storage, egress, dukungan, dan ketersediaan.
- Tim finance nyaman mendanai kapasitas sebelum setiap request tiba.
Ini umum untuk inference batch bervolume tinggi, pipeline ekstraksi internal, bot support yang stabil, model open domain-spesifik, dan beban kerja di mana bobot kustom atau kedekatan data menjadi penting.
Untuk perencanaan sisi GPU yang lebih mendalam, gunakan panduan Flatkey tentang harga sewa GPU, GPU terbaik untuk inference LLM, penyewaan klaster GPU, dan TCO klaster GPU.
Kapan model API tetap lebih murah
Model API biasanya tetap lebih murah ketika hal-hal berikut benar:
- Lalu lintas bersifat lonjakan, musiman, atau masih belum diketahui.
- Aplikasi memerlukan beberapa model frontier.
- Model berubah lebih cepat daripada rencana infrastruktur Anda.
- Tim membutuhkan fallback, penanganan rate limit, invoice, log penggunaan, dan kontrol anggaran lebih daripada kontrol hardware.
- Anda tidak dapat menjaga GPU tetap sibuk cukup lama untuk mengimbangi waktu idle.
- Anda tidak memiliki tim platform yang siap mengoperasikan layer serving.
- Beban kerja mencakup model tertutup, generasi multimodal, kapabilitas proprietary dari penyedia, atau peluncuran model yang bergerak cepat.
- Procurement menginginkan atribusi per request alih-alih tagihan infrastruktur gabungan.
Di sinilah perbandingan GPU cloud vs model API bukan hanya soal harga. Model API dapat mengurangi waktu integrasi, kompleksitas procurement, dan luasnya area insiden.
Flatkey cocok untuk sisi keputusan ini ketika tim menginginkan satu jalur OpenAI-compatible untuk banyak model resmi, satu saldo prabayar, satu invoice, anggaran sub-key, allowlist model, catatan penggunaan tingkat request, dan failover lintas kanal upstream. Lihat panduan terkait tentang perbandingan harga model AI, perbandingan harga AI API, harga AI gateway, dan manajemen pengeluaran AI API.
Hybrid sering kali adalah jawaban yang sebenarnya
Banyak tim AI enterprise tidak seharusnya memaksakan satu jawaban universal. Model hybrid sering kali lebih defensible:
| Potongan beban kerja | Default yang lebih baik |
|---|---|
| Inference open-weight bervolume tinggi yang stabil | GPU cloud |
| Reasoning atau coding model frontier | Model API |
| Batch job yang bisa antre | GPU cloud, spot, atau kapasitas reserved |
| Lonjakan yang menghadap pelanggan | Model API atau overflow hybrid |
| Bobot proprietary | GPU cloud |
| Eksplorasi model | Model API |
| Deploy yang teregulasi dengan kontrol infrastruktur | Dedicated GPU cloud, private GPU cloud, colocation, atau on-premises |
Pola hybrid adalah:
- Arahkan beban kerja yang belum diketahui dan bervariasi melalui model API.
- Benchmark beban kerja yang stabil di GPU cloud.
- Pindahkan hanya beban kerja dengan volume terbukti dan stabilitas model ke self-hosting.
- Pertahankan fallback model API untuk overflow, upgrade model, dan diversitas penyedia.
Jalur itu menghindari kesalahan termahal: membeli kapasitas GPU untuk beban kerja yang kemudian berubah bentuk.
Rencana benchmark sebelum beralih
Jalankan traffic yang sama melalui kedua jalur setidaknya selama satu jendela yang representatif.
| Metrik | Jalur GPU cloud | Jalur model API |
|---|---|---|
| Output yang diterima | ||
| Input token atau record | ||
| Output token atau hasil | ||
| Latensi p50 / p95 / p99 | ||
| Waktu ke token pertama | ||
| Tingkat error | ||
| Tingkat retry | ||
| Tingkat penolakan kualitas | ||
| Kapasitas idle | N/A | |
| Jam kerja staf | ||
| Storage dan egress | ||
| Total biaya | ||
| Biaya per output yang diterima |
Lalu tanyakan:
- Apakah GPU cloud masih menang setelah waktu idle?
- Apakah masih menang setelah waktu staf?
- Apakah masih menang setelah retry dan filter kualitas?
- Apakah masih menang jika model berubah?
- Apakah masih menang jika traffic turun 30%?
- Apakah masih menang jika latensi p95 harus membaik?
Jika jawabannya ya dalam skenario terburuk, self-hosting layak mendapatkan jalur procurement yang serius.
Checklist procurement
Untuk GPU cloud:
- GPU, ukuran memori, CPU, RAM, disk, interconnect, dan bandwidth jaringan apa saja yang disertakan secara tepat?
- Apakah kapasitasnya on-demand, spot, marketplace, secure cloud, reserved, dedicated, atau bare metal?
- Biaya storage, snapshot, egress, public IP, load balancer, support, dan observability apa yang tidak termasuk?
- Apa yang terjadi saat host gagal, preemption, maintenance, atau kekurangan kapasitas?
- Bisakah penyedia menjalankan benchmark aktual Anda sebelum komitmen?
- Apa jangka minimum, jalur peningkatan, dan biaya keluar?
Untuk model API:
- Model ID, context window, output cap, dan unit harga apa yang digunakan secara tepat?
- Apakah cache hit, batch job, unit image/video, dan panggilan tool dikenai harga terpisah?
- Apa batas rate dan opsi fallback-nya?
- Bagaimana retry, panggilan provider yang gagal, dan penolakan kualitas dihitung?
- Bisakah finance mengekspor penggunaan berdasarkan tim, key, model, environment, dan pelanggan?
- Ketentuan retensi data, compliance, dan SLA apa yang berlaku?
Daftar periksa sumber
Gunakan halaman resmi berikut sebagai titik awal untuk input terkini:
| Jenis sumber | Halaman yang perlu dicek |
|---|---|
| Harga model API | Harga API OpenAI, Harga Anthropic, Harga API Google Gemini |
| Harga cloud GPU | Harga AWS EC2, Instans AWS P5, Harga GPU Google Cloud, Harga RunPod, Lambda GPU Cloud, Harga Vast.ai |
| Framework serving | Server kompatibel OpenAI vLLM, Dokumentasi SGLang |
| Spesifikasi GPU | NVIDIA H100, NVIDIA H200, NVIDIA DGX B200 |
| Struktur FinOps | FinOps FOCUS |
| Konteks biaya Flatkey | Harga Flatkey, Flatkey Compute, Indeks harga Flatkey Compute |
Pertanyaan yang sering diajukan
Apakah GPU cloud selalu lebih murah daripada model API?
Tidak. GPU cloud lebih murah hanya ketika utilisasi yang berguna cukup tinggi untuk mengimbangi kapasitas menganggur, storage, egress, operasi serving, pemborosan retry, dan waktu staf. Model API bisa lebih murah untuk beban kerja yang bersifat bursty atau berubah-ubah meskipun harga token terlihat lebih tinggi.
Kapan self-hosting LLM menghemat biaya?
Self-hosting menghemat biaya ketika modelnya stabil, volumenya tinggi, utilisasinya dapat diprediksi, tim dapat mengoperasikan stack serving, dan biaya cloud GPU all-in per output yang diterima lebih rendah daripada biaya model API dengan asumsi skenario downside.
Bagaimana saya harus membandingkan harga GPU cloud vs model API?
Bandingkan biaya per output yang diterima. Sertakan token, jam GPU, storage, bandwidth, waktu menganggur, retry, tingkat kegagalan, filter kualitas, waktu engineering, support, dan operasi finance. Jangan hanya membandingkan harga GPU per jam dengan harga daftar token.
Apa biaya tersembunyi terbesar dari inferensi GPU cloud?
Biaya tersembunyi terbesar biasanya adalah kapasitas menganggur, operasi engineering, storage dan egress, deployment yang gagal, retry karena out-of-memory, dan perubahan serving yang kurang teruji. Biaya-biaya ini tidak muncul dalam tarif GPU per jam yang ditonjolkan.
Apa biaya tersembunyi terbesar dari model API?
Biaya tersembunyi terbesar biasanya adalah retry, panggilan fallback, prompt yang panjang, context yang tidak ter-cache, respons yang berat di output, panggilan tool atau media, akun provider yang tersebar, dan atribusi penggunaan yang lemah. Ledger di level request membantu mengungkap biaya-biaya ini.
Haruskah tim AI enterprise menggunakan arsitektur hybrid?
Sering kali, ya. Gunakan model API untuk eksplorasi, model frontier, lonjakan beban, dan fallback. Pindahkan hanya beban kerja stabil bervolume tinggi ke GPU cloud setelah benchmark membuktikan biaya diterima yang lebih rendah. Pertahankan jalur API untuk overflow dan perubahan model.
Intinya
GPU cloud vs model API bukan keputusan filosofis. GPU cloud vs model API adalah keputusan ekonomi beban kerja.
Pilih GPU cloud ketika Anda dapat membuat kapasitas tetap sibuk, modelnya stabil, dan kontrol hardware menciptakan keunggulan nyata. Pilih model API ketika fleksibilitas, akses multi-provider, perubahan model yang lebih cepat, dan governance per request lebih berharga daripada penghematan hardware secara teoritis.
Jalur paling aman adalah bertahap: mulai dengan model API, benchmark beban kerja, pindahkan hanya irisan yang stabil ke GPU cloud ketika perhitungan titik impas tetap masuk akal dalam skenario downside, dan pertahankan rute API untuk fallback serta perubahan model di masa depan.
Jika Anda membandingkan GPU cloud vs model API untuk beban kerja AI produksi, Flatkey dapat membantu di sisi API dengan satu kunci, satu saldo, rute model resmi, buku besar penggunaan, anggaran, dan invoice, sementara tim Anda membuktikan beban kerja mana yang benar-benar layak mendapatkan kapasitas GPU khusus.


