Decoding Spekulatif untuk Inferensi LLM: Peningkatan Throughput dan Kompromi
Penyajian decoding spekulatif LLM dapat mengurangi waktu tunggu untuk token berikutnya—tanpa meminta model target menjadi model yang berbeda. Alih-alih membiarkan model target besar menghasilkan hanya satu token per langkah decode, proposer yang lebih murah menyusun draf kelanjutan singkat. Model target memverifikasi kelanjutan tersebut secara paralel, menerapkan prefiks yang diterima, lalu melanjutkan dari ketidaksepakatan pertama.
Ini terdengar seperti akselerator universal. Namun tidak. Hasilnya bergantung pada kualitas draf, campuran permintaan, batching, pengaturan sampling, ruang sisa memori GPU, serta apakah beban kerja Anda benar-benar dibatasi oleh decoding. Panduan ini menjelaskan apa yang terjadi di balik layar, bagaimana EAGLE dan Medusa mengubah desain, serta cara menentukan apakah decoding spekulatif sesuai untuk tumpukan penyajian Anda.
Aturan praktis: perlakukan decoding spekulatif sebagai optimasi penyajian yang harus diukur—bukan pengaturan percepatan versi makalah. Gunakan hanya jika metode ini meningkatkan latensi atau throughput token keluaran yang penting bagi trafik aktual Anda tanpa mengurangi konkurensi atau keandalan.
Apa itu inferensi LLM decoding spekulatif?
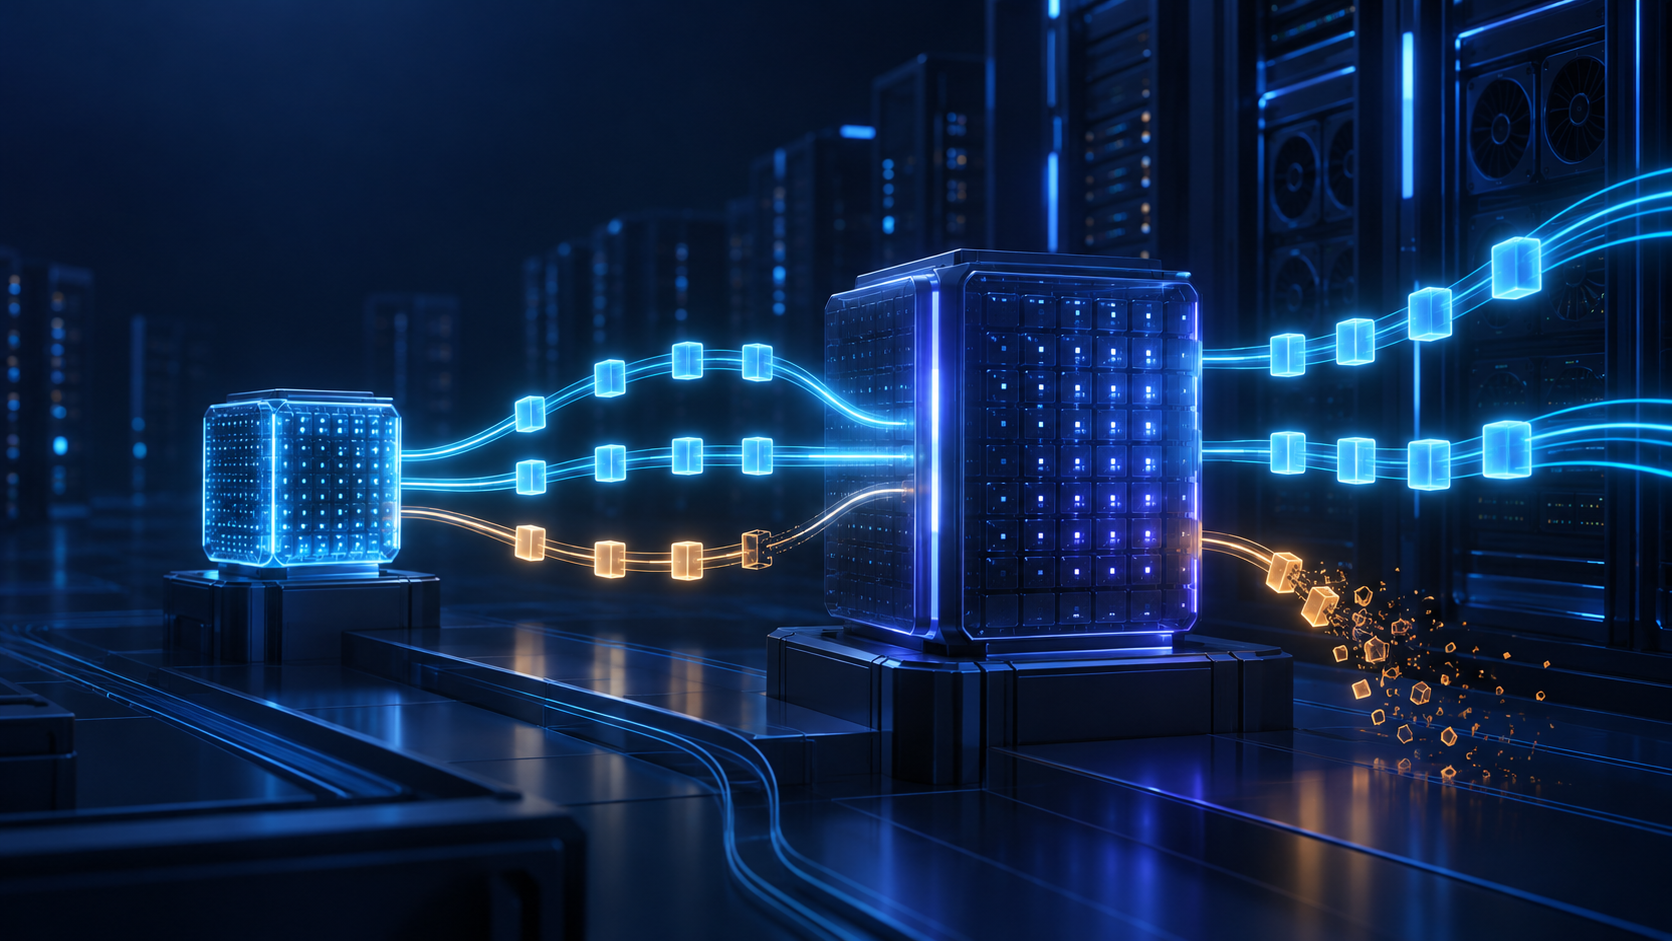
Pembuatan autoregresif bersifat berurutan: token t + 1 bergantung pada token-token sebelumnya. Oleh karena itu, dekoder normal menunggu model target besar berjalan sekali untuk setiap token yang dihasilkan. Decoding spekulatif mengubah penjadwalan, bukan distribusi target: mekanisme draf yang lebih kecil atau terspesialisasi memprediksi beberapa token kandidat; model target menilai atau memverifikasi posisi kandidat secara bersamaan; sistem menerima prefiks yang cocok dan kembali ke mekanisme sebelumnya pada posisi pertama yang ditolak.
Makalah decoding spekulatif asli menjelaskan ini sebagai cara untuk mendapatkan sampel eksak dari model target sambil mengevaluasi beberapa posisi kandidat secara paralel. Hasil 2–3× yang dilaporkannya merupakan hasil benchmark untuk konfigurasi T5 mereka, bukan janji untuk setiap model atau layanan. Baca makalah asli.
Diagram inferensi LLM decoding spekulatif
request + current context
            |
            v
  draft mechanism proposes:  [A] [B] [C] [D]
            |
            v
  target model verifies all proposed positions in one pass
            |
            +-- accepts [A] [B] [C] -> commit that prefix (and possibly one extra target token)
            |
            +-- rejects at [C] -> commit [A] [B], sample/correct at [C], then repeat
Pekerjaan yang dihemat bukanlah komputasi draf itu sendiri. Potensi keuntungan berasal dari penggantian beberapa iterasi decoding model target serial dengan satu tahap verifikasi model target. Jika proposal sering salah, target tetap harus sering memulihkan hasil dan keuntungan pun menyusut.
Metrik yang penting: token yang diterima per verifikasi target
Sinyal kesehatan yang paling berguna adalah jumlah token yang diusulkan dan lolos verifikasi. Tim sering menyebutnya sebagai tingkat penerimaan atau panjang yang diterima. Lacak keduanya:
| Metrik | Informasi yang diberikan | Mengapa dapat menyesatkan jika berdiri sendiri |
|---|---|---|
| Tingkat penerimaan | Bagian token yang diusulkan dan diterima target | Tidak mencakup biaya draf atau biaya verifikasi target. |
| Rata-rata panjang yang diterima | Jumlah token draf yang dikomit per putaran | Rata-rata dapat menyembunyikan permintaan berekor panjang dan mode sampling yang berbeda. |
| Latensi antar-token (ITL) | Waktu di antara token yang di-streaming | Biasanya ini adalah metrik decoding yang terlihat oleh pengguna. |
| Total token output/detik | Kapasitas serving yang berguna di seluruh permintaan bersamaan | Dapat membaik sementara pengguna interaktif dengan QPS rendah hanya melihat sedikit manfaat, atau sebaliknya. |
| Memori GPU dan jumlah permintaan aktif | Apakah proposer mengurangi ruang KV cache atau konkurensi | Satu permintaan yang lebih cepat dapat menjadi konfigurasi yang lebih buruk di tingkat armada. |
Untuk pengujian A/B yang adil, pertahankan revisi model, tokenizer, kuantisasi, panjang output maksimum, campuran prompt, parameter sampling, perangkat keras, dan kebijakan konkurensi tetap sama. Bandingkan latensi end-to-end, waktu hingga token pertama, ITL p50/p95, token output/detik, dan tingkat kesalahan. Satu angka “token/detik” tanpa bentuk bebannya tidak cukup untuk memilih konfigurasi.
Di mana decoding spekulatif membantu—dan di mana tidak
Serving LLM decoding spekulatif biasanya paling menarik saat decoding terikat memori dan setiap permintaan memiliki panjang generasi yang cukup agar putaran verifikasi berulang menjadi berarti. Panduan vLLM saat ini secara khusus memosisikannya sebagai cara untuk mengurangi latensi antar-token bagi beban kerja terikat memori dengan QPS sedang hingga rendah, serta mencatat bahwa peningkatan nyata bergantung pada keluarga model, trafik, perangkat keras, dan pengaturan sampling. Lihat panduan decoding spekulatif vLLM.
Metode ini kurang menarik dalam kasus berikut:
- Prefill mendominasi permintaan. Prompt panjang dengan jawaban singkat menghabiskan sebagian besar waktunya untuk memasukkan konteks. Drafting mengubah pekerjaan decoding, bukan pekerjaan prefill prompt yang sudah mendominasi latensi end-to-end.
- Penerimaan rendah. Decoding kreatif, model draf yang tidak cocok, atau konfigurasi yang menghasilkan kelanjutan kandidat lemah dapat menyebabkan kegagalan verifikasi berulang.
- Server Anda sudah jenuh oleh batch. Pada konkurensi tinggi, GPU target mungkin telah digunakan secara efisien oleh scheduler normal. Menambahkan drafter dapat mengonsumsi memori atau komputasi yang seharusnya dapat melayani lebih banyak permintaan.
- Ruang kosong KV cache terbatas. Model draf tambahan atau state proposer dapat mengurangi jumlah urutan aktif sebelum eviction atau antrean dimulai. Tinjau kebutuhan memori GPU LLM sebelum menafsirkan percepatan satu permintaan sebagai kemenangan tingkat armada.
- Model target tidak kompatibel dengan proposer yang dipilih. Metode berbasis model memerlukan artefak, tokenisasi, dan dukungan serving yang kompatibel; jangan pernah mengasumsikan model kecil adalah model draf yang valid hanya karena lebih murah.
Karena itu, pertanyaan yang tepat bukanlah “Dapatkah decoding spekulatif membuat model ini lebih cepat?” Melainkan, “Kendala tingkat layanan mana yang ditingkatkannya dalam distribusi trafik kami?”
Model draf, EAGLE, dan Medusa: tiga cara mengusulkan token
Model draf terpisah
Desain klasik memasangkan model draf cepat dengan model target yang lebih besar. Draf mengusulkan k token; target memverifikasinya. Secara konseptual ini bisa sederhana, tetapi menambahkan artefak model lain, jejak memori, pekerjaan kompatibilitas, serta permukaan operasional untuk diberi versi dan dipantau.
Gunakan saat Anda memiliki proposer berlatensi rendah yang terbukti kompatibel serta kapasitas GPU yang cukup untuk mempertahankan konkurensi layanan target. Mulailah dengan sejumlah kecil panjang spekulatif—alih-alih mengasumsikan bahwa proposal yang lebih dalam selalu lebih baik.
LLM decoding spekulatif EAGLE
EAGLE adalah pendekatan berbasis model yang melakukan drafting pada tingkat fitur alih-alih hanya menggunakan jalur proposal model-token kecil konvensional. Makalahnya menjelaskan pengondisian prediksi fiturnya dengan urutan token satu langkah ke depan untuk mengatasi ketidakpastian tingkat fitur. Dalam pengaturan yang diuji pada makalah tersebut, EAGLE melaporkan latensi dan throughput yang lebih baik sambil mempertahankan distribusi teks yang dihasilkan; ini adalah bukti berguna mengenai potensi metode tersebut, bukan prakiraan kapasitas untuk model lain atau armada GPU lain. Baca makalah EAGLE.
Bagi operator, implikasinya jelas: EAGLE dapat menarik ketika artefak yang didukung tersedia untuk keluarga target, tetapi bukan sakelar generik untuk setiap checkpoint. Validasi pasangan target/proposer dan versi mesin serving yang tepat sebelum mempromosikannya.
LLM decoding spekulatif Medusa
Medusa menempatkan beberapa head decoding pada model backbone dan menggunakan attention berbasis pohon untuk membuat serta memverifikasi beberapa kelanjutan kandidat. Ini menghindari pengelolaan model draf terpisah yang sepenuhnya independen, tetapi head tersebut harus dilatih atau di-fine-tune untuk backbone. Makalah Medusa membedakan jalur backbone beku dari fine-tuning bersama dan melaporkan percepatan benchmark untuk pengaturan eksperimental tersebut. Baca makalah Medusa.
Kompromi operasionalnya berbeda dari pasangan model draf: potensi pengelolaan model terpisah yang lebih sedikit, tetapi memerlukan artefak khusus model dan pelatihan atau integrasi. Perlakukan ini sebagai pilihan serving model, bukan trik runtime.
Rencana peluncuran praktis untuk inferensi GPU
1. Tetapkan baseline yang representatif
Ambil setidaknya satu irisan permintaan yang menyerupai produksi: rentang panjang prompt, rentang panjang output, bahasa atau jenis tugas, pengaturan temperature/top-p, perilaku streaming, dan tingkat konkurensi. Catat baseline secara terpisah untuk waktu hingga token pertama dan decoding. Jika beban kerja didominasi prompt, jangan biarkan benchmark token output menutupi masalah prefill.
2. Pilih satu strategi proposer dan kedalaman konservatif
Mulailah dengan satu metode yang didukung—model draf, EAGLE, Medusa, atau proposer lain yang didukung mesin—dan panjang kandidat kecil. vLLM, misalnya, mendokumentasikan pengaturan --speculative-config seperti metode, model proposer, dan num_speculative_tokens; konsultasikan dokumentasi yang sesuai dengan versi sebelum menyalin konfigurasi apa pun ke produksi. Untuk penyiapan operasional yang lebih luas, lihat panduan deployment vLLM. Jangan menyetel kedalaman spekulatif dan batching secara bersamaan pada percobaan pertama.
3. Jalankan matriks beban, bukan satu benchmark
Uji irisan trafik yang sama pada konkurensi rendah, sedang, dan menyerupai puncak. Untuk setiap titik, bandingkan:
- Latensi end-to-end baseline vs. spekulatif.
- Latensi antar-token p50 dan p95 untuk permintaan streaming.
- Total token output/detik dan permintaan selesai/detik.
- Panjang yang diterima, frekuensi penolakan, dan latensi proposer.
- Memori GPU, tekanan KV cache, penundaan antrean, dan tingkat kesalahan/timeout.
Jika memungkinkan, pisahkan hasil berdasarkan rentang prompt dan rentang output. Konfigurasi yang membantu penyelesaian kode panjang mungkin tidak membantu jawaban chat singkat, dan hasil offline yang baik dapat menurun setelah antrean diperhitungkan.
4. Tetapkan guardrail sebelum canary
Tentukan ambang rollback sebelum trafik menerima perubahan: misalnya, regresi pada ITL p95, penurunan permintaan selesai/detik pada beban puncak, peningkatan kejadian kehabisan memori, atau penurunan tingkat penerimaan yang terus-menerus. Pada awalnya, arahkan hanya irisan yang memenuhi syarat dan pertahankan jalur baseline untuk perbandingan cepat.
5. Tetap lakukan pengukuran setelah peluncuran
Penerimaan berubah seiring pembaruan model, distribusi prompt, format penggunaan tool, dan default sampling. Jalankan kembali perbandingan setelah perubahan material pada model target, tokenizer, kuantisasi, GPU, mesin serving, atau profil trafik.
Titik awal vLLM minimal
Untuk mesin serving yang mendukungnya, konfigurasi harus menyatakan metode proposer, bukan menyembunyikannya dalam default yang tidak transparan. Dokumentasi vLLM saat ini menggunakan struktur seperti berikut untuk model draf terpisah:
vllm serve <target-model> \
  --speculative-config '{
    "method": "draft_model",
    "model": "<compatible-draft-model>",
    "num_speculative_tokens": 5
  }'
Placeholder tersebut memang disengaja. Model yang kompatibel, jumlah token spekulatif, pengaturan paralelisme, dan anggaran memori harus dipilih dari artefak serta versi mesin yang telah Anda uji. Jangan menyalin snippet ini sebagai bukti bahwa pasangan target/draf tertentu didukung.
Peningkatan throughput dan kompromi secara ringkas
| Keputusan | Potensi keuntungan | Biaya utama atau mode kegagalan | Yang harus diukur terlebih dahulu |
|---|---|---|---|
| Mengaktifkan model draf terpisah | Lebih sedikit langkah decoding target serial saat penerimaan tinggi | Memori model tambahan, kompatibilitas, dan latensi draf | Panjang yang diterima, ruang kosong KV cache, ITL p95 |
| Meningkatkan panjang spekulatif | Lebih banyak potensi token per verifikasi | Lebih banyak pekerjaan draf yang terbuang saat token berikutnya ditolak | ITL bersih dan TPS output total, bukan hanya penerimaan |
| Menggunakan EAGLE | Jalur proposal berbasis model yang kuat saat artefak didukung | Persyaratan kompatibilitas keluarga model dan mesin | Kompatibilitas target/proposer dan hasil benchmark sesuai bentuk beban |
| Menggunakan Medusa | Proposal multi-head tanpa model draf penuh terpisah | Head khusus model serta pekerjaan integrasi/pelatihan | Pemeriksaan kualitas output, dukungan serving, dan jalur rollback |
| Mengaktifkannya pada QPS puncak | Kemungkinan manfaat throughput pada mesin/beban kerja yang tepat | Persaingan scheduler, memori, atau komputasi dapat menghapus keuntungan | Permintaan selesai/detik, waktu antrean, dan tingkat kesalahan |
FAQ
Apakah decoding spekulatif mengubah jawaban dari model target?
Sampling spekulatif yang tepat menggunakan verifikasi dan koreksi model target sehingga sampling dapat mempertahankan distribusi target. Jaminannya bergantung pada penggunaan algoritme yang benar dan implementasi yang kompatibel. Perubahan serving tetap dapat memengaruhi perilaku operasional—seperti latensi, antrean, atau kesalahan—jadi evaluasi kualitas dan keandalan selain kecepatan.
Apakah decoding spekulatif meningkatkan waktu hingga token pertama?
Biasanya, metode ini menargetkan fase decoding setelah generasi dimulai. Jika pemrosesan prompt mendominasi permintaan Anda, waktu hingga token pertama mungkin hanya sedikit berubah. Ukur prefill dan decoding secara terpisah.
Berapa banyak token spekulatif yang harus digunakan?
Tidak ada nilai terbaik yang universal. Uji rentang kecil terhadap model, proposer, pengaturan sampling, jenis GPU, dan konkurensi Anda. Proposal yang lebih panjang hanya menguntungkan jika cukup banyak tokennya diterima dan pekerjaan tambahannya tidak mengurangi kapasitas layanan.
Haruskah saya menggunakan EAGLE atau Medusa?
Pilih metode yang didukung dengan baik oleh model target dan mesin serving Anda, lalu benchmark pada beban kerja Anda. EAGLE mengandalkan artefak drafting tingkat fitur yang didukung; Medusa mengandalkan beberapa head yang terkait dengan backbone. Keduanya tidak secara otomatis dapat dipertukarkan dengan model draf generik.
Tempatkan keputusan dalam konteks
Decoding spekulatif adalah salah satu lapisan optimasi serving LLM. Metode ini bekerja paling baik bersama pilihan serving model yang jelas, batas kapasitas realistis, dan pemantauan eksplisit. Untuk perbandingan mesin serving yang lebih luas, lihat vLLM vs SGLang: Throughput, Latensi, Dukungan Model, dan Operasi. Untuk sisi kapasitas API produksi, lihat RPM vs TPM: Batas Laju LLM dan Perbaikan 429.
Jika Anda merencanakan eksperimen GPU atau lingkungan inferensi baru, jelajahi Flatkey Compute dan mulailah dengan rencana benchmark yang melaporkan latensi yang terlihat pengguna serta throughput tingkat armada. Konfigurasi LLM decoding spekulatif terbaik adalah konfigurasi yang meningkatkan metrik terbatas Anda pada beban nyata—dan dapat di-rollback dengan aman ketika beban kerja berubah. Panduan LLM decoding spekulatif ini adalah titik awal untuk disiplin pengukuran tersebut, bukan penggantinya.
Sumber
- Leviathan, Kalman, dan Matias — Inferensi Cepat dari Transformer melalui Decoding Spekulatif
- Cai et al. — Medusa: Kerangka Akselerasi Inferensi LLM Sederhana dengan Beberapa Head Decoding
- Li et al. — EAGLE: Sampling Spekulatif Memerlukan Pemikiran Ulang tentang Ketidakpastian Fitur
- Dokumentasi vLLM — Decoding Spekulatif