
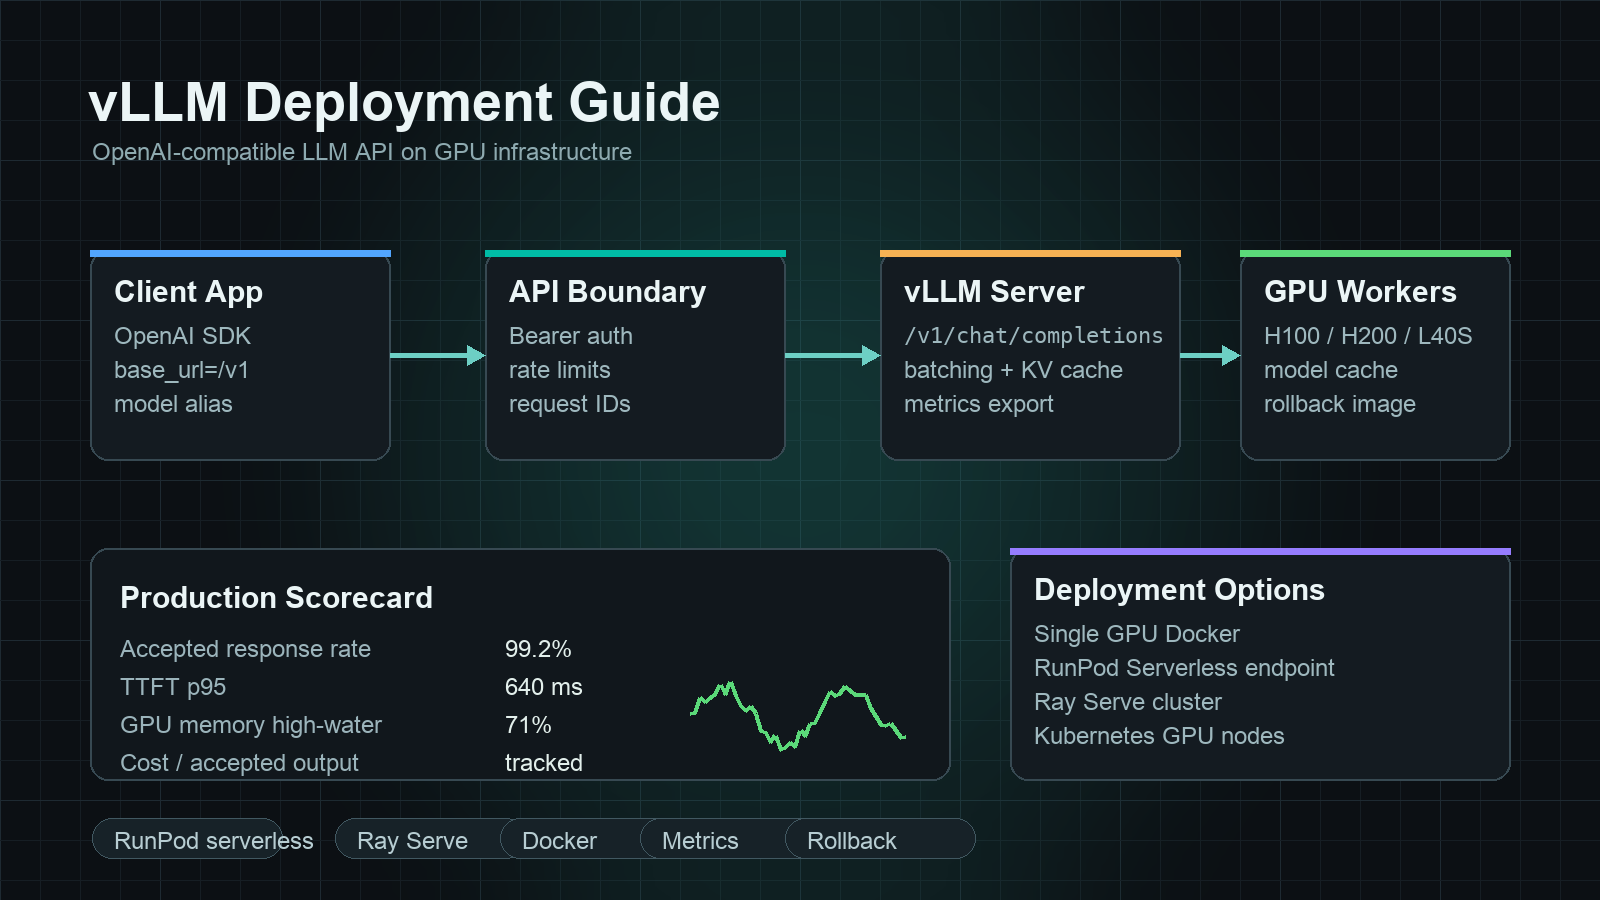
Sebuah panduan deployment vLLM harus menjawab satu pertanyaan praktis: bagaimana Anda mengubah kapasitas GPU menjadi API LLM yang kompatibel dengan OpenAI yang dapat dipanggil, dipantau, di-rollback, dan dibandingkan oleh tim aplikasi terhadap API model terkelola?
Jawaban singkatnya adalah mulai dengan satu model, satu bentuk GPU, satu rute yang kompatibel dengan OpenAI, dan satu rencana pengukuran. vLLM dapat mengekspos /v1/models, /v1/chat/completions, dan endpoint bergaya OpenAI lainnya yang familier, tetapi deployment produksi lebih dari sekadar perintah vllm serve pertama. Anda memerlukan image container, cache model, batas autentikasi, health check, metrik, batas request, load test, dan scorecard biaya per output yang diterima.
Panduan deployment vLLM ini memberi developer AI dan tim platform jalur deployment dari satu server GPU ke RunPod Serverless, Ray Serve, dan pola produksi bergaya Kubernetes. Ini juga menjelaskan kapan API model atau router seperti Flatkey mungkin lebih sederhana daripada mengelola sendiri layer serving GPU.
Panduan deployment vLLM cepat
Gunakan urutan ini sebelum menambahkan kompleksitas orkestrasi.
| Langkah | Keputusan | Default praktis |
|---|---|---|
| 1. Pilih model | Pilih satu model yang didukung dan revisi yang tepat | Mulai dengan model terkecil yang membuktikan kontrak API, lalu skalakan |
| 2. Pilih GPU | Konfirmasi kecocokan memori sebelum menyetel throughput | Gunakan kelas GPU yang sama di pengujian dan produksi |
| 3. Mulai vLLM | Ekspos API yang kompatibel dengan OpenAI | Gunakan vllm serve terlebih dahulu, lalu containerize |
| 4. Kunci batas request | Batasi panjang konteks, konkurensi, dan ukuran output | Lindungi GPU dari prompt yang tidak dibatasi |
| 5. Tambahkan auth dan kontrol jaringan | Jangan ekspos worker GPU mentah secara langsung | Letakkan gateway, ingress, atau private endpoint di depan |
| 6. Ukur output yang diterima | Lacak respons sukses, latensi, retry, dan biaya | Bandingkan dengan biaya per output yang diterima pada API model |
| 7. Tambahkan mekanisme rollout | Canary, rollback, dan alias model berversi | Jaga kode klien tetap stabil saat ada perubahan serving |
Tujuannya bukan agar setiap workload di-self-host. Tujuannya adalah mengetahui kapan vLLM yang di-self-host layak untuk beban operasionalnya.
Apa yang diberikan vLLM kepada Anda
vLLM adalah engine inference dan serving open-source untuk large language model. Dokumentasinya mencakup serving yang kompatibel dengan OpenAI, deployment Docker, metrik, prefix caching, quantization, speculative decoding, paralelisme, dan arsitektur model yang didukung. Bagian-bagian tersebut menjadikan vLLM default yang kuat ketika Anda ingin menyajikan model open-weight di belakang kontrak API yang familier.
Properti produksi yang berguna adalah batas API. Jika aplikasi Anda sudah memanggil klien yang kompatibel dengan OpenAI, endpoint vLLM dapat mengurangi pekerjaan penulisan ulang aplikasi. Layer serving mungkin berubah, bobot model mungkin berubah, dan host GPU mungkin berpindah, sementara kode klien tetap mengirim request chat-completion ke satu base URL.
Itu tidak menghilangkan pekerjaan platform. Itu memindahkan pekerjaan berat dari integrasi aplikasi ke operasi inferensi: alokasi GPU, loading model, batching, observability, rate limit, respons insiden, dan manajemen biaya.
Deployment vLLM satu GPU
Mulai secara lokal atau pada satu GPU cloud sebelum Anda menambahkan serverless, Ray, atau Kubernetes.
pip install vllm

vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Lalu uji endpoint yang kompatibel dengan OpenAI.
curl http://localhost:8000/v1/models
Gunakan request chat yang menyerupai request yang sebenarnya akan dikirim aplikasi Anda.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "messages": [
      {"role": "user", "content": "Tulis checklist deployment tiga poin."}
    ],
    "temperature": 0.2,
    "max_tokens": 300
  }'
Deployment pertama ini bukan produksi. Ini menjawab empat pertanyaan:
- Apakah model berhasil dimuat pada GPU yang dipilih?
- Apakah klien Anda memahami bentuk responsnya?
- Apakah streaming, tool calling, atau structured output berfungsi untuk request spesifik Anda?
- Berapakah perkiraan time-to-first-token dan latensi end-to-end?
Jaga agar pengujian pertama tetap sederhana. Jangan lakukan tuning batching, quantization, atau paralelisme sampai endpoint dasarnya berfungsi.
Deployment Docker untuk server GPU yang repeatable
Untuk server yang repeatable, gunakan jalur Docker resmi vLLM atau image container yang dipin di registry Anda sendiri. Kontrol produksi yang penting bukan hanya tag image. Itu juga mencakup stack driver, kompatibilitas CUDA, cache model, mount volume, port jaringan, dan flag proses.
Bentuk contoh:
docker run --gpus all \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env HUGGING_FACE_HUB_TOKEN=$HUGGING_FACE_HUB_TOKEN \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Sebelum menggunakan pola ini di produksi, pin versi:
- Tag image vLLM.
- Driver NVIDIA dan container runtime.
- Stack CUDA, jika dikelola secara terpisah.
- Revisi model atau hash commit.
- Perilaku tokenizer dan template chat.
- Mode quantization, jika digunakan.
Sebuah panduan deployment vLLM belum lengkap jika hanya mengatakan "jalankan Docker." Runbook juga perlu perilaku restart, logging, pemanasan cache model, probe kesiapan, dan jalur rollback ke image dan revisi model sebelumnya.
Buat endpoint kompatibel dengan OpenAI, tetapi jangan tanpa autentikasi
vLLM dapat berbicara dengan API yang kompatibel dengan OpenAI, tetapi worker vLLM mentah Anda biasanya tidak boleh menjadi batas internet publik. Letakkan sesuatu di depannya:
- Endpoint VPC privat untuk layanan internal.
- API gateway dengan validasi bearer token.
- Service mesh atau ingress controller dengan mTLS.
- Proxy tipis di level aplikasi yang menegakkan alias model, request ID, dan anggaran per tim.
- Lapisan router ketika Anda perlu fallback ke API model terkelola.
Gunakan base URL yang spesifik per lingkungan:
VLLM_BASE_URL_DEV=http://localhost:8000/v1
VLLM_BASE_URL_STAGING=https://staging-inference.example.com/v1
VLLM_BASE_URL_PROD=https://inference.example.com/v1
Lalu buat klien aplikasi tetap dapat dibalikkan:
from openai import OpenAI

client = OpenAI(
    api_key="not-used-by-raw-vllm",
    base_url="https://inference.example.com/v1",
)

response = client.chat.completions.create(
    model="llama-3-1-8b-instruct",
    messages=[{"role": "user", "content": "Ringkas rencana deployment ini."}],
)
Jika nanti Anda merutekan sebagian request ke lapisan API model OpenAI-compatible milik Flatkey, pola klien yang sama tetap berguna: ubah base URL, API key, dan alias model sambil menjaga kontrak aplikasi tetap stabil.
Pengaturan produksi yang perlu diputuskan sebelum trafik masuk
Flag deployment bergantung pada model, GPU, dan workload, tetapi setiap tim harus memutuskan kontrol ini sebelum trafik produksi:
| Kontrol | Mengapa penting |
|---|---|
| Panjang model maksimum | Mencegah beberapa prompt panjang menghabiskan seluruh memori KV-cache |
| Token output maksimum | Mencegah generasi yang tak terkendali mengikat kapasitas decode |
| Batas konkurensi | Melindungi latensi p95 dan p99 saat trafik meledak |
| Timeout request | Menghentikan request yang macet agar overload tidak tersamarkan |
| Kebijakan antrean | Menentukan apakah permintaan berlebih menunggu, gagal cepat, atau fallback |
| Alias model | Memungkinkan klien memakai nama stabil saat revisi yang disajikan berubah |
| Batas autentikasi | Mencegah endpoint GPU yang mahal menjadi proxy terbuka |
| Kebijakan logging | Menyeimbangkan debugging dengan retensi data dan kebutuhan privasi |
| Ekspor metrik | Membuat latensi, error, perilaku cache, dan throughput dapat diamati |
Jangan menyalin flag tim lain. Salin metode pengukurannya.
Metrik untuk deployment produksi vLLM
Lacak metrik pada tiga lapisan.
| Lapisan | Metrik yang dilacak |
|---|---|
| Lapisan API | Jumlah request, tingkat respons diterima, tingkat 4xx/5xx, tingkat timeout, tingkat retry |
| Lapisan serving | Waktu ke token pertama, latensi antar-token, latensi end-to-end, waktu tunggu antrean, token per detik |
| Lapisan GPU | Utilisasi GPU, utilisasi memori, kejadian OOM, waktu pemuatan model, jumlah restart |
Lalu tambahkan metrik finansial:
biaya per output yang diterima =
  (sewa GPU + penyimpanan + bandwidth + retry + waktu operator)
  / respons yang diterima yang lolos pemeriksaan kualitas
Ini menjaga panduan deployment vLLM tetap terikat pada ekonomi produksi. Endpoint yang lebih cepat tidak lebih murah jika lebih sering gagal, membutuhkan lebih banyak intervensi manual, atau menganggur hampir sepanjang hari.
Untuk konteks biaya yang lebih luas, bandingkan endpoint yang Anda ukur dengan harga sewa GPU, GPU terbaik untuk inferensi LLM, GPU cloud vs API model, dan TCO klaster GPU.
Panduan deployment vLLM tanpa server RunPod
Panduan deployment vLLM tanpa server RunPod memiliki model operasi yang berbeda dari VM GPU yang berjalan terus-menerus. Anda mengemas handler atau container, mendefinisikan endpoint serverless, dan membiarkan platform menskalakan worker di sekitar request. Ini bisa berguna ketika trafik bersifat sporadis atau ketika Anda menginginkan permukaan eksekusi GPU terkelola tanpa harus mengelola setiap detail siklus hidup VM.
Gunakan RunPod Serverless ketika:
- Anda ingin eksekusi GPU bergaya endpoint tanpa mengelola host persisten.
- Trafik cukup bursty sehingga kapasitas GPU yang selalu aktif akan menganggur.
- Perilaku cold start dan load model dapat diterima untuk workload tersebut.
- Aplikasi Anda dapat menoleransi pola request asinkron atau spesifik endpoint dari platform.
- Anda dapat menguji konkurensi, antrean, dan timeout sebelum peluncuran.
Berhati-hatilah menggunakan serverless untuk chat yang sensitif terhadap latensi. Model besar dapat memiliki cold-start dan waktu muat yang signifikan. Ukur latensi token pertama setelah periode idle, bukan hanya saat benchmark hangat.
Untuk panduan deployment vLLM endpoint serverless RunPod, pengujian penerimaan Anda harus mencakup:
| Pemeriksaan | Mengapa ini penting |
|---|---|
| Waktu pull image container | Image berukuran besar dapat mendominasi cold start |
| Download bobot model atau mount volume | Download berulang dapat menghapus penghematan serverless |
| Jumlah worker maksimum | Mencegah lonjakan biaya tak terduga saat terjadi burst |
| Timeout antrean | Menentukan perilaku kegagalan yang terlihat oleh pengguna |
| Kebijakan warm-worker | Mengubah latensi dan biaya idle |
| Bentuk request dan response | Memastikan klien yang kompatibel dengan OpenAI dapat disesuaikan dengan mulus |
Jika kueri pencarian persis Anda adalah runpod serverless endpoints vllm deployment guide, perlakukan "endpoints" sebagai topik operasi: bangun endpoint, tetapi juga uji cold start, penskalaan worker, batas request, dan rollback.
Panduan deployment Ray Serve vLLM
Panduan deployment Ray Serve vLLM berguna ketika deployment tidak lagi hanya satu model pada satu worker. Ray Serve dapat membantu tim membangun aplikasi serving yang menggabungkan deployment, menskalakan replika, dan berjalan di cluster Ray. Ini bernilai ketika Anda membutuhkan logika serving di level Python di sekitar model, routing kustom, aplikasi multi-model, atau cluster yang sudah menstandarkan pada Ray.
Gunakan Ray Serve ketika:
- Anda sudah menjalankan Ray untuk infrastruktur ML.
- Anda membutuhkan beberapa deployment dalam satu graph serving.
- Anda ingin routing di level aplikasi di sekitar satu atau lebih engine vLLM.
- Anda membutuhkan jalur dari pengujian lokal ke cluster Ray.
- Tim platform Anda dapat mengoperasikan Ray, bukan hanya vLLM.
Trade-off-nya adalah permukaan operasional. Ray memberi kekuatan orkestrasi, tetapi juga menambah operasi cluster Ray, perilaku autoscaling, pertimbangan object store, log, dashboard, dan jalur upgrade lain. Untuk satu model di balik satu endpoint, deployment vLLM langsung mungkin lebih sederhana.
Pola deployment Kubernetes
Kubernetes adalah pilihan yang baik ketika organisasi Anda sudah mengoperasikan node GPU, ingress, secrets, metrik, dan kebijakan rollout di Kubernetes. Ini tidak otomatis menjadi deployment pertama yang tepat untuk tim kecil.
Daftar periksa Kubernetes:
| Area | Daftar periksa |
|---|---|
| Penjadwalan GPU | Label node, taint, request resource, device plugin, dan isolasi GPU |
| Penyimpanan model | Persistent volume, sinkronisasi object-store, atau strategi image yang dibangun di awal |
| Startup | Warmup cache model dan readiness probe yang realistis |
| Kesehatan | Liveness probe yang tidak mematikan pemuatan model yang lambat tetapi sehat |
| Rollout | Deployment canary atau blue-green dengan rollback cepat |
| Autoscaling | Skala berdasarkan antrean, latensi, atau metrik GPU, bukan CPU saja |
| Networking | Secara default hanya internal; ingress publik hanya melalui kontrol auth |
| Observabilitas | Latensi per rute, tingkat error, memori GPU, dan atribusi biaya |
Jika platform Anda belum memiliki kematangan Kubernetes GPU, mulailah dengan satu host GPU atau endpoint terkelola terlebih dahulu. Kubernetes seharusnya mengurangi risiko operasional, bukan mengubah endpoint sederhana menjadi proyek cluster.
Rencana load test untuk deployment vLLM
Jangan load test dengan satu prompt. Buat set request yang representatif.
Gunakan setidaknya tiga trace:
- Chat singkat: prompt singkat, output singkat, konkurensi tinggi.
- RAG konteks panjang: prompt panjang, output sedang, template sistem dan retrieval berulang.
- Agent atau loop tool: skema berulang, output terstruktur, pembatalan, retry, dan konteks multi-turn.
Catat:
| Metrik | Target |
|---|---|
| Request yang diterima per menit | Mengukur throughput yang berguna |
| Waktu ke token pertama p50/p95/p99 | Menunjukkan latensi interaktif |
| Latensi end-to-end p50/p95/p99 | Menunjukkan waktu tugas yang terlihat oleh pengguna |
| Tingkat error dan timeout | Menunjukkan keandalan di bawah beban |
| Latensi yang disesuaikan retry | Menunjukkan pengalaman nyata setelah kegagalan |
| High-water mark memori GPU | Menunjukkan ruang headroom |
| Biaya per output yang diterima | Menunjukkan ekonominya |
Jalankan dua benchmark:
- Run default: tuning minimal, sehingga Anda tahu waktu menuju produksi.
- Run yang dituning: batching, cache, quantization, dan batas request yang dituning, sehingga Anda tahu batas maksimumnya.
Jika run yang dituning lebih cepat tetapi rapuh, jangan deploy sebagai default. Deploy konfigurasi yang dapat dijelaskan oleh tim on-call Anda.
Kapan tidak perlu deploy vLLM sendiri
Self-hosting bernilai ketika Anda membutuhkan kontrol hardware, bobot kustom, locality data yang ketat, atau utilisasi tinggi yang berkelanjutan pada workload yang stabil. Opsi ini kurang menarik ketika trafik tidak pasti, pilihan model sering berubah, model proprietary frontier diperlukan, atau tim tidak memiliki kapasitas operasi inferensi.
Pilih managed model API atau router terlebih dahulu ketika:
- Anda masih menguji kualitas model.
- Anda membutuhkan pergantian model yang sering.
- Trafik bersifat spiky atau sulit diprediksi.
- Fallback lintas provider lebih penting daripada kontrol GPU.
- Anda membutuhkan ledger penggunaan, anggaran, invoice, dan governance tim sebelum tuning GPU.
Flatkey cocok untuk lapisan ini ketika beban kerja di sisi API membutuhkan satu kunci, satu saldo, satu faktur, catatan penggunaan, dan akses ke rute model resmi. Jika suatu beban kerja kemudian terbukti cukup stabil untuk serving GPU khusus, terus bandingkan endpoint vLLM yang di-host sendiri dengan perbandingan harga model AI, perbandingan harga API AI, dan biaya GPU terukur Anda per output yang diterima.
Template runbook deployment
Salin ini sebelum peluncuran.
Service:
  Owner:
  On-call:
  Model alias:
  Served model revision:
  vLLM version:
  Container image:
  GPU type and count:
  Base URL:

Request policy:
  Max model length:
  Max output tokens:
  Max concurrency:
  Queue timeout:
  Request timeout:
  Auth method:

Observability:
  Metrics dashboard:
  Log location:
  Trace/request ID field:
  Alert thresholds:

Rollout:
  Canary percentage:
  Rollback image:
  Rollback model revision:
  Fallback route:

Cost:
  GPU cost source:
  Storage/bandwidth assumptions:
  Accepted-output denominator:
  Weekly cost review owner:
Template ini lebih penting daripada perintah pertama yang sempurna. Sebuah panduan deployment vLLM yang tidak bisa diserahkan ke tim on-call masih merupakan prototipe.
Pertanyaan yang sering diajukan
Apakah ini termasuk konten panduan deployment vLLM jika saya menggunakan managed GPU endpoint?
Ya. Jika vLLM adalah mesin serving dan Anda memutuskan cara mengekspos, menskalakan, memantau, dan mengamankannya, itu tetap termasuk dalam panduan deployment vLLM. Detail operasional berbeda antara VM mentah, RunPod Serverless, Ray Serve, dan Kubernetes, tetapi uji penerimaannya serupa: kontrak endpoint, latensi, error, concurrency, rollback, dan biaya output yang diterima.
Haruskah saya menggunakan RunPod Serverless atau VM GPU persisten untuk vLLM?
Gunakan RunPod Serverless ketika penanganan lonjakan dan operasi endpoint terkelola lebih penting daripada latensi selalu hangat. Gunakan VM GPU persisten ketika Anda membutuhkan performa hangat yang dapat diprediksi, kontrol langsung atas host, atau jalur debugging yang lebih sederhana. Benchmark keduanya jika latensi dan utilisasi menjadi penentu keputusan.
Kapan Ray Serve masuk akal dengan vLLM?
Ray Serve masuk akal ketika vLLM adalah bagian dari aplikasi serving yang lebih besar, terutama jika Anda sudah mengoperasikan Ray. Untuk satu model di balik satu endpoint, serving vLLM secara langsung mungkin lebih mudah dijalankan.
Apakah vLLM dapat menggantikan OpenAI API?
vLLM dapat mengekspos antarmuka yang kompatibel dengan OpenAI untuk model self-hosted yang didukung, tetapi itu tidak membuat model open-weight identik dengan API proprietary frontier. Perlakukan ini sebagai kontrak endpoint dan opsi serving, lalu validasi kualitas model, latensi, dan biaya operasional terhadap beban kerja Anda.
Apa yang harus saya ukur terlebih dahulu?
Ukur tingkat respons yang diterima, waktu ke token pertama, latensi p95 dan p99, tingkat timeout, tekanan memori GPU, dan biaya per output yang diterima. Token mentah per detik memang berguna, tetapi tidak cukup untuk keputusan produksi.
Di mana posisi Flatkey dengan vLLM?
Gunakan vLLM ketika Anda perlu memiliki sendiri lapisan serving GPU. Gunakan Flatkey ketika Anda menginginkan satu lapisan API model yang kompatibel dengan OpenAI, penagihan terpadu, catatan penggunaan, dan tata kelola di seluruh rute serta alat model resmi. Banyak tim akan menggunakan keduanya: vLLM untuk beban kerja self-hosted yang stabil dan Flatkey untuk model frontier, fallback, eksperimen, dan tata kelola di sisi API.
Checklist akhir
Sebelum peluncuran, panduan deployment vLLM Anda harus menghasilkan artefak berikut:
- Revision model dan versi container yang dipin.
- Base URL OpenAI-compatible yang sudah diuji.
- Batasan auth dan jaringan.
- Batas request untuk konteks, output, timeout, dan concurrency.
- Metrik untuk latensi, error, antrean, throughput, dan memori GPU.
- Jalur rollback dan image sebelumnya yang diketahui baik.
- Lembar kerja biaya per output yang diterima.
- Catatan keputusan yang menjelaskan mengapa vLLM self-hosted mengungguli API model terkelola untuk beban kerja ini.
Jika artefak-artefak itu ada, Anda tidak hanya menjalankan vLLM. Anda sedang mengoperasikan API LLM di GPU.


