
Reliability and Routing
Artigos mais recentes em Reliability and Routing.

LLM Router Canary Release: Mova o tráfego dos modelos com segurança sem uma troca big-bang
Use um lançamento canário de LLM router para mover o tráfego dos modelos em etapas, com métricas, condições de توقف, gatilhos de rollback e verificações Flatkey.
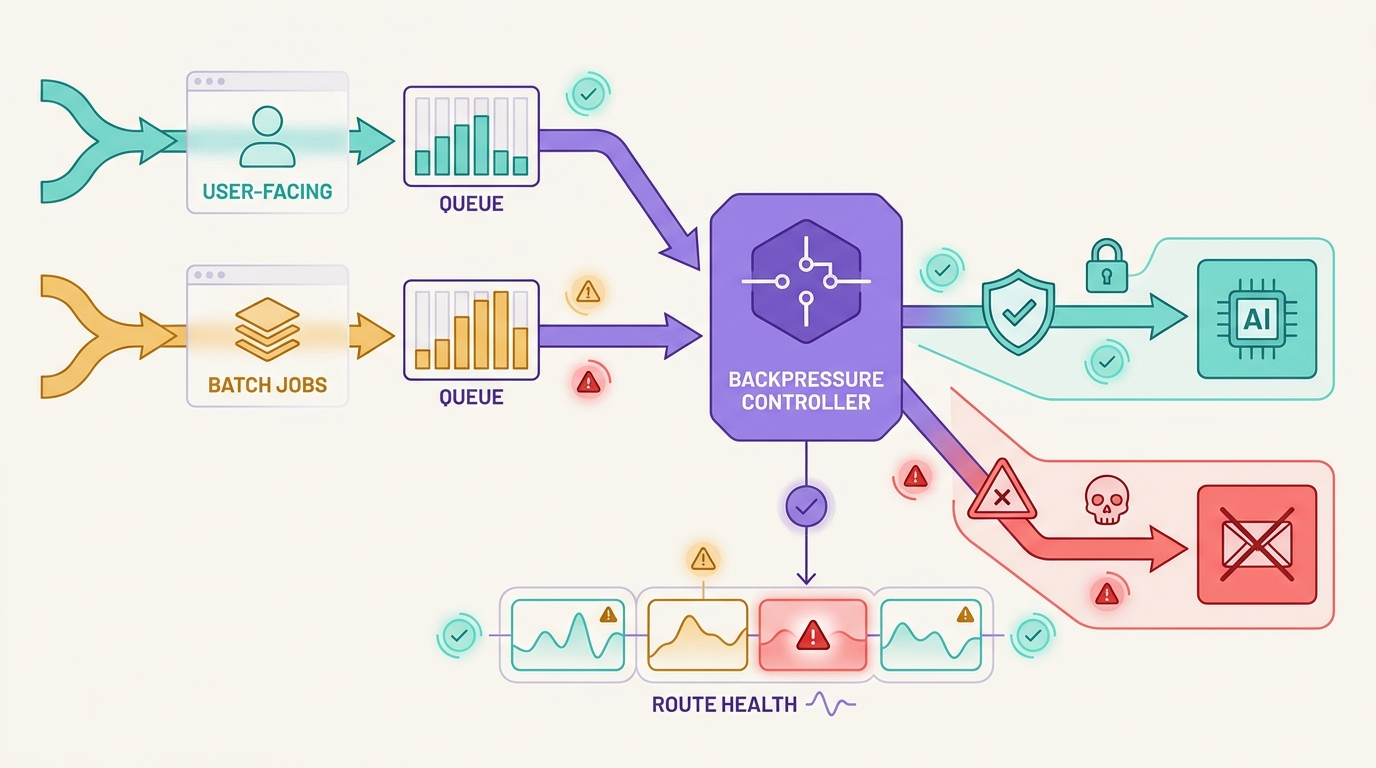
Estratégia de Queueing para API de IA: Proteja Workflows Voltados para o Usuário Durante Interrupções do Provedor
Um manual de confiabilidade de produção para proteger workflows de IA voltados para o usuário com filas de processamento, contrapressão, contratos de fallback, regras de dead-letter e evidência de rota.
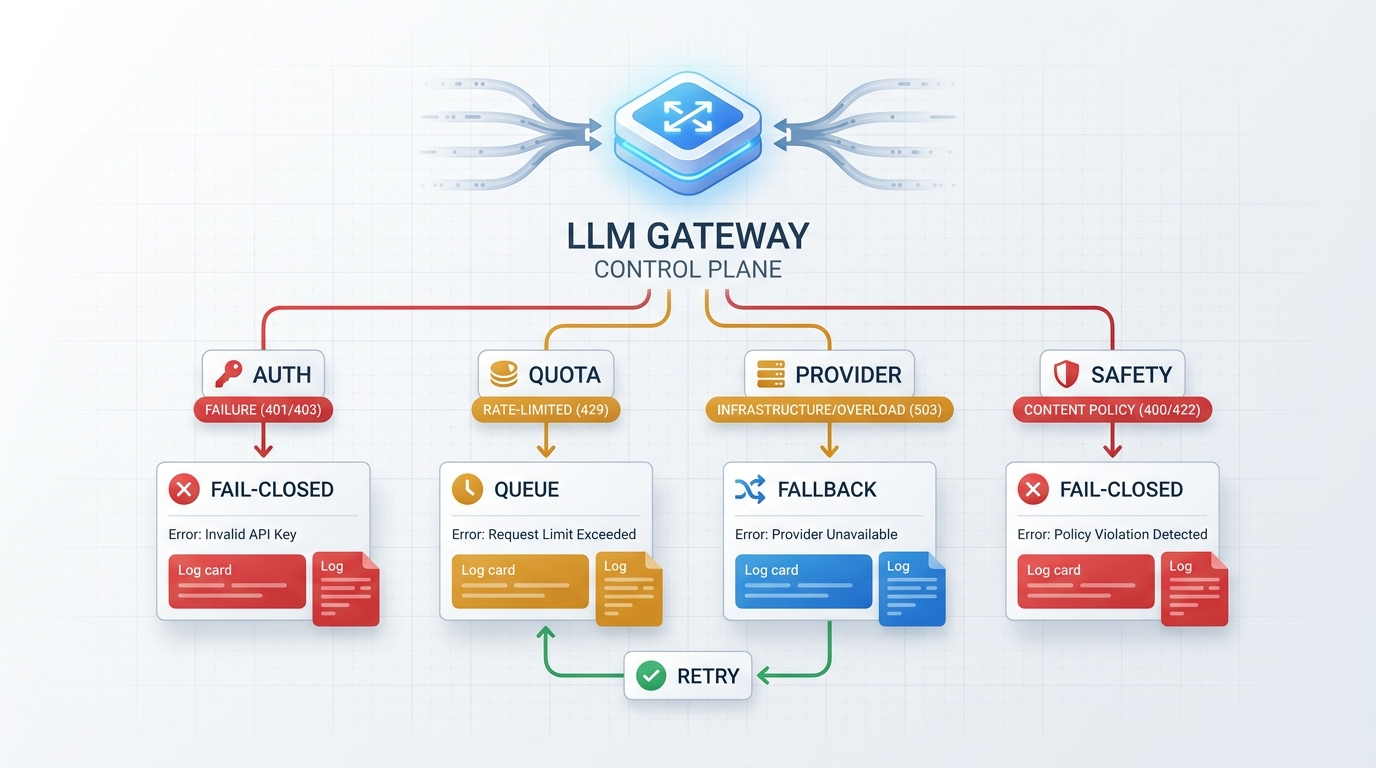
Taxonomia de Erros de Gateway de LLM: Separe Falhas de Autenticação, Cota, Provedor e Segurança
Um manual de confiabilidade de produção para classificar falhas de gateway de LLM em caminhos de autenticação, cota, provedor, requisição, segurança e cancelamento antes de tentar novamente ou usar um fallback.
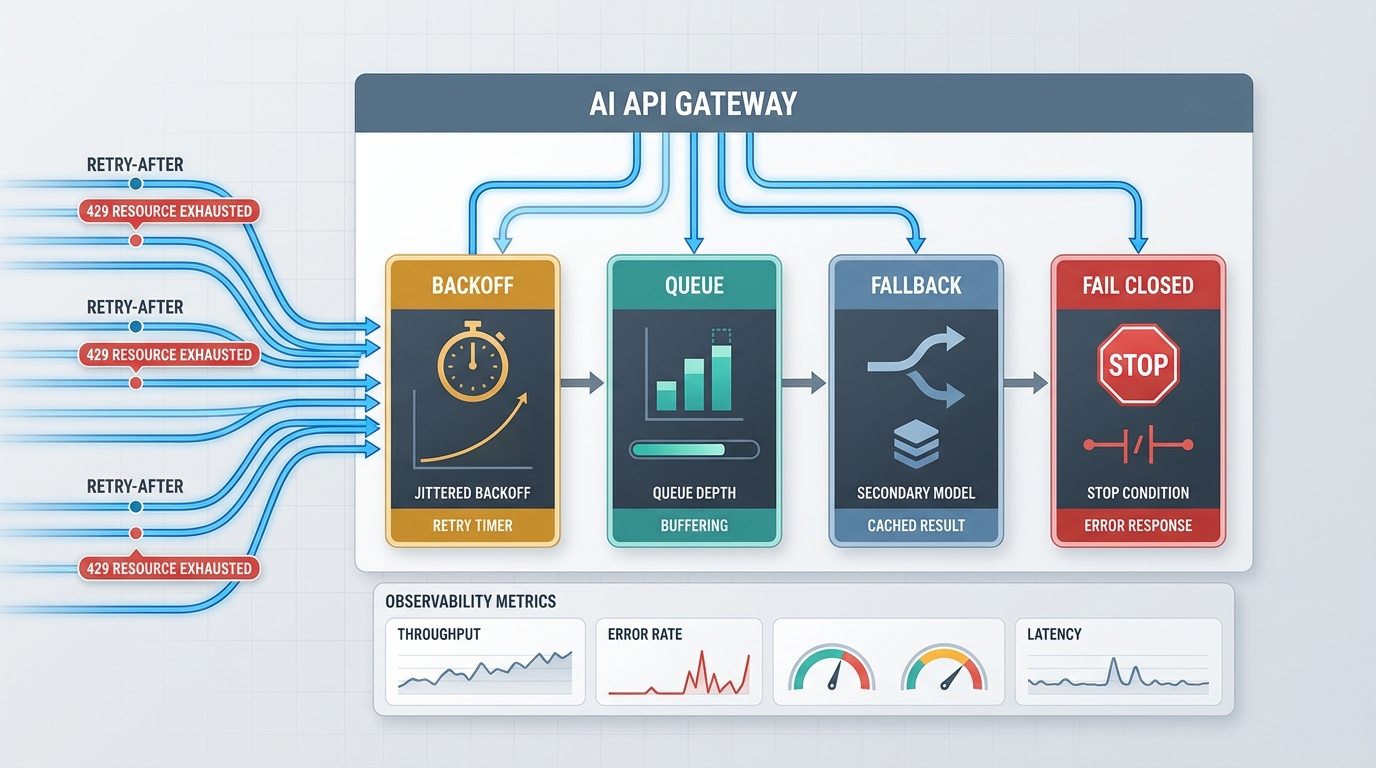
Gerenciamento de Limites de Taxa da API de IA: Backoff, Fila, Fallback ou Fail-Closed
Um checklist de produção para gerenciar limites de taxa da API de IA com Retry-After, backoff com jitter, enfileiramento, contratos de fallback, paradas fail-closed e observabilidade.
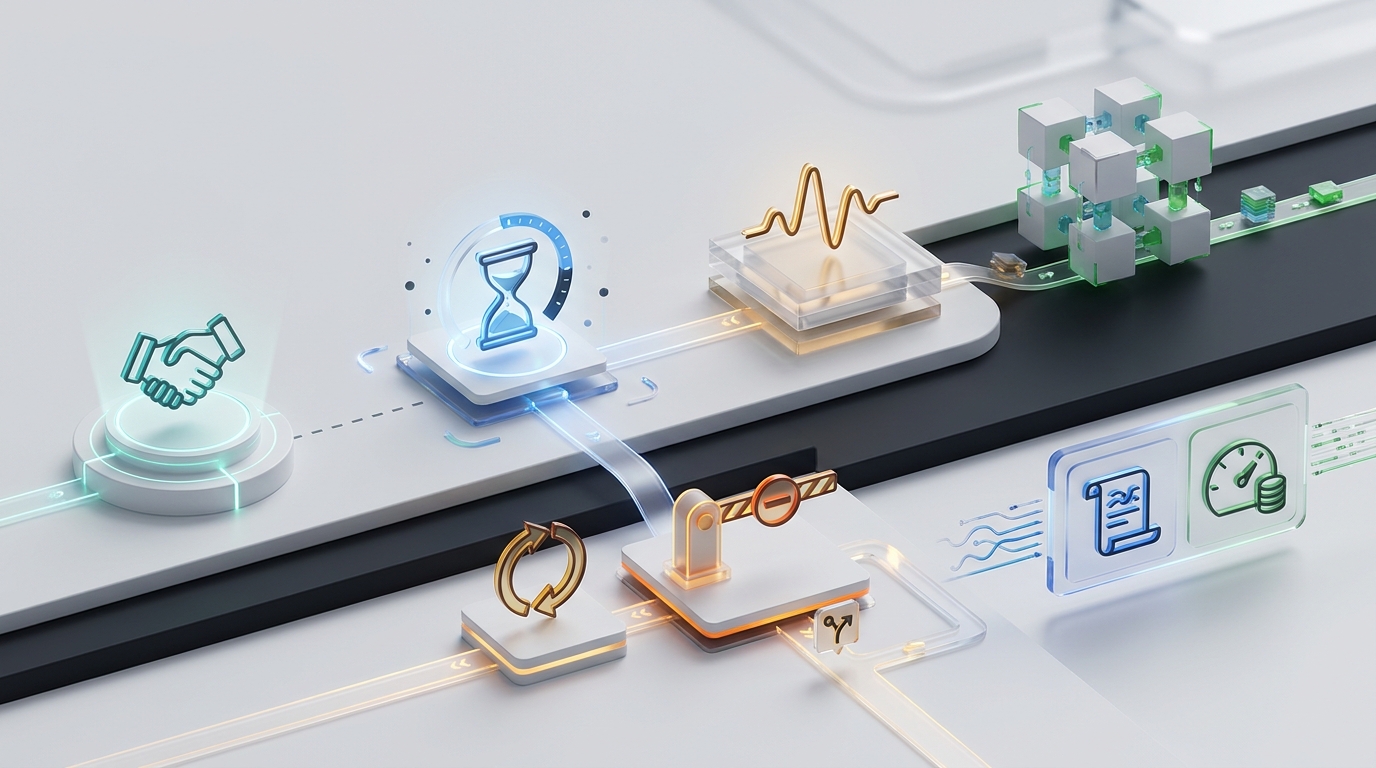
Estratégia de Timeout para API de IA: Orçamentos de Conexão, Leitura, Stream e Fila
Defina orçamentos de timeout para API de IA em produção para conexão, leitura, stream, fila, repetição, fallback e observabilidade antes que os incidentes se tornem caros.
Disjuntores para Gateways de API de LLM: Proteja Apps de Loops de Falha do Provedor
Use um disjuntor no gateway de API de LLM para interromper loops de falha do provedor, classificar erros, proteger tentativas de retry e direcionar para fallback, fila ou fail closed.
Checklist de Fallback de Modelo: Qualidade, Custo, Ferramentas e Limites de Conformidade
Use este checklist de fallback de modelo para avaliar qualidade, custo, ferramentas, streaming, conformidade, logs e rollback antes do fallback automático no AI gateway.
Confiabilidade de Streaming da API de IA: SSE, Timeouts e Modos de Falha no Nível do Router
Use testes de confiabilidade de streaming da API de IA para detectar travamentos de SSE, timeouts de proxy, saídas parciais, riscos de retry e falhas de failover no router antes da produção.
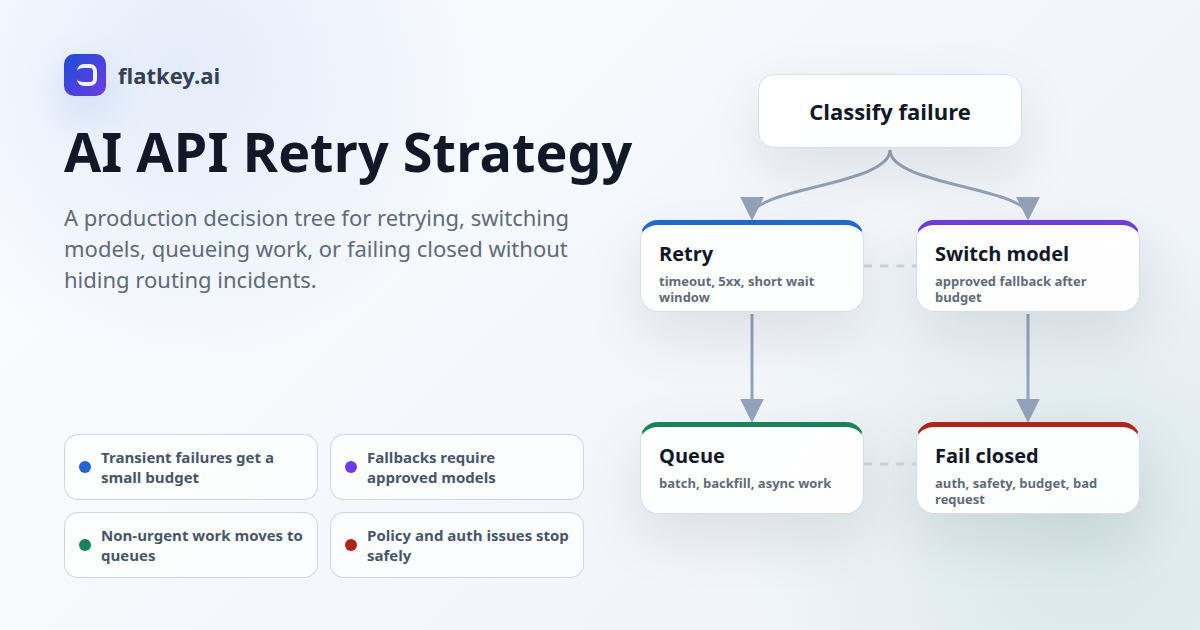
Estratégia de Retentativa em API de IA: Quando Tentar Novamente, Trocar Modelos, Enfileirar ou Falhar Fechado
Use uma estratégia de retentativa em API de IA para decidir quando tentar novamente, trocar modelos, enfileirar tarefas ou falhar fechado, sem mascarar incidentes de cota, autenticação ou roteamento.
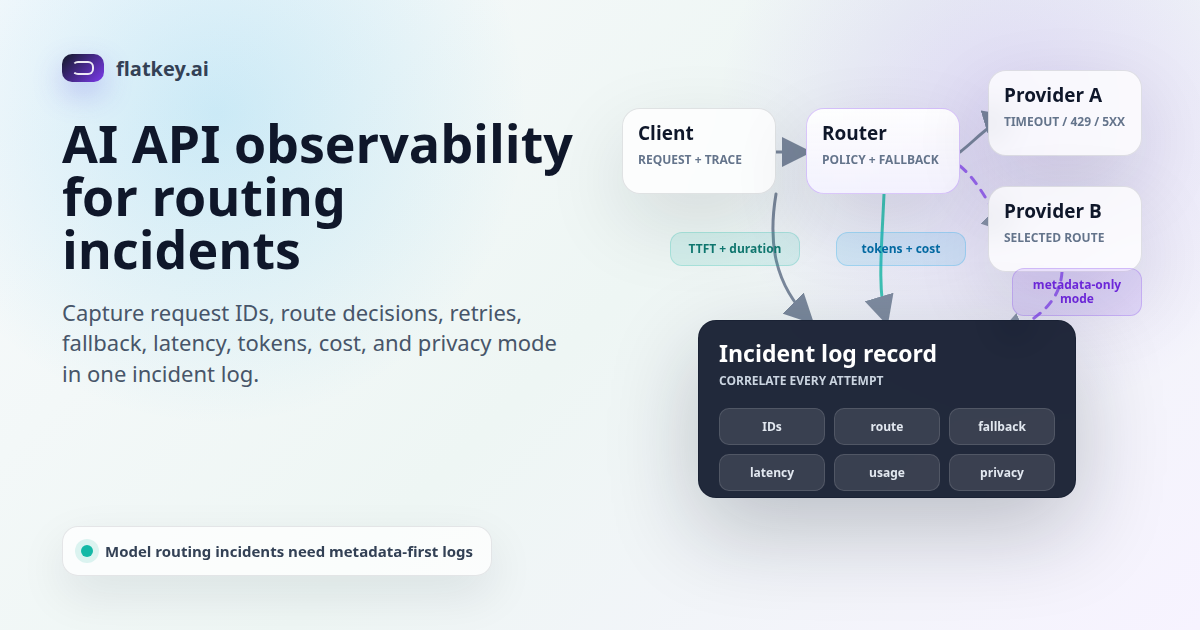
Logs de observabilidade de API de IA: o que capturar em incidentes de roteamento de modelos
Use logs de observabilidade de API de IA para depurar incidentes de roteamento de modelos com IDs de requisição, rotas, tentativas, fallback, tokens, latência, custo e metadados compatíveis com privacidade.
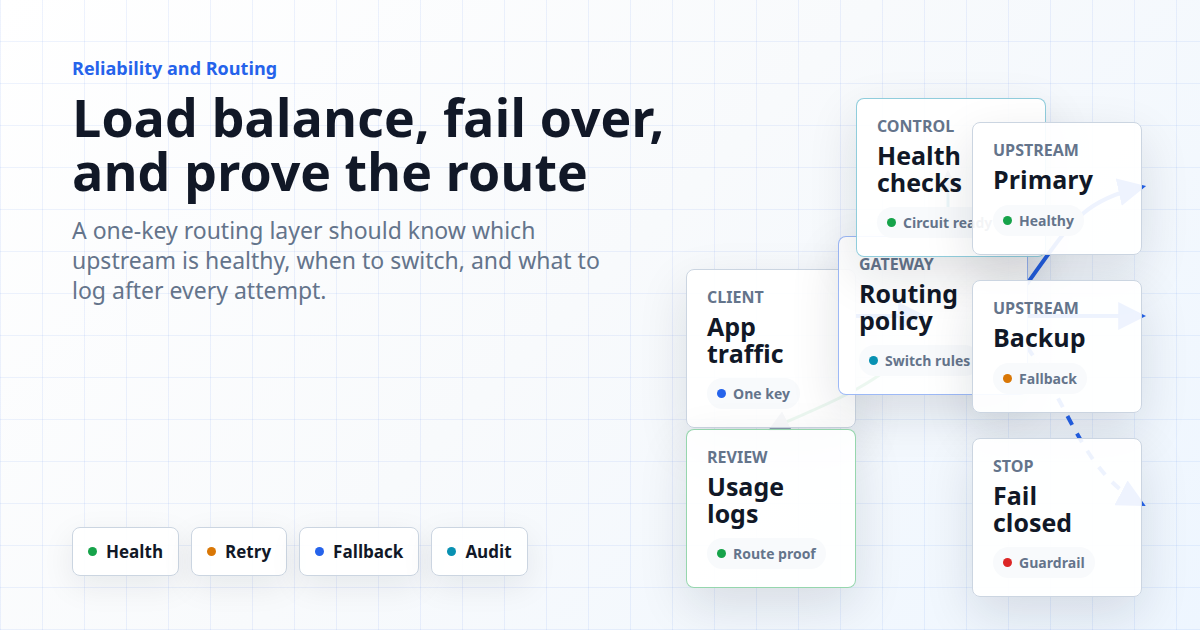
Balanceamento de carga e failover de API de IA por trás de uma única chave
Planeje o balanceamento de carga e o failover de API de IA com regras de roteamento, verificações de integridade, caminhos de retry, logs de uso, cotas, testes de rollback e gateways de uma única chave.
Crie mais rápido com um único gateway de IA.
Use a flatkey.ai para gerenciar modelos, chaves, cobrança e observabilidade em uma plataforma de API.
Começar