Limites de Taxa de LLM Explicados: RPM, TPM e Tentativas é um tópico de confiabilidade operacional antes de ser uma configuração de SDK. Os limites de taxa decidem quantas solicitações, tokens, jobs ou gerações concorrentes sua aplicação pode enviar por meio de um provedor ou gateway em uma janela de tempo. As tentativas decidem o que acontece quando um limite é atingido. A política de tentativas errada pode transformar uma pequena rajada em uma interrupção prolongada.
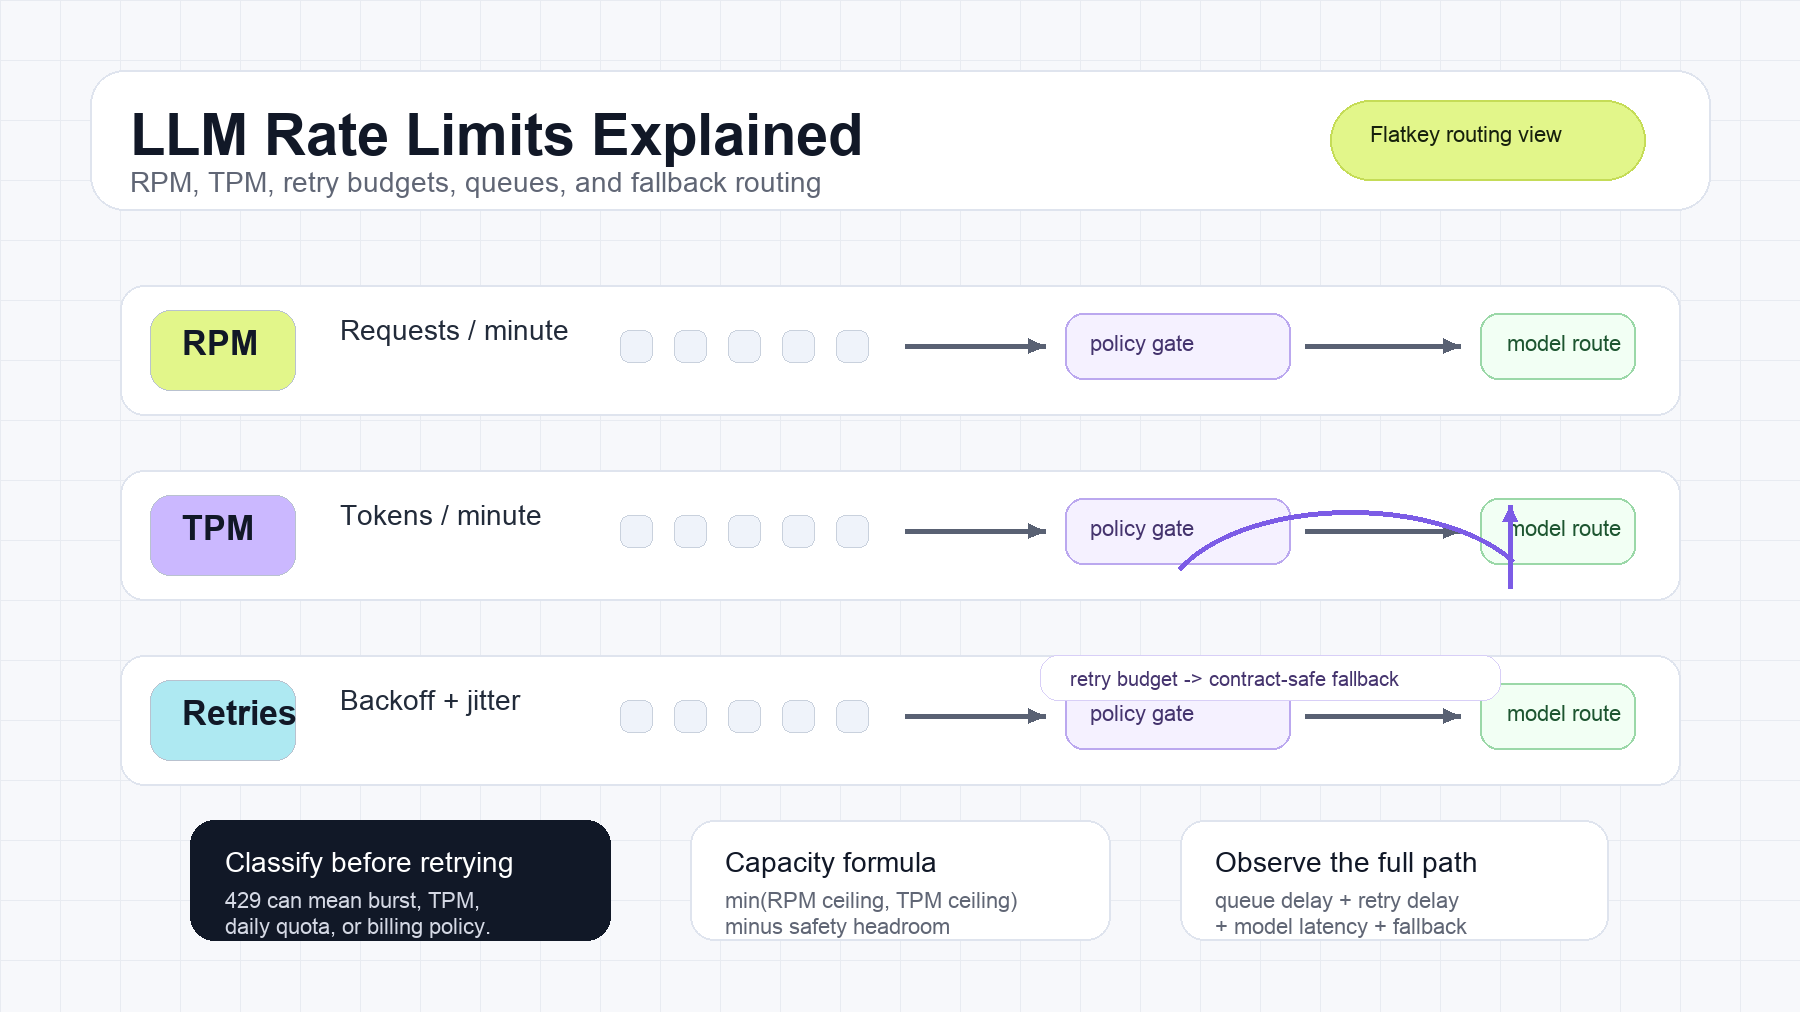
A regra prática é simples: RPM controla a frequência das solicitações, TPM controla a vazão de tokens, a concorrência controla o trabalho em andamento e as tentativas consomem a mesma capacidade escassa, a menos que sejam limitadas. Um sistema em produção deve primeiro classificar o recurso limitado e, em seguida, escolher entre escalonar o ritmo, enfileirar, reduzir tokens, tentar novamente por um curto período ou rotear para outro modelo compatível com o contrato.
Este guia trata Limites de Taxa de LLM Explicados: RPM, TPM e Tentativas como um manual operacional para equipes de produto e plataforma de IA. Ele cobre os termos, a matemática de capacidade, a política de tentativas, os campos de observabilidade e os controles de gateway no estilo Flatkey que evitam que os limites de taxa da API de LLM se tornem um incidente para o cliente.
Resposta rápida sobre Limites de Taxa de LLM Explicados: RPM, TPM e Tentativas
Use esta tabela quando estiver triando um incidente de limite de taxa de LLM.
| Sinal | O que mede | Sintoma típico | Primeiro controle |
|---|---|---|---|
| RPM | Solicitações admitidas por minuto ou janela definida pelo provedor | Muitas chamadas pequenas falham com 429 |
Escalonar solicitações, enfileirar rajadas, agrupar tarefas pequenas |
| TPM | Tokens de entrada e/ou saída admitidos por minuto ou janela | Prompts longos, saídas longas ou execuções de avaliação são limitados | Reservar tokens, encurtar contexto, limitar saída |
| RPD / TPD | Solicitações ou tokens admitidos por dia | O trabalho para até a cota ser redefinida | Parar tentativas, reagendar, solicitar um nível superior |
| Concorrência | Solicitações ou jobs em andamento ao mesmo tempo | Gerações lentas se acumulam mesmo com RPM moderado | Limitar workers, adicionar backpressure |
| Orçamento de tentativas | Quanto trabalho extra um chamador pode gastar após uma falha | Tempestade de tentativas, latência inflada, efeitos colaterais duplicados | Limitar tentativas, tempo decorrido e status passíveis de nova tentativa |
| Rota de fallback | Modelo ou provedor alternativo elegível | A rota primária está limitada, mas o produto ainda precisa de saída | Roteie apenas quando capacidade, política e custo forem compatíveis |
Limites de Taxa de LLM Explicados: RPM, TPM e Tentativas se resume a uma decisão operacional: não tente novamente às cegas. Um 429 não é um comando para enviar a mesma solicitação imediatamente de novo. É um sinal de que um bucket de capacidade, política de cota, estado de cobrança ou mecanismo de proteção do provedor rejeitou a solicitação.
Por que os limites de taxa existem
Os provedores लागूem limites de taxa da API de LLM para proteger a capacidade compartilhada, evitar contas descontroladas e manter a política de cobrança ou de nível de serviço consistente. OpenAI, Anthropic e Gemini documentam conceitos de limite de taxa, mas expõem nomes de buckets, escopos, cabeçalhos e painéis diferentes. A OpenAI documenta limites de taxa e orienta os clientes a tratar erros de limite com backoff. A Anthropic documenta limites de gasto de organização e workspace, além de limites de taxa no nível do modelo que podem incluir solicitações e tokens. O Gemini documenta camadas com conceitos de limites de solicitações, tokens e diários.
Esses controles do provedor são necessários, mas não constituem uma política completa de produto. Eles normalmente respondem à pergunta do lado do provedor: “Este projeto pode enviar mais tráfego agora?” Sua aplicação ainda precisa responder a perguntas do lado do produto:
- Qual cliente, workspace, equipe ou recurso causou a rajada?
- O recurso limitado era solicitações, tokens de entrada, tokens de saída, concorrência, cota diária ou gasto?
- Essa carga de trabalho deve esperar, degradar, reduzir a velocidade ou falhar rapidamente?
- Uma rota de fallback é permitida por capacidade, política de dados, preço e contrato do cliente?
- As tentativas estão piorando o limite?
Para controles de cota adjacentes, combine este artigo com gerenciamento de cota da API de IA e gerenciamento de gastos da API de IA.
RPM, TPM e concorrência são limites diferentes
As equipes frequentemente tratam os limites de taxa como um único número. Isso esconde o verdadeiro gargalo.
RPM: Solicitações por minuto
RPM limita o número de solicitações admitidas durante uma janela de tempo definida pelo provedor. Prompts pequenos, verificações de saúde, loops de ferramentas de agentes e jobs de avaliação de alto fan-out normalmente pressionam o RPM primeiro. Uma carga de trabalho pode ficar bem abaixo do TPM e ainda assim atingir o RPM se enviar muitas chamadas pequenas.
TPM: Tokens por minuto
TPM limita a vazão de tokens. Dependendo do provedor e do modelo, o limite pode considerar tokens de entrada, tokens de saída, tokens em cache ou buckets separados de entrada e saída. Recuperação com contexto longo, histórico de conversa, saídas verbosas, geração de múltiplos candidatos e evals paralelos normalmente pressionam o TPM antes do RPM.
Concorrência: trabalho em andamento
Concorrência não é RPM. Um sistema pode enviar apenas 60 solicitações por minuto e ainda assim ter alta concorrência se cada geração levar 20 segundos. Streaming e chamadas de ferramentas de longa duração tornam isso visível. Limitar pools de workers e a profundidade da fila geralmente é um controle melhor do que mais tentativas.
Limites diários e limites de gasto
Alguns limites não se recuperam após uma breve espera. Limites diários de requisições, limites diários de tokens, limites mensais de gasto e restrições de faturamento normalmente devem interromper as tentativas. A ação correta é reagendar, elevar o nível, ajustar o orçamento ou informar ao usuário que a capacidade foi esgotada.
Por que Você Pode Receber 429 Abaixo do Limite Divulgado
Um limite publicado como “1.000 RPM” raramente significa que um cliente pode enviar 1.000 requisições no primeiro segundo de um minuto. Os provedores podem aplicar janelas móveis, baldes de tokens, pools de modelos, regras de pico específicas por nível, limites de aceleração ou cotas compartilhadas de projeto.
Uma requisição pode receber 429 Too Many Requests mesmo quando um contador local parece seguro porque:
- Vários workers, usuários, serviços ou ambientes compartilham o mesmo limite da conta.
- Tokens de entrada e de saída são contados em buckets diferentes.
- Um modelo tem um pool mais restrito do que outro modelo.
- As tentativas de falhas anteriores ainda estão consumindo capacidade de requisições.
- A cadência do tráfego é muito abrupta para os controles de aceleração.
- Uma regra diária, de gasto, de workspace ou de nível de serviço está ativa.
- O provedor retorna um
429genérico para várias políticas de capacidade.
É por isso que Limites de Taxa de LLM Explicados: RPM, TPM e Tentativas deve começar com classificação, não com código. Registre o código de status, o tipo de erro do provedor, os cabeçalhos da resposta, o modelo, a conta ou projeto, a estimativa de tokens, os tokens reais, o número da tentativa, o atraso na fila e o ID da requisição do provedor, quando disponível.
Fórmula de Planejamento de Capacidade
Comece com tetos independentes para requisições e tokens e então opere abaixo do máximo.
request_ceiling = RPM * safety_factor

token_ceiling = (TPM * safety_factor) / average_total_tokens_per_request

safe_requests_per_minute = min(request_ceiling, token_ceiling)
Use um fator de segurança como 0.70 a 0.90, dependendo da variância de tokens, dos consumidores compartilhados, do comportamento de retry e de quão caros são os objetivos de latência perdidos.
Exemplo:
RPM = 1,000
TPM = 2,000,000
average_total_tokens_per_request = 4,000
safety_factor = 0.80

request_ceiling = 1,000 * 0.80 = 800 requests/minute

token_ceiling = (2,000,000 * 0.80) / 4,000 = 400 requests/minute

safe_requests_per_minute = min(800, 400) = 400 requests/minute
Neste exemplo, TPM é a restrição limitante. Adicionar mais workers não aumentará a vazão sustentável. Isso criará mais enfileiramento, mais tentativas ou mais erros 429.
Para sistemas online, traduza a taxa segura de requisições em um ponto de partida de concorrência:
target_concurrency ~= requests_per_second * average_request_seconds
Se a taxa segura for 400 requisições por minuto, isso equivale a cerca de 6,67 requisições por segundo. Se a latência média do modelo for 3 segundos, uma concorrência inicial é de cerca de 20. Ajuste com base no p95 e no p99 da latência, não apenas nas médias.
Reserva de Tokens Para Segurança de TPM
Incidentes de TPM muitas vezes vêm de agendamento otimista. A aplicação aceita o trabalho com base em tokens esperados, mas o modelo produz uma saída mais longa do que o planejado.
Um agendador mais seguro reserva tokens antes de enviar a requisição:
reservation:
  workload: support_answer
  model_route: primary_chat_route
  request_id: req_8f3a
  estimated_input_tokens: 3200
  max_output_tokens: 900
  reserved_total_tokens: 4100
  reservation_expires_at: 2026-10-10T11:03:00Z
Após a resposta, concilie os tokens reservados com os tokens reais:
actual_usage:
  input_tokens: 3014
  output_tokens: 622
  total_tokens: 3636
  retry_attempts: 0
  accepted_result: true
Faça a reserva com base no p95 ou em estimativas específicas da carga de trabalho para produção. Use o uso real para atribuição de custos e previsão. Essa separação torna os limites de taxa da API de LLM mais fáceis de operar: o controle de admissão usa uma estimativa segura, enquanto finanças e produto analisam o custo real por resultado aceito.
Uma Árvore de Decisão de Limite de Taxa
Quando uma requisição é rejeitada ou uma fila cresce, decida o controle com base na causa.
O provedor retornou Retry-After ou um cabeçalho de reset?
  sim -> aguarde a dica se ela couber no orçamento de latência do chamador
  não  -> use backoff exponencial limitado com jitter para classes transitórias

A causa é cota diária, faturamento, permissão ou limite rígido de gasto?
  sim -> não tente novamente; falhe, reagende ou solicite capacidade
  não  -> continue

RPM é a restrição limitante?
  sim -> faça o ritmo das requisições, agrupe trabalhos pequenos ou coloque em fila o tráfego de baixa prioridade
  não  -> continue

TPM é a restrição limitante?
  sim -> encurte o contexto, limite a saída, reserve tokens ou atrase trabalhos longos
  não  -> continue

A concorrência é a restrição limitante?
  sim -> reduza workers, defina prazos de fila e aplique backpressure
  não  -> continue

Uma rota de fallback elegível está saudável e aprovada pela política?
  sim -> roteie após o orçamento de retries ser gasto
  no -> retorne uma falha controlada
Esta árvore de decisão é o ativo de valor para Limites de Taxa de LLM Explicados: RPM, TPM e Tentativas. Ela impede que o tratamento de 429 se torne um loop sem limites e transforma Limites de Taxa de LLM Explicados: RPM, TPM e Tentativas de um tema de definições em um fluxo de trabalho de resposta a incidentes.
Como Usar Retry-After
HTTP Retry-After informa ao cliente quanto tempo esperar antes de fazer outra solicitação. O RFC o define como um atraso em segundos ou uma data HTTP. A referência 429 Too Many Requests da MDN também descreve o uso de Retry-After para indicar quando o cliente pode tentar novamente.
Regras práticas:
- Respeite um
Retry-Afterválido quando ele se encaixar no orçamento de latência do chamador. - Limite valores muito longos para chamadas interativas; não deixe uma solicitação de usuário aberta para sempre.
- Trate valores inválidos ou ausentes como um motivo para usar backoff no lado do cliente.
- Não tente novamente causas não passíveis de retry só porque
Retry-Afterestá ausente. - Registre a orientação do provedor e o atraso real usado.
Para fluxos interativos de usuário, o orçamento de retry costuma ser menor do que a orientação do provedor. Nesse caso, falhe rapidamente com mensagens úteis ou direcione para outro lugar. Para trabalho em lote, enfileirar pode ser melhor do que retornar um erro.
Backoff Exponencial Com Jitter
O backoff exponencial aumenta o atraso após cada tentativa com falha. O jitter randomiza esse atraso para que os workers não se sincronizem e tentem novamente ao mesmo tempo. A orientação da AWS sobre backoff e jitter é útil porque explica por que o backoff exponencial simples com limite ainda pode agrupar retries sem aleatoriedade.
Uma fórmula comum de full-jitter:
delay_ms = random(0, min(cap_ms, base_ms * 2^attempt))
Uma política de retry em produção precisa de mais do que a fórmula de atraso:
| Campo da Política | Controle Recomendado |
|---|---|
| Status passíveis de retry | 429, alguns 5xx selecionados e falhas transitórias de rede |
| Status não passíveis de retry | erros de validação, erros de autenticação, erros de permissão, erros de cobrança, esgotamento da cota diária |
| Máximo de tentativas | Pequeno número para chamadas interativas; maior apenas para jobs offline |
| Tempo máximo decorrido | Limitado pelo orçamento de latência visível ao usuário ou pelo prazo do job |
| Jitter | Obrigatório para sistemas com múltiplos workers |
| Retry-After | Usar quando válido e viável |
| Cancelamento | Parar imediatamente quando o chamador abortar |
| Observabilidade | Contagem de tentativas, tempo de espera, status final, ID da solicitação, atraso na fila |
Solicitações sem sucesso ainda podem consumir capacidade do rate limit. É por isso que retries devem fazer parte do planejamento de rate limit, e não ser uma reflexão tardia.
Helper de Retry em TypeScript Para APIs Compatíveis com OpenAI
Este helper usa Retry-After quando presente; caso contrário, usa full jitter. Ele para quando as tentativas ou o tempo decorrido se esgotam.
type ChatRequest = {
  model: string;
  messages: Array<{ role: "system" | "user" | "assistant"; content: string }>;
  max_tokens?: number;
};

const sleep = (milliseconds: number) =>
  new Promise((resolve) => setTimeout(resolve, milliseconds));

function retryAfterMilliseconds(response: Response): number | null {
  const value = response.headers.get("retry-after");
  if (!value) return null;

  const seconds = Number(value);
  if (Number.isFinite(seconds)) return Math.max(0, seconds * 1_000);

  const date = Date.parse(value);
  return Number.isNaN(date) ? null : Math.max(0, date - Date.now());
}

export async function createChatCompletion(
  apiKey: string,
  request: ChatRequest,
  options: { maxAttempts?: number; maxElapsedMs?: number } = {},
) {
  const maxAttempts = options.maxAttempts ?? 4;
  const maxElapsedMs = options.maxElapsedMs ?? 30_000;
  const startedAt = Date.now();

  for (let attempt = 0; attempt < maxAttempts; attempt += 1) {
    const response = await fetch("https://router.flatkey.ai/v1/chat/completions", {
      method: "POST",
      headers: {
        Authorization: `Bearer ${apiKey}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify(request),
    });

    if (response.ok) return response.json();

    const retryable = response.status === 429 || response.status >= 500;
    const finalAttempt = attempt === maxAttempts - 1;
    if (!retryable || finalAttempt) {
      throw new Error(`A solicitação LLM falhou com ${response.status}: ${await response.text()}`);
    }

    const serverDelay = retryAfterMilliseconds(response);
    const exponentialCap = Math.min(8_000, 500 * 2 ** attempt);
    const jitteredDelay = Math.random() * exponentialCap;
    const delayMs = serverDelay ?? jitteredDelay;

    if (Date.now() + delayMs - startedAt >= maxElapsedMs) {
      throw new Error("Orçamento de retry de LLM esgotado");
    }

    await sleep(delayMs);
  }

  throw new Error("Estado de retry inalcançável");
}
Adicione timeouts de solicitação, classes de erro estruturadas, telemetria e cancelamento antes do uso em produção. Se a chamada puder criar efeitos colaterais externos, torne a operação de negócio idempotente antes de tentar novamente.
Tentar Novamente, Enfileirar, Reduzir Ou Roteirizar?
Um sistema resiliente tem mais de uma resposta ao throttling.
| Situação | Tentativa | Fila | Reduzir Tokens | Redirecionar para Outro Lugar |
|---|---|---|---|---|
Uma única 429 transitória curta |
Sim, com limite | Opcional | Não | Normalmente não |
| Esgotamento sustentado de RPM | Muito limitado | Sim | Normalmente não | Às vezes |
| Esgotamento sustentado de TPM | Muito limitado | Sim | Sim | Às vezes |
| Cota diária esgotada | Não | Somente se a redefinição posterior for aceitável | Não | Talvez |
| Erro de cobrança ou permissão | Não | Não | Não | Não, corrija o acesso primeiro |
| Sobrecarga do provedor com fallback saudável | Brevemente | Opcional | Não | Sim, após a verificação da política |
| Stream parcial já entregue | Normalmente sem repetição | Talvez continuar ou reiniciar explicitamente | Talvez | Somente com semântica clara |
A enfileiramento protege o provedor e a experiência do usuário quando o trabalho pode esperar. A redução de tokens protege o TPM. O roteamento protege a disponibilidade apenas quando a rota alternativa satisfaz o mesmo contrato de produto.
Para padrões específicos de sobrecarga, use o playbook de API Error 529 overloaded. Para implicações de custo, conecte o comportamento de tentativas e fallback a AI gateway pricing e how to compare AI model prices.
Rate Limits Em Avaliações de Modelos
Os limites de taxa podem invalidar uma comparação de modelos.
Se o modelo A é testado com 10 workers e o modelo B com 100 workers, o modelo B pode parecer mais lento porque o harness causou enfileiramento e tentativas. Essa medição diz mais sobre a configuração do teste do que sobre a latência do modelo.
Para avaliações defensáveis:
- Separe a latência do modelo, o atraso na fila e o atraso de tentativa.
- Use o mesmo processo de chegada ou o mesmo nível de utilização normalizado para cada rota.
- Aqueça o tráfego gradualmente quando os provedores usarem controles de aceleração.
- Registre tokens e tentativas por tarefa concluída.
- Relate separadamente a taxa de sucesso na primeira tentativa e a taxa de sucesso eventual.
- Compare o custo por tarefa aceita, não apenas o preço do token.
- Execute testes de sobrecarga separadamente dos testes de qualidade.
Isso é especialmente importante para contas gratuitas ou de baixo nível. O artigo free LLM APIs é um contexto útil porque limites gratuitos geralmente são projetados para exploração, não para carga de produção.
Métricas Para Gerar Alertas
Acompanhe estas por provedor, modelo, rota, tenant, carga de trabalho e ambiente:
- Requisições por minuto.
- Tokens de entrada por minuto e tokens de saída por minuto.
- Tokens estimados reservados versus tokens reais usados.
- Profundidade da fila e idade do item mais antigo na fila.
- Tempo de espera por capacidade de taxa.
- Taxa de sucesso na primeira tentativa.
- Tentativas de retry por requisição bem-sucedida.
- Taxa de
429por causa classificada. - Amplificação de retries: tentativas totais divididas pelos resultados bem-sucedidos.
- Taxa de fallback e resultado do fallback.
- Latência ponta a ponta de p50, p95 e p99.
- Custo por tarefa bem-sucedida ou aceita.
As convenções semânticas de IA generativa do OpenTelemetry podem ajudar a padronizar a telemetria de modelo, operação, token, resposta e erro. Mantenha também dimensões específicas do produto: cliente, workspace, classe de tráfego, ambiente, recurso e responsável.
Um alerta apenas sobre a contagem total de 429 é ruidoso. Um sinal melhor combina taxa de limitação, idade da fila, amplificação de retries e taxa final de falha.
Uma Arquitetura de Limite de Taxa em Produção
Um caminho robusto de requisição geralmente tem sete camadas de controle:
client
  -> admission control
  -> priority queue
  -> token reservation
  -> RPM + TPM limiter
  -> provider/model route
  -> bounded retry controller
  -> contract-safe fallback
  -> usage, cost, and latency ledger
Use controle de admissão quando a fila não puder atender ao prazo do chamador. Use filas de prioridade para que avaliações não críticas não bloqueiem o tráfego de produção. Use reserva de tokens para manter o TPM honesto. Use um controlador centralizado de retries para que as camadas de SDK, fila, gateway e worker não façam retry independentemente.
O livro razão de uso deve registrar:
rate_limit_event:
  request_id: req_8f3a
  workspace_id: ws_42
  environment: production
  workflow: support_answer
  route_requested: primary_chat_route
  route_final: fallback_chat_route
  estimated_input_tokens: 3200
  max_output_tokens: 900
  actual_input_tokens: 3014
  actual_output_tokens: 622
  attempt_count: 2
  retry_delay_ms: 740
  queue_delay_ms: 1180
  final_status: success
  classified_limit: transient_rpm_burst
  accepted_result: true
Isso torna os limites de taxa da API de LLM revisáveis após o incidente. Também fornece às equipes de finanças e produto as evidências de que precisam quando retries ou fallbacks alteram o custo por resultado aceito.
Como a Flatkey Se Encaixa
A Flatkey oferece às equipes uma chave de API e uma URL base compatível com a OpenAI para rotas de modelos suportadas. Isso não remove os limites de taxa upstream de LLM. Ele fornece às equipes uma única superfície de integração na qual roteamento, revisão de uso e política podem ser tornados consistentes entre provedores.
Para o fluxo de trabalho LLM Rate Limits Explained: RPM, TPM, and Retries, uma camada de gateway ajuda quando:
- Sua aplicação precisa de uma única política de retentativa, fila e fallback em vez de lógica por provedor espalhada entre serviços.
- As equipes de produto precisam comparar a saúde da rota, a latência, os tokens e o custo do resultado aceito em um único livro-razão.
- As equipes de plataforma precisam de allowlists de modelos, orçamentos por subchave e controles de uso por ambiente ou fluxo de trabalho.
- O financeiro precisa de um único saldo, fatura e evidência em nível de requisição em vez de painéis de provedores desconectados.
- Os operadores precisam mover o tráfego elegível quando uma rota está restringida, sem reescrever o SDK da aplicação.
O gateway ainda deve preservar contratos específicos do modelo. Não roteie de um modelo para outro, a menos que a janela de contexto, o comportamento das ferramentas, a saída estruturada, a política de segurança, os controles de dados, a latência e o custo sejam aceitáveis para essa carga de trabalho. Verifique a disponibilidade atual das rotas e os preços no diretório de modelos da Flatkey e na precificação da Flatkey antes do lançamento em produção.
Erros Comuns
Tratar RPM Como Concorrência
RPM mede admissões ao longo do tempo. Concorrência mede o trabalho em andamento. Gerações lentas podem criar alta concorrência com RPM modesto.
Tentar Novamente Imediatamente Todo 429
Retentativas imediatas sincronizam trabalhadores e consomem mais capacidade. Respeite Retry-After quando válido, adicione jitter e limite o orçamento de retentativas.
Usar Um Único Limitador Para Cada Modelo
Os provedores podem usar pools separados por modelo ou pools compartilhados por conta. O limitador deve seguir o escopo de quota documentado e os cabeçalhos de resposta observados.
Ignorar Consumidores Compartilhados
Um painel, um executador de avaliações, um agente de programação e uma API de produção podem compartilhar um projeto. Reserve capacidade por carga de trabalho e isole o tráfego crítico sempre que possível.
Tentar Novamente Streams Parciais
Uma vez que os tokens tenham chegado ao usuário ou uma ação de ferramenta tenha sido executada, uma repetição silenciosa pode duplicar a saída ou efeitos colaterais. Defina explicitamente a semântica de continuação, reinício ou idempotência.
Medir Apenas a Latência do Provedor
A latência do usuário final inclui atraso de fila, atraso de retentativa, atraso de fallback e latência do modelo. Alerta sobre todo o caminho e mantenha os componentes separados.
FAQ
Qual é a diferença entre RPM e TPM?
RPM limita quantas requisições são admitidas ao longo do tempo. TPM limita quantos tokens de entrada e/ou saída são admitidos. Prompts pequenos geralmente atingem RPM primeiro; cargas de trabalho com contexto longo ou alta saída geralmente atingem TPM primeiro.
Por que recebo erros 429 abaixo do meu limite de RPM?
O provedor pode aplicar janelas deslizantes, token buckets, quotas compartilhadas por conta, limites separados de tokens, pools específicos por modelo, limites diários ou controles de aceleração. Seu contador local de requisições pode não representar o escopo total da quota.
Devo tentar novamente todo 429?
Não. Tente novamente um throttling de curta duração com um pequeno orçamento e jitter. Não tente repetidamente esgotamento de quota diária, restrições de cobrança, erros de permissão, erros de validação ou sobrecarga sustentada que não tenha uma janela realista de recuperação.
O backoff exponencial garante sucesso?
Não. O backoff reduz colisões e dá tempo para que a capacidade transitória se recupere. Ele não pode criar quota. O esgotamento persistente exige menor demanda, mais capacidade, trabalho adiado ou outra rota elegível.
As retentativas contam contra os limites de taxa?
Podem contar. Os provedores podem contabilizar requisições ou tentativas malsucedidas contra os limites ativos, então a amplificação por retentativas deve ser monitorada e limitada.
Quantas retentativas uma requisição de LLM deve usar?
Não existe um número universal. Defina as tentativas com base no orçamento de latência visível ao usuário e no modo de falha. Aplicações interativas geralmente precisam apenas de algumas tentativas curtas antes de falhar ou rotear; trabalhos offline podem tolerar filas mais longas.
Checklist Final
Use esta checklist ao implementar Limites de Taxa de LLM Explicados: RPM, TPM e Tentativas em produção:
- Modele RPM, TPM, limites diários, limites de gasto e concorrência separadamente.
- Calcule a capacidade a partir do mínimo entre os tetos de requisições e de tokens.
- Opere abaixo do máximo publicado com um fator de segurança.
- Reserve tokens antes de enviar requisições de alta variância.
- Use filas e pacing para carga sustentada.
- Respeite
Retry-Afterquando válido e viável. - Use backoff exponencial com jitter quando não houver uma dica válida do servidor.
- Limite as tentativas e o tempo total de retentativa.
- Interrompa retentativas para erros de quota, cobrança, permissão e validação.
- Evite reproduzir streams parciais ou efeitos colaterais não idempotentes.
- Encaminhe apenas para modelos que preservem o contrato de produto necessário.
- Separe o atraso de fila e o atraso de retentativa da latência do modelo nas avaliações.
- Alerta sobre amplificação de retentativas e idade da fila, não apenas sobre a contagem bruta de
429. - Registre IDs de requisição, estimativas de tokens, tokens reais, tentativas, rota de fallback e resultado final no livro-razão de uso.
Limites de taxa são controles de planejamento de capacidade antes de serem mensagens de erro. A principal conclusão duradoura de Limites de Taxa de LLM Explicados: RPM, TPM e Tentativas é medir independentemente a frequência de requisições, a vazão de tokens, a concorrência, as retentativas e os resultados de fallback para que 429 se torne um sinal acionável em vez de ruído de produção.
Fontes
- Documentação de limite de taxa da OpenAI: https://platform.openai.com/docs/guides/rate-limits
- OpenAI Cookbook, lidando com limites de taxa: https://cookbook.openai.com/examples/how_to_handle_rate_limits
- Limites de taxa da Anthropic: https://docs.anthropic.com/en/api/rate-limits
- Limites de taxa da API Gemini: https://ai.google.dev/gemini-api/docs/rate-limits
- RFC 9110 Retry-After: https://www.rfc-editor.org/rfc/rfc9110.html#name-retry-after
- MDN 429 Too Many Requests: https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Status/429
- Blog de Arquitetura da AWS, backoff exponencial e jitter: https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
- Convenções semânticas de IA generativa do OpenTelemetry: https://opentelemetry.io/docs/specs/semconv/gen-ai/
- Preços do Flatkey: https://flatkey.ai/pricing
- Diretório de modelos do Flatkey: https://flatkey.ai/models