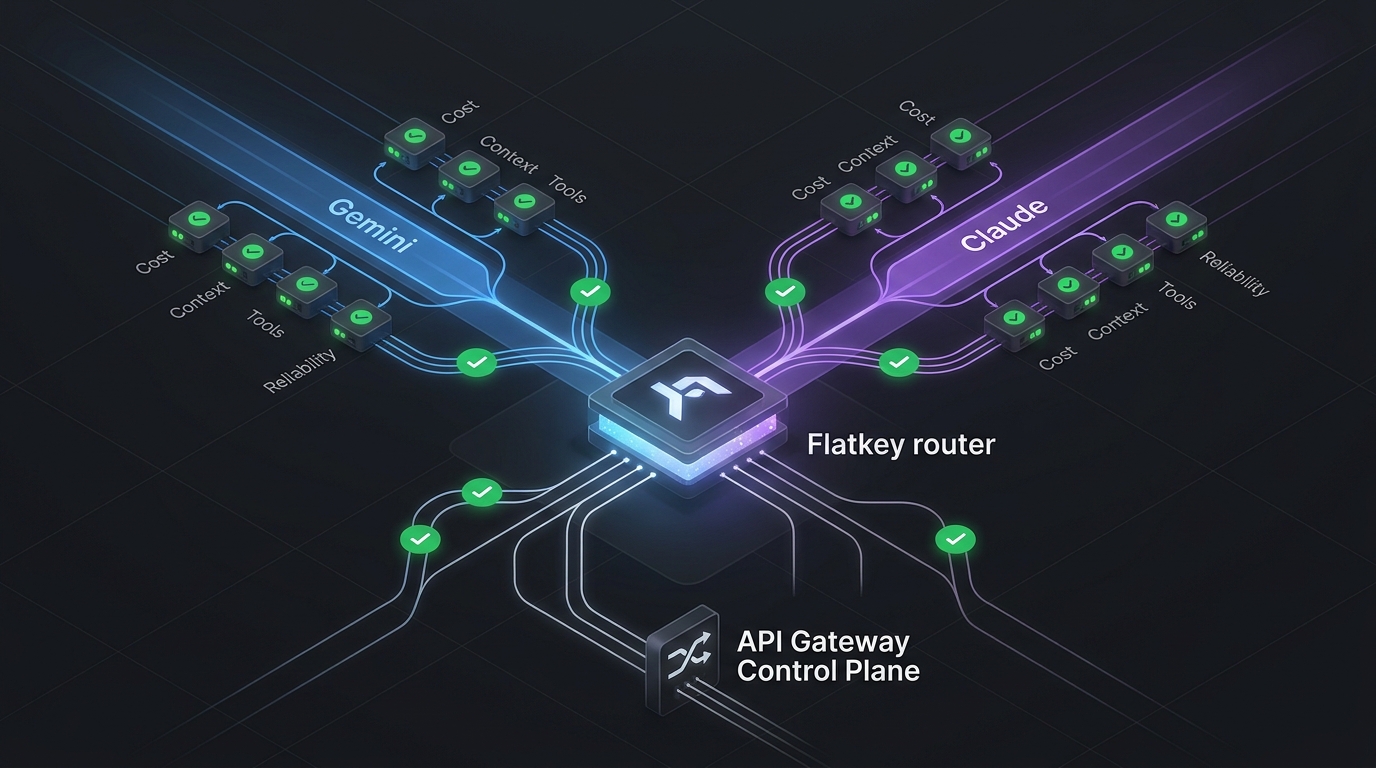
Se você estiver comparando Gemini e Claude para um fluxo de trabalho de API, não pare em "qual modelo é melhor". Em produção, a pergunta melhor é: qual rota deve receber esta classe de solicitação, o que deve acontecer quando ela falhar e como você vai provar o custo e a qualidade do resultado após a chamada?
Esse é o trabalho prático de Roteamento de API Gemini vs Claude: custo, contexto, ferramentas e verificações de confiabilidade. Gemini e Claude dão suporte a cargas de trabalho de aplicativos sérias, mas fazem trade-offs diferentes em unidades de preço, janelas de contexto, chamada de ferramentas, saída estruturada, processamento em lote, cache, limites de taxa e verificação operacional. Uma política de rota deve deixar esses trade-offs explícitos antes que o tráfego seja movido.
Este guia oferece às equipes uma lista de verificação com base em fontes para decidir quando rotear para Gemini, quando rotear para Claude e quando colocar ambos atrás de um gateway compatível com OpenAI, como o Flatkey. Use-o antes de uma migração, do lançamento de um agente, de uma revisão de custo de prompts ou de uma implantação de fallback.
Se você ainda estiver escolhendo o próprio padrão de gateway, combine este artigo com os guias do Flatkey para usar uma API unificada de IA e usar uma alternativa à API OpenAI. Se a principal questão for medição, comece primeiro com a estrutura de métricas de API para roteamento de IA.
A resposta rápida para o roteamento da API Gemini vs Claude
Use Gemini como a primeira rota quando a carga de trabalho for sensível a preço, de grande contexto, multimodal ou adequada a processamento em lote e seu conjunto de avaliação confirmar uma qualidade de saída aceitável. Use Claude como a primeira rota quando a carga de trabalho exigir raciocínio forte em textos longos, seguimento cuidadoso de instruções, uso de ferramentas com alta confiança ou recursos de agente específicos da Anthropic. Use uma rota de gateway quando a aplicação precisar alternar modelos sem reescrever o código do SDK, comparar registros de uso em um só lugar ou manter um fallback testado pronto.
| Pergunta de roteamento | A rota Gemini costuma ser atraente quando... | A rota Claude costuma ser atraente quando... | Verifique antes da produção |
|---|---|---|---|
| Custo | A tarefa pode usar modelos no estilo Flash / Flash-Lite, descontos por lote ou unidades de entrada multimodais mais baratas. | A tarefa justifica taxas por token mais altas por meio de melhor taxa de aceitação, menos tentativas ou menor custo de revisão. | Normalize para custo por saída aceita, não para o preço de entrada listado. |
| Contexto | Você precisa de contexto amplo para documentos, bases de código, transcrições ou pacotes de recuperação. | Você precisa de raciocínio em contexto longo com a linha atual de modelos da Claude e limites de saída. | Teste a retenção, a disciplina de citação, a latência e o modo de falha em tamanhos de contexto reais. |
| Ferramentas | Você precisa de chamada de função, além de opções de ecossistema de ferramentas nativas do Google. | Você precisa de padrões de uso de ferramentas da Claude para agentes, ferramentas de cliente, ferramentas de servidor e chamadas de ferramentas estruturadas. | Execute o mesmo esquema de ferramentas e verifique argumentos, tentativas e chamadas inválidas. |
| Saída estruturada | Você precisa de conformidade com JSON Schema para fluxos de aplicativos tipados. | Você precisa de controles de saída em JSON ou padrões rígidos de uso de ferramentas para conformidade com o esquema. | Valide a saída analisada em relação ao seu esquema, não apenas a correção visual. |
| Confiabilidade | Você pode absorver a variabilidade de limite de taxa do provedor com enfileiramento ou fallback. | Você pode absorver os limites da Anthropic e a sobrecarga de tokens de ferramentas com controles de rollout. | Registre provedor, modelo, contagens de tokens, latência, status e motivo do fallback. |
Em resumo: o vencedor raramente é "Gemini" ou "Claude" globalmente. O vencedor é a rota que passa nas verificações específicas da sua carga de trabalho com o menor custo por saída aceita e o menor número de surpresas operacionais.
Normalize o custo antes de comparar os preços dos modelos
A parte mais difícil do roteamento de API Gemini vs Claude é que as páginas de preços não são estruturadas da mesma forma. O Google lista os preços do Gemini por modelo, modalidade, unidade de entrada/saída, modo em lote e, às vezes, nível de contexto. A Anthropic lista os preços do Claude por família de modelo, tokens de entrada/saída, cache de prompts, processamento em lote e sobrecarga de tokens específica de recurso.
Comece com uma planilha de custos em vez de um debate:
| Campo de custo | Por que isso importa |
|---|---|
| Tokens de entrada | Prompts longos, documentos recuperados, esquemas de ferramentas e instruções de sistema podem dominar o custo da solicitação. |
| Tokens de saída | Planos de agentes, diffs de código, payloads JSON e resumos podem deslocar o custo para os tokens de conclusão. |
| Escrita em cache e leitura de cache | O cache de prompts do Claude pode mudar a economia para contexto repetido; o cache de contexto do Gemini deve ser verificado quando o contexto repetido for relevante. |
| Desconto em lote | Google e Anthropic documentam descontos para processamento em lote, mas o lote só ajuda quando respostas com atraso são aceitáveis. |
| Overhead de ferramentas | Definições de ferramentas, esquemas e chamadas intermediárias de ferramentas adicionam tokens. A Anthropic documenta explicitamente os custos de tokens em torno do uso de ferramentas; os payloads de ferramentas do Gemini também precisam de contabilização medida de tokens. |
| Taxa de retry | Um modelo mais barato pode ficar caro se a validação rejeitar mais saídas. |
| Custo de revisão humana | Para fluxos de trabalho de suporte, jurídico, finanças ou revisão de código, a taxa de aceitação pode importar mais do que o preço bruto por token. |
Para o Gemini, mantenha a página de preços da API Gemini aberta enquanto monta a planilha. Na verificação desta fonte, o Google lista preços diferentes para Gemini Flash, Flash-Lite, Pro, lote e casos com faixas de contexto, incluindo as novas linhas Gemini 3.x e Gemini 2.5. Para Claude, use a página de preços do Claude da Anthropic e considere os níveis de modelo, cache de prompts, comportamento de contexto longo e processamento em lote.
Para um trabalho de preços mais aprofundado, use o guia de preços da API Gemini e o guia de preços da API Claude da Flatkey como complementos e, depois, traga os números finais de volta para esta planilha de roteamento.
A métrica de roteamento deve ser:
accepted_output_cost =
  (input_cost + output_cost + cache_write_cost + cache_read_cost + tool_overhead_cost + retry_cost)
  / accepted_outputs
Essa fórmula evita um erro comum: escolher o menor preço de entrada listado e ignorar saídas mais longas, JSON inválido, retries de ferramentas ou limpeza manual.
Verifique as janelas de contexto com payloads reais
As alegações sobre janela de contexto são úteis, mas não são o mesmo que contexto utilizável. Um modelo pode aceitar um contexto grande e ainda assim deixar passar uma instrução enterrada, perder o rastreamento de uma entidade, ficar lento além do seu SLA ou produzir uma resposta que não possa ser validada.
A página de modelos Gemini da Google documenta opções de modelos com contexto longo, incluindo o Gemini 2.5 Flash com janela de contexto de 1M tokens. A página visão geral dos modelos Claude da Anthropic documenta os limites atuais de contexto e saída dos modelos Claude, incluindo contexto de 1M tokens para vários modelos atuais e uma janela menor para rotas da classe Haiku. Esses números importam, mas a decisão de roteamento deve vir de testes.
Execute o mesmo pacote de contexto pelas rotas candidatas:
- Um prompt curto sem contexto recuperado.
- Um prompt médio com o pacote de recuperação típico.
- Um prompt p90 com contexto real de cliente ou base de código.
- Um prompt de pior caso perto do seu limite.
- Um prompt degradado com fragmentos recuperados irrelevantes.
Em cada execução, registre:
| Métrica de contexto | O que capturar |
|---|---|
| Taxa de respostas aceitas | A resposta passou na sua rubrica ou validador downstream? |
| Latência em p50 / p90 / p99 | O prompt longo permaneceu dentro do SLA do produto? |
| Falhas de perda de contexto | O modelo ignorou fatos em posição baixa, restrições de ferramentas ou instruções finais? |
| Desvio no comprimento da saída | O contexto longo causou verbosidade desnecessária ou saída truncada? |
| Custo por saída aceita | O prompt maior compensou seu custo? |
Se o Gemini lidar com o contexto completo de forma barata, mas precisar de mais tentativas, direcione tarefas mais estreitas para ele e mantenha o Claude para raciocínio de alto risco. Se o Claude produzir maior taxa de aceitação no mesmo pacote de contexto longo, seu preço bruto de tokens mais alto ainda pode sair mais barato após os custos de revisão e repetição.
Compare diretamente a chamada de ferramentas e as saídas estruturadas
Cargas de trabalho de agentes geralmente falham de maneiras banais: um argumento malformado, um enum inventado, uma chave extra em JSON, uma chamada de ferramenta feita no momento errado ou uma resposta que parece boa, mas não pode ser analisada. É por isso que o roteamento de API Gemini vs Claude precisa de verificações de ferramentas e esquema, não apenas de pontuações de benchmark.
O Google documenta function calling para conectar modelos Gemini a ferramentas e retornar parâmetros, e structured output para respostas baseadas em JSON Schema. A Anthropic documenta Claude tool use para ferramentas de cliente e servidor e structured outputs para respostas orientadas a esquema.
Use um único framework de testes compartilhado:
| Teste | Comportamento para aprovação |
|---|---|
| Chamada de ferramenta obrigatória | O modelo chama a ferramenta correta e não responde diretamente. |
| Caso sem ferramenta | O modelo se recusa a chamar uma ferramenta quando já há informação suficiente. |
| Campo enum | O modelo retorna apenas os valores enum permitidos. |
| Objeto aninhado | O modelo preenche os campos aninhados obrigatórios sem adicionar campos não suportados. |
| Erro na ferramenta | O modelo tenta novamente, pede os dados ausentes ou falha de forma graciosa conforme a política. |
| Streaming | A saída parcial não quebra seu parser nem a experiência do usuário. |
| Tentativa de injeção | O modelo segue a política do sistema e da ferramenta em vez de texto recuperado hostil. |
Não avalie primeiro a resposta em linguagem natural. Analise a saída, valide o JSON, inspecione os argumentos da ferramenta e então avalie a resposta. O roteamento que produz a prosa mais atraente ainda pode ser o roteamento errado para um agente se causar mais ações inválidas.
Use em lote e cache apenas onde o fluxo de trabalho permitir
Ambos os fornecedores documentam mecanismos de redução de custos que podem mudar uma decisão de roteamento.
A Batch API do Google foi projetada para solicitações assíncronas de alto volume e documenta uma meta de custo padrão 50% menor para cargas de trabalho em lote elegíveis. A documentação das Message Batches da Anthropic também descreve uma redução de custo de 50% para processamento em lote, com a maioria dos lotes concluindo em menos de uma hora e limites de tamanho de solicitação documentados.
Batch é uma boa opção para:
- Classificação offline.
- Backfills.
- Rotulagem de conjuntos de dados.
- Execuções grandes de avaliação.
- Geração de relatórios semanais.
- Resumo não urgente.
Batch é uma má opção para:
- Turnos de chat.
- Suporte em tempo real.
- Loops internos de agentes de programação.
- Retries voltados ao usuário.
- Qualquer fluxo de trabalho em que saída desatualizada seja cara.
O cache tem uma forma diferente. Se seus prompts repetem uma política grande, um mapa da base de código, um catálogo de produtos ou um modelo de contrato, leituras do cache podem tornar economicamente razoável uma rota de maior qualidade. Se os prompts forem em sua maioria únicos, o cache talvez não ajude. Para Claude, a página de preços da Anthropic inclui multiplicadores de gravação e leitura do cache de prompt; para Gemini, consulte a documentação e a linha de preços atuais de cache de contexto antes de assumir que a economia se aplica à sua carga de trabalho.
A regra de roteamento deve ser simples:
route_policy:
  realtime_user_request:
    primary: low_latency_model_that_passes_schema_tests
    fallback: safest_validated_model
    batch: false
  offline_backfill:
    primary: lowest_accepted_output_cost
    fallback: retry_later_or_second_provider
    batch: true
  repeated_context_agent:
    primary: best_cache_adjusted_acceptance_rate
    fallback: model_with_shorter_context_pack
    batch: false
Verificações de confiabilidade antes de uma rota Gemini ou Claude entrar em produção
O status do provedor e os limites publicados são apenas pontos de partida. O Google documenta os limites de taxa do Gemini por dimensões como solicitações por minuto, tokens de entrada por minuto, solicitações por dia e limites baseados em gasto, com limites aplicados por projeto e capacidade real não garantida. A documentação da Anthropic descreve restrições de preço, contexto, ferramentas, cache e lote do modelo que afetam quantas chamadas seu fluxo de trabalho pode enviar com segurança.
Antes de o tráfego de produção ser movido, execute uma lista de verificação da rota:
| Verificação | O que verificar |
|---|---|
| Autenticação | A chave direta do provedor ou a chave do gateway está vinculada ao ambiente correto. |
| Model ID | O ID exato do modelo está atualizado e é suportado pela rota da conta. |
| Formato da solicitação | Mensagens, ferramentas, esquema JSON, streaming e campos de modalidade correspondem à rota. |
| Limites de taxa | A classe de tráfego permanece dentro das restrições de RPM, TPM, diárias e de gastos. |
| Mapeamento de erros | Casos de 400, 401, 403, 429, 5xx, timeout e sobrecarga do provedor mapeiam para um comportamento acionável do app. |
| Política de fallback | O app sabe quando tentar novamente a mesma rota, trocar de provedor, enfileirar ou falhar de forma fechada. |
| Log de custos | Cada solicitação registra modelo, contagens de tokens, uso de cache, modo de lote, latência, status e custo. |
| Validador de saída | O produto tem um validador para JSON, chamadas de ferramentas, citações ou correção específica da tarefa. |
O quickstart da Flatkey mostra o padrão do SDK da OpenAI: mantenha o SDK e altere o base_url para https://router.flatkey.ai/v1. A visão geral da API REST da Flatkey documenta a mesma base URL compatível com a OpenAI, e o índice de documentação da Flatkey descreve uma chave, um saldo compartilhado, um catálogo de modelos e documentação para GPT, Claude, Gemini, DeepSeek e outros modelos. Após a primeira solicitação, o quickstart da Flatkey orienta os usuários a verificar os Usage Logs para modelo, contagem de tokens, latência e custo.
Isso torna a Flatkey útil em uma implantação de roteamento: você pode manter estável o formato de solicitação do app, comparar o comportamento das rotas do Gemini e do Claude nos logs de uso e promover um fallback testado sem espalhar chaves de provedor entre serviços.
Para padrões adjacentes de planejamento de rotas, compare este fluxo com a lista de verificação do Gemini API para agentes da Flatkey e com o artigo verificações de roteamento da API DeepSeek vs Qwen.
Um scorecard prático de roteamento
Use este scorecard para a decisão final. Dê a cada linha uma pontuação de 1 a 5 para Gemini e Claude e depois pese de acordo com a carga de trabalho.
| Critério | Peso | Pontuação Gemini | Pontuação Claude | Observações |
|---|---|---|---|---|
| Custo de saída aceita | 25% | Inclua novas tentativas, cache, lote e sobrecarga de ferramentas. | ||
| Validade do esquema | 15% | Conte falhas de parser e valores de enumeração inválidos. | ||
| Precisão de chamadas de ferramenta | 15% | Conte ferramenta errada, campo ausente e uso desnecessário de ferramenta. | ||
| Confiabilidade do contexto | 15% | Teste em tamanhos de prompt p50, p90 e no pior caso. | ||
| Latência | 10% | Meça a latência de streaming e de resposta completa. | ||
| Folga de limite de taxa | 10% | Verifique os limites do projeto/conta antes do lançamento. | ||
| Recuperação de falhas | 10% | Verifique caminhos de nova tentativa, fallback e revisão humana. |
Por exemplo:
- Um pipeline de sumarização em segundo plano pode dar o maior peso ao custo de saída aceita e ao suporte a lote.
- Um agente de codificação pode dar o maior peso à precisão de chamadas de ferramenta, à latência e à confiabilidade do contexto.
- Um fluxo de trabalho de suporte ao cliente pode dar o maior peso à validade do esquema, ao comportamento de escalonamento e ao custo de revisão.
A saída de Gemini vs Claude API Routing deve ser um arquivo de política, não uma ata de reunião.
routes:
  support_triage:
    primary: gemini-or-claude-route-that-wins-scorecard
    fallback: second-provider-route
    validator: support_ticket_schema_v3
    retry_limit: 1
    fail_closed_when:
      - missing_required_field
      - unsafe_escalation_label
  code_review_agent:
    primary: route-that-wins-tool-and-context-tests
    fallback: route-with-best-safe-summary
    validator: diff_comment_schema_v2
    retry_limit: 0
    fail_closed_when:
      - tool_argument_invalid
      - repository_path_not_in_context
Como executar uma comparação segura do Flatkey
Flatkey não substitui a avaliação. É o plano de controle que torna a avaliação e a implementação mais fáceis.
- Escolha uma carga de trabalho, como triagem de suporte, comentários de revisão de código, sumarização de relatórios ou extração.
- Crie um conjunto congelado de 50-200 prompts reais com regras de saída esperadas.
- Escolha uma rota Gemini e uma rota Claude do catálogo atual de modelos.
- Envie ambas pelo mesmo formato de solicitação compatível com OpenAI, sempre que possível.
- Registre contagens de tokens, latência, status, provedor, modelo, custo e resultado do validador.
- Compare o custo por saída aceita, não o preço por milhão de tokens.
- Implante o vencedor como primário e mantenha o outro como fallback monitorado.
- Execute o teste novamente após mudanças em preços do provedor, IDs de modelo, limites de contexto ou integridade da rota.
É aqui que um gateway faz por merecer. Se o aplicativo já usa um cliente compatível com OpenAI, o Flatkey pode tornar o primeiro teste tão pequeno quanto uma alteração em base_url mais uma alteração na seleção de modelo. Se a rota falhar, você reverte a política de rota em vez de reescrever o código da aplicação.
Erros comuns em Gemini vs Claude API Routing
Erro 1: Comparar apenas modelos flagship.
A maioria dos fluxos de trabalho de produção não precisa do modelo mais caro para cada solicitação. Compare classes de rota: rápida, barata, de longo contexto, com alto nível de raciocínio, em lote e de fallback.
Erro 2: Ignorar esquemas de ferramentas.
Prompts de agentes frequentemente incluem definições grandes de ferramentas. Meça esses tokens e valide os argumentos das ferramentas.
Erro 3: Tratar janela de contexto como qualidade da პასუხ.
Uma janela de contexto maior só é útil quando o modelo usa de forma confiável as partes certas dela.
Erro 4: Esquecer a semântica de fallback.
Um modelo de fallback pode ser pior do que não ter fallback se ele alterar a forma da saída, pular ferramentas obrigatórias ou violar uma política do produto.
Erro 5: Publicar uma rota sem revisão dos logs de uso.
Seus logs devem mostrar o modelo real, contagens de tokens, latência, status, custo e o motivo do fallback. Se esses campos estiverem ausentes, você não conseguirá depurar a rota sob carga.
FAQ
Gemini é mais barato do que Claude?
Às vezes, mas nem sempre após a validação. O Gemini frequentemente tem taxas publicadas atraentes para cargas de trabalho no estilo Flash, enquanto o Claude pode vencer quando maior taxa de aceitação, menos retries, melhor comportamento com ferramentas ou menor custo de revisão compensam taxas de token mais altas. Use as páginas de preços dos provedores e calcule o custo por saída aceita.
Claude é melhor do que Gemini para chamada de ferramentas?
Não universalmente. O Claude tem documentação forte de uso de ferramentas e padrões orientados a agentes, enquanto o Gemini suporta function calling e saídas estruturadas. A resposta certa depende do seu esquema de ferramentas, do tratamento de erros, das necessidades de streaming e dos resultados do validador.
Devo rotear cada solicitação por um único provedor primeiro?
Geralmente não. Separe o tráfego por classe de carga de trabalho. Uma rota barata em lote, uma rota de chat em tempo real, uma rota de longo contexto e uma rota de fallback podem usar modelos diferentes.
As APIs em lote tornam as rotas em tempo real mais baratas?
Não. Descontos de lote ajudam cargas de trabalho com atraso tolerável. Eles não ajudam um usuário esperando por uma resposta de chat, suporte ou de um agente de programação.
Por que usar a Flatkey para roteamento de API Gemini vs Claude?
Use a Flatkey quando quiser um único plano de controle compatível com OpenAI para seleção de modelos, logs de uso, revisão de custos e rollout de fallback. Ela é especialmente útil quando um app já usa um SDK no estilo OpenAI e precisa comparar Gemini e Claude sem espalhar chaves de provedor e visões de cobrança por vários serviços.
Conclusão
Roteamento de API Gemini vs Claude: custo, contexto, ferramentas e verificações de confiabilidade não é uma comparação pontual de fornecedores. É um fluxo de trabalho operacional. Comece com os preços e a documentação oficiais dos modelos, teste contexto e comportamento de ferramentas em prompts reais, calcule o custo por saída aceita e mantenha uma política de fallback pronta antes que o tráfego de produção seja movido.
Se sua equipe quiser comparar Gemini e Claude atrás de um único gateway compatível com OpenAI, comece com o quickstart da Flatkey, escolha os candidatos de rota no catálogo de modelos atual e verifique as primeiras chamadas em Usage Logs antes de ampliar o tráfego.