Plataformas de observabilidade de IA: o que fazem e como escolher (2026)
Uma plataforma de observabilidade de IA registra cada chamada de modelo, etapa de agente e chamada de ferramenta da sua aplicação (prompt, resposta, tokens, custo, latência e erros) para que você possa depurar, avaliar e controlar gastos em produção. As principais opções em outubro de 2026 são Langfuse, LangSmith, Arize (Phoenix e AX), Datadog LLM Observability, Helicone, Braintrust e Pydantic Logfire, e a maioria aceita traces do OpenTelemetry. Escolha com base em onde seus dados precisam ficar, como você avalia a qualidade e quanto vai pagar por trace.
Este guia explica o que é observabilidade de IA, quais sinais capturar, como as principais plataformas se comparam em recursos e preços publicados e como instrumentar uma aplicação em menos de 30 linhas de código. Os preços foram retirados da página oficial de preços de cada fornecedor, consultada em 24 de outubro de 2026.
O que é observabilidade de IA?
Observabilidade de IA é a prática de coletar traces, métricas, logs e notas de qualidade de sistemas de IA para responder, a qualquer momento, a três perguntas: O que o modelo fez? A resposta foi boa? Quanto custou? Ela amplia o monitoramento clássico de aplicações, que acompanha disponibilidade e latência, com sinais que só importam para modelos de linguagem:
- Entradas e saídas: o prompt, o contexto recuperado e a resposta gerada.
- Uso de tokens e custo: tokens de entrada, de saída e em cache por requisição, usuário e funcionalidade.
- Traces de agentes: cada etapa de raciocínio, chamada de ferramenta e nova tentativa em uma execução de várias etapas.
- Qualidade: notas de avaliadores, feedback de usuários e sinalizações de alucinação ou de violação de políticas.
- Metadados do modelo e do provedor: qual modelo respondeu, por qual rota e com quais parâmetros.
O monitoramento tradicional diz que uma requisição levou 9 segundos. A observabilidade de IA diz que ela levou 9 segundos porque o agente chamou uma ferramenta de busca três vezes, a segunda chamada ao modelo recebeu um 429 e o modelo de fallback gerou uma resposta que falhou na sua verificação de fundamentação (groundedness).
Monitoramento vs observabilidade vs avaliação
| Prática | Pergunta que responde | Resultado típico |
|---|---|---|
| Monitoramento | O sistema está no ar e dentro dos limites? | Dashboards, alertas de latência e taxa de erros |
| Observabilidade | Por que esta requisição específica se comportou assim? | Traces com prompts, chamadas de ferramentas, tokens e metadados |
| Avaliação | A saída está correta, segura e útil? | Notas de testes, juízes LLM ou revisão humana |
Uma plataforma moderna de observabilidade de IA combina as três. O Framework de Gestão de Riscos de IA do NIST também enfatiza a medição e o monitoramento contínuos de sistemas de IA implantados, por isso muitas equipes de governança passaram a exigir esses registros.
O padrão aberto: convenções GenAI do OpenTelemetry
Você não precisa mais de um SDK proprietário para capturar telemetria de IA. O OpenTelemetry define convenções semânticas para IA generativa que nomeiam os atributos padrão das chamadas de modelos. Em outubro de 2026, essas convenções são mantidas em um repositório semantic-conventions-genai dedicado e continuam marcadas como "Development", então alguns nomes ainda podem mudar.
| Atributo | Significado |
|---|---|
gen_ai.operation.name |
A operação, como chat ou embeddings (obrigatório) |
gen_ai.provider.name |
O provedor, como openai ou anthropic (obrigatório) |
gen_ai.request.model |
Modelo solicitado pelo seu código |
gen_ai.response.model |
Modelo que realmente respondeu |
gen_ai.usage.input_tokens / gen_ai.usage.output_tokens |
Contagem de tokens |
gen_ai.response.finish_reasons |
Por que a geração parou |
gen_ai.conversation.id |
Agrupa os turnos de uma mesma conversa |
Instrumente uma vez com esses atributos e você poderá enviar os mesmos traces para Langfuse, Arize Phoenix, Datadog, Logfire, Grafana Tempo ou qualquer outro backend compatível com OTLP. A propagação de contexto entre serviços segue o padrão W3C Trace Context.
Comparativo de plataformas de observabilidade de IA
| Plataforma | Implantação | Pontos fortes | Preço de entrada publicado (out. 2026) |
|---|---|---|---|
| Langfuse | Código aberto (self-host) ou nuvem | Tracing, gestão de prompts, avaliações; núcleo com licença MIT | Hobby grátis (50 mil unidades/mês); Core US$ 29/mês; Pro US$ 199/mês |
| LangSmith | Nuvem, híbrido ou self-host no Enterprise | Integração profunda com LangChain e LangGraph, avaliações | Developer US$ 0/assento (5 mil traces base); Plus US$ 39/assento |
| Arize Phoenix e AX | Phoenix de código aberto; AX na nuvem | Tracing nativo OTel, avaliações, análise de drift | Phoenix grátis em self-host; AX Pro US$ 50/mês (50 mil spans) |
| Datadog LLM Observability | Nuvem (parte do Datadog) | Une traces de LLM a APM, logs e infraestrutura | Por uso; cotação via Datadog |
| Helicone | Nuvem ou self-host | Logging via proxy com uma linha de configuração, cache | Hobby grátis (10 mil requisições); Pro US$ 79/mês; Team US$ 799/mês |
| Braintrust | Nuvem | Fluxo focado em avaliação, experimentos, pontuação | Starter US$ 0 (1 GB processado, 10 mil notas); Pro US$ 249/mês |
| Pydantic Logfire | Nuvem | Observabilidade OTel geral com ótimo suporte a Python e agentes | Personal grátis (10 milhões de registros/mês); Team US$ 49/mês |
Como ler esta tabela:
- Precisa manter os dados no seu próprio ambiente? Comece com Langfuse ou Arize Phoenix; ambos podem ser auto-hospedados.
- Já paga pelo Datadog? O produto LLM Observability mantém os traces de IA junto do seu APM e dos seus logs.
- Usa LangChain ou LangGraph? O LangSmith exige a menor configuração.
- A avaliação é a prioridade? Braintrust e LangSmith lideram em experimentos e fluxos de pontuação.
- Quer zero mudanças no código? Ferramentas do tipo proxy, como o Helicone, ou os logs do seu gateway de IA capturam o tráfego na camada de rede.
O que observar em uma plataforma de observabilidade de IA
Use este checklist durante o teste:
- Suporte a OpenTelemetry. Ela consegue ingerir traces OTLP com atributos
gen_ai.*, e você consegue exportar seus dados de volta? - Tracing de agentes e ferramentas. Ela mostra spans aninhados para cada etapa, chamada de ferramenta e nova tentativa, e não só a chamada final ao modelo?
- Rastreamento de custos. Ela calcula o custo por requisição a partir dos tokens e dos seus preços reais, incluindo tokens em cache e descontos de batch?
- Avaliações. Dá para rodar verificações automáticas (LLM como juiz, regex, respostas de referência) em traces de produção e alertar quando as notas caem?
- Controles de privacidade. Dá para mascarar ou aplicar hash aos prompts, definir períodos de retenção e restringir quem vê o conteúdo bruto?
- Unidade de cobrança. Os fornecedores cobram por trace, span, "unidade", GB ou assento. Estime seu volume mensal em cada unidade antes de comparar.
- Self-hosting. Se houver dados regulados, confirme se existe uma opção auto-hospedada e quanto custa operá-la.
Instrumente uma chamada de LLM em Python com OpenTelemetry
Este exemplo registra uma chat completion com os atributos GenAI padrão e a exporta para qualquer endpoint OTLP (Langfuse, Phoenix, Logfire ou um collector local). Ele chama os modelos por um endpoint compatível com OpenAI, então o mesmo código funciona para GPT, Claude, Gemini ou DeepSeek.
pip install openai opentelemetry-sdk opentelemetry-exporter-otlp
export OTEL_EXPORTER_OTLP_ENDPOINT="http://localhost:4318"   # your collector or vendor endpoint
export FLATKEY_API_KEY="sk-..."
import os, time
from openai import OpenAI
from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter

provider = TracerProvider()
provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))
trace.set_tracer_provider(provider)
tracer = trace.get_tracer("support-bot")

client = OpenAI(api_key=os.environ["FLATKEY_API_KEY"],
                base_url="https://router.flatkey.ai/v1")

def answer(question: str, model: str = "claude-sonnet-5-5") -> str:
    with tracer.start_as_current_span(f"chat {model}") as span:
        span.set_attribute("gen_ai.operation.name", "chat")
        span.set_attribute("gen_ai.provider.name", "flatkey")
        span.set_attribute("gen_ai.request.model", model)
        t0 = time.time()
        r = client.chat.completions.create(
            model=model, max_tokens=300,
            messages=[{"role": "user", "content": question}])
        span.set_attribute("gen_ai.response.model", r.model)
        span.set_attribute("gen_ai.usage.input_tokens", r.usage.prompt_tokens)
        span.set_attribute("gen_ai.usage.output_tokens", r.usage.completion_tokens)
        span.set_attribute("gen_ai.response.finish_reasons", [r.choices[0].finish_reason])
        span.set_attribute("app.latency_ms", int((time.time() - t0) * 1000))
        return r.choices[0].message.content

print(answer("How do I reset my password?"))
provider.shutdown()  # flush spans before exit
No Node.js, o padrão é o mesmo com @opentelemetry/sdk-node:
import OpenAI from "openai";
import { trace } from "@opentelemetry/api";

const tracer = trace.getTracer("support-bot");
const client = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

export async function answer(question, model = "gpt-6.1-sol") {
  return tracer.startActiveSpan(`chat ${model}`, async (span) => {
    span.setAttributes({ "gen_ai.operation.name": "chat", "gen_ai.request.model": model });
    const r = await client.chat.completions.create({ model, messages: [{ role: "user", content: question }] });
    span.setAttributes({
      "gen_ai.response.model": r.model,
      "gen_ai.usage.input_tokens": r.usage.prompt_tokens,
      "gen_ai.usage.output_tokens": r.usage.completion_tokens,
    });
    span.end();
    return r.choices[0].message.content;
  });
}
Não coloque o conteúdo de prompts e respostas nos atributos dos spans, a menos que sua política de privacidade permita; muitas equipes registram um hash ou uma cópia anonimizada. Nosso guia de logging de payloads cobre padrões de anonimização.
Seu gateway de IA também é uma fonte de observabilidade
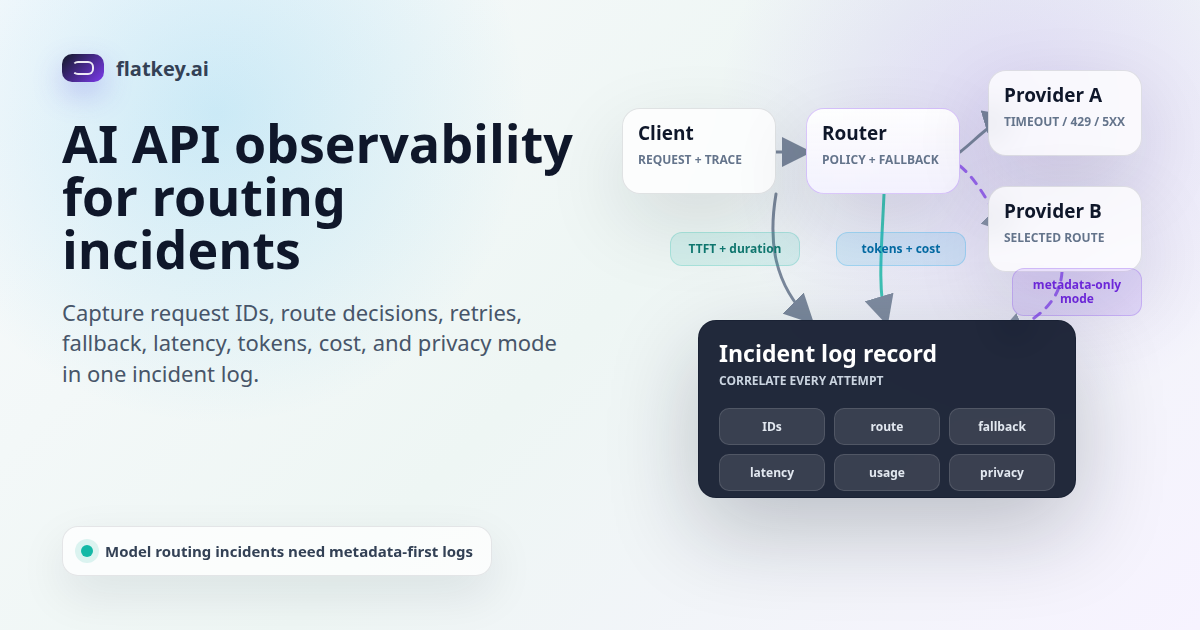
Se sua aplicação chama modelos por meio de um gateway ou roteador de IA, o gateway já vê cada requisição, então é o ponto de partida mais barato. Ele captura dados até de serviços que ainda não foram instrumentados. Os logs de uso da Flatkey, por exemplo, registram o horário, o modelo, os tokens de entrada e de saída, o custo, a chave de API mascarada e o status de cada chamada, podem ser exportados em CSV ou JSON e suportam limites de gasto mensal e cotas por grupo (documentação de uso da Flatkey, outubro de 2026).
Uma configuração prática combina as duas camadas:
| Camada | O que ela enxerga melhor | Exemplo de uso |
|---|---|---|
| Logs do gateway | Cada chamada de modelo, custo, status, erros do provedor, fallbacks | Gasto por chave ou equipe, taxas de 429 e 5xx, quedas de provedores |
| Traces da aplicação | Contexto de negócio, etapas do agente, recuperação, chamadas de ferramentas | Por que a requisição de um usuário falhou ou teve resposta ruim |
| Avaliações | Qualidade das respostas ao longo do tempo | Detectar regressões após mudar um prompt ou um modelo |
Conecte as duas com um ID de requisição compartilhado: envie seu trace ID como header ou campo de metadados em cada chamada de modelo, para ir de uma linha do log do gateway ao trace completo da aplicação. Veja observabilidade de APIs de LLM: métricas, traces e custos para o conjunto de métricas que recomendamos e o dashboard de KPIs do gateway de IA para layouts de gráficos.
As métricas que importam em produção
| Métrica | Por que importa | Ideia de alerta |
|---|---|---|
| Latência p50 / p95 por modelo | Usuários sentem a latência de cauda | p95 acima do seu SLO por 10 minutos |
| Tempo até o primeiro token | Experiência de streaming | TTFT subindo em um único provedor |
| Taxa de erros por status (429, 5xx, timeout) | Problemas de provedor ou de cota | Taxa de 429 acima de 2% |
| Taxa de fallback | Problemas de confiabilidade ocultos | Fallbacks dobrando de um dia para o outro |
| Custo por requisição e por usuário | Controle de orçamento | Gasto diário acima da previsão |
| Tokens por requisição | Prompts inchados e agentes descontrolados | Execuções de agentes acima de um teto de tokens |
| Nota de avaliação | Regressões de qualidade | Queda da nota após um deploy |
Atribua custos por equipe e ambiente para que o financeiro tenha respostas; o guia de atribuição de custos e o rastreamento de custos por ambiente mostram esquemas de tags. Para o plano de implantação, siga o checklist de implementação de observabilidade de IA.
Perguntas frequentes
O que é observabilidade de IA?
Observabilidade de IA é coletar traces, métricas, logs e notas de qualidade de aplicações de IA para ver o que um modelo ou agente fez, se o resultado foi bom e quanto custou. Ela acrescenta prompts, tokens, chamadas de ferramentas e avaliações ao monitoramento tradicional.
Qual é a melhor plataforma de observabilidade de IA?
Não existe uma única melhor plataforma. Langfuse e Arize Phoenix servem para equipes que querem código aberto e self-hosting, LangSmith para usuários de LangChain, Datadog para equipes que já usam Datadog e Braintrust para fluxos focados em avaliação. Teste duas opções com seus próprios traces.
Existe plataforma de observabilidade de IA gratuita?
Sim. Em outubro de 2026, Langfuse Hobby (50 mil unidades por mês), LangSmith Developer (5 mil traces base), Helicone Hobby (10 mil requisições), Braintrust Starter e Logfire Personal (10 milhões de registros) são gratuitos, e Langfuse e Arize Phoenix podem ser auto-hospedados sem custo de licença.
Qual a diferença entre monitoramento de LLM e observabilidade de IA?
O monitoramento acompanha limites predefinidos, como latência e taxa de erros. A observabilidade permite investigar em detalhe qualquer requisição individual, incluindo prompts, chamadas de ferramentas, uso de tokens e notas de qualidade.
A observabilidade de IA funciona com OpenTelemetry?
Sim. As convenções semânticas GenAI do OpenTelemetry definem atributos padrão como gen_ai.request.model e gen_ai.usage.input_tokens, e a maioria das plataformas aceita traces OTLP. Em outubro de 2026, as convenções ainda estão em status Development.
O que é observabilidade de IA generativa?
É a mesma prática aplicada a modelos generativos: capturar prompts, saídas, custos de tokens, etapas de agentes e resultados de avaliação para que as equipes possam depurar e melhorar recursos de IA generativa em produção.
Fontes
- Convenções semânticas GenAI do OpenTelemetry (outubro de 2026)
- Preços do Langfuse, preços do LangSmith, preços da Arize, preços do Helicone, preços do Braintrust, preços do Logfire (todos consultados em 24 de outubro de 2026)
- Documentação do Datadog LLM Observability (outubro de 2026)
- Arize Phoenix no GitHub e Langfuse no GitHub
- Framework de Gestão de Riscos de IA do NIST