Arquitetura de API gateway e principais recursos (guia 2026)
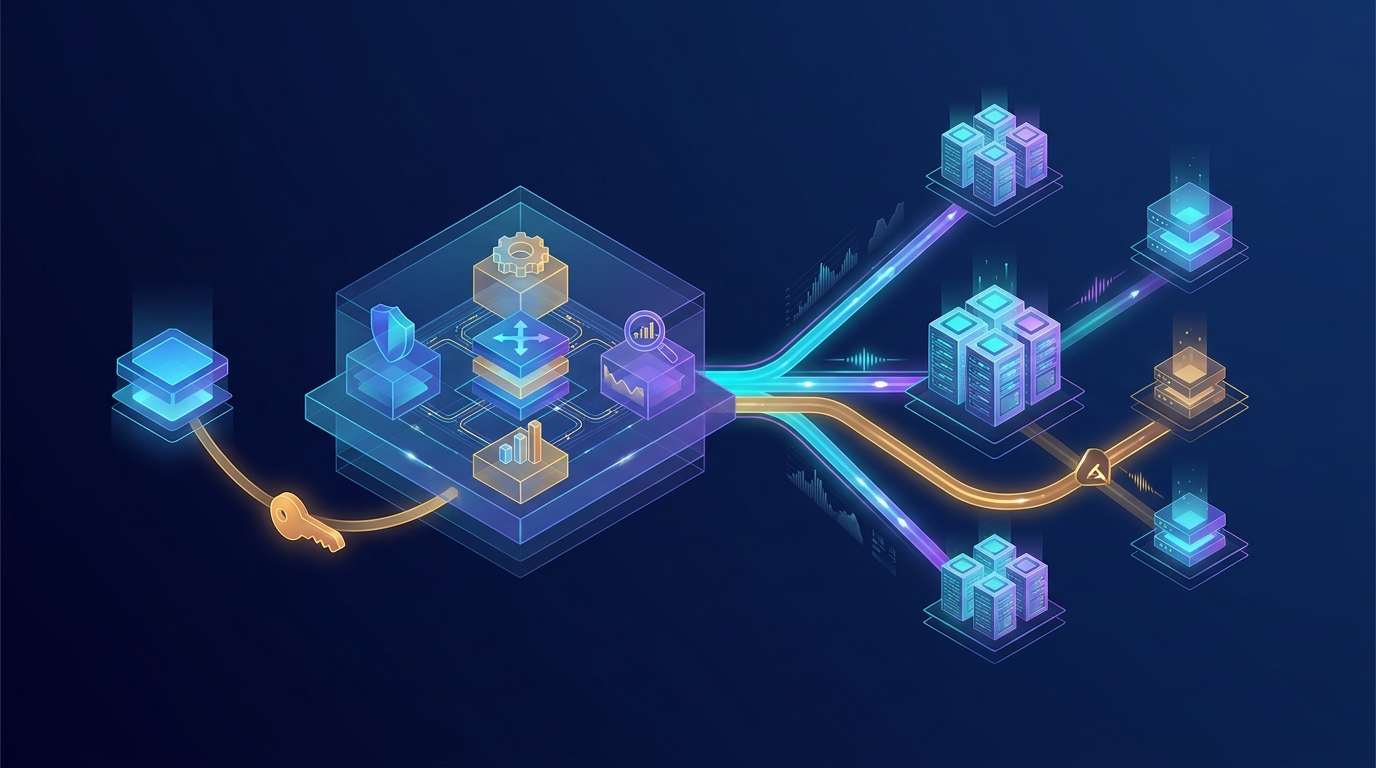
Um API gateway é um ponto de entrada único entre os clientes e seus serviços de backend: ele recebe cada requisição, aplica políticas de segurança e de tráfego e a encaminha para o serviço certo. Sua arquitetura tem duas partes: um plano de dados que processa o tráfego em tempo real (roteamento, autenticação, rate limiting, transformação, cache, logging) e um plano de controle onde você configura essas políticas. Os principais recursos a procurar são roteamento, autenticação e autorização, rate limiting, transformação de requisições e respostas, cache, observabilidade e controles de resiliência como timeouts, retries e circuit breakers.
Este guia percorre a arquitetura de um API gateway com um diagrama, explica cada componente e recurso, compara padrões de implantação e produtos comuns e mostra configuração e código funcionais. A última seção mostra como a mesma arquitetura se aplica a gateways para APIs de grandes modelos de linguagem (LLM). As informações dos produtos vêm da documentação oficial consultada em 24 de outubro de 2026.
O que é um API gateway?
Em um sistema de microsserviços, sem gateway os clientes precisariam conhecer o endereço, o protocolo e o esquema de autenticação de cada serviço. O padrão API gateway coloca um único componente na frente deles. Os clientes chamam o gateway, e o gateway decide para onde vai cada requisição e quais regras se aplicam.
Sem gateway, cada serviço reimplementa autenticação, limites de taxa e logging, e todos os clientes precisam mudar quando um serviço muda de lugar. Com um gateway, essas preocupações transversais ficam em um só lugar e os serviços podem mudar por trás de uma API pública estável.
Diagrama de arquitetura de um API gateway
 Clients (web, mobile, partners, internal jobs)
        |
        v
 [ DNS / CDN / WAF / Load balancer ]
        |
        v
 +--------------------- API GATEWAY (data plane) ---------------------+
 |  TLS termination -> AuthN/AuthZ -> Rate limit & quota ->           |
 |  Request validation & transform -> Cache lookup -> Router          |
 |  -> Timeouts / retries / circuit breaker -> Response transform     |
 |  -> Logs, metrics, traces                                          |
 +--------------------------------------------------------------------+
        |               |                 |
        v               v                 v
   Orders service   Users service   Payments service   (or Lambda, queues, LLM providers)

 Control plane: config store, admin API/UI, policy and key management, deploys config to data plane
Componentes principais
| Componente | Função |
|---|---|
| Listener / terminação TLS | Aceita conexões HTTP/1.1, HTTP/2, gRPC ou WebSocket e descriptografa o TLS |
| Autenticação e autorização | Valida API keys, tokens OAuth 2.0 / JWT ou certificados mTLS e depois verifica permissões |
| Rate limiter e cotas | Limita requisições por cliente, chave ou rota; retorna HTTP 429 quando excedido |
| Validação e transformação de requisições | Verifica schemas, reescreve caminhos e headers, converte protocolos (REST para gRPC, por exemplo) |
| Cache | Serve respostas repetidas sem chamar o backend |
| Roteador | Associa caminho, método, host ou header a um serviço upstream e faz balanceamento de carga entre instâncias |
| Camada de resiliência | Timeouts, retries com backoff, circuit breakers e fallbacks |
| Observabilidade | Logs de acesso, métricas (latência, taxa de erros) e traces distribuídos |
| Plano de controle | Armazena a configuração e a envia às instâncias do gateway; expõe uma API ou UI de administração |
Ciclo de vida de uma requisição
- O cliente envia
GET /orders/42com um bearer token. - O gateway termina o TLS e valida o token.
- Verifica o rate limit e a cota de quem está chamando.
- Valida a requisição e adiciona headers como um ID de requisição.
- Consulta o cache e, em caso de miss, roteia para uma instância saudável de
orders. - Aplica um timeout, tenta novamente uma vez em caso de erro de conexão e registra o resultado.
- Transforma a resposta se necessário e a devolve, registrando status, latência e chamador.
Principais recursos de um API gateway
Estes são os recursos de que a maioria das equipes precisa, mais ou menos em ordem de importância:
- Roteamento de requisições. Roteamento por caminho, host, método e header, além de balanceamento de carga e releases canário ou ponderados.
- Autenticação e autorização. API keys, validação OAuth 2.0 e JWT, mTLS e políticas de acesso por rota.
- Rate limiting e cotas. Limites por consumidor que protegem os backends; o HTTP 429 "Too Many Requests" é definido na RFC 6585.
- Transformação de requisições e respostas. Injeção de headers, mapeamento de payloads, tradução de protocolos e versionamento de APIs.
- Cache. Cache de respostas com TTL para reduzir a latência e a carga no backend.
- Segurança. TLS, listas de IPs permitidos e bloqueados, limites de tamanho de requisição e integração com um firewall de aplicações web.
- Observabilidade. Logs de acesso estruturados, métricas e propagação de traces para ferramentas como Grafana Tempo ou Datadog.
- Resiliência. Timeouts, retries, circuit breakers e health checks.
- Experiência do desenvolvedor. API keys e planos, um portal do desenvolvedor e análise de uso; muitas vezes agrupados como "API management".
- Monetização e medição. Contagem de uso por consumidor para cobrança ou rateio interno.
Padrões de implantação
| Padrão | Como funciona | Quando usar |
|---|---|---|
| Gateway central único | Um cluster de gateway atende todos os serviços | Sistemas pequenos a médios, uma equipe cuida da borda |
| Backend for frontend (BFF) | Um gateway separado por tipo de cliente (web, mobile, parceiro) | Os clientes precisam de APIs muito diferentes |
| Gateway por domínio | Cada domínio de negócio roda seu próprio gateway | Grandes organizações com equipes autônomas |
| Ingress do Kubernetes / Gateway API | Gateway configurado com recursos do Kubernetes | Os serviços já rodam no Kubernetes |
| Gateway mais service mesh | O gateway cuida do tráfego norte-sul (clientes); o mesh, do leste-oeste (entre serviços) | Muitos serviços internos que precisam de mTLS e políticas de tráfego |
A Kubernetes Gateway API é hoje a forma padrão de configurar gateways no Kubernetes, e implementações como o Envoy Gateway são construídas sobre ela.
API gateway vs load balancer vs service mesh
- Um load balancer distribui o tráfego entre instâncias de um mesmo serviço, principalmente no nível de rede ou HTTP, sem políticas conscientes de API.
- Um API gateway entende APIs: autentica consumidores, aplica cotas por chave, transforma payloads e roteia entre muitos serviços.
- Um service mesh gerencia o tráfego entre serviços internos, geralmente com sidecars ou proxies por nó.
A maioria dos sistemas em produção usa um load balancer na frente do gateway, e alguns adicionam um mesh atrás dele.
Produtos de API gateway populares
| Produto | Tipo | Observações (outubro de 2026) |
|---|---|---|
| Amazon API Gateway | Gerenciado (AWS) | APIs REST, HTTP e WebSocket; o nível gratuito inclui 1 milhão de chamadas REST, 1 milhão de chamadas HTTP e 1 milhão de mensagens WebSocket, além de 750.000 minutos de conexão por mês durante 12 meses |
| Kong Gateway | Código aberto e enterprise | Baseado em plugins; roda sem banco de dados (DB-less) com configuração declarativa ou com banco |
| Envoy Gateway | Código aberto | Proxy Envoy gerenciado pela Kubernetes Gateway API |
| Azure API Management | Gerenciado (Azure) | Gateways gerenciados e auto-hospedados, além de um portal do desenvolvedor |
Exemplo: configuração declarativa do Kong
Esta configuração DB-less do Kong roteia /orders para um backend, exige uma API key e limita cada consumidor a 60 requisições por minuto:
_format_version: "3.0"
services:
  - name: orders
    url: http://orders:8080
    routes:
      - name: orders-route
        paths: ["/orders"]
    plugins:
      - name: key-auth
      - name: rate-limiting
        config:
          minute: 60
          policy: local
consumers:
  - username: mobile-app
    keyauth_credentials:
      - key: replace-with-a-long-random-key
Exemplo: um gateway mínimo em Python
Para ver a arquitetura em código, aqui está um gateway pequeno e executável com autenticação por API key, rate limiting por chave, roteamento e timeout. Ele serve para aprendizado; use um gateway de produção para tráfego real.
# pip install fastapi uvicorn httpx ; run: uvicorn gateway:app --port 8080
import time, httpx
from collections import defaultdict
from fastapi import FastAPI, Request, Response, HTTPException

ROUTES = {"/orders": "http://localhost:9001", "/users": "http://localhost:9002"}
KEYS = {"key-mobile": "mobile-app"}
LIMIT_PER_MIN = 60
hits = defaultdict(list)
app = FastAPI()

@app.api_route("/{path:path}", methods=["GET", "POST", "PUT", "DELETE"])
async def gateway(path: str, request: Request):
    consumer = KEYS.get(request.headers.get("x-api-key", ""))
    if not consumer:
        raise HTTPException(401, "invalid API key")
    now = time.time()
    hits[consumer] = [t for t in hits[consumer] if now - t < 60]
    if len(hits[consumer]) >= LIMIT_PER_MIN:
        raise HTTPException(429, "rate limit exceeded", headers={"Retry-After": "60"})
    hits[consumer].append(now)
    prefix = next((p for p in ROUTES if f"/{path}".startswith(p)), None)
    if not prefix:
        raise HTTPException(404, "no route")
    async with httpx.AsyncClient(timeout=5.0) as client:
        upstream = await client.request(request.method, ROUTES[prefix] + f"/{path}"[len(prefix):],
                                        content=await request.body(),
                                        headers={"x-consumer": consumer})
    return Response(upstream.content, upstream.status_code,
                    media_type=upstream.headers.get("content-type"))
Do API gateway ao LLM gateway
Quando os backends são provedores de modelos de IA em vez de microsserviços, a mesma arquitetura se aplica, com algumas tarefas extras. Um LLM gateway (ou AI gateway) acrescenta:
| Recurso clássico do gateway | Extensão do LLM gateway |
|---|---|
| Roteamento por caminho | Roteamento por nome do modelo, custo, latência ou saúde do provedor |
| Rate limiting por requisições | Limites por tokens por minuto e gasto por chave |
| Transformação de requisições | Tradução entre os formatos de requisição da OpenAI, Anthropic e Gemini |
| Cache de respostas | Prompt caching e cache semântico |
| Retries e circuit breakers | Fallback para outro provedor ou modelo em caso de 429, 5xx ou timeout |
| Logs de acesso | Contagem de tokens, custo por requisição e modelo usado |
| API keys por consumidor | Uma chave que funciona em vários provedores, com orçamentos por equipe |
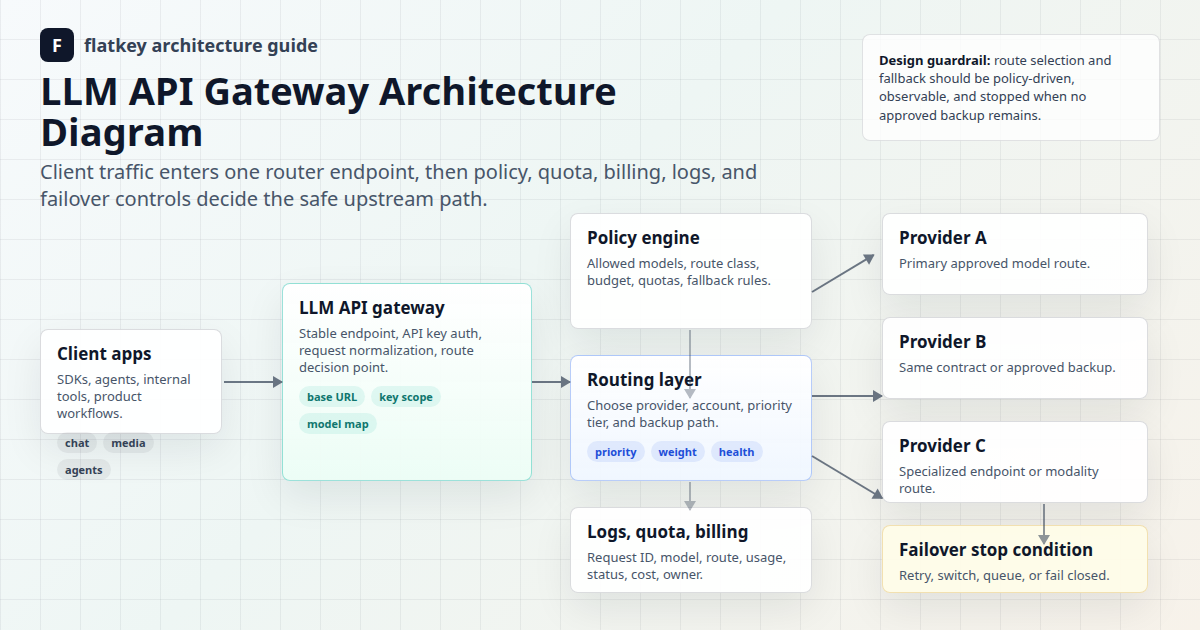
 App / agent  --OpenAI-format request-->  LLM gateway
   auth + budget check -> model map -> route (primary provider)
   -> on 429/5xx/timeout: fallback provider -> usage + cost log
   -> Anthropic / OpenAI / Google / DeepSeek / self-hosted vLLM
Você pode operar essa camada por conta própria (por exemplo, com LiteLLM ou os plugins de IA do Kong) ou usar uma gerenciada. A Flatkey é uma opção gerenciada: um endpoint compatível com OpenAI em https://router.flatkey.ai/v1, uma chave para mais de 300 modelos, logs de uso com tokens e custo por chamada e limites de gasto por chave ou grupo, segundo sua documentação de outubro de 2026. Como usa o formato da OpenAI, os clientes existentes só precisam trocar a base URL:
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"claude-sonnet-5-5","messages":[{"role":"user","content":"Summarize the API gateway pattern in one sentence."}]}'
Para um design mais aprofundado, leia nossos guias sobre arquitetura de AI API gateway e roteamento de modelos, circuit breakers para LLM gateways, AI gateway vs API management e AI gateway gerenciado vs proxy auto-hospedado. Se o tema é novo para você, o guia para iniciantes sobre LLM gateways é um bom ponto de partida, e o guia de tratamento de rate limits cobre estratégias para o 429.
Checklist de design
- Coloque TLS, autenticação e rate limiting no gateway, não em cada serviço.
- Defina um timeout em cada rota upstream; nunca espere indefinidamente.
- Tente novamente apenas requisições idempotentes (GET, PUT, DELETE conforme a RFC 9110), a menos que o backend suporte chaves de idempotência.
- Propague um ID de requisição e o contexto de trace para cada backend.
- Rode pelo menos duas instâncias do gateway atrás de um load balancer para que ele não seja um ponto único de falha.
- Mantenha a lógica de negócio fora do gateway; ele deve aplicar políticas, não implementar funcionalidades.
- Versione a configuração do gateway no git e faça o deploy como código.
Perguntas frequentes
O que é o padrão API gateway em microsserviços?
É um design em que um único gateway é o ponto de entrada de todas as requisições dos clientes. O gateway roteia cada requisição para o microsserviço certo e cuida de preocupações compartilhadas como autenticação, rate limiting e logging, para que os clientes não chamem os serviços diretamente.
Quais são os principais recursos de um API gateway?
Os recursos centrais são roteamento de requisições, autenticação e autorização, rate limiting e cotas, transformação de requisições e respostas, cache, controles de segurança, observabilidade e recursos de resiliência como timeouts, retries e circuit breakers.
Quais são os principais componentes da arquitetura de um API gateway?
Um plano de dados que processa o tráfego (listener, autenticação, rate limiter, transformador, cache, roteador, camada de resiliência e telemetria) e um plano de controle que armazena e distribui a configuração.
API gateway é a mesma coisa que load balancer?
Não. Um load balancer distribui o tráfego entre instâncias de um serviço. Um API gateway acrescenta recursos conscientes de API, como autenticação por consumidor, cotas, transformação de payloads e roteamento entre muitos serviços. A maioria dos sistemas usa os dois.
O que é um LLM gateway?
Um LLM gateway é um API gateway especializado em tráfego de modelos de IA. Ele roteia por modelo e provedor, limita por tokens e gasto, traduz entre os formatos de API dos provedores, faz fallback quando um provedor falha e registra o uso de tokens e o custo.
O API gateway é um ponto único de falha?
Pode ser, se você rodar apenas uma instância. Rode várias instâncias em diferentes zonas atrás de um load balancer, mantenha a configuração em um armazenamento replicado e monitore o próprio gateway.