APIゲートウェイのアーキテクチャと主な機能(2026年版ガイド)
APIゲートウェイは、クライアントとバックエンドサービスの間に置かれる単一のエントリポイントです。すべてのリクエストを受け取り、セキュリティとトラフィックのポリシーを適用して、適切なサービスへ転送します。 アーキテクチャは2つの部分で構成されます。ライブトラフィックを処理するデータプレーン(ルーティング、認証、レート制限、変換、キャッシュ、ログ記録)と、それらのポリシーを設定するコントロールプレーンです。注目すべき主な機能は、ルーティング、認証と認可、レート制限、リクエストとレスポンスの変換、キャッシュ、可観測性、そしてタイムアウト・リトライ・サーキットブレーカーといった耐障害性の仕組みです。
このガイドでは、図を使ってAPIゲートウェイのアーキテクチャを説明し、各コンポーネントと機能を解説し、一般的なデプロイパターンと製品を比較し、動作する設定とコードを紹介します。最後のセクションでは、同じアーキテクチャが大規模言語モデル(LLM)API向けのゲートウェイにどう適用されるかを示します。製品情報は2026年10月24日時点の公式ドキュメントに基づいています。
APIゲートウェイとは?
マイクロサービスのシステムでゲートウェイがない場合、クライアントは各サービスのアドレス、プロトコル、認証方式をすべて把握する必要があります。APIゲートウェイパターンは、それらの前に1つのコンポーネントを置きます。クライアントはゲートウェイを呼び出し、ゲートウェイが各リクエストの転送先と適用するルールを決めます。
ゲートウェイがないと、各サービスが認証、レート制限、ログ記録をそれぞれ実装し直すことになり、サービスの移動のたびにすべてのクライアントを変更しなければなりません。ゲートウェイがあれば、こうした横断的な関心事を1か所に集約でき、安定した公開APIの裏側でサービスを自由に変更できます。
APIゲートウェイのアーキテクチャ図
 Clients (web, mobile, partners, internal jobs)
        |
        v
 [ DNS / CDN / WAF / Load balancer ]
        |
        v
 +--------------------- API GATEWAY (data plane) ---------------------+
 |  TLS termination -> AuthN/AuthZ -> Rate limit & quota ->           |
 |  Request validation & transform -> Cache lookup -> Router          |
 |  -> Timeouts / retries / circuit breaker -> Response transform     |
 |  -> Logs, metrics, traces                                          |
 +--------------------------------------------------------------------+
        |               |                 |
        v               v                 v
   Orders service   Users service   Payments service   (or Lambda, queues, LLM providers)

 Control plane: config store, admin API/UI, policy and key management, deploys config to data plane
主要コンポーネント
| コンポーネント | 役割 |
|---|---|
| リスナー / TLS終端 | HTTP/1.1、HTTP/2、gRPC、WebSocketの接続を受け付け、TLSを復号する |
| 認証と認可 | APIキー、OAuth 2.0 / JWTトークン、mTLS証明書を検証し、権限を確認する |
| レートリミッターとクォータ | クライアント、キー、ルートごとにリクエストを制限し、超過時はHTTP 429を返す |
| リクエスト検証と変換 | スキーマを検証し、パスやヘッダーを書き換え、プロトコルを変換する(例:RESTからgRPC) |
| キャッシュ | 繰り返しのレスポンスをバックエンドを呼ばずに返す |
| ルーター | パス、メソッド、ホスト、ヘッダーをアップストリームサービスに対応づけ、インスタンス間で負荷分散する |
| 耐障害性レイヤー | タイムアウト、バックオフ付きリトライ、サーキットブレーカー、フォールバック |
| 可観測性 | アクセスログ、メトリクス(レイテンシ、エラー率)、分散トレース |
| コントロールプレーン | 設定を保存してゲートウェイインスタンスに配布し、管理APIやUIを提供する |
リクエストのライフサイクル
- クライアントがBearerトークン付きで
GET /orders/42を送信する。 - ゲートウェイがTLSを終端し、トークンを検証する。
- 呼び出し元のレート制限とクォータを確認する。
- リクエストを検証し、リクエストIDなどのヘッダーを追加する。
- キャッシュを確認し、ミスした場合は正常な
ordersインスタンスにルーティングする。 - タイムアウトを適用し、接続エラー時に1回リトライして結果を記録する。
- 必要に応じてレスポンスを変換して返し、ステータス、レイテンシ、呼び出し元をログに記録する。
APIゲートウェイの主な機能
多くのチームが必要とする機能を、おおよその重要度順に挙げます。
- リクエストルーティング。 パス、ホスト、メソッド、ヘッダーに基づくルーティングに加え、負荷分散とカナリアリリースや重み付きリリース。
- 認証と認可。 APIキー、OAuth 2.0とJWTの検証、mTLS、ルートごとのアクセスポリシー。
- レート制限とクォータ。 バックエンドを保護するコンシューマーごとの制限。HTTP 429「Too Many Requests」はRFC 6585で定義されています。
- リクエストとレスポンスの変換。 ヘッダーの挿入、ペイロードのマッピング、プロトコル変換、APIのバージョニング。
- キャッシュ。 TTL付きのレスポンスキャッシュでレイテンシとバックエンド負荷を削減。
- セキュリティ。 TLS、IPの許可リストと拒否リスト、リクエストサイズ制限、WAFとの連携。
- 可観測性。 構造化されたアクセスログ、メトリクス、Grafana TempoやDatadogなどへのトレース伝播。
- 耐障害性。 タイムアウト、リトライ、サーキットブレーカー、ヘルスチェック。
- 開発者体験。 APIキーとプラン、開発者ポータル、利用状況の分析。「API管理」としてまとめられることが多い機能です。
- 収益化と計測。 課金や社内配賦のためのコンシューマーごとの利用量カウント。
デプロイパターン
| パターン | 仕組み | 使いどころ |
|---|---|---|
| 単一の中央ゲートウェイ | 1つのゲートウェイクラスターがすべてのサービスを担う | 小〜中規模のシステム、エッジを1チームが管理 |
| Backend for Frontend(BFF) | クライアント種別(Web、モバイル、パートナー)ごとに別のゲートウェイ | クライアントごとに大きく異なるAPIが必要 |
| ドメインごとのゲートウェイ | 各業務ドメインが独自のゲートウェイを運用 | 自律したチームを持つ大規模組織 |
| Kubernetes Ingress / Gateway API | Kubernetesリソースでゲートウェイを設定 | サービスがすでにKubernetes上で動いている |
| ゲートウェイ+サービスメッシュ | ゲートウェイが南北(クライアント)トラフィック、メッシュが東西(サービス間)トラフィックを担当 | mTLSとトラフィックポリシーが必要な多数の内部サービス |
Kubernetes Gateway APIは現在、Kubernetesでゲートウェイを設定する標準的な方法であり、Envoy Gatewayなどの実装がその上に構築されています。
APIゲートウェイ、ロードバランサー、サービスメッシュの違い
- ロードバランサーは、主にネットワークレベルまたはHTTPレベルで、1つのサービスのインスタンス間にトラフィックを分散します。APIを意識したポリシーは持ちません。
- APIゲートウェイはAPIを理解します。コンシューマーを認証し、キーごとのクォータを適用し、ペイロードを変換し、多数のサービスにまたがってルーティングします。
- サービスメッシュは、内部サービス間のトラフィックを、通常はサイドカーやノード単位のプロキシで管理します。
本番システムの多くはゲートウェイの前にロードバランサーを置き、一部はその背後にメッシュを追加しています。
代表的なAPIゲートウェイ製品
| 製品 | 種別 | 備考(2026年10月時点) |
|---|---|---|
| Amazon API Gateway | マネージド(AWS) | REST、HTTP、WebSocket API。無料利用枠には12か月間、毎月100万回のREST呼び出し、100万回のHTTP呼び出し、100万件のWebSocketメッセージと75万分の接続時間が含まれる |
| Kong Gateway | オープンソースとエンタープライズ | プラグインベース。宣言的設定によるDBレス構成、またはデータベース併用で動作 |
| Envoy Gateway | オープンソース | Kubernetes Gateway APIで管理されるEnvoyプロキシ |
| Azure API Management | マネージド(Azure) | マネージドとセルフホストのゲートウェイ、開発者ポータル |
例:Kongの宣言的設定
このDBレスのKong設定は、/orders をバックエンドにルーティングし、APIキーを必須とし、各コンシューマーを1分あたり60リクエストに制限します。
_format_version: "3.0"
services:
  - name: orders
    url: http://orders:8080
    routes:
      - name: orders-route
        paths: ["/orders"]
    plugins:
      - name: key-auth
      - name: rate-limiting
        config:
          minute: 60
          policy: local
consumers:
  - username: mobile-app
    keyauth_credentials:
      - key: replace-with-a-long-random-key
例:Pythonによる最小構成のゲートウェイ
アーキテクチャをコードで確認するために、APIキー認証、キーごとのレート制限、ルーティング、タイムアウトを備えた小さな実行可能ゲートウェイを示します。学習用なので、実際のトラフィックには本番用ゲートウェイを使ってください。
# pip install fastapi uvicorn httpx ; run: uvicorn gateway:app --port 8080
import time, httpx
from collections import defaultdict
from fastapi import FastAPI, Request, Response, HTTPException

ROUTES = {"/orders": "http://localhost:9001", "/users": "http://localhost:9002"}
KEYS = {"key-mobile": "mobile-app"}
LIMIT_PER_MIN = 60
hits = defaultdict(list)
app = FastAPI()

@app.api_route("/{path:path}", methods=["GET", "POST", "PUT", "DELETE"])
async def gateway(path: str, request: Request):
    consumer = KEYS.get(request.headers.get("x-api-key", ""))
    if not consumer:
        raise HTTPException(401, "invalid API key")
    now = time.time()
    hits[consumer] = [t for t in hits[consumer] if now - t < 60]
    if len(hits[consumer]) >= LIMIT_PER_MIN:
        raise HTTPException(429, "rate limit exceeded", headers={"Retry-After": "60"})
    hits[consumer].append(now)
    prefix = next((p for p in ROUTES if f"/{path}".startswith(p)), None)
    if not prefix:
        raise HTTPException(404, "no route")
    async with httpx.AsyncClient(timeout=5.0) as client:
        upstream = await client.request(request.method, ROUTES[prefix] + f"/{path}"[len(prefix):],
                                        content=await request.body(),
                                        headers={"x-consumer": consumer})
    return Response(upstream.content, upstream.status_code,
                    media_type=upstream.headers.get("content-type"))
APIゲートウェイからLLMゲートウェイへ
バックエンドがマイクロサービスではなくAIモデルプロバイダーである場合も、同じアーキテクチャが当てはまりますが、追加の役割がいくつかあります。LLMゲートウェイ(AIゲートウェイ)は次の機能を加えます。
| 従来のゲートウェイ機能 | LLMゲートウェイでの拡張 |
|---|---|
| パスによるルーティング | モデル名、コスト、レイテンシ、プロバイダーの稼働状況によるルーティング |
| リクエスト数によるレート制限 | 1分あたりのトークン数とキーごとの支出による制限 |
| リクエスト変換 | OpenAI、Anthropic、Geminiのリクエスト形式間の変換 |
| レスポンスキャッシュ | プロンプトキャッシュとセマンティックキャッシュ |
| リトライとサーキットブレーカー | 429、5xx、タイムアウト時に別のプロバイダーやモデルへフォールバック |
| アクセスログ | トークン数、リクエストごとのコスト、使用モデル |
| コンシューマーごとのAPIキー | 複数プロバイダーで使える1つのキーとチームごとの予算 |
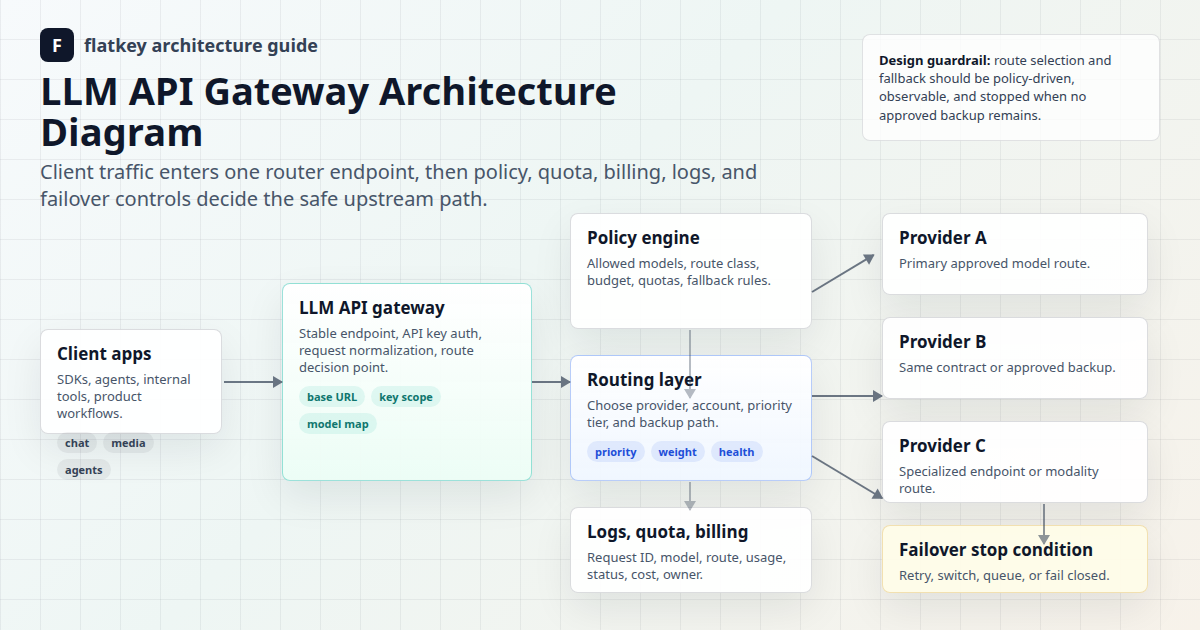
 App / agent  --OpenAI-format request-->  LLM gateway
   auth + budget check -> model map -> route (primary provider)
   -> on 429/5xx/timeout: fallback provider -> usage + cost log
   -> Anthropic / OpenAI / Google / DeepSeek / self-hosted vLLM
このレイヤーは自前で運用することも(例:LiteLLMやKongのAIプラグイン)、マネージドサービスを使うこともできます。Flatkeyはマネージドの選択肢の1つです。2026年10月時点のドキュメントによると、OpenAI互換のエンドポイント https://router.flatkey.ai/v1、300以上のモデルに使える1つのキー、呼び出しごとのトークンとコストを含む利用ログ、キーやグループ単位の支出上限を提供しています。OpenAI形式を使うため、既存のクライアントはベースURLを変えるだけで利用できます。
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"claude-sonnet-5-5","messages":[{"role":"user","content":"Summarize the API gateway pattern in one sentence."}]}'
さらに踏み込んだ設計については、AI APIゲートウェイのアーキテクチャとモデルルーティング、LLMゲートウェイのサーキットブレーカー、AIゲートウェイとAPI管理の比較、マネージドAIゲートウェイとセルフホストプロキシの比較のガイドをご覧ください。初めての方はLLMゲートウェイ入門ガイドから始めるのがおすすめです。429への対処法はレート制限への対処ガイドで解説しています。
設計チェックリスト
- TLS、認証、レート制限は各サービスではなくゲートウェイに置く。
- すべてのアップストリームルートにタイムアウトを設定し、無期限に待たない。
- バックエンドが冪等性キーをサポートしていない限り、リトライは冪等なリクエスト(RFC 9110に基づくGET、PUT、DELETE)に限定する。
- リクエストIDとトレースコンテキストをすべてのバックエンドに伝播する。
- ゲートウェイが単一障害点にならないよう、ロードバランサーの背後で少なくとも2つのインスタンスを動かす。
- ビジネスロジックはゲートウェイに入れない。ゲートウェイはポリシーを適用する場所であり、機能を実装する場所ではない。
- ゲートウェイの設定はgitでバージョン管理し、コードとしてデプロイする。
よくある質問
マイクロサービスにおけるAPIゲートウェイパターンとは?
単一のゲートウェイをすべてのクライアントリクエストのエントリポイントとする設計です。ゲートウェイが各リクエストを適切なマイクロサービスにルーティングし、認証、レート制限、ログ記録などの共通の関心事を処理するため、クライアントはサービスを直接呼び出しません。
APIゲートウェイの主な機能は?
中核となる機能は、リクエストルーティング、認証と認可、レート制限とクォータ、リクエストとレスポンスの変換、キャッシュ、セキュリティ制御、可観測性、そしてタイムアウト・リトライ・サーキットブレーカーなどの耐障害性機能です。
APIゲートウェイのアーキテクチャの主要コンポーネントは?
トラフィックを処理するデータプレーン(リスナー、認証、レートリミッター、トランスフォーマー、キャッシュ、ルーター、耐障害性レイヤー、テレメトリ)と、設定を保存・配布するコントロールプレーンです。
APIゲートウェイはロードバランサーと同じですか?
いいえ。ロードバランサーは1つのサービスのインスタンス間でトラフィックを分散します。APIゲートウェイは、コンシューマーごとの認証、クォータ、ペイロード変換、多数のサービスにまたがるルーティングなど、APIを意識した機能を加えます。多くのシステムでは両方を使います。
LLMゲートウェイとは?
LLMゲートウェイは、AIモデルのトラフィックに特化したAPIゲートウェイです。モデルとプロバイダーでルーティングし、トークンと支出で制限し、プロバイダーのAPI形式間を変換し、プロバイダー障害時にフォールバックし、トークン使用量とコストを記録します。
APIゲートウェイは単一障害点になりますか?
インスタンスを1つしか動かしていなければ、なり得ます。複数のゾーンで複数のインスタンスをロードバランサーの背後に置き、設定をレプリケートされたストアに保存し、ゲートウェイ自体を監視してください。