Arquitectura de un API gateway y funciones clave (guía 2026)
Un API gateway es un punto de entrada único situado entre los clientes y tus servicios backend: recibe cada solicitud, aplica políticas de seguridad y de tráfico y la enruta al servicio correcto. Su arquitectura tiene dos partes: un plano de datos que gestiona el tráfico en vivo (enrutamiento, autenticación, limitación de tasa, transformación, caché, logging) y un plano de control donde configuras esas políticas. Las funciones clave que debes buscar son enrutamiento, autenticación y autorización, limitación de tasa, transformación de solicitudes y respuestas, caché, observabilidad y controles de resiliencia como timeouts, reintentos y circuit breakers.
Esta guía recorre la arquitectura de un API gateway con un diagrama, explica cada componente y función, compara los patrones de despliegue y productos más comunes y muestra configuración y código funcionales. La última sección explica cómo se aplica la misma arquitectura a los gateways para APIs de modelos de lenguaje (LLM). Los datos de productos proceden de la documentación oficial consultada el 24 de octubre de 2026.
¿Qué es un API gateway?
En un sistema de microservicios, sin gateway los clientes tendrían que conocer la dirección, el protocolo y el esquema de autenticación de cada servicio. El patrón API gateway coloca un único componente delante de todos ellos. Los clientes llaman al gateway, y el gateway decide adónde va cada solicitud y qué reglas se aplican.
Sin gateway, cada servicio vuelve a implementar autenticación, límites de tasa y logging, y todos los clientes tienen que cambiar cuando un servicio se mueve. Con un gateway, esas responsabilidades transversales viven en un solo lugar y los servicios pueden cambiar detrás de una API pública estable.
Diagrama de arquitectura de un API gateway
 Clients (web, mobile, partners, internal jobs)
        |
        v
 [ DNS / CDN / WAF / Load balancer ]
        |
        v
 +--------------------- API GATEWAY (data plane) ---------------------+
 |  TLS termination -> AuthN/AuthZ -> Rate limit & quota ->           |
 |  Request validation & transform -> Cache lookup -> Router          |
 |  -> Timeouts / retries / circuit breaker -> Response transform     |
 |  -> Logs, metrics, traces                                          |
 +--------------------------------------------------------------------+
        |               |                 |
        v               v                 v
   Orders service   Users service   Payments service   (or Lambda, queues, LLM providers)

 Control plane: config store, admin API/UI, policy and key management, deploys config to data plane
Componentes principales
| Componente | Función |
|---|---|
| Listener / terminación TLS | Acepta conexiones HTTP/1.1, HTTP/2, gRPC o WebSocket y descifra TLS |
| Autenticación y autorización | Valida API keys, tokens OAuth 2.0 / JWT o certificados mTLS y luego comprueba permisos |
| Limitador de tasa y cuotas | Limita las solicitudes por cliente, key o ruta; devuelve HTTP 429 al superarse |
| Validación y transformación de solicitudes | Comprueba esquemas, reescribe rutas y cabeceras, convierte protocolos (por ejemplo, REST a gRPC) |
| Caché | Sirve respuestas repetidas sin llamar al backend |
| Router | Asocia ruta, método, host o cabecera con un servicio upstream y balancea la carga entre instancias |
| Capa de resiliencia | Timeouts, reintentos con backoff, circuit breakers y fallbacks |
| Observabilidad | Logs de acceso, métricas (latencia, tasa de errores) y trazas distribuidas |
| Plano de control | Almacena la configuración y la distribuye a las instancias del gateway; expone una API o UI de administración |
Ciclo de vida de una solicitud
- El cliente envía
GET /orders/42con un bearer token. - El gateway termina TLS y valida el token.
- Comprueba el límite de tasa y la cuota del llamante.
- Valida la solicitud y añade cabeceras como un ID de solicitud.
- Consulta la caché y, si no hay acierto, enruta a una instancia sana de
orders. - Aplica un timeout, reintenta una vez ante un error de conexión y registra el resultado.
- Transforma la respuesta si hace falta y la devuelve, registrando estado, latencia y llamante.
Funciones clave de un API gateway
Estas son las funciones que necesita la mayoría de los equipos, más o menos por orden de importancia:
- Enrutamiento de solicitudes. Enrutamiento por ruta, host, método y cabecera, además de balanceo de carga y despliegues canary o ponderados.
- Autenticación y autorización. API keys, validación OAuth 2.0 y JWT, mTLS y políticas de acceso por ruta.
- Limitación de tasa y cuotas. Límites por consumidor que protegen los backends; el código HTTP 429 "Too Many Requests" se define en el RFC 6585.
- Transformación de solicitudes y respuestas. Inyección de cabeceras, mapeo de payloads, traducción de protocolos y versionado de APIs.
- Caché. Caché de respuestas con TTL para reducir la latencia y la carga del backend.
- Seguridad. TLS, listas de IP permitidas y bloqueadas, límites de tamaño de solicitud e integración con un firewall de aplicaciones web.
- Observabilidad. Logs de acceso estructurados, métricas y propagación de trazas a herramientas como Grafana Tempo o Datadog.
- Resiliencia. Timeouts, reintentos, circuit breakers y health checks.
- Experiencia de desarrollador. API keys y planes, un portal para desarrolladores y analítica de uso; a menudo se agrupan como "API management".
- Monetización y medición. Conteo de uso por consumidor para facturación o reparto interno de costes.
Patrones de despliegue
| Patrón | Cómo funciona | Cuándo usarlo |
|---|---|---|
| Gateway central único | Un clúster de gateway atiende a todos los servicios | Sistemas pequeños o medianos, un equipo gestiona el borde |
| Backend for frontend (BFF) | Un gateway distinto por tipo de cliente (web, móvil, partners) | Los clientes necesitan APIs muy diferentes |
| Gateway por dominio | Cada dominio de negocio ejecuta su propio gateway | Grandes organizaciones con equipos autónomos |
| Ingress de Kubernetes / Gateway API | Gateway configurado con recursos de Kubernetes | Los servicios ya se ejecutan en Kubernetes |
| Gateway más service mesh | El gateway gestiona el tráfico norte-sur (clientes); el mesh, el este-oeste (entre servicios) | Muchos servicios internos que necesitan mTLS y políticas de tráfico |
La Kubernetes Gateway API es ahora la forma estándar de configurar gateways en Kubernetes, e implementaciones como Envoy Gateway se basan en ella.
API gateway vs balanceador de carga vs service mesh
- Un balanceador de carga reparte el tráfico entre instancias de un mismo servicio, sobre todo a nivel de red o HTTP, sin políticas conscientes de la API.
- Un API gateway entiende de APIs: autentica a los consumidores, aplica cuotas por key, transforma payloads y enruta entre muchos servicios.
- Un service mesh gestiona el tráfico entre servicios internos, normalmente con sidecars o proxies por nodo.
La mayoría de los sistemas en producción usan un balanceador de carga delante del gateway, y algunos añaden un mesh detrás.
Productos de API gateway populares
| Producto | Tipo | Notas (octubre de 2026) |
|---|---|---|
| Amazon API Gateway | Gestionado (AWS) | APIs REST, HTTP y WebSocket; la capa gratuita incluye 1 millón de llamadas REST, 1 millón de llamadas HTTP y 1 millón de mensajes WebSocket más 750.000 minutos de conexión al mes durante 12 meses |
| Kong Gateway | Código abierto y enterprise | Basado en plugins; funciona sin base de datos (DB-less) con configuración declarativa o con base de datos |
| Envoy Gateway | Código abierto | Proxy Envoy gestionado mediante la Kubernetes Gateway API |
| Azure API Management | Gestionado (Azure) | Gateways gestionados y autoalojados más un portal para desarrolladores |
Ejemplo: configuración declarativa de Kong
Esta configuración DB-less de Kong enruta /orders a un backend, exige una API key y limita a cada consumidor a 60 solicitudes por minuto:
_format_version: "3.0"
services:
  - name: orders
    url: http://orders:8080
    routes:
      - name: orders-route
        paths: ["/orders"]
    plugins:
      - name: key-auth
      - name: rate-limiting
        config:
          minute: 60
          policy: local
consumers:
  - username: mobile-app
    keyauth_credentials:
      - key: replace-with-a-long-random-key
Ejemplo: un gateway mínimo en Python
Para ver la arquitectura en código, aquí tienes un gateway pequeño y ejecutable con autenticación por API key, limitación de tasa por key, enrutamiento y timeout. Es para aprender; usa un gateway de producción para tráfico real.
# pip install fastapi uvicorn httpx ; run: uvicorn gateway:app --port 8080
import time, httpx
from collections import defaultdict
from fastapi import FastAPI, Request, Response, HTTPException

ROUTES = {"/orders": "http://localhost:9001", "/users": "http://localhost:9002"}
KEYS = {"key-mobile": "mobile-app"}
LIMIT_PER_MIN = 60
hits = defaultdict(list)
app = FastAPI()

@app.api_route("/{path:path}", methods=["GET", "POST", "PUT", "DELETE"])
async def gateway(path: str, request: Request):
    consumer = KEYS.get(request.headers.get("x-api-key", ""))
    if not consumer:
        raise HTTPException(401, "invalid API key")
    now = time.time()
    hits[consumer] = [t for t in hits[consumer] if now - t < 60]
    if len(hits[consumer]) >= LIMIT_PER_MIN:
        raise HTTPException(429, "rate limit exceeded", headers={"Retry-After": "60"})
    hits[consumer].append(now)
    prefix = next((p for p in ROUTES if f"/{path}".startswith(p)), None)
    if not prefix:
        raise HTTPException(404, "no route")
    async with httpx.AsyncClient(timeout=5.0) as client:
        upstream = await client.request(request.method, ROUTES[prefix] + f"/{path}"[len(prefix):],
                                        content=await request.body(),
                                        headers={"x-consumer": consumer})
    return Response(upstream.content, upstream.status_code,
                    media_type=upstream.headers.get("content-type"))
Del API gateway al LLM gateway
Cuando los backends son proveedores de modelos de IA en lugar de microservicios, se aplica la misma arquitectura con algunas tareas adicionales. Un LLM gateway (o AI gateway) añade:
| Función clásica del gateway | Extensión del LLM gateway |
|---|---|
| Enrutamiento por ruta | Enrutamiento por nombre de modelo, coste, latencia o estado del proveedor |
| Limitación por solicitudes | Límites por tokens por minuto y gasto por key |
| Transformación de solicitudes | Traducción entre los formatos de solicitud de OpenAI, Anthropic y Gemini |
| Caché de respuestas | Prompt caching y caché semántica |
| Reintentos y circuit breakers | Fallback a otro proveedor o modelo ante 429, 5xx o timeout |
| Logs de acceso | Número de tokens, coste por solicitud y modelo usado |
| API keys por consumidor | Una sola key válida para muchos proveedores, con presupuestos por equipo |
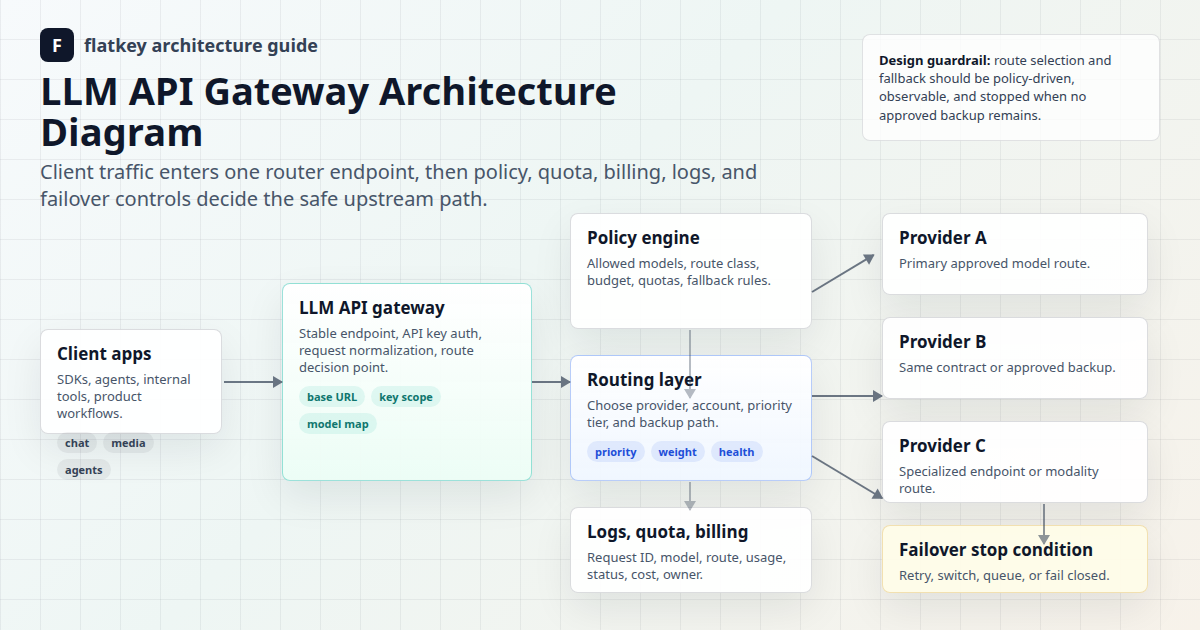
 App / agent  --OpenAI-format request-->  LLM gateway
   auth + budget check -> model map -> route (primary provider)
   -> on 429/5xx/timeout: fallback provider -> usage + cost log
   -> Anthropic / OpenAI / Google / DeepSeek / self-hosted vLLM
Puedes operar esta capa tú mismo (por ejemplo, con LiteLLM o los plugins de IA de Kong) o usar una gestionada. Flatkey es una opción gestionada: un endpoint compatible con OpenAI en https://router.flatkey.ai/v1, una sola key para más de 300 modelos, logs de uso con tokens y coste por llamada, y límites de gasto por key o grupo, según su documentación de octubre de 2026. Como habla el formato de OpenAI, los clientes existentes solo cambian la base URL:
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"claude-sonnet-5-5","messages":[{"role":"user","content":"Summarize the API gateway pattern in one sentence."}]}'
Para un diseño más profundo, lee nuestras guías sobre arquitectura de AI API gateway y enrutamiento de modelos, circuit breakers para LLM gateways, AI gateway vs API management y AI gateway gestionado vs proxy autoalojado. Si eres nuevo en el tema, la guía para principiantes sobre LLM gateways es un buen punto de partida, y la guía de gestión de límites de tasa cubre estrategias para el 429.
Checklist de diseño
- Coloca TLS, autenticación y limitación de tasa en el gateway, no en cada servicio.
- Define un timeout en cada ruta upstream; nunca esperes indefinidamente.
- Reintenta solo solicitudes idempotentes (GET, PUT, DELETE según el RFC 9110) salvo que el backend admita claves de idempotencia.
- Propaga un ID de solicitud y el contexto de traza a cada backend.
- Ejecuta al menos dos instancias del gateway detrás de un balanceador para que no sea un punto único de fallo.
- Mantén la lógica de negocio fuera del gateway; debe aplicar políticas, no implementar funcionalidades.
- Versiona la configuración del gateway en git y despliégala como código.
Preguntas frecuentes
¿Qué es el patrón API gateway en microservicios?
Es un diseño en el que un único gateway es el punto de entrada de todas las solicitudes de los clientes. El gateway enruta cada solicitud al microservicio correcto y gestiona aspectos compartidos como la autenticación, la limitación de tasa y el logging, de modo que los clientes no llaman directamente a los servicios.
¿Cuáles son las funciones clave de un API gateway?
Las funciones principales son enrutamiento de solicitudes, autenticación y autorización, limitación de tasa y cuotas, transformación de solicitudes y respuestas, caché, controles de seguridad, observabilidad y funciones de resiliencia como timeouts, reintentos y circuit breakers.
¿Cuáles son los componentes principales de la arquitectura de un API gateway?
Un plano de datos que procesa el tráfico (listener, autenticación, limitador de tasa, transformador, caché, router, capa de resiliencia y telemetría) y un plano de control que almacena y distribuye la configuración.
¿Un API gateway es lo mismo que un balanceador de carga?
No. Un balanceador de carga reparte el tráfico entre instancias de un servicio. Un API gateway añade funciones conscientes de la API, como autenticación por consumidor, cuotas, transformación de payloads y enrutamiento entre muchos servicios. La mayoría de los sistemas usan ambos.
¿Qué es un LLM gateway?
Un LLM gateway es un API gateway especializado en tráfico de modelos de IA. Enruta por modelo y proveedor, limita por tokens y gasto, traduce entre los formatos de API de los proveedores, hace fallback cuando un proveedor falla y registra el uso de tokens y el coste.
¿Es el API gateway un punto único de fallo?
Puede serlo si ejecutas una sola instancia. Ejecuta varias instancias en distintas zonas detrás de un balanceador de carga, guarda la configuración en un almacén replicado y monitoriza el propio gateway.
Fuentes
- Patrón API gateway, microservices.io
- Guía para desarrolladores de Amazon API Gateway y precios (octubre de 2026)
- Documentación de Kong Gateway (octubre de 2026)
- Envoy Gateway y Kubernetes Gateway API
- Descripción general de los gateways de Azure API Management
- RFC 6585 (HTTP 429) y RFC 9110 (semántica HTTP)