Architecture d'une API gateway et fonctionnalités clés (guide 2026)
Une API gateway est un point d'entrée unique placé entre les clients et vos services backend : elle reçoit chaque requête, applique les politiques de sécurité et de trafic, puis la route vers le bon service. Son architecture comporte deux parties : un plan de données qui traite le trafic en temps réel (routage, authentification, limitation de débit, transformation, cache, journalisation) et un plan de contrôle où vous configurez ces politiques. Les fonctionnalités clés à rechercher sont le routage, l'authentification et l'autorisation, la limitation de débit, la transformation des requêtes et des réponses, le cache, l'observabilité et les mécanismes de résilience comme les timeouts, les nouvelles tentatives et les circuit breakers.
Ce guide présente l'architecture d'une API gateway avec un schéma, explique chaque composant et fonctionnalité, compare les modèles de déploiement et produits courants, et fournit une configuration et du code fonctionnels. La dernière section montre comment la même architecture s'applique aux passerelles pour les API de grands modèles de langage (LLM). Les informations produits proviennent de la documentation officielle consultée le 24 octobre 2026.
Qu'est-ce qu'une API gateway ?
Dans un système de microservices, sans passerelle, les clients devraient connaître l'adresse, le protocole et le mode d'authentification de chaque service. Le pattern API gateway place un composant unique devant eux. Les clients appellent la passerelle, qui décide où va chaque requête et quelles règles s'appliquent.
Sans passerelle, chaque service réimplémente l'authentification, les limites de débit et la journalisation, et chaque client doit être modifié quand un service change d'emplacement. Avec une passerelle, ces préoccupations transverses sont centralisées et les services peuvent évoluer derrière une API publique stable.
Schéma d'architecture d'une API gateway
 Clients (web, mobile, partners, internal jobs)
        |
        v
 [ DNS / CDN / WAF / Load balancer ]
        |
        v
 +--------------------- API GATEWAY (data plane) ---------------------+
 |  TLS termination -> AuthN/AuthZ -> Rate limit & quota ->           |
 |  Request validation & transform -> Cache lookup -> Router          |
 |  -> Timeouts / retries / circuit breaker -> Response transform     |
 |  -> Logs, metrics, traces                                          |
 +--------------------------------------------------------------------+
        |               |                 |
        v               v                 v
   Orders service   Users service   Payments service   (or Lambda, queues, LLM providers)

 Control plane: config store, admin API/UI, policy and key management, deploys config to data plane
Composants principaux
| Composant | Rôle |
|---|---|
| Listener / terminaison TLS | Accepte les connexions HTTP/1.1, HTTP/2, gRPC ou WebSocket et déchiffre le TLS |
| Authentification et autorisation | Valide les clés API, les jetons OAuth 2.0 / JWT ou les certificats mTLS, puis vérifie les permissions |
| Limiteur de débit et quotas | Plafonne les requêtes par client, clé ou route ; renvoie HTTP 429 en cas de dépassement |
| Validation et transformation des requêtes | Vérifie les schémas, réécrit chemins et en-têtes, convertit les protocoles (REST vers gRPC, par exemple) |
| Cache | Sert les réponses répétées sans appeler le backend |
| Routeur | Associe chemin, méthode, hôte ou en-tête à un service amont et répartit la charge entre les instances |
| Couche de résilience | Timeouts, nouvelles tentatives avec backoff, circuit breakers et fallbacks |
| Observabilité | Logs d'accès, métriques (latence, taux d'erreur) et traces distribuées |
| Plan de contrôle | Stocke la configuration et la pousse vers les instances de la passerelle ; expose une API ou une interface d'administration |
Cycle de vie d'une requête
- Le client envoie
GET /orders/42avec un bearer token. - La passerelle termine le TLS et valide le jeton.
- Elle vérifie la limite de débit et le quota de l'appelant.
- Elle valide la requête et ajoute des en-têtes comme un identifiant de requête.
- Elle consulte le cache et, en cas d'absence, route vers une instance
orderssaine. - Elle applique un timeout, réessaie une fois en cas d'erreur de connexion et enregistre le résultat.
- Elle transforme la réponse si nécessaire et la renvoie, en journalisant le statut, la latence et l'appelant.
Fonctionnalités clés d'une API gateway
Voici les fonctionnalités dont la plupart des équipes ont besoin, à peu près par ordre d'importance :
- Routage des requêtes. Routage par chemin, hôte, méthode et en-tête, plus répartition de charge et déploiements canary ou pondérés.
- Authentification et autorisation. Clés API, validation OAuth 2.0 et JWT, mTLS et politiques d'accès par route.
- Limitation de débit et quotas. Limites par consommateur qui protègent les backends ; le code HTTP 429 « Too Many Requests » est défini dans la RFC 6585.
- Transformation des requêtes et des réponses. Injection d'en-têtes, mappage des payloads, traduction de protocoles et versionnage des API.
- Cache. Mise en cache des réponses avec TTL pour réduire la latence et la charge des backends.
- Sécurité. TLS, listes d'IP autorisées et bloquées, limites de taille des requêtes et intégration avec un pare-feu applicatif web.
- Observabilité. Logs d'accès structurés, métriques et propagation des traces vers des outils comme Grafana Tempo ou Datadog.
- Résilience. Timeouts, nouvelles tentatives, circuit breakers et health checks.
- Expérience développeur. Clés API et formules, portail développeur et analytique d'usage ; souvent regroupés sous le terme « API management ».
- Monétisation et mesure. Comptage de l'usage par consommateur pour la facturation ou la refacturation interne.
Modèles de déploiement
| Modèle | Fonctionnement | Quand l'utiliser |
|---|---|---|
| Passerelle centrale unique | Un cluster de passerelle unique dessert tous les services | Systèmes petits à moyens, une seule équipe gère la périphérie |
| Backend for frontend (BFF) | Une passerelle distincte par type de client (web, mobile, partenaire) | Les clients ont besoin d'API très différentes |
| Passerelle par domaine | Chaque domaine métier exploite sa propre passerelle | Grandes organisations avec des équipes autonomes |
| Ingress Kubernetes / Gateway API | Passerelle configurée via des ressources Kubernetes | Les services tournent déjà sur Kubernetes |
| Passerelle plus service mesh | La passerelle gère le trafic nord-sud (clients) ; le mesh gère l'est-ouest (entre services) | Nombreux services internes nécessitant mTLS et politiques de trafic |
La Kubernetes Gateway API est désormais la méthode standard pour configurer des passerelles sur Kubernetes, et des implémentations comme Envoy Gateway s'appuient dessus.
API gateway vs load balancer vs service mesh
- Un load balancer répartit le trafic entre les instances d'un même service, surtout au niveau réseau ou HTTP, sans politique liée aux API.
- Une API gateway comprend les API : elle authentifie les consommateurs, applique des quotas par clé, transforme les payloads et route entre de nombreux services.
- Un service mesh gère le trafic entre services internes, généralement via des sidecars ou des proxys par nœud.
La plupart des systèmes en production placent un load balancer devant la passerelle, et certains ajoutent un mesh derrière.
Produits d'API gateway populaires
| Produit | Type | Remarques (octobre 2026) |
|---|---|---|
| Amazon API Gateway | Managé (AWS) | API REST, HTTP et WebSocket ; l'offre gratuite inclut 1 million d'appels REST, 1 million d'appels HTTP et 1 million de messages WebSocket, plus 750 000 minutes de connexion par mois pendant 12 mois |
| Kong Gateway | Open source et entreprise | Basé sur des plugins ; fonctionne sans base de données (DB-less) avec une configuration déclarative ou avec une base |
| Envoy Gateway | Open source | Proxy Envoy géré via la Kubernetes Gateway API |
| Azure API Management | Managé (Azure) | Passerelles managées et auto-hébergées, plus un portail développeur |
Exemple : configuration déclarative Kong
Cette configuration Kong DB-less route /orders vers un backend, exige une clé API et limite chaque consommateur à 60 requêtes par minute :
_format_version: "3.0"
services:
  - name: orders
    url: http://orders:8080
    routes:
      - name: orders-route
        paths: ["/orders"]
    plugins:
      - name: key-auth
      - name: rate-limiting
        config:
          minute: 60
          policy: local
consumers:
  - username: mobile-app
    keyauth_credentials:
      - key: replace-with-a-long-random-key
Exemple : une passerelle minimale en Python
Pour voir l'architecture en code, voici une petite passerelle exécutable avec authentification par clé API, limitation de débit par clé, routage et timeout. Elle sert à apprendre ; utilisez une passerelle de production pour le trafic réel.
# pip install fastapi uvicorn httpx ; run: uvicorn gateway:app --port 8080
import time, httpx
from collections import defaultdict
from fastapi import FastAPI, Request, Response, HTTPException

ROUTES = {"/orders": "http://localhost:9001", "/users": "http://localhost:9002"}
KEYS = {"key-mobile": "mobile-app"}
LIMIT_PER_MIN = 60
hits = defaultdict(list)
app = FastAPI()

@app.api_route("/{path:path}", methods=["GET", "POST", "PUT", "DELETE"])
async def gateway(path: str, request: Request):
    consumer = KEYS.get(request.headers.get("x-api-key", ""))
    if not consumer:
        raise HTTPException(401, "invalid API key")
    now = time.time()
    hits[consumer] = [t for t in hits[consumer] if now - t < 60]
    if len(hits[consumer]) >= LIMIT_PER_MIN:
        raise HTTPException(429, "rate limit exceeded", headers={"Retry-After": "60"})
    hits[consumer].append(now)
    prefix = next((p for p in ROUTES if f"/{path}".startswith(p)), None)
    if not prefix:
        raise HTTPException(404, "no route")
    async with httpx.AsyncClient(timeout=5.0) as client:
        upstream = await client.request(request.method, ROUTES[prefix] + f"/{path}"[len(prefix):],
                                        content=await request.body(),
                                        headers={"x-consumer": consumer})
    return Response(upstream.content, upstream.status_code,
                    media_type=upstream.headers.get("content-type"))
De l'API gateway à la passerelle LLM
Lorsque les backends sont des fournisseurs de modèles d'IA plutôt que des microservices, la même architecture s'applique, avec quelques tâches supplémentaires. Une passerelle LLM (ou AI gateway) ajoute :
| Fonctionnalité classique | Extension de la passerelle LLM |
|---|---|
| Routage par chemin | Routage par nom de modèle, coût, latence ou santé du fournisseur |
| Limitation par requêtes | Limites en tokens par minute et en dépenses par clé |
| Transformation des requêtes | Traduction entre les formats de requête OpenAI, Anthropic et Gemini |
| Cache des réponses | Prompt caching et cache sémantique |
| Nouvelles tentatives et circuit breakers | Bascule vers un autre fournisseur ou modèle en cas de 429, 5xx ou timeout |
| Logs d'accès | Nombre de tokens, coût par requête et modèle utilisé |
| Clés API par consommateur | Une seule clé pour de nombreux fournisseurs, avec des budgets par équipe |
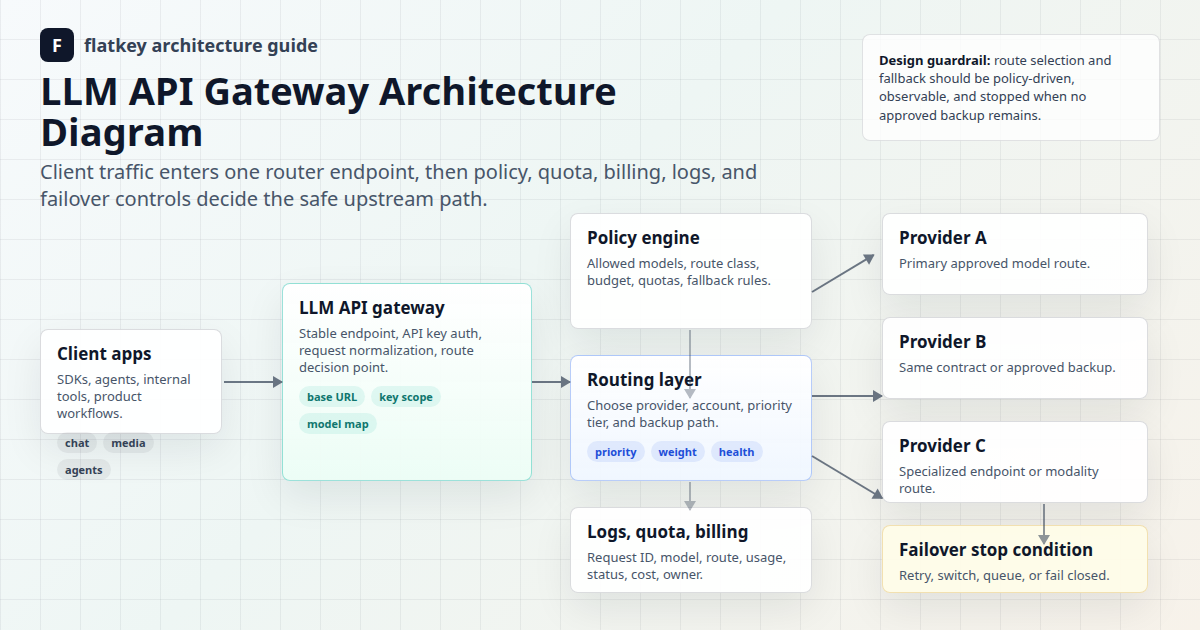
 App / agent  --OpenAI-format request-->  LLM gateway
   auth + budget check -> model map -> route (primary provider)
   -> on 429/5xx/timeout: fallback provider -> usage + cost log
   -> Anthropic / OpenAI / Google / DeepSeek / self-hosted vLLM
Vous pouvez exploiter cette couche vous-même (par exemple avec LiteLLM ou les plugins IA de Kong) ou utiliser une solution managée. Flatkey est une option managée : un endpoint compatible OpenAI à l'adresse https://router.flatkey.ai/v1, une seule clé pour plus de 300 modèles, des logs d'usage avec tokens et coût par appel, et des plafonds de dépenses par clé ou par groupe, selon sa documentation d'octobre 2026. Comme elle utilise le format OpenAI, les clients existants n'ont qu'à changer la base URL :
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"claude-sonnet-5-5","messages":[{"role":"user","content":"Summarize the API gateway pattern in one sentence."}]}'
Pour approfondir la conception, lisez nos guides sur l'architecture d'AI API gateway et le routage des modèles, les circuit breakers pour passerelles LLM, AI gateway vs API management et passerelle IA managée vs proxy auto-hébergé. Si vous découvrez le sujet, le guide du débutant sur les passerelles LLM est un bon point de départ, et le guide de gestion des limites de débit couvre les stratégies face aux erreurs 429.
Checklist de conception
- Placez TLS, authentification et limitation de débit dans la passerelle, pas dans chaque service.
- Définissez un timeout sur chaque route amont ; n'attendez jamais indéfiniment.
- Ne réessayez que les requêtes idempotentes (GET, PUT, DELETE selon la RFC 9110), sauf si le backend prend en charge les clés d'idempotence.
- Propagez un identifiant de requête et le contexte de trace vers chaque backend.
- Exécutez au moins deux instances de la passerelle derrière un load balancer pour qu'elle ne soit pas un point de défaillance unique.
- Gardez la logique métier hors de la passerelle ; elle doit appliquer des politiques, pas implémenter des fonctionnalités.
- Versionnez la configuration de la passerelle dans git et déployez-la comme du code.
FAQ
Qu'est-ce que le pattern API gateway dans les microservices ?
C'est une conception dans laquelle une passerelle unique est le point d'entrée de toutes les requêtes clientes. La passerelle route chaque requête vers le bon microservice et gère les aspects communs comme l'authentification, la limitation de débit et la journalisation, de sorte que les clients n'appellent pas directement les services.
Quelles sont les fonctionnalités clés d'une API gateway ?
Les fonctionnalités essentielles sont le routage des requêtes, l'authentification et l'autorisation, la limitation de débit et les quotas, la transformation des requêtes et des réponses, le cache, les contrôles de sécurité, l'observabilité et les fonctions de résilience comme les timeouts, les nouvelles tentatives et les circuit breakers.
Quels sont les principaux composants de l'architecture d'une API gateway ?
Un plan de données qui traite le trafic (listener, authentification, limiteur de débit, transformateur, cache, routeur, couche de résilience et télémétrie) et un plan de contrôle qui stocke et distribue la configuration.
Une API gateway est-elle la même chose qu'un load balancer ?
Non. Un load balancer répartit le trafic entre les instances d'un service. Une API gateway ajoute des fonctionnalités liées aux API comme l'authentification par consommateur, les quotas, la transformation des payloads et le routage entre de nombreux services. La plupart des systèmes utilisent les deux.
Qu'est-ce qu'une passerelle LLM ?
Une passerelle LLM est une API gateway spécialisée dans le trafic des modèles d'IA. Elle route par modèle et par fournisseur, limite par tokens et par dépenses, traduit entre les formats d'API des fournisseurs, bascule en cas de panne d'un fournisseur et journalise l'usage des tokens et les coûts.
L'API gateway est-elle un point de défaillance unique ?
Elle peut l'être si vous n'exécutez qu'une seule instance. Exécutez plusieurs instances réparties sur plusieurs zones derrière un load balancer, stockez la configuration dans un magasin répliqué et surveillez la passerelle elle-même.