API 网关架构与核心功能(2026 指南)
API 网关是位于客户端与后端服务之间的统一入口:它接收每一个请求,执行安全和流量策略,再把请求路由到正确的服务。 它的架构分为两部分:处理实时流量(路由、认证、限流、转换、缓存、日志)的数据平面,以及用于配置这些策略的控制平面。需要重点关注的核心功能包括:路由、认证与授权、限流、请求与响应转换、缓存、可观测性,以及超时、重试、熔断等弹性控制。
本文结合架构图讲解 API 网关架构,逐一解释各组件和功能,对比常见部署模式与产品,并给出可运行的配置和代码。最后一节介绍同一架构如何应用于大语言模型(LLM)API 网关。产品信息来自官方文档,查询日期为 2026 年 10 月 24 日。
什么是 API 网关?
在微服务系统中,如果没有网关,客户端就需要知道每个服务的地址、协议和认证方式。API 网关模式在这些服务前面放置一个统一组件。客户端只调用网关,由网关决定每个请求去往哪里、适用哪些规则。
没有网关时,每个服务都要重复实现认证、限流和日志,而且服务一旦迁移,所有客户端都得跟着改。有了网关,这些横切关注点集中在一处,服务可以在稳定的公共 API 背后自由变化。
API 网关架构图
 Clients (web, mobile, partners, internal jobs)
        |
        v
 [ DNS / CDN / WAF / Load balancer ]
        |
        v
 +--------------------- API GATEWAY (data plane) ---------------------+
 |  TLS termination -> AuthN/AuthZ -> Rate limit & quota ->           |
 |  Request validation & transform -> Cache lookup -> Router          |
 |  -> Timeouts / retries / circuit breaker -> Response transform     |
 |  -> Logs, metrics, traces                                          |
 +--------------------------------------------------------------------+
        |               |                 |
        v               v                 v
   Orders service   Users service   Payments service   (or Lambda, queues, LLM providers)

 Control plane: config store, admin API/UI, policy and key management, deploys config to data plane
核心组件
| 组件 | 作用 |
|---|---|
| 监听器 / TLS 终止 | 接收 HTTP/1.1、HTTP/2、gRPC 或 WebSocket 连接并解密 TLS |
| 认证与授权 | 校验 API Key、OAuth 2.0 / JWT 令牌或 mTLS 证书,再检查权限 |
| 限流与配额 | 按客户端、Key 或路由限制请求数;超出时返回 HTTP 429 |
| 请求校验与转换 | 校验 schema,重写路径和请求头,转换协议(例如 REST 转 gRPC) |
| 缓存 | 无需调用后端即可返回重复响应 |
| 路由器 | 按路径、方法、主机或请求头匹配上游服务,并在多个实例间负载均衡 |
| 弹性层 | 超时、带退避的重试、熔断器和回退 |
| 可观测性 | 访问日志、指标(延迟、错误率)和分布式追踪 |
| 控制平面 | 存储配置并推送到各网关实例;提供管理 API 或 UI |
请求生命周期
- 客户端携带 bearer token 发送
GET /orders/42。 - 网关终止 TLS 并校验令牌。
- 检查调用方的限流和配额。
- 校验请求,并添加请求 ID 等请求头。
- 查询缓存;未命中时路由到一个健康的
orders实例。 - 强制执行超时,连接出错时重试一次,并记录结果。
- 如有需要转换响应后返回,同时记录状态、延迟和调用方。
API 网关的核心功能
以下是大多数团队需要的功能,大致按重要程度排序:
- 请求路由。 基于路径、主机、方法和请求头的路由,以及负载均衡、金丝雀发布或按权重发布。
- 认证与授权。 API Key、OAuth 2.0 与 JWT 校验、mTLS,以及按路由配置的访问策略。
- 限流与配额。 按消费者设置限制以保护后端;HTTP 429 "Too Many Requests" 定义于 RFC 6585。
- 请求与响应转换。 注入请求头、映射负载、协议转换和 API 版本管理。
- 缓存。 带 TTL 的响应缓存,降低延迟和后端负载。
- 安全。 TLS、IP 白名单与黑名单、请求大小限制,以及与 Web 应用防火墙的集成。
- 可观测性。 结构化访问日志、指标,以及向 Grafana Tempo、Datadog 等工具传播追踪信息。
- 弹性。 超时、重试、熔断器和健康检查。
- 开发者体验。 API Key 与套餐、开发者门户和用量分析;通常被打包为"API 管理"。
- 商业化与计量。 按消费者统计用量,用于计费或内部结算。
部署模式
| 模式 | 工作方式 | 适用场景 |
|---|---|---|
| 单一中心网关 | 一个网关集群承接所有服务 | 中小型系统,由一个团队负责入口 |
| 面向前端的后端(BFF) | 为每类客户端(Web、移动端、合作方)单独部署网关 | 不同客户端需要差异很大的 API |
| 按领域部署网关 | 每个业务领域运行自己的网关 | 拥有自治团队的大型组织 |
| Kubernetes Ingress / Gateway API | 用 Kubernetes 资源配置网关 | 服务已经运行在 Kubernetes 上 |
| 网关 + 服务网格 | 网关处理南北向(客户端)流量,网格处理东西向(服务间)流量 | 大量内部服务需要 mTLS 和流量策略 |
Kubernetes Gateway API 现已成为在 Kubernetes 上配置网关的标准方式,Envoy Gateway 等实现都基于它构建。
API 网关、负载均衡器与服务网格的区别
- 负载均衡器在同一服务的多个实例间分配流量,主要工作在网络层或 HTTP 层,不具备 API 感知的策略。
- API 网关理解 API:它认证消费者、按 Key 执行配额、转换负载,并在多个服务间路由。
- 服务网格管理内部服务之间的流量,通常借助 sidecar 或节点代理。
大多数生产系统会在网关前放置负载均衡器,有些还会在网关后面加一层服务网格。
主流 API 网关产品
| 产品 | 类型 | 说明(2026 年 10 月) |
|---|---|---|
| Amazon API Gateway | 托管(AWS) | 支持 REST、HTTP 和 WebSocket API;免费套餐在 12 个月内每月包含 100 万次 REST 调用、100 万次 HTTP 调用、100 万条 WebSocket 消息以及 75 万连接分钟 |
| Kong Gateway | 开源与企业版 | 基于插件;可用声明式配置以无数据库(DB-less)模式运行,也可接数据库 |
| Envoy Gateway | 开源 | 通过 Kubernetes Gateway API 管理的 Envoy 代理 |
| Azure API Management | 托管(Azure) | 托管网关和自托管网关,另有开发者门户 |
示例:Kong 声明式配置
下面这份 DB-less Kong 配置把 /orders 路由到后端,要求提供 API Key,并把每个消费者限制为每分钟 60 次请求:
_format_version: "3.0"
services:
  - name: orders
    url: http://orders:8080
    routes:
      - name: orders-route
        paths: ["/orders"]
    plugins:
      - name: key-auth
      - name: rate-limiting
        config:
          minute: 60
          policy: local
consumers:
  - username: mobile-app
    keyauth_credentials:
      - key: replace-with-a-long-random-key
示例:用 Python 实现的最小网关
为了在代码中直观理解架构,下面是一个可运行的小型网关,包含 API Key 认证、按 Key 限流、路由和超时。它仅用于学习;真实流量请使用生产级网关。
# pip install fastapi uvicorn httpx ; run: uvicorn gateway:app --port 8080
import time, httpx
from collections import defaultdict
from fastapi import FastAPI, Request, Response, HTTPException

ROUTES = {"/orders": "http://localhost:9001", "/users": "http://localhost:9002"}
KEYS = {"key-mobile": "mobile-app"}
LIMIT_PER_MIN = 60
hits = defaultdict(list)
app = FastAPI()

@app.api_route("/{path:path}", methods=["GET", "POST", "PUT", "DELETE"])
async def gateway(path: str, request: Request):
    consumer = KEYS.get(request.headers.get("x-api-key", ""))
    if not consumer:
        raise HTTPException(401, "invalid API key")
    now = time.time()
    hits[consumer] = [t for t in hits[consumer] if now - t < 60]
    if len(hits[consumer]) >= LIMIT_PER_MIN:
        raise HTTPException(429, "rate limit exceeded", headers={"Retry-After": "60"})
    hits[consumer].append(now)
    prefix = next((p for p in ROUTES if f"/{path}".startswith(p)), None)
    if not prefix:
        raise HTTPException(404, "no route")
    async with httpx.AsyncClient(timeout=5.0) as client:
        upstream = await client.request(request.method, ROUTES[prefix] + f"/{path}"[len(prefix):],
                                        content=await request.body(),
                                        headers={"x-consumer": consumer})
    return Response(upstream.content, upstream.status_code,
                    media_type=upstream.headers.get("content-type"))
从 API 网关到 LLM 网关
当后端从微服务变成 AI 模型供应商时,同样的架构依然适用,只是多了几项工作。LLM 网关(或 AI 网关)会额外提供:
| 传统网关功能 | LLM 网关扩展 |
|---|---|
| 按路径路由 | 按模型名称、成本、延迟或供应商健康状况路由 |
| 按请求数限流 | 按每分钟 Token 数和每个 Key 的支出限制 |
| 请求转换 | 在 OpenAI、Anthropic 和 Gemini 请求格式之间转换 |
| 响应缓存 | 提示词缓存和语义缓存 |
| 重试与熔断 | 遇到 429、5xx 或超时时回退到其他供应商或模型 |
| 访问日志 | Token 数量、每次请求的成本和所用模型 |
| 每个消费者一个 API Key | 一个 Key 通用多个供应商,并支持按团队设置预算 |
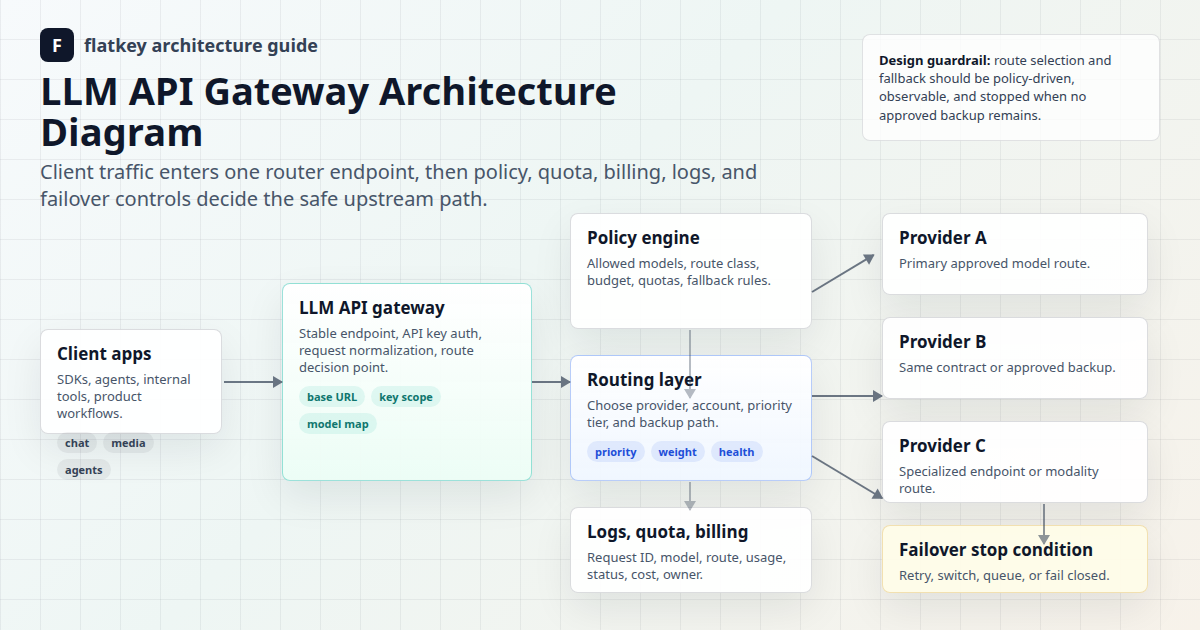
 App / agent  --OpenAI-format request-->  LLM gateway
   auth + budget check -> model map -> route (primary provider)
   -> on 429/5xx/timeout: fallback provider -> usage + cost log
   -> Anthropic / OpenAI / Google / DeepSeek / self-hosted vLLM
这一层可以自己运行(例如使用 LiteLLM 或 Kong 的 AI 插件),也可以使用托管服务。Flatkey 就是一种托管方案:根据其截至 2026 年 10 月的文档,它提供一个位于 https://router.flatkey.ai/v1 的 OpenAI 兼容端点,一个 Key 即可调用 300 多个模型,用量日志记录每次调用的 Token 和成本,并支持按 Key 或分组设置支出上限。由于它使用 OpenAI 格式,现有客户端只需修改 base URL:
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"claude-sonnet-5-5","messages":[{"role":"user","content":"Summarize the API gateway pattern in one sentence."}]}'
想深入了解设计,可以阅读我们的指南:AI API 网关架构与模型路由、LLM 网关熔断器、AI 网关与 API 管理的区别,以及托管 AI 网关与自托管代理对比。如果你刚接触这个话题,LLM 网关入门指南是很好的起点,限流处理指南则介绍了应对 429 的策略。
设计清单
- 把 TLS、认证和限流放在网关层,而不是每个服务各自实现。
- 为每条上游路由设置超时;绝不无限等待。
- 只重试幂等请求(按 RFC 9110 为 GET、PUT、DELETE),除非后端支持幂等键。
- 将请求 ID 和追踪上下文传递给每个后端。
- 在负载均衡器后至少运行两个网关实例,避免网关成为单点故障。
- 不要把业务逻辑放进网关;网关应执行策略,而不是实现功能。
- 用 git 管理网关配置版本,像代码一样部署。
常见问题
微服务中的 API 网关模式是什么?
这是一种由单个网关作为所有客户端请求入口的设计。网关把每个请求路由到正确的微服务,并处理认证、限流、日志等共性问题,因此客户端不直接调用各个服务。
API 网关有哪些核心功能?
核心功能包括请求路由、认证与授权、限流与配额、请求与响应转换、缓存、安全控制、可观测性,以及超时、重试、熔断等弹性功能。
API 网关架构的主要组件有哪些?
一个处理流量的数据平面(监听器、认证、限流器、转换器、缓存、路由器、弹性层和遥测),以及一个存储和分发配置的控制平面。
API 网关和负载均衡器是一回事吗?
不是。负载均衡器在一个服务的多个实例间分配流量。API 网关则增加了 API 感知的功能,例如按消费者认证、配额、负载转换以及跨多个服务的路由。大多数系统两者都会使用。
什么是 LLM 网关?
LLM 网关是专门处理 AI 模型流量的 API 网关。它按模型和供应商路由,按 Token 和支出限流,在不同供应商的 API 格式之间转换,在供应商故障时自动回退,并记录 Token 用量和成本。
API 网关会成为单点故障吗?
如果只运行一个实例,就有可能。应在负载均衡器后跨可用区运行多个实例,把配置保存在可复制的存储中,并监控网关本身。