
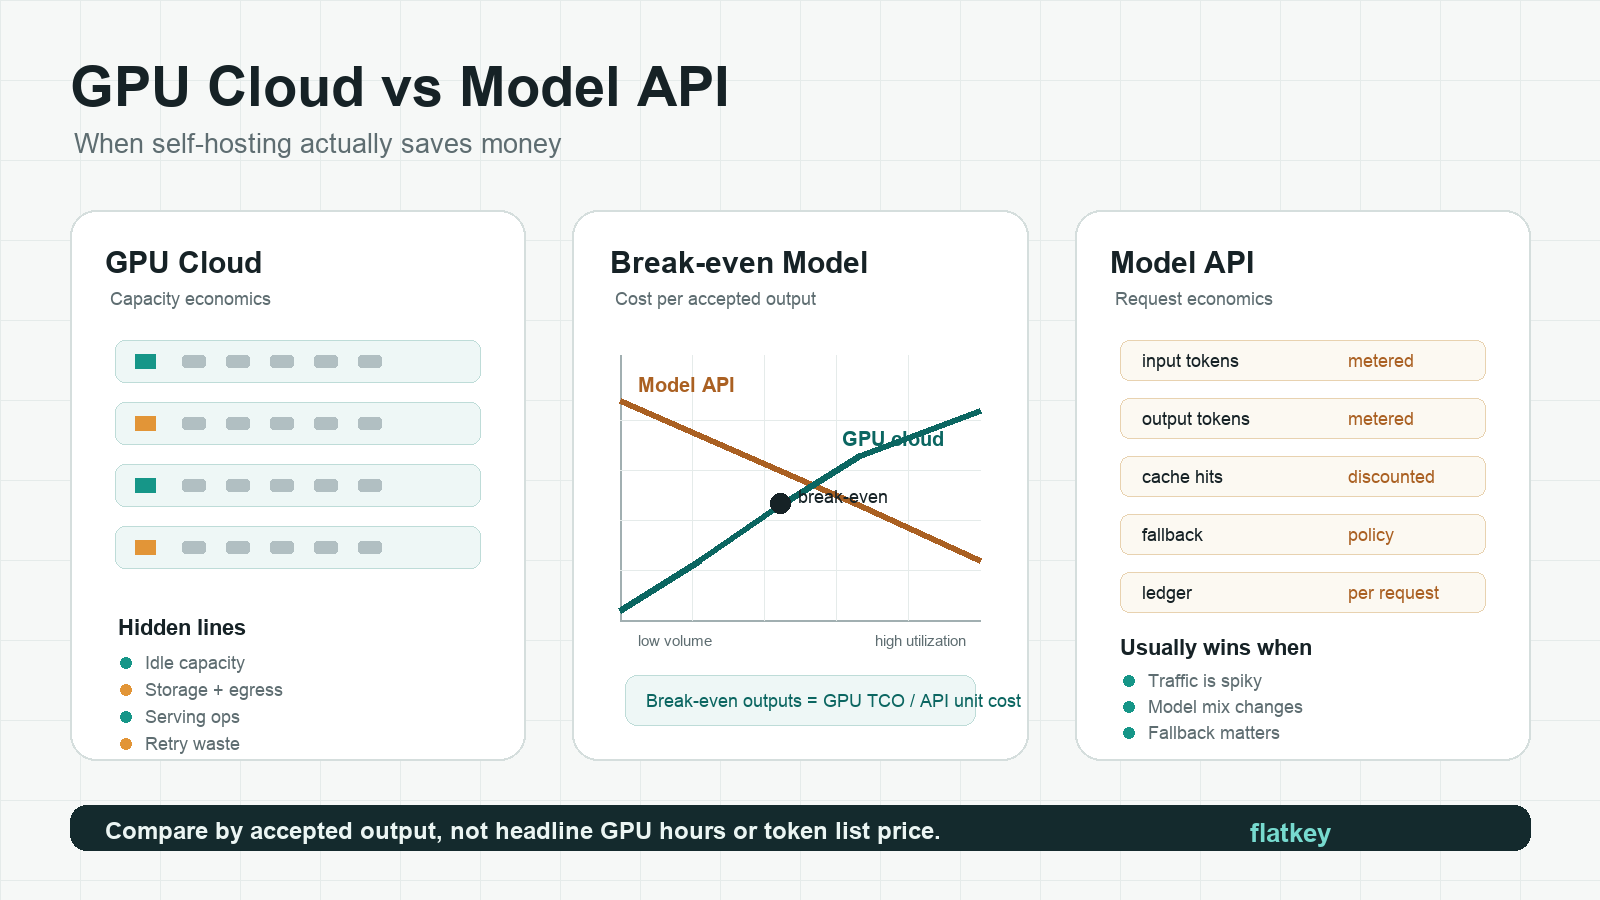
A maioria das equipes faz a pergunta GPU cloud vs API de modelo tarde demais. Elas alugam GPUs, implantam uma stack de serving, ajustam batching, contratam suporte de plataforma e só então comparam a conta com uma API de modelo gerenciada. Nessa altura, a comparação já está enviesada em favor do caminho no qual investiram esforço.
A pergunta melhor é mais simples: você precisa de controle da camada de GPU ou precisa de saídas de modelo confiáveis ao menor custo aceito?
Para equipes de IA corporativa, a GPU cloud começa a economizar dinheiro quando você tem demanda sustentada, uma escolha de modelo estável, alta utilização útil e a equipe de engenharia para operar a inferência. Uma API de modelo costuma ser mais barata quando o tráfego é esporádico, a escolha do modelo muda com frequência, retries e failover importam mais do que o controle do hardware, ou você precisa de modelos de fronteira que não podem ser auto-hospedados.
Regra prática da Flatkey: compare GPU cloud vs API de modelo pelo custo por saída aceita, não apenas pela taxa horária da GPU ou pelo preço de tabela dos tokens.
Resposta rápida sobre GPU cloud vs API de modelo
Use esta tabela antes de montar uma planilha.
| Situação | Normalmente comece com | Por quê |
|---|---|---|
| Produto inicial, prompts mudando, demanda incerta | API de modelo | Você evita GPUs ociosas enquanto aprende sobre tráfego, qualidade e adequação do modelo. |
| Inferência em lote de alto volume em um modelo aberto estável | GPU cloud | Utilização sustentada pode amortizar a stack de serving. |
| Chat voltado ao cliente com picos imprevisíveis | API de modelo ou híbrido | Autoscaling, fallback e ausência de capacidade ociosa muitas vezes importam mais do que o preço unitário bruto. |
| Pesos proprietários, kernels customizados, localidade rígida de dados | GPU cloud | O requisito de negócio é controle, não apenas custo. |
| Roteamento de modelos entre múltiplos provedores, modelos de fronteira ou trocas frequentes de modelo | API de modelo | Você evita reconstruir a infraestrutura de serving a cada mudança de modelo. |
| Carga de trabalho estável de longo prazo com utilização comprovada | GPU cloud reservada, cluster de GPU dedicado ou GPUs em colocation | O compromisso pode reduzir o custo efetivo de capacidade depois que a demanda é comprovada. |
O restante deste guia oferece um modelo copiável para comparar GPU cloud vs API de modelo sem ocultar tempo ocioso, retries, operações ou filtros de qualidade.
A unidade de custo que realmente importa
Não compare:
- Taxa horária da GPU vs preço por token.
- Cotação de cloud vs um benchmark no melhor cenário.
- Preço de tabela da API de modelo vs um cluster auto-hospedado totalmente utilizado.
Em vez disso, compare um destes denominadores:
| Carga de trabalho | Melhor denominador |
|---|---|
| Chat com LLM ou agentes | Custo por resposta aceita, tarefa aceita ou token de saída aceito |
| Classificação em lote ou extração | Custo por registro aceito |
| Geração de código | Custo por patch aceito ou tarefa de codificação concluída |
| Geração de imagens | Custo por imagem aceita após filtros de qualidade |
| Geração de vídeo | Custo por segundo aceito ou clipe aceito |
| Fine-tuning ou treinamento | Custo por execução concluída |
Para a maioria das equipes de inferência:
effective_unit_cost =
  all_in_monthly_cost
  / accepted_outputs_after_retries_quality_filters_and_failures
É aqui que muitas comparações GPU cloud vs API de modelo se invertem. Um endpoint auto-hospedado pode mostrar ótimo throughput em benchmark e ainda assim perder se a utilização for baixa, o modelo falhar nas verificações de qualidade ou os engenheiros gastarem tempo demais mantendo a stack saudável.
Modelo de custo da API de modelo
Uma API de modelo parece simples porque a cobrança normalmente é feita por requisição, token, segundo de imagem, segundo de vídeo ou chamada de ferramenta. Mas um modelo justo de API de modelo ainda precisa de mais do que o preço unitário publicado.
Use este modelo:
monthly_model_api_cost =
  input_token_cost
  + cached_input_or_context_cost
  + output_token_cost
  + tool_or_media_cost
  + retry_and_fallback_cost
  + gateway_or_router_cost
  + observability_and_finops_cost
Depois normalize:
model_api_cost_per_accepted_output =
  monthly_model_api_cost
  / accepted_outputs
O que capturar:
| Linha de custo | O que verificar |
|---|---|
| Tokens de entrada e saída | Página oficial de preços do provedor, ID do modelo, janela de contexto, limite de saída e data de verificação. |
| Entrada em cache | Se o provedor oferece cache de prompt ou descontos por cache hit, e se sua carga de trabalho realmente reutiliza contexto. |
| Preço em lote | Se o processamento em lote ou assíncrono atende ao seu requisito de latência. |
| Retries | Retries por limite de taxa, erros transitórios, verificações de qualidade falhas e requisições de fallback. |
| Camada de roteador/gateway | Qualquer taxa de gateway, ledger de uso, allowlist de modelos, orçamento por sub-chave ou fluxo de faturamento. |
| Operações | Integração, monitoramento, tratamento de status do provedor e reconciliação financeira. |
Use páginas oficiais de origem para números atuais, não tabelas de tarifas copiadas. Comece com preços da API da OpenAI, preços da Anthropic, preços da API Google Gemini e a página de preços atual do seu gateway ou roteador.
Para a Flatkey, o lado da API de modelo é sobre uma chave, um saldo e um único registro de uso entre modelos e ferramentas oficiais. Isso importa quando o problema real de custo não é uma única chamada de modelo, mas sim chaves dispersas, múltiplas faturas, controles de orçamento por equipe e fallback entre provedores.
Modelo de custo da nuvem de GPU
Nuvem de GPU não é apenas o preço horário da GPU. Uma API de modelo auto-hospedada em produção tem custo de capacidade, software de serving, armazenamento, rede, monitoramento, trabalho para manter o uptime e capacidade ociosa.
Use este modelo:
monthly_gpu_cloud_cost =
  gpu_compute_hours
  + storage_and_snapshot_cost
  + bandwidth_and_egress_cost
  + load_balancing_and_network_cost
  + serving_stack_cost
  + observability_and_logging_cost
  + platform_engineering_cost
  + support_plan_or_managed_service_cost
  + idle_capacity_cost
  + retry_failure_and_redeployment_waste
Depois normalize:
self_hosted_cost_per_accepted_output =
  monthly_gpu_cloud_cost
  / accepted_outputs
O que capturar:
| Linha de custo | Por que isso altera a resposta |
|---|---|
| Modelo de GPU e memória | GPUs H100, H200, B200, A100, L40S e da classe RTX têm curvas diferentes de memória, throughput, oferta e preço. |
| Modo do produto | On-demand, spot, reservado, marketplace, GPU serverless, cluster dedicado e bare metal têm perfis diferentes de confiabilidade. |
| Utilização | Um endpoint auto-hospedado mais barato perde rapidamente se a GPU ficar ociosa. |
| Stack de serving | vLLM, SGLang, TensorRT-LLM, NIM ou servidores customizados precisam de suporte operacional real. |
| Armazenamento e carregamento do modelo | Pesos grandes, snapshots, volumes e pulls repetidos podem se tornar relevantes. |
| Rede | Egress, links privados, IPs públicos e balanceamento de carga podem alterar a economia unitária. |
| Falhas | Erros de falta de memória, preempções, contêineres com problemas e cold starts aumentam o custo por saída aceita. |
Use as páginas atuais dos provedores como pontos de verificação: preços do AWS EC2, instâncias AWS P5, preços de GPU do Google Cloud, preços da RunPod, Lambda GPU Cloud e preços da Vast.ai.
Trate todo preço de GPU como carimbado no tempo. A oferta do marketplace, a disponibilidade regional e as cotações comprometidas podem mudar mais rápido do que o artigo que você está lendo.
A fórmula de ponto de equilíbrio
Este é o ponto em que uma decisão entre nuvem de GPU e API de modelo deixa de ser opinião e passa a ser de nível financeiro.
O modelo mais simples de ponto de equilíbrio é:
break_even_outputs =
  monthly_gpu_cloud_cost
  / model_api_cost_per_accepted_output
Se sua carga de trabalho produzir mais saídas aceitas do que break_even_outputs, a auto-hospedagem pode economizar dinheiro. Se produzir menos, uma API de modelo provavelmente é mais barata.
Você também pode expressar a mesma ideia em utilização:
required_utilization =
  monthly_gpu_cloud_cost
  / equivalent_model_api_cost_at_expected_volume
Essa fórmula só é útil se a carga de trabalho for estável. Se volume, modelo, tamanho de contexto ou meta de qualidade mudarem todo mês, o lado da API de modelo tem valor de opção que uma fórmula de utilização não captura.
Exemplo prático: por que o preço horário da GPU pode enganar
Suponha que uma equipe esteja decidindo se deve auto-hospedar um modelo aberto estável.
| Entrada | Valor de exemplo |
|---|---|
| Custo total da nuvem de GPU | US$ 24.000 por mês |
| Volume de saída aceita | 30 milhões de saídas aceitas por mês |
| Custo auto-hospedado por saída aceita | US$ 0,0008 |
| Custo da API de modelo por saída aceita | US$ 0,0012 |
| Custo mensal da API de modelo no mesmo volume | US$ 36.000 |
| Economia aparente da auto-hospedagem | US$ 12.000 por mês |
Nesse caso base, a nuvem de GPU parece economizar dinheiro.
Agora estresse as premissas.
| Mudança | Efeito |
|---|---|
| A utilização útil cai 35% | O custo unitário da auto-hospedagem sobe porque o pool fixo de GPUs faz menos trabalho aceito. |
| A taxa de retry ou de falha de qualidade dobra | Ambos os caminhos ficam mais caros, mas a auto-hospedagem também absorve desperdício de capacidade. |
| O produto muda para um modelo maior | As GPUs existentes podem precisar de sharding, mais memória ou um novo stack de serving. |
| A demanda se torna irregular | A API de modelo pode escalar com a demanda; o pool de GPUs precisa ser dimensionado para picos ou aceitar filas. |
Se o pior cenário eliminar a economia, a auto-hospedagem na verdade não é mais barata. É uma aposta de capacidade.
Quando a nuvem de GPU realmente economiza dinheiro
A nuvem de GPU pode economizar dinheiro quando a maioria destes itens é verdadeira:
- Você tem demanda sustentada, não picos ocasionais.
- A família do modelo é estável por meses, não por dias.
- O modelo é de pesos abertos ou, de outra forma, está disponível para auto-hospedagem.
- A carga de trabalho tem alta utilização útil após lacunas de fila e falhas.
- As metas de latência podem ser atendidas com sua stack de serving.
- Você consegue executar vLLM, SGLang, TensorRT-LLM, NIM ou outra stack de forma confiável.
- A equipe consegue monitorar utilização de GPU, pressão de memória, latência p95/p99, taxa de erro e amplificação de retentativas.
- Você tem um plano para carregamento do modelo, aquecimento de cache, automação de desligamento e segurança de rollout.
- A cotação inclui armazenamento, egress, suporte e premissas de disponibilidade.
- O financeiro se sente confortável em financiar capacidade antes de cada solicitação chegar.
Isso é comum em inferência em lote de alto volume, pipelines internos de extração, bots de suporte estáveis, modelos abertos específicos de domínio e cargas de trabalho em que pesos personalizados ou localidade dos dados importam.
Para um planejamento mais profundo do lado da GPU, use os guias da Flatkey sobre preços de aluguel de GPU, melhor GPU para inferência de LLM, aluguel de cluster de GPU e TCO de cluster de GPU.
Quando as APIs de modelo continuam mais baratas
As APIs de modelo geralmente continuam mais baratas quando estes pontos são verdadeiros:
- O tráfego é em picos, sazonal ou ainda desconhecido.
- O aplicativo precisa de vários modelos de fronteira.
- O modelo muda mais rápido do que seu plano de infraestrutura.
- A equipe precisa mais de fallback, tratamento de limite de taxa, faturas, logs de uso e controles de orçamento do que de controle de hardware.
- Você não consegue manter as GPUs ocupadas o suficiente para compensar o tempo ocioso.
- Você não tem uma equipe de plataforma pronta para operar a camada de serving.
- A carga de trabalho inclui modelos fechados, geração multimodal, capacidades proprietárias do provedor ou lançamentos de modelos que evoluem rapidamente.
- O setor de compras quer atribuição por solicitação em vez de uma fatura de infraestrutura compartilhada.
É aqui que a comparação entre GPU cloud e API de modelo não é apenas sobre preço. Uma API de modelo pode reduzir o tempo de integração, a complexidade de procurement e a superfície de incidentes.
A Flatkey se encaixa nesse lado da decisão quando as equipes querem um único caminho compatível com OpenAI para muitos modelos oficiais, um saldo pré-pago, uma fatura, orçamentos por subchave, allowlists de modelos, registros de uso por solicitação e failover entre canais upstream. Veja os guias relacionados sobre comparação de preços de modelos de IA, comparação de preços de APIs de IA, preços de gateway de IA e gestão de gastos com APIs de IA.
Híbrido costuma ser a resposta real
Muitas equipes corporativas de IA não devem forçar uma única resposta universal. Um modelo híbrido costuma ser mais defensável:
| Fatia da carga de trabalho | Melhor padrão padrão |
|---|---|
| Inferência estável de alto volume com pesos abertos | GPU cloud |
| Raciocínio ou codificação com modelos de fronteira | API de modelo |
| Jobs em lote que podem enfileirar | GPU cloud, spot ou capacidade reservada |
| Picos voltados ao cliente | API de modelo ou overflow híbrido |
| Pesos proprietários | GPU cloud |
| Exploração de modelos | API de modelo |
| Implantação regulada com controle de infraestrutura | GPU cloud dedicada, GPU cloud privada, colocation ou on-premises |
O padrão híbrido é:
- Direcione workloads desconhecidos e variáveis por meio de APIs de modelo.
- Faça benchmark de workloads estáveis na GPU cloud.
- Mova para auto-hospedagem apenas os workloads com volume comprovado e estabilidade do modelo.
- Mantenha um fallback de API de modelo para overflow, upgrades de modelo e diversidade de provedores.
Esse caminho evita o erro mais caro: comprar capacidade de GPU para uma carga de trabalho que depois muda de forma.
Plano de benchmark antes de trocar
Execute o mesmo tráfego pelos dois caminhos por pelo menos uma janela representativa.
| Métrica | Caminho de GPU cloud | Caminho de API de modelo |
|---|---|---|
| Saídas aceitas | ||
| Tokens ou registros de entrada | ||
| Tokens ou resultados de saída | ||
| Latência p50 / p95 / p99 | ||
| Tempo até o primeiro token | ||
| Taxa de erro | ||
| Taxa de retentativa | ||
| Taxa de rejeição por qualidade | ||
| Capacidade ociosa | N/A | |
| Horas da equipe | ||
| Armazenamento e egress | ||
| Custo total | ||
| Custo por saída aceita |
Depois, pergunte:
- A GPU cloud ainda vence depois do tempo ocioso?
- Ainda vence depois do tempo da equipe?
- Ainda vence depois de retentativas e filtros de qualidade?
- Ainda vence se o modelo mudar?
- Ainda vence se o tráfego cair 30%?
- Ainda vence se a latência p95 precisar melhorar?
Se a resposta for sim no caso desfavorável, a auto-hospedagem merece um caminho sério de procurement.
Checklist de procurement
Para GPU cloud:
- Qual GPU exata, tamanho de memória, CPU, RAM, disco, interconexão e largura de banda de rede estão incluídos?
- A capacidade é sob demanda, spot, marketplace, cloud segura, reservada, dedicada ou bare metal?
- Quais custos de armazenamento, snapshot, egress, IP público, balanceador de carga, suporte e observabilidade estão excluídos?
- O que acontece durante falha do host, preempção, manutenção ou falta de capacidade?
- O provedor pode executar seu benchmark real antes do compromisso?
- Qual é o prazo mínimo, a trajetória de escala e o custo de saída?
Para APIs de modelo:
- Quais IDs exatos de modelo, janelas de contexto, limites de saída e unidades de precificação são usados?
- Hits de cache, jobs em lote, unidades de imagem/vídeo e chamadas de ferramentas são cobrados separadamente?
- Quais são os limites de taxa e as opções de fallback?
- Como são contadas as tentativas de repetição, chamadas falhas ao provedor e rejeições de qualidade?
- O financeiro pode exportar o uso por equipe, chave, modelo, ambiente e cliente?
- Quais termos de retenção de dados, conformidade e SLA se aplicam?
Lista de verificação de fontes
Use estas páginas oficiais como pontos de partida para as entradas atuais:
| Tipo de fonte | Páginas para verificar |
|---|---|
| Preço de API de modelo | Preços da API da OpenAI, Preços da Anthropic, Preços da API do Google Gemini |
| Preço de GPU cloud | Preços do AWS EC2, Instâncias AWS P5, Preços de GPU do Google Cloud, Preços da RunPod, Lambda GPU Cloud, Preços da Vast.ai |
| Frameworks de serving | Servidor compatível com OpenAI do vLLM, Documentação do SGLang |
| Especificações de GPU | NVIDIA H100, NVIDIA H200, NVIDIA DGX B200 |
| Estrutura FinOps | FinOps FOCUS |
| Contexto de custo Flatkey | Preços da Flatkey, Flatkey Compute, Índice de preços do Flatkey Compute |
Perguntas frequentes
GPU cloud é sempre mais barato do que uma API de modelo?
Não. GPU cloud só é mais barato quando a utilização útil é alta o suficiente para compensar capacidade ociosa, armazenamento, egress, operações de serving, desperdício com retries e tempo da equipe. Uma API de modelo pode ser mais barata para cargas de trabalho intermitentes ou variáveis, mesmo quando o preço por token parece mais alto.
Quando a auto-hospedagem de um LLM economiza dinheiro?
A auto-hospedagem economiza dinheiro quando o modelo é estável, o volume é alto, a utilização é previsível, a equipe consegue operar a pilha de serving e o custo total da GPU cloud por saída aceita é menor do que o custo da API de modelo sob premissas pessimistas.
Como devo comparar preços de GPU cloud versus API de modelo?
Compare custo por saída aceita. Inclua tokens, horas de GPU, armazenamento, largura de banda, tempo ocioso, retries, taxa de falha, filtros de qualidade, tempo de engenharia, suporte e operações financeiras. Não compare apenas o preço horário da GPU com o preço de tabela dos tokens.
Qual é o maior custo oculto da inferência em GPU cloud?
Os maiores custos ocultos geralmente são capacidade ociosa, operações de engenharia, armazenamento e egress, implantações com falha, retries por falta de memória, e mudanças de serving pouco testadas. Esses custos não aparecem na taxa horária principal da GPU.
Qual é o maior custo oculto das APIs de modelo?
Os maiores custos ocultos geralmente são retries, chamadas de fallback, prompts longos, contexto não cacheado, respostas pesadas em saída, chamadas de ferramentas ou mídia, contas de provedores dispersas e atribuição fraca de uso. Um ledger no nível da requisição ajuda a expor esses custos.
Equipes corporativas de IA devem usar uma arquitetura híbrida?
Frequentemente, sim. Use APIs de modelo para exploração, modelos de fronteira, picos e fallback. Mova apenas cargas estáveis e de alto volume para GPU cloud depois que um benchmark provar um custo aceito menor. Mantenha o caminho da API disponível para overflow e mudanças de modelo.
Em resumo
GPU cloud versus API de modelo não é uma decisão filosófica. GPU cloud versus API de modelo é uma decisão de economia da carga de trabalho.
Escolha GPU cloud quando você conseguir manter a capacidade ocupada, o modelo for estável e o controle de hardware criar uma vantagem real. Escolha uma API de modelo quando flexibilidade, acesso a múltiplos provedores, mudanças mais rápidas de modelo e governança por requisição valham mais do que as economias teóricas de hardware.
O caminho mais seguro é gradual: comece com a API de modelo, faça benchmark da carga de trabalho, mova apenas fatias estáveis para GPU cloud quando a conta do ponto de equilíbrio resistir a cenários adversos, e mantenha uma rota de API para fallback e futuras mudanças de modelo.
Se você estiver comparando GPU cloud vs API de modelo para uma carga de trabalho de IA em produção, a Flatkey pode ajudar no lado da API com uma única chave, um único saldo, rotas oficiais de modelos, registros de uso, orçamentos e faturas, enquanto sua equipe comprova quais cargas de trabalho realmente merecem capacidade dedicada de GPU.


