O que é uma AI Factory? Clusters de GPU, Dados, Modelos e Operações
O que é uma AI factory? Uma AI factory é o sistema operacional em torno da IA empresarial: capacidade de GPU, pipelines de dados, treinamento ou fine-tuning de modelos, serving de inferência, avaliação, governança e operações de custos trabalhando como um único ciclo de produção repetível.
A metáfora importa porque a IA não é produzida apenas por GPUs. Um cluster de GPU é a sala de máquinas, mas uma AI factory também precisa de dados curados, escalonadores, armazenamento, rede, registries de modelos, fluxos de implantação, observabilidade, controles de segurança e um modelo financeiro para decidir quando alugar GPUs, reservar clusters, usar APIs gerenciadas ou combinar os três.
A NVIDIA popularizou o termo em torno de infraestrutura que transforma dados em inteligência, e fornecedores como Dell Technologies e HPE agora usam "AI factory" para descrever plataformas empresariais de IA full-stack. Para quem constrói, a pergunta útil é menos "quem é dono da expressão?" e mais prática: quais peças precisam existir antes que sua carga de trabalho de IA se torne uma fábrica em vez de um experimento pontual?
Este guia define o que é uma AI factory, explica como uma AI factory funciona, mapeia as camadas centrais da plataforma e mostra onde a Flatkey se encaixa quando uma equipe quer acesso a modelo/API sem operar sozinha cada camada da infraestrutura de GPU.
A definição rápida: o que é uma AI factory?
Uma AI factory é um ambiente de produção que converte dados brutos, prompts, modelos, computação e feedback operacional em saídas de IA utilizáveis. Em termos de negócio, é um sistema repetível para criar, implantar, medir e aprimorar capacidades de IA.
Uma maneira simples de pensar nisso:
| Factory layer | What it does | Common owner |
|---|---|---|
| Capacidade de GPU e aceleradores | Executa workloads de treinamento, fine-tuning, inferência em lote ou inferência em tempo real | Infraestrutura, plataforma, sistemas de ML |
| Rede e armazenamento | Move datasets, checkpoints, embeddings, logs e artefatos de modelo sem gargalos | Infraestrutura, SRE, plataforma de dados |
| Pipelines de dados | Ingere, limpa, rotula, filtra e atualiza dados usados por modelos e aplicações | Engenharia de dados, plataforma de ML |
| Ciclo de vida do modelo | Seleciona modelos foundation, faz fine-tuning, avalia, versiona e coloca em produção | Engenharia de ML, produto de IA |
| Serving e roteamento | Entrega saídas do modelo por meio de APIs, jobs em lote, agentes ou aplicações | Backend, plataforma, engenharia de IA |
| Operações | Monitora latência, erros, utilização, custo, segurança, acesso e deriva de qualidade | SRE, FinOps, segurança, governança |
Então, quando alguém pergunta "o que é uma AI factory?", a melhor resposta é: é a stack completa de produção para IA, não apenas uma sala cheia de GPUs.
Como uma AI factory funciona?
Uma AI factory funciona transformando quatro entradas em um ciclo de saída gerenciado:
- Dados entram por meio de eventos de clientes, documentos, código, logs, mídia, dados sintéticos, conjuntos de dados públicos ou chamadas de ferramentas.
- Computação processa os dados por meio de jobs de treinamento, execuções de fine-tuning, pipelines de recuperação, jobs de embeddings, inferência em lote ou inferência em tempo real.
- Modelos produzem saídas por meio de checkpoints, APIs hospedadas, roteadores de modelos ou agentes específicos de domínio.
- Operações medem se as saídas são confiáveis, acessíveis, governadas e úteis o suficiente para permanecer em produção.
Esse ciclo se repete. Uma AI factory madura coleta feedback de usuários e sistemas, transforma esse feedback em dados de avaliação, melhora prompts ou modelos e publica a próxima versão por meio de implantação controlada.
É por isso que a conversa sobre AI factory inclui tanto o design do data center quanto as operações do produto. Um cluster pode treinar ou servir um modelo, mas a fábrica só existe quando a equipe consegue responder repetidamente:
- Quais workloads exigem controle direto de GPU?
- Quais workloads podem usar uma API de modelo gerenciada?
- Quais dados têm permissão para chegar a qual modelo?
- Quais saídas passam na avaliação?
- Quais falhas devem tentar novamente, fazer failover ou parar?
- Qual equipe, cliente, produto ou ambiente gerou o custo?
AI factory vs cluster de GPU
Um cluster de GPU é um recurso de computação. Uma AI factory é um sistema de produção que usa recursos de computação.
A distinção importa porque muitos programas caros de IA falham na camada acima do cluster. A equipe compra capacidade e depois descobre que movimentação de dados, armazenamento de checkpoints, serving de modelos, observabilidade, controle de acesso e atribuição de custos são os verdadeiros bloqueadores.
Use um guia de aluguel de cluster de GPU quando precisar comparar capacidade de GPU em múltiplos nós, topologia, rede e testes de aceitação. Use um modelo de AI factory quando precisar decidir como computação, dados, implantação de modelos e operações se tornam uma capacidade duradoura de IA.
| Pergunta | Resposta de cluster de GPU | Resposta de AI factory |
|---|---|---|
| O que estamos comprando? | Nós, GPUs, rede fabric, armazenamento, suporte | Um sistema repetível de produção de IA |
| O que está sendo otimizado? | Throughput, utilização, disponibilidade, conclusão de jobs | Resultado de negócio, qualidade, custo, governança, velocidade de iteração |
| Quem o opera? | Infra, plataforma, SRE, sistemas de ML | Infra, além de dados, ML, produto, segurança, finanças |
| O que pode dar errado? | Rede saturada, jobs com falha, GPUs ociosas, contenção de fila | Modelo errado, dados fracos, saída insegura, custo fora de controle, governança ausente |
| Qual é a questão da economia unitária? | Custo por hora de GPU ou por job | Custo por saída aceita, feature, cliente ou fluxo de trabalho |
Para modelagem de custos, combine este artigo com a planilha de TCO de cluster de GPU. Um orçamento de AI factory deve incluir o cluster, mas também armazenamento, egress, tempo de engenharia, falhas, avaliação, observabilidade e governança.
Camadas da plataforma de AI factory
O que é uma plataforma de AI factory? É a camada de software e infraestrutura que permite às equipes operar a fábrica como um produto, em vez de uma coleção de scripts.
Na prática, uma plataforma de AI factory normalmente inclui sete camadas.
1. Capacidade e hardware
Esta camada inclui GPUs ou aceleradores, hosts de CPU, memória, armazenamento local, design de rack, energia, refrigeração e o data center ou região de nuvem onde a carga de trabalho é executada.
Para treinamento e inferência em lote de grande porte, as equipes se preocupam com desempenho multinó, fabric de rede, velocidade de checkpoint e comportamento do agendador. Para inferência em tempo real, as equipes se preocupam com enfileiramento, cold starts, caudas de latência, autoscaling e uptime. O modelo de capacidade certo pode ser aluguel de GPU sob demanda, capacidade reservada de GPU, uma nuvem privada de GPU, GPU serverless, colocation ou um cluster interno.
2. Rede e armazenamento
As cargas de trabalho de IA muitas vezes são limitadas pelo movimento, e não pela matemática bruta. Jobs de treinamento movem conjuntos de dados e checkpoints. Sistemas de recuperação movem embeddings e documentos-fonte. Geração de mídia move arquivos grandes. Fluxos de trabalho de agentes podem chamar ferramentas, bancos de dados e navegadores.
Isso significa que uma plataforma de AI factory precisa de localidade de armazenamento previsível, regras de retenção de dados, planos de backup e caminhos de rede que correspondam à carga de trabalho. Um cluster com GPUs rápidas e armazenamento fraco ainda pode apresentar desempenho inferior.
3. Pipelines de dados
Pipelines de dados determinam com o que a fábrica está autorizada a aprender e responder. Eles abrangem ingestão, filtragem, rotulagem, deduplicação, tratamento de privacidade, limites de permissão, verificações de qualidade e cronogramas de atualização.
Para geração aumentada por recuperação, o pipeline de dados pode ser mais importante do que a escolha do modelo. Para fine-tuning, pequenos problemas de qualidade podem se transformar em falhas repetidas a jusante. Para agentes, ferramentas de dados e ferramentas da web tornam-se parte da superfície de entrada da fábrica.
4. Ciclo de vida do modelo
O ciclo de vida do modelo abrange seleção de modelo, design de prompt, fine-tuning, avaliação, versionamento, testes de regressão, rollbacks e notas de release. É aqui que uma equipe decide se vai usar uma API de modelo de fronteira, um modelo de pesos abertos em GPUs alugadas, um modelo especializado de imagem/vídeo ou uma rota híbrida.
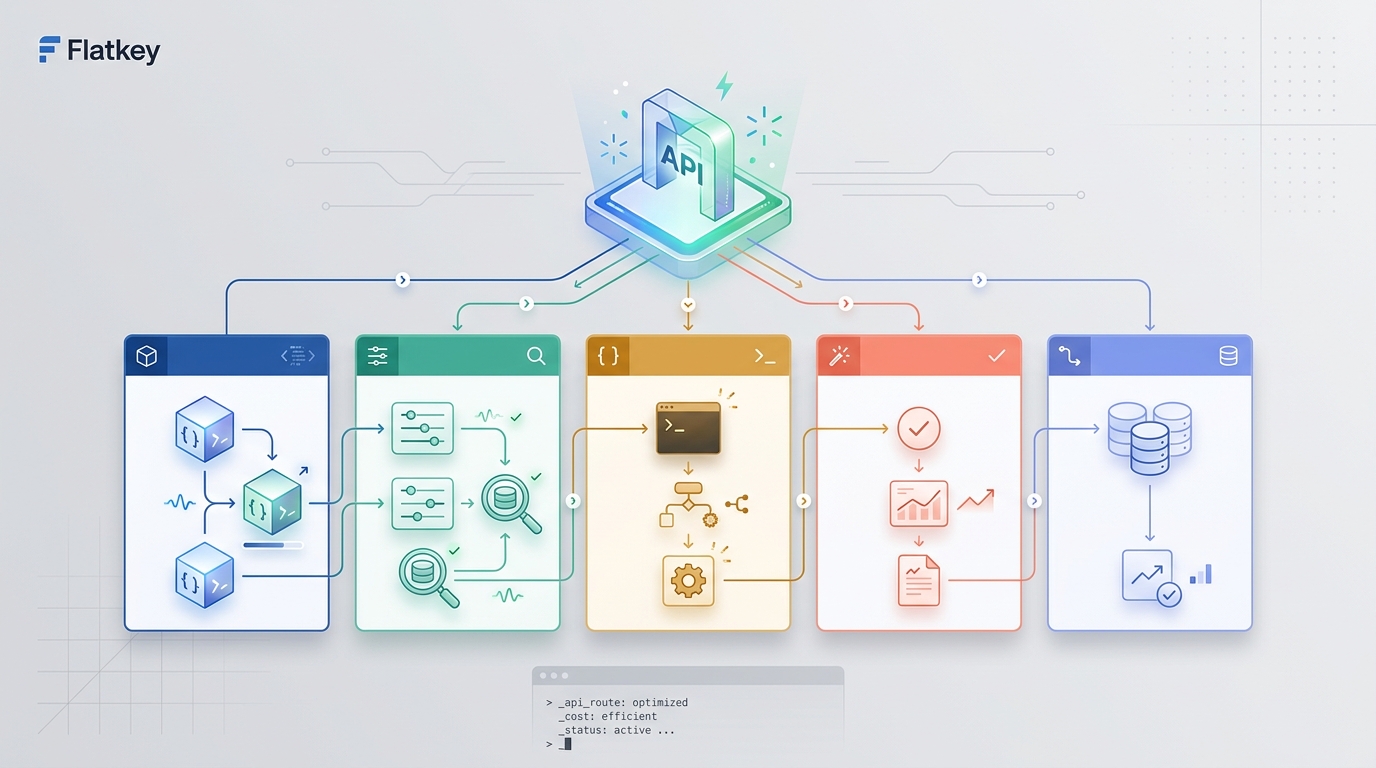
A Flatkey é relevante aqui quando uma equipe quer comparar e rotear entre APIs oficiais de modelos sem gerenciar muitas chaves de provedores e saldos separados. A Flatkey oferece aos desenvolvedores uma chave, um saldo e uma fatura para centenas de modelos oficiais e ferramentas pay-per-call, o que pode ser mais simples do que transformar cada carga de trabalho em infraestrutura própria.
5. Serving, roteamento e integração com aplicações
Serving transforma um modelo treinado ou selecionado em um endpoint confiável. O roteamento decide qual modelo, provedor, região ou caminho de fallback deve lidar com cada solicitação.
É aqui que a AI factory encontra as aplicações. Um agente de codificação, um copiloto de suporte ao cliente, um pipeline de imagens, um fluxo de trabalho de vídeo ou uma ferramenta interna de pesquisa não devem precisar conhecer todos os detalhes da infraestrutura. Eles precisam de uma API estável, latência previsível, custo rastreável e modos de falha recuperáveis.
Se sua equipe está decidindo se deve assumir a camada de serving, leia GPU cloud vs model API. A versão curta: assuma o serving em GPU quando controle de hardware, modelos personalizados, isolamento de dados ou economia unitária justificarem a carga operacional; use APIs de modelo quando velocidade, amplitude, failover e menor carga de plataforma forem mais importantes.
6. Observabilidade, avaliação e governança
Uma AI factory deve medir mais do que uptime. Ela deve monitorar volume de solicitações, latência, erros, retentativas, custo, escolha de modelo, versões de prompt, fontes de dados, filtros de segurança, pontuações de avaliação e saídas aceitas.
A governança fica ao lado da observabilidade. As equipes precisam de controles de acesso, logs de auditoria, regras de retenção, aprovação de fornecedores, limites para dados de clientes e caminhos de escalonamento para saídas inseguras ou de baixa qualidade. Sem esses controles, a fábrica pode escalar o risco mais rapidamente do que o valor.
7. FinOps e cadência operacional
As AI factories transformam computação em resultados, mas as equipes financeiras ainda precisam saber quanto esses resultados custam. O modelo operacional deve atribuir gastos por produto, ambiente, cliente, equipe ou fluxo de trabalho.
Métricas unitárias úteis incluem:
- Custo por saída aceita
- Custo por ação do usuário concluída
- Custo por chamada de ferramenta bem-sucedida
- Utilização de GPU por classe de carga de trabalho
- Desperdício de retentativas e falhas
- Taxa de acerto de cache
- Tempo de espera na fila
- Taxa de fallback de modelo
O valor da Flatkey é mais forte quando as equipes querem o uso de modelos e ferramentas em um livro-razão compartilhado, em vez de contas fragmentadas de provedores. Isso não substitui um cluster de GPU para infraestrutura personalizada, mas pode reduzir a complexidade para cargas de trabalho de modelo/API que não exigem controle direto do hardware.
O que é uma AI factory nos termos da NVIDIA?
Do que geralmente trata a discussão sobre o que é uma AI factory da NVIDIA? A NVIDIA usa o termo para descrever infraestrutura que transforma dados corporativos em inteligência, com GPUs, rede acelerada, software e padrões de implantação trabalhando juntos. Os materiais de AI factory da NVIDIA e a arquitetura de referência para empresas focam no design full-stack, não apenas em aceleradores individuais.
Esse enquadramento é útil, mas também pode inclinar os leitores para a visão de hardware. O comprador prático deve traduzir o conceito da NVIDIA em uma lista de verificação operacional:
- Quais cargas de trabalho precisam diretamente de GPUs da NVIDIA?
- Quais modelos são treinados, ajustados ou atendidos nessas GPUs?
- Quais fontes de dados alimentam os modelos?
- Qual stack de software agenda e monitora jobs?
- Quais aplicativos consomem as saídas?
- Qual equipe é responsável por confiabilidade, segurança e custo?
Jensen Huang frequentemente enquadra as AI factories como a próxima geração de data centers porque elas fabricam tokens ou inteligência a partir de dados e energia. Trate isso como a narrativa macro. Sua implementação ainda precisa de dimensionamento de cargas de trabalho, governança, design de nível de serviço e um modelo de custos.
O que é uma AI factory no contexto de negócios?
No contexto de negócios, uma AI factory é uma capacidade organizacional. Ela oferece às equipes uma forma repetível de lançar recursos de IA, fluxos de trabalho de agentes, copilotos internos, produtos de dados e operações automatizadas.
A fábrica deve responder a perguntas de negócio em termos operacionais:
| Business question | AI factory translation |
|---|---|
| Can we launch this AI feature safely? | Permissões de dados, avaliação do modelo, fallback, registros de auditoria |
| Can we scale without surprise cost? | Orçamentos, limites de taxa, livro-razão de uso, roteamento de modelos, utilização de GPU |
| Can we improve quality over time? | Loops de feedback, conjuntos de avaliação, testes de regressão, versionamento de prompts/modelos |
| Can teams reuse the platform? | APIs compartilhadas, templates, observabilidade, controles de acesso |
| Can we switch models or providers? | Camada de abstração, rotas compatíveis com OpenAI, benchmarks de modelos |
É também por isso que uma AI factory não é automaticamente o investimento certo para toda equipe. Se o produto precisa apenas de texto, imagem, vídeo, busca, navegador, enriquecimento ou chamadas de ferramentas de agentes padrão, um gateway gerenciado de modelos e ferramentas pode chegar à produção mais rápido. Se o produto precisa de pesos de modelo personalizados, controle de data plane privado, inferência de alto volume ou pipelines de mídia especializados, uma fábrica baseada em GPU pode ser justificada.
Construir, alugar ou usar APIs de modelos?
A estratégia certa de AI factory geralmente é híbrida.
Construa ou reserve capacidade de GPU quando:
- Você executa inferência estável e de alto volume e consegue manter as GPUs utilizadas.
- Você precisa de pesos de modelo personalizados, serving privado de modelos ou kernels especializados.
- Você consegue operar armazenamento, rede, agendamento, segurança e resposta a incidentes.
- O custo da carga de trabalho por saída aceita é menor após incluir todos os custos ocultos.
Alugue clusters de GPU quando:
- Você precisa de picos de treinamento, ajuste fino, avaliação ou inferência em lote.
- Você quer validar o formato da carga de trabalho antes de comprar ou reservar capacidade.
- Você precisa de aceleradores, regiões ou topologias específicas para um projeto definido.
- Você pode tolerar o trabalho de configuração e testes de aceitação.
Use APIs de modelo ou um gateway quando:
- Você precisa de acesso rápido a muitos modelos e modalidades.
- A carga de trabalho muda com frequência.
- O failover entre provedores importa mais do que o controle bruto do hardware.
- Sua equipe quer uma única chave de API, uma única fatura e controles de uso em vez de contas de provedores espalhadas.
- Você precisa de ferramentas como busca, automação de navegador, enriquecimento de dados ou APIs de mídia no mesmo fluxo de trabalho.
Para muitas equipes, a AI factory não é um único lugar. É um modelo operacional que abrange GPUs alugadas, APIs gerenciadas, serviços internos e ferramentas de agentes.
Checklist de avaliação de uma AI factory
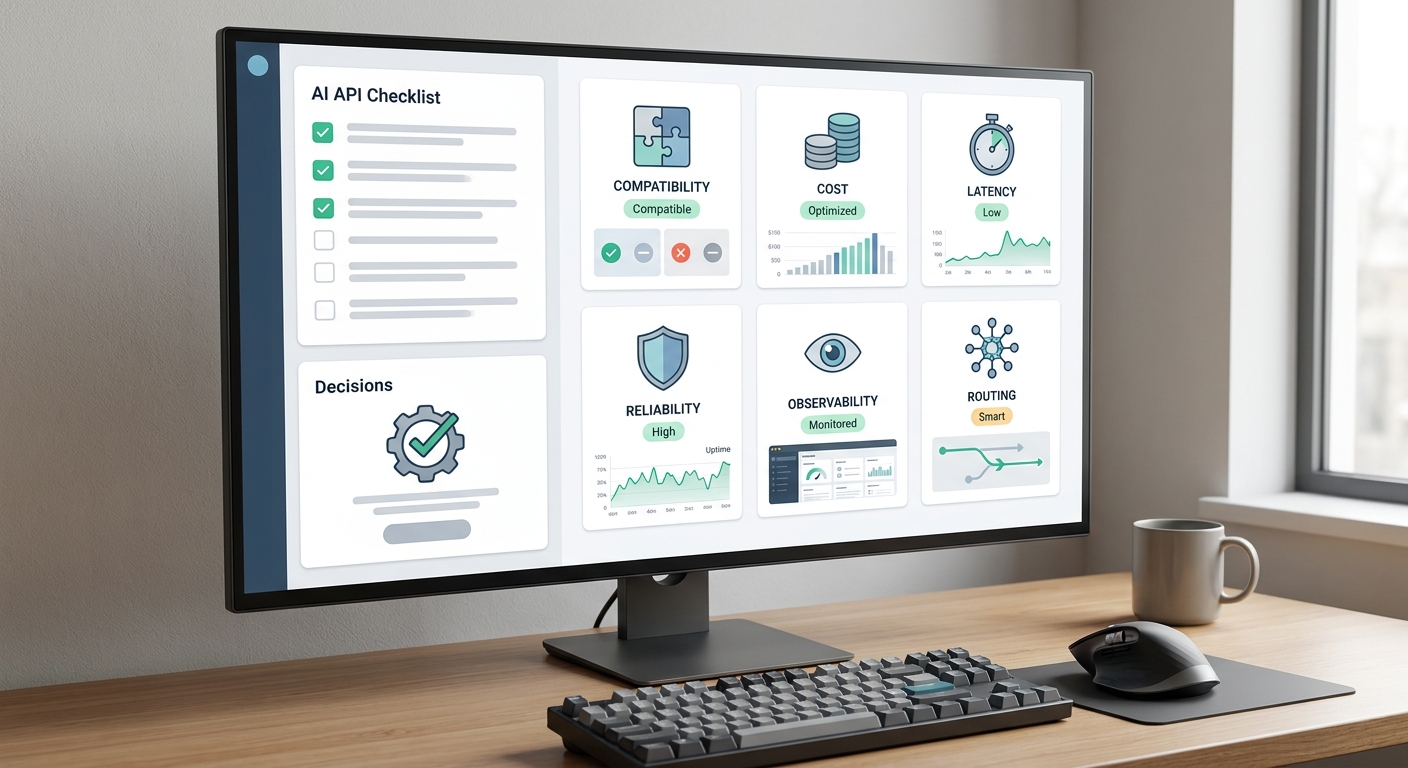
Antes de investir em uma plataforma de AI factory, faça estas perguntas:
- Workload: Estamos treinando, ajustando fino, gerando embeddings, atendendo, gerando mídia, executando agentes ou fazendo tudo isso?
- Latency: Quais cargas de trabalho são em tempo real, em lote, assíncronas ou com humano no loop?
- Data: Quais conjuntos de dados, documentos, logs e saídas de ferramentas alimentam o sistema, e quem pode acessá-los?
- Model strategy: Quais modelos são próprios, alugados, open-weight, de API de fronteira, multimodais ou especializados?
- Serving: Os aplicativos precisam de um endpoint interno estável, de uma API compatível com OpenAI ou de acesso direto ao cluster?
- Reliability: O que acontece quando um modelo, provedor, nó de GPU, caminho de armazenamento ou fila falha?
- Cost: Qual é o custo por saída aceita após retries, tempo ocioso, armazenamento, egress, engenharia e suporte?
- Governance: Como prompts, saídas, fontes de dados, usuários e versões de modelos são auditados?
- Portability: A carga de trabalho pode se mover entre provedores, regiões, famílias de modelos ou tipos de GPU?
- Ownership: Qual equipe será dona da fábrica após o lançamento?
Se sua equipe não consegue responder a essas perguntas, comece menor. Use APIs gerenciadas para o primeiro caminho de produção, meça o uso real e depois mova as cargas de trabalho que claramente justificam controle direto de GPU para uma plataforma de AI factory mais formal.
Erros comuns
O primeiro erro é tratar uma AI factory como um projeto de compras. Comprar GPUs não é o mesmo que construir um sistema de produção de IA.
O segundo erro é ignorar as operações de dados. Dados de baixa qualidade, permissões अस्प?