O que é um LLM gateway? Como funciona, recursos principais e 7 opções comparadas (2026)
Um LLM gateway é uma camada de API única entre sua aplicação e um ou mais provedores de modelos. Ele cuida de autenticação, roteamento, fallback, limites de taxa, controle de custos e logs, para que seu código chame um único endpoint em vez de se integrar a cada provedor separadamente. A maioria dos gateways expõe uma API compatível com OpenAI. Trocar de GPT para Claude, Gemini ou Qwen passa a ser alterar uma string model, e não lançar uma nova integração de SDK.
Este guia explica passo a passo como um LLM gateway funciona, os nove recursos que importam, como ele se diferencia de um API gateway, de um roteador de modelos e de um MCP gateway, quando você precisa (ou não) de um, e como sete gateways populares se comparam. Os dados de produto foram conferidos na documentação oficial de cada fornecedor em 20 de outubro de 2026.
Definição de LLM gateway
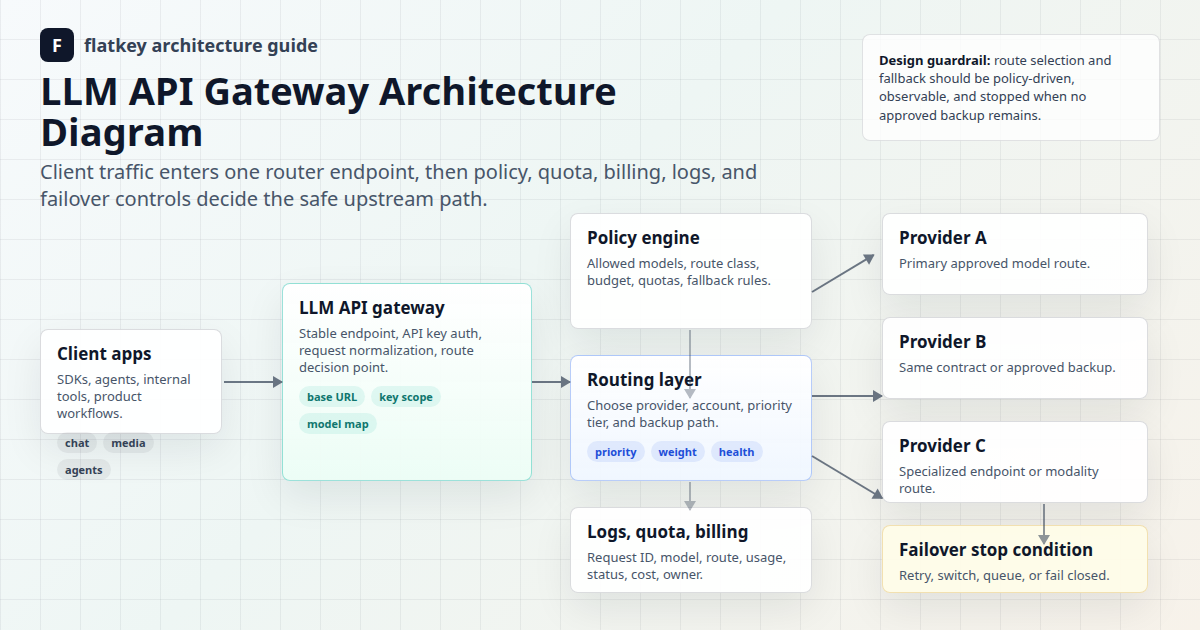
Um LLM gateway (também chamado de AI gateway ou LLM API gateway) recebe requisições de modelos das aplicações, aplica controles compartilhados, encaminha cada requisição para o endpoint de modelo adequado e devolve a resposta em um formato consistente.
Your apps ──► LLM gateway ──┬──► OpenAI
                            ├──► Anthropic
  one key                   ├──► Google
  one API shape             ├──► Alibaba (Qwen)
  one usage ledger          └──► fallback provider
O gateway não hospeda os modelos. Ele controla o acesso a eles.
Por que as equipes adotam um LLM gateway
Sem gateway, cada serviço guarda as próprias keys de provedor, implementa os próprios retries e registra o uso no próprio formato. Os problemas crescem a cada novo provedor:
| Sem gateway | Com gateway |
|---|---|
| Uma key por provedor e por serviço | Uma key de gateway por serviço, com rotação centralizada (guia de rotação de keys) |
| SDKs e formatos de erro diferentes | Um único formato de API, geralmente compatível com OpenAI |
| Uma queda exige mudança de código | Fallback é configuração |
| Gastos espalhados em várias faturas | Um único registro por equipe, key e modelo |
| Sem limites compartilhados | Cotas e orçamentos por key |
Os preços dos provedores também variam o bastante para que o roteamento valha a pena. Em 20 de outubro de 2026, os preços de tabela de saída nas páginas de modelos da Flatkey iam de US$ 0,47 por milhão de tokens (qwen3.8-flash) a US$ 10,00 (gpt-6-sol, claude-sonnet-5-5) e US$ 15,00 (kimi-k3). Um gateway permite aproveitar essa diferença sem reescrever código.
Como um LLM gateway funciona, passo a passo
- O app envia uma requisição para a base URL do gateway com uma key de gateway.
- Autenticação: o gateway valida a key e carrega a política dela (modelos permitidos, orçamento, limite de taxa).
- Política pré-requisição: verifica cotas e pode mascarar ou bloquear conteúdo e anexar metadados como equipe, ambiente ou funcionalidade.
- Roteamento: escolhe o endpoint do provedor para o modelo solicitado, ou a próxima rota saudável de uma cadeia de fallback.
- Chamada ao provedor: traduz a requisição para o formato do provedor, se necessário, e devolve a resposta em streaming.
- Registro: grava modelo, latência, tokens, custo, status e ID da requisição para observabilidade e faturamento.
Os 9 recursos de um LLM gateway que importam
| Recurso | O que verificar |
|---|---|
| API unificada | /v1/chat/completions compatível com OpenAI, além de Responses ou Messages se você usa |
| Catálogo de modelos | Quais modelos estão ativos e com que rapidez chegam os lançamentos |
| Fallback e failover | Cadeias ordenadas e o que as aciona (429, 5xx, timeout) |
| Balanceamento de carga | Entre keys, regiões ou provedores |
| Limites e orçamentos | Por key, equipe e modelo, com tetos rígidos |
| Observabilidade | Logs de requisições, uso de tokens, latência e erros, de preferência exportáveis pelas convenções GenAI do OpenTelemetry |
| Controle de custos | Por key, equipe e ambiente (guia de atribuição de custos) |
| Cache | Cache de respostas exato ou semântico, e repasse do prompt caching do provedor |
| Segurança e políticas | Escopo das keys, mascaramento de dados pessoais, termos de retenção, evidências SOC 2 ou DPA |
LLM gateway x API gateway x roteador de modelos x MCP gateway
| Camada | Controla | Entende tokens e modelos? | Exemplo |
|---|---|---|---|
| API gateway | APIs HTTP genéricas | Não | Kong, AWS API Gateway |
| LLM gateway | Tráfego de modelos entre provedores | Sim | LiteLLM, Portkey, Flatkey |
| Roteador de modelos | Qual modelo responde a cada prompt | Sim | RouteLLM, um motor de regras |
| MCP gateway | Chamadas de ferramentas de agentes via Model Context Protocol | Nível de ferramenta | Proxies e registros MCP |
Qual é a diferença entre um MCP gateway e um LLM gateway? Um LLM gateway governa chamadas para modelos. Um MCP gateway governa chamadas de agentes para ferramentas e fontes de dados pelo Model Context Protocol. Plataformas de agentes costumam precisar dos dois: um LLM gateway para o gasto com modelos e um MCP gateway para as permissões de ferramentas. Veja controles de gateway para agentes de IA e AI API gateway x gestão de APIs.
7 LLM gateways comparados (2026)
| Gateway | Implantação | Código aberto | Ponto forte | Atenção |
|---|---|---|---|---|
| LiteLLM | Proxy auto-hospedado ou SDK | Sim | Mais de 100 provedores, roteamento, orçamentos | Você opera, escala e aplica patches |
| Portkey | Hospedado ou auto-hospedado | Núcleo do gateway é aberto | Guardrails, observabilidade | Recursos avançados em planos pagos |
| Cloudflare AI Gateway | Hospedado no edge | Não | Cache, analytics, limite de taxa | Você ainda gerencia as keys dos provedores |
| Kong AI Gateway | Auto-hospedado ou Konnect | Núcleo é aberto | Encaixa na gestão de APIs Kong existente | Configuração de plugins trabalhosa |
| Vercel AI Gateway | Hospedado | Não | Integração estreita com Vercel e AI SDK | Melhor dentro do ecossistema Vercel |
| OpenRouter | Hospedado | Não | Catálogo de modelos muito amplo, créditos | Roteamento compartilhado estilo marketplace |
| Flatkey | Hospedado | Não | Uma key e um saldo para GPT, Claude, Gemini, Qwen, DeepSeek, Kimi, GLM, além de imagem e vídeo | Confira o catálogo para modelos de nicho |
Comparações detalhadas: guia para escolher o melhor LLM gateway, alternativas ao OpenRouter, alternativas ao Portkey, alternativas ao Vercel AI Gateway e gateway gerenciado x proxy auto-hospedado.
Como um LLM gateway aparece no código
Com um gateway compatível com OpenAI, seu app mantém o SDK da OpenAI e altera dois valores: a base URL e a key. Trocar de provedor vira uma troca de string.
curl
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "claude-sonnet-5-5", "messages": [{"role": "user", "content": "What is an LLM gateway?"}]}'
Python: um cliente, vários provedores, fallback automático
import os
from openai import OpenAI, APIError

gw = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

def complete(prompt, chain=("gpt-6-sol", "claude-sonnet-5-5", "gemini-3.5-flash")):
    for model in chain:
        try:
            r = gw.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
            return model, r.choices[0].message.content, r.usage.total_tokens
        except APIError as err:
            print(f"{model} -> {err.__class__.__name__}, trying next")
    raise RuntimeError("no route available")

print(complete("Give me one sentence on why gateways log token usage."))
Node.js
import OpenAI from "openai";
const gw = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

const models = ["qwen3.8-max", "gpt-6-luna"];
const results = await Promise.all(models.map((model) =>
  gw.chat.completions.create({ model, messages: [{ role: "user", content: "Define 'fallback' in 8 words." }] })
));
results.forEach((r, i) => console.log(models[i], r.usage.total_tokens, r.choices[0].message.content));
Sem gateway, isso exigiria três SDKs, três keys e três formatos de erro. Para a primeira chamada, siga o guia rápido da Flatkey.
Compatibilidade com OpenAI: o que garante e o que não garante
"Compatível com OpenAI" significa que o formato da requisição e da resposta segue a Chat Completions API da OpenAI. Não garante que todo modelo suporte todo recurso. Antes de migrar, teste por modelo:
- Chunks de streaming e valores de
finish_reason - Chamadas de ferramentas/funções e chamadas paralelas
- Saída estruturada ou modo JSON
- Entradas de imagem e arquivo
- Campos de
usage, incluindo tokens em cache - Códigos de erro para limite de taxa e estouro de contexto (taxonomia de erros)
Quando você precisa de um LLM gateway (e quando não)
Você provavelmente precisa se: - Chama dois ou mais provedores de modelos, ou pretende chamar. - Várias equipes ou serviços dividem o gasto com IA e precisam de orçamentos por equipe. - Precisa de failover durante quedas de provedores. - O financeiro precisa de um único registro em vez de cinco faturas.
Talvez ainda não precise se: - Tem um único protótipo em um único modelo, com pouco tráfego. - Seu contrato com o provedor exige acesso direto, sem intermediários.
Como avaliar um LLM gateway em uma tarde
- Teste de contrato: passe por ele suas 20 requisições mais comuns (streaming, ferramentas, JSON).
- Teste de falha: force um ID de modelo errado e um timeout. O fallback dispara e o erro é claro?
- Teste de overhead: compare a latência P50 e P95 com a chamada direta ao provedor.
- Teste de registro: os tokens registrados batem com o
usagedo provedor? O custo aparece por key? - Revisão de segurança: confira o escopo das keys, a retenção de logs e os termos de tratamento de dados (checklist de DPA).
- Teste de saída: dá para sair só voltando a base URL original?
Perguntas frequentes
O que é um LLM gateway?
Um LLM gateway é uma API intermediária entre aplicações e provedores de modelos. Ele centraliza autenticação, roteamento, fallback, limites de taxa, logs e controle de custos atrás de um único endpoint, geralmente compatível com OpenAI.
Quais são os LLM gateways mais populares?
Entre as opções mais usadas em 2026 estão LiteLLM (código aberto, auto-hospedado), Portkey, Cloudflare AI Gateway, Kong AI Gateway, Vercel AI Gateway, OpenRouter e roteadores hospedados como a Flatkey.
LLM gateway é gratuito?
Gateways de código aberto como o LiteLLM são gratuitos para rodar, mas você paga hospedagem e operação. Gateways hospedados cobram taxas de plataforma ou faturam o uso dos modelos com preços próprios. De qualquer forma, os tokens dos modelos continuam custando dinheiro.
Qual é a diferença entre um MCP gateway e um LLM gateway?
Um LLM gateway gerencia requisições a modelos de linguagem. Um MCP gateway gerencia requisições de agentes a ferramentas e fontes de dados pelo Model Context Protocol. Eles resolvem problemas diferentes e muitas vezes são implantados juntos.
LLM gateway é o mesmo que AI gateway?
Geralmente sim. "AI gateway" é o termo de marketing mais amplo e costuma incluir também modelos de imagem, vídeo e áudio. "LLM gateway" enfatiza os modelos de texto.
Um LLM gateway aumenta a latência?
Um pouco: um salto de rede extra mais as verificações de política. Meça o overhead P95 na sua região. Durante uma queda, o failover costuma economizar muito mais tempo do que esse salto custa.
Um LLM gateway reduz custos?
Sim, indiretamente. Ele facilita aplicar de forma consistente o roteamento para modelos mais baratos, o cache e os tetos de orçamento. Não torna mais baratos os tokens de um modelo específico, a menos que o próprio gateway ofereça tarifas com desconto.
Conclusão
Um LLM gateway transforma muitas integrações de provedores em um único endpoint controlado: uma key, um formato de API, um registro e o fallback como configuração. Escolha o auto-hospedado (LiteLLM, Kong) se quiser controle total e puder operá-lo. Escolha o hospedado (Portkey, Cloudflare, Vercel, OpenRouter, Flatkey) se preferir não operar infraestrutura. Para testar o caminho hospedado, veja o diretório de modelos da Flatkey e a página de preços.
Última atualização: 20 de outubro de 2026 · Flatkey Team. Os dados de produto resumem a documentação oficial com link no texto.