Что такое LLM-шлюз? Как он работает, ключевые функции и сравнение 7 решений (2026)
LLM-шлюз (LLM gateway) — это единый API-слой между вашим приложением и одним или несколькими провайдерами моделей. Он берёт на себя аутентификацию, маршрутизацию, fallback, rate limits, учёт затрат и логирование, поэтому ваш код обращается к одному эндпоинту, а не интегрируется с каждым провайдером по отдельности. Большинство шлюзов предоставляют OpenAI-совместимый API. Переход с GPT на Claude, Gemini или Qwen сводится к замене строки model, а не к выпуску новой интеграции SDK.
В этом руководстве по шагам разобрано, как работает LLM-шлюз, какие девять функций действительно важны, чем он отличается от API-шлюза, маршрутизатора моделей и MCP-шлюза, когда он нужен (а когда нет), и как соотносятся семь популярных шлюзов. Сведения о продуктах сверены с официальной документацией каждого вендора 20 октября 2026 года.
Определение LLM-шлюза
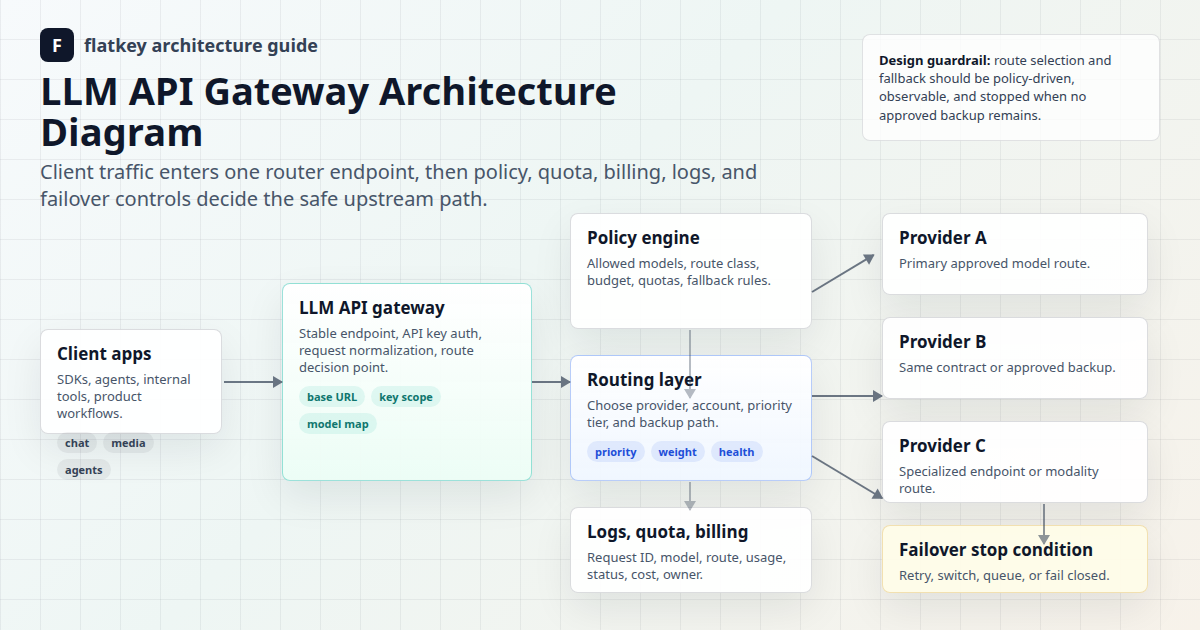
LLM-шлюз (его также называют AI-шлюзом или LLM API gateway) принимает запросы к моделям от приложений, применяет общие политики контроля, перенаправляет каждый запрос на подходящий эндпоинт модели и возвращает ответ в едином формате.
Your apps ──► LLM gateway ──┬──► OpenAI
                            ├──► Anthropic
  one key                   ├──► Google
  one API shape             ├──► Alibaba (Qwen)
  one usage ledger          └──► fallback provider
Шлюз не хостит модели. Он управляет доступом к ним.
Зачем командам LLM-шлюз
Без шлюза каждый сервис хранит собственные ключи провайдеров, реализует свои повторные попытки и пишет логи использования в своём формате. С каждым новым провайдером проблем становится больше:
| Без шлюза | Со шлюзом |
|---|---|
| Отдельный ключ на каждого провайдера в каждом сервисе | Один ключ шлюза на сервис с централизованной ротацией (гид по ротации ключей) |
| Разные SDK и форматы ошибок | Единый формат API, обычно OpenAI-совместимый |
| Сбой провайдера требует правки кода | Fallback задаётся конфигурацией |
| Расходы разбросаны по счетам | Единый журнал по командам, ключам и моделям |
| Нет общих лимитов | Квоты и бюджеты на уровне ключа |
К тому же цены у провайдеров различаются настолько, что маршрутизация приносит ощутимую пользу. На 20 октября 2026 года прейскурантные цены за выход на страницах моделей Flatkey составляли от $0.47 за 1 млн токенов (qwen3.8-flash) до $10.00 (gpt-6-sol, claude-sonnet-5-5) и $15.00 (kimi-k3). Шлюз позволяет использовать этот разброс без переписывания кода.
Как работает LLM-шлюз: по шагам
- Приложение отправляет запрос на base URL шлюза с ключом шлюза.
- Аутентификация: шлюз проверяет ключ и загружает его политику (разрешённые модели, бюджет, rate limit).
- Политика до запроса: проверяет квоты, может маскировать или блокировать контент и добавлять метаданные — команду, окружение, функцию.
- Маршрутизация: выбирает эндпоинт провайдера для запрошенной модели или следующий исправный маршрут в цепочке fallback.
- Вызов провайдера: при необходимости переводит запрос в формат провайдера и стримит ответ обратно.
- Запись: логирует модель, задержку, токены, стоимость, статус и ID запроса для наблюдаемости и биллинга.
9 функций LLM-шлюза, которые действительно важны
| Функция | Что проверить |
|---|---|
| Единый API | OpenAI-совместимый /v1/chat/completions, а также Responses или Messages, если вы их используете |
| Каталог моделей | Какие модели доступны и как быстро появляются новые релизы |
| Fallback и failover | Упорядоченные цепочки и условия срабатывания (429, 5xx, таймаут) |
| Балансировка нагрузки | Между ключами, регионами или провайдерами |
| Лимиты и бюджеты | По ключу, команде и модели, с жёсткими потолками |
| Наблюдаемость | Логи запросов, расход токенов, задержки и ошибки, в идеале с экспортом по конвенциям OpenTelemetry GenAI |
| Учёт затрат | По ключу, команде и окружению (гид по атрибуции затрат) |
| Кэширование | Точный или семантический кэш ответов и проброс prompt caching провайдера |
| Безопасность и политики | Области действия ключей, маскирование персональных данных, условия хранения данных, подтверждение SOC 2 или DPA |
LLM-шлюз, API-шлюз, маршрутизатор моделей и MCP-шлюз
| Уровень | Что контролирует | Понимает токены и модели? | Пример |
|---|---|---|---|
| API-шлюз | Обычные HTTP API | Нет | Kong, AWS API Gateway |
| LLM-шлюз | Трафик к моделям разных провайдеров | Да | LiteLLM, Portkey, Flatkey |
| Маршрутизатор моделей | Какая модель отвечает на каждый промпт | Да | RouteLLM, движок правил |
| MCP-шлюз | Вызовы инструментов агентами по Model Context Protocol | На уровне инструментов | MCP-прокси и реестры |
Чем MCP-шлюз отличается от LLM-шлюза? LLM-шлюз управляет вызовами к моделям. MCP-шлюз управляет вызовами от агентов к инструментам и источникам данных по Model Context Protocol. Агентным платформам часто нужны оба: LLM-шлюз для контроля расходов на модели и MCP-шлюз для прав доступа к инструментам. См. контроль AI-агентов через шлюз и AI API gateway и API management.
Сравнение 7 LLM-шлюзов (2026)
| Шлюз | Развёртывание | Open source | Сильная сторона | На что обратить внимание |
|---|---|---|---|---|
| LiteLLM | Self-hosted прокси или SDK | Да | 100+ провайдеров, маршрутизация, бюджеты | Эксплуатация, масштабирование и патчи на вас |
| Portkey | Облако или self-hosted | Ядро шлюза открыто | Guardrails, наблюдаемость | Продвинутые функции в платных тарифах |
| Cloudflare AI Gateway | Облако на edge | Нет | Кэширование, аналитика, rate limiting | Ключами провайдеров по-прежнему управляете вы |
| Kong AI Gateway | Self-hosted или Konnect | Ядро открыто | Вписывается в существующий Kong API management | Трудоёмкая настройка плагинов |
| Vercel AI Gateway | Облако | Нет | Тесная интеграция с Vercel и AI SDK | Лучше всего внутри экосистемы Vercel |
| OpenRouter | Облако | Нет | Очень широкий каталог моделей, кредиты | Общая маршрутизация в формате маркетплейса |
| Flatkey | Облако | Нет | Один ключ и один баланс для GPT, Claude, Gemini, Qwen, DeepSeek, Kimi, GLM, а также изображений и видео | Проверьте каталог на нишевые модели |
Подробные сравнения: гид по выбору LLM-шлюза, альтернативы OpenRouter, альтернативы Portkey, альтернативы Vercel AI Gateway и управляемый шлюз или self-hosted прокси.
Как LLM-шлюз выглядит в коде
С OpenAI-совместимым шлюзом приложение продолжает использовать OpenAI SDK и меняет всего два значения: base URL и ключ. Смена провайдера после этого — просто замена строки.
curl
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "claude-sonnet-5-5", "messages": [{"role": "user", "content": "What is an LLM gateway?"}]}'
Python: один клиент, несколько провайдеров, автоматический fallback
import os
from openai import OpenAI, APIError

gw = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

def complete(prompt, chain=("gpt-6-sol", "claude-sonnet-5-5", "gemini-3.5-flash")):
    for model in chain:
        try:
            r = gw.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
            return model, r.choices[0].message.content, r.usage.total_tokens
        except APIError as err:
            print(f"{model} -> {err.__class__.__name__}, trying next")
    raise RuntimeError("no route available")

print(complete("Give me one sentence on why gateways log token usage."))
Node.js
import OpenAI from "openai";
const gw = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

const models = ["qwen3.8-max", "gpt-6-luna"];
const results = await Promise.all(models.map((model) =>
  gw.chat.completions.create({ model, messages: [{ role: "user", content: "Define 'fallback' in 8 words." }] })
));
results.forEach((r, i) => console.log(models[i], r.usage.total_tokens, r.choices[0].message.content));
Без шлюза для этого понадобились бы три SDK, три ключа и три формата ошибок. Для первого вызова воспользуйтесь быстрым стартом Flatkey.
OpenAI-совместимость: что она гарантирует и чего нет
«OpenAI-совместимый» означает, что формат запросов и ответов соответствует Chat Completions API OpenAI. Это не гарантирует, что каждая модель поддерживает каждую функцию. Перед миграцией проверьте для каждой модели:
- Чанки стриминга и значения
finish_reason - Вызов инструментов/функций и параллельные вызовы
- Структурированный вывод или JSON-режим
- Входные изображения и файлы
- Поля
usage, включая кэшированные токены - Коды ошибок при превышении rate limit и контекста (таксономия ошибок)
Когда LLM-шлюз нужен (а когда нет)
Скорее всего, нужен, если: - Вы обращаетесь к двум и более провайдерам моделей или планируете это. - Несколько команд или сервисов делят расходы на AI и им нужны бюджеты по командам. - Нужен failover во время сбоев провайдеров. - Финансам нужен один журнал вместо пяти счетов.
Возможно, пока не нужен, если: - У вас один прототип на одной модели с небольшим трафиком. - Договор с провайдером требует прямого доступа без посредников.
Как оценить LLM-шлюз за один день
- Контрактный тест: прогоните через него 20 самых частых запросов (стриминг, инструменты, JSON).
- Тест отказа: подставьте неверный ID модели и вызовите таймаут. Срабатывает ли fallback и понятна ли ошибка?
- Тест накладных расходов: сравните задержку P50 и P95 с прямым вызовом провайдера.
- Тест журнала: совпадают ли залогированные токены с
usageпровайдера? Видна ли стоимость по ключу? - Проверка безопасности: изучите области действия ключей, срок хранения логов и условия обработки данных (чек-лист DPA).
- Тест выхода: можно ли уйти, просто вернув прежний base URL?
Вопросы и ответы
Что такое LLM-шлюз?
LLM-шлюз — это промежуточный API между приложениями и провайдерами моделей. Он централизует аутентификацию, маршрутизацию, fallback, rate limits, логирование и учёт затрат за одним эндпоинтом, обычно OpenAI-совместимым.
Какие LLM-шлюзы самые популярные?
Среди широко используемых в 2026 году — LiteLLM (open source, self-hosted), Portkey, Cloudflare AI Gateway, Kong AI Gateway, Vercel AI Gateway, OpenRouter и облачные маршрутизаторы вроде Flatkey.
LLM-шлюз бесплатный?
Open-source шлюзы, такие как LiteLLM, можно запускать бесплатно, но вы платите за хостинг и эксплуатацию. Облачные шлюзы берут плату за платформу либо выставляют счёт за использование моделей по собственным тарифам. В любом случае токены моделей стоят денег.
Чем MCP-шлюз отличается от LLM-шлюза?
LLM-шлюз управляет запросами к языковым моделям. MCP-шлюз управляет запросами агентов к инструментам и источникам данных по Model Context Protocol. Они решают разные задачи и часто разворачиваются вместе.
LLM-шлюз и AI-шлюз — это одно и то же?
Обычно да. «AI-шлюз» — более широкий маркетинговый термин, который часто охватывает также модели изображений, видео и аудио. «LLM-шлюз» делает акцент на текстовых моделях.
Добавляет ли LLM-шлюз задержку?
Немного: один дополнительный сетевой переход плюс проверки политик. Измерьте накладные расходы по P95 в своём регионе. Во время сбоя failover обычно экономит гораздо больше времени, чем стоит этот переход.
Может ли LLM-шлюз снизить затраты?
Да, косвенно. С ним проще последовательно применять маршрутизацию на более дешёвые модели, кэширование и бюджетные потолки. Сделать токены конкретной модели дешевле он не может, если только сам шлюз не предлагает скидочные тарифы.
Заключение
LLM-шлюз превращает множество интеграций с провайдерами в один управляемый эндпоинт: один ключ, один формат API, один журнал и fallback в виде конфигурации. Выбирайте self-hosted (LiteLLM, Kong), если нужен полный контроль и есть ресурсы на эксплуатацию. Выбирайте облачный вариант (Portkey, Cloudflare, Vercel, OpenRouter, Flatkey), если не хотите управлять инфраструктурой. Чтобы попробовать облачный путь, загляните в каталог моделей Flatkey и на страницу цен.
Последнее обновление: 20 октября 2026 года · Flatkey Team. Сведения о продуктах обобщены по официальной документации, ссылки на которую приведены в тексте.