NVIDIA H100 GPU:架构、性能与云端部署指南
NVIDIA H100 GPU 是一款基于 Hopper 代架构的数据中心加速器,专为 AI 训练、高吞吐量推理和技术计算打造。它在云端的价值并非仅仅来自一个醒目的 FLOPS 数值。真正有用的问题是:其内存容量、内存带宽、精度支持、GPU 间互连架构以及运维模型,是否与您需要运行的模型和服务相匹配。
对于 AI 开发者或 ML 基础设施工程师而言,NVIDIA H100 GPU 的决策包含三个层面:
- 模型、KV 缓存、优化器状态和工作空间能否在留有安全余量的情况下装入内存?
- 工作负载需要单个 GPU、紧密互连的多 GPU 节点,还是分布式集群?
- 在生产环境中完成监控埋点后,该部署能否满足延迟、吞吐量、可靠性和成本目标?
本指南将规格表转化为上述部署选择。它侧重于当前可验证的硬件事实和可重复执行的云端上线流程,而非未经验证的提供商价格快照。
NVIDIA H100 GPU 的设计用途
NVIDIA H100 GPU 基于 NVIDIA Hopper 架构。Hopper 引入了第四代 Tensor Core、支持 FP8 的 Transformer Engine、H100 SXM 配置中的 HBM3 内存、NVLink 以及多实例 GPU(MIG)能力。这些特性因不同原因而重要:
- Tensor Core 和 Transformer Engine会影响 AI 框架或推理引擎可使用哪些混合精度路径。
- HBM 容量和带宽会影响模型权重、激活值和 KV 缓存能否装入内存,以及受内存限制的工作负载能够多快地移动数据。
- NVLink 和系统拓扑会影响工作负载跨越多个 GPU 时的通信成本。
- MIG 可将受支持的 GPU 划分为相互隔离的实例,以运行较小且兼容的工作负载。
H100 产品家族并非单一的云端规格。在比较服务方案之前,请确定您查看的是 H100 SXM 系统、H100 NVL 配置,还是其他基于 H100 PCIe 的方案。外形规格和互连方式会改变适合的并行策略、调度方式和基准测试计划。
NVIDIA H100 GPU 架构:与部署相关的关键事实
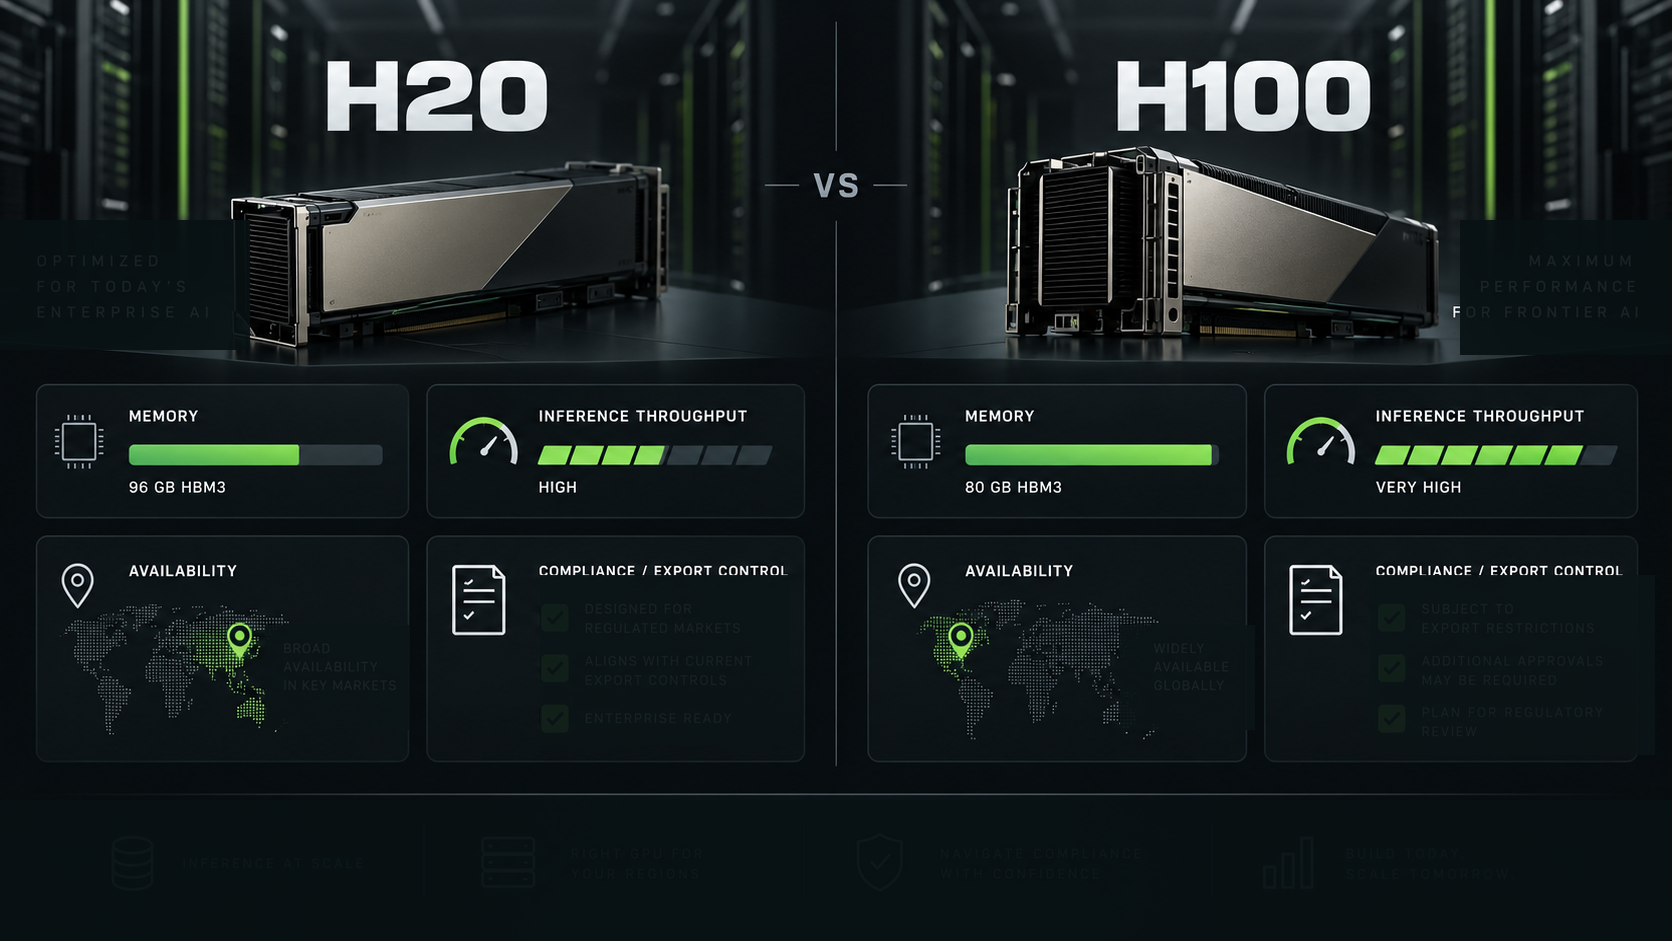
NVIDIA 标注 H100 SXM 配备 80 GB HBM3 内存、3.35 TB/s 的 GPU 内存带宽、最高 900 GB/s 的 NVLink 带宽,以及最多七个 10 GB 的 MIG 实例。NVIDIA 单独列出 H100 NVL,其配备 94 GB 内存、3.9 TB/s 带宽、最高 600 GB/s 的 NVLink 带宽,并采用双槽位、风冷式 PCIe 外形规格。应将这些视为产品配置事实,而非每个云端列表都会提供相同拓扑或可用容量的承诺。部署前请确认确切的实例规格。NVIDIA H100 产品规格
| 能力 | 其在云端部署中的重要性 | 提交使用承诺前应验证的内容 |
|---|---|---|
| HBM 容量 | 决定可用于权重、KV 缓存、激活值、工作空间和碎片化余量的空间。 | 每个 GPU 的确切显存、运行时启动后的可用内存,以及在目标上下文长度下 KV 缓存的峰值使用量。 |
| HBM 带宽 | 通常会影响受内存限制的推理和训练阶段。 | 在预期批量大小、序列长度和精度下,针对工作负载测得的 tokens/sec 或 steps/sec。 |
| Tensor Core 和 FP8 支持 | 当模型、框架和质量目标支持时,可启用高效的精度路径。 | 受支持的精度路径、校准或量化流程,以及质量回归标准。 |
| NVLink / NVSwitch 拓扑 | 当张量并行、流水线并行或数据并行工作进程交换大型张量时至关重要。 | GPU 数量、nvidia-smi topo -m 输出、互连架构健康状况,以及集合通信测试结果。 |
| MIG | 可提高兼容的小型工作负载的利用率,但会改变资源规格和隔离边界。 | 受支持的配置文件、调度器可见性、监控标签,以及每个租户是否需要完整 GPU。 |
NVIDIA 的 Hopper 架构细节说明了这些组件为何相互配合:第四代 Tensor Core 新增 FP8 和 Transformer Engine,而 H100 SXM 将 HBM3 与超过 3 TB/s 的内存带宽结合起来。NVIDIA Hopper 架构概览
不要将峰值算力作为部署预估
峰值 Tensor Core 吞吐量有助于进行硬件比较,但它并不是应用 SLA。在生产环境中,实测性能取决于模型架构、精度、批量大小、序列长度组合、内核选择、缓存、数据加载、通信开销以及服务级延迟限制。
对于新的 NVIDIA H100 GPU 部署,应首先定义工作负载验收测试。对于 LLM 服务,这通常包括首个 token 时间、token 间延迟、端到端 p50/p95 延迟、每秒可接受的输出 token 数、排队时间、错误率和质量检查。对于训练,应跟踪每步耗时、每秒样本数、检查点耗时、收敛行为和 all-reduce 健康状况。
在选择云服务合约之前,先选择 H100 拓扑
同一款加速器可以采用截然不同的部署方式。应从通信模式入手,而不是只看 GPU 名称。
| 部署模式 | 通常适用的情况 | 主要设计考量 |
|---|---|---|
| 一块 H100 GPU | 模型可容纳在单个设备上,或者您正在横向扩展前验证推理服务。 | 内存容量匹配、请求并发度、持久化存储以及清晰的基准测试基线。 |
| 单节点中两到四块 GPU | 模型或批处理需要分片,但单台主机可以容纳完整的服务或训练组。 | 拓扑、集合通信、CPU/RAM 平衡以及故障恢复。 |
| HGX 风格节点中四到八块 H100 SXM GPU | 工作负载可从紧密互连的多 GPU 域中受益。 | NVLink/NVSwitch 可见性、NCCL 验证、数据局部性以及协同发布。 |
| 多个节点 | 作业无法容纳在一个节点中,或者需要超过单个节点可提供的总吞吐量。 | 网络架构、存储吞吐量、检查点、rank 放置以及故障隔离。 |
| MIG 分区容量 | 多个兼容的较小工作负载可以共享一块物理 GPU,且每个工作负载都不需要完整设备容量。 | 配置文件大小、调度器策略、租户隔离以及每个切片的可观测性。 |
单 GPU VM 中的 NVIDIA H100 GPU 可以是合理的首个生产部署步骤。多 GPU H100 部署应被视为一个系统:主机拓扑、互连、网络、CPU、存储、软件栈和调度器都会影响最终结果。有关更全面的硬件系统视角,请参阅 Flatkey 的GPU 服务器部署指南。
实用的云端部署工作流程
1. 在配置资源前编写工作负载简介
记录使基准测试可复现的事实信息:
- 模型名称、修订版本、参数数量和精度。
- 目标上下文长度、输入/输出组合以及并发配置。
- 训练、微调、批量推理或在线服务目标。
- 延迟 SLO、吞吐量目标以及质量或准确率门槛。
- 所需区域、数据边界、持久化存储、网络暴露方式和恢复时间目标。
对于 LLM 推理,应将内存容量视为预算,而非仅计算模型权重:
required GPU memory = model weights + KV cache at target concurrency
                    + runtime workspace + communication buffers
                    + safety margin for fragmentation and rollout variance
正确的数值来自具有代表性的负载测试。即使模型能够成功启动,一旦 KV 缓存增长,仍可能无法满足其并发或长上下文目标。
2. 检查实例,而不只是加速器标签
在预留容量之前,记录云服务产品的确切详细信息:
- H100 型号、GPU 数量以及每个设备的 VRAM。
- GPU 间拓扑,以及该产品是否提供 NVLink 或由 NVSwitch 支持的节点。
- CPU 核心数、主机 RAM、本地 NVMe 和网络接口。
- 驱动程序、CUDA、容器运行时和框架兼容性。
- 容量是专用、可中断,还是受回收策略约束。
- 快照、检查点、私有网络和指标导出的工作方式。
应将新的 GPU 规格视为假设,而不是已完成的设计。在迁移流量或承诺长期预留之前,先运行小规模预检。
3. 验证硬件和网络架构
至少要确认操作系统、容器运行时和工作负载能够识别预期的设备。在多 GPU 节点上,记录拓扑并测试您的训练或服务引擎将使用的集合通信路径。
nvidia-smi
nvidia-smi topo -m

# Run inside the same CUDA-compatible image your workload will use.
nvidia-smi --query-gpu=name,memory.total,driver_version --format=csv
对于多节点作业,应将验收测试扩展至实际网络路径、rank 放置、存储读取、检查点写入和重启行为。仅有健康的 GPU 清单并不能证明分布式作业能够保持吞吐量。
4. 仅在 Kubernetes 能解决运维问题时使用它
当多个团队或服务需要调度、配额、隔离、可重复发布或集群范围可观测性时,Kubernetes 很有用。对于一台经过精心管理的 VM,它并非必需。
对于 Kubernetes 部署,NVIDIA 的 GPU Operator 可自动部署 NVIDIA 驱动程序、Container Toolkit、设备插件、GPU Feature Discovery、基于 DCGM 的监控以及相关 GPU 组件。其默认安装还会在 GPU 工作节点上部署 MIG Manager。安装前请查看当前的支持矩阵和安装前提条件——托管 Kubernetes 服务可能已经提供了部分组件栈。NVIDIA GPU Operator 文档 安装指南
最小设备请求有意保持简单:
resources:
  limits:
    nvidia.com/gpu: 1
该请求只是开始。在将工作负载视为可投入生产之前,还需添加节点选择策略、容忍度、资源配额、镜像兼容性检查、持久卷行为和服务级指标。如果您正在构建多节点运维,Flatkey 的Kubernetes GPU 集群指南涵盖了需要规划的平台级控制措施。
5. 审慎选择推理或训练技术栈
H100 硬件不会替您选择合适的运行时。应使用支持您的模型和运维约束的服务技术栈,然后通过贴近生产环境的流量对其进行验证。例如,TensorRT-LLM 为 NVIDIA GPU 上优化的 LLM 推理提供 API 和运行时;其性能仍需根据您的模型、精度、批处理策略和延迟目标进行测量。TensorRT-LLM 文档
对于生产推理上线:
- 从一个副本和具有代表性的请求追踪开始。
- 测量质量、延迟、吞吐量、内存、排队情况和错误行为。
- 每次只更改一个因素:精度、最大批次、上下文限制、张量并行度或副本数量。
- 在驱动程序、运行时、模型或拓扑发生变化后,重复相同测试。
- 逐步迁移流量,并保留使用最后一个已知良好构件的回滚路径。
6. 将 NVIDIA H100 GPU 作为服务的一部分进行监控
同时关注硬件和应用信号。NVIDIA H100 GPU 的满负载利用率可能表明批处理正常、请求路径停滞,或其他位置存在瓶颈;需要结合服务指标来解读。
| 层级 | 需关注的信号 |
|---|---|
| GPU | 利用率、已分配/保留内存、功耗、温度、时钟频率、ECC/Xid 事件和 MIG 配置文件。 |
| 互连 | GPU 拓扑、集合操作耗时、网络重传和 rank 不平衡。 |
| 运行时 | 队列深度、批次大小、缓存占用率、OOM/重启、请求取消和模型加载时间。 |
| 用户体验 | 首个 token 时间、token 间延迟、p50/p95 端到端延迟、成功请求数和质量评估。 |
| 成本与容量 | 付费实例时间、存储/网络费用、空闲时间、付费窗口内的利用率以及完成的成功工作量。 |
围绕用户可见的症状定义告警。例如,可针对持续恶化的 p95 首个 token 时间加上不断增长的队列发出告警,然后使用 GPU 和互连遥测数据调查原因。仅基于原始利用率的告警很少足够。
性能优化:安全的操作顺序
当 NVIDIA H100 GPU 服务未达到目标时,请按以下顺序进行优化:
- 确认目标。失败的是延迟、吞吐量、每项已完成任务的成本、质量,还是可靠性?
- 验证基线。使用相同的模型、镜像、驱动程序、拓扑和并发度重新运行相同追踪。
- 找出限制性资源。可能是 VRAM、内存带宽、计算能力、CPU 分词、PCIe/NVLink 通信、网络、存储或排队策略。
- 更改一个变量。例如批处理策略、最大上下文、张量并行度、精度、副本数量或缓存配置。
- 重新执行功能和质量验证。如果更快的输出会增加超时,或使模型质量超出可接受范围,那么这并非改进。
- 记录运行边界。记录设置、测量结果以及使该结果有效的条件。
这种方法可避免一个常见错误:当真正的瓶颈是过大的上下文策略、受 CPU 限制的请求路径或糟糕的流量拆分时,直接增加更多 GPU。
成本控制:避免脆弱的按小时价格比较
云端 H100 的定价、可用性和计费条款因提供商、区域、承诺方案和容量类型而异。不要将过时的价目表作为决策规则,而应比较已完成的工作:
每个成功结果的成本 =
  (GPU 实例时间 + 存储 + 网络 + 运维开销)
  / 同一测量窗口内的成功结果数
对于推理服务,请明确定义“成功结果”:已接受的 token、已完成的请求、生成的图像、已评估的文档,或任何满足您的质量和 SLO 门槛的其他输出。将已付费但处于空闲状态的时间和重试纳入计算。然后,当产品不需要 GPU 级控制时,将该数值与托管模型 API 替代方案进行比较。
使用 Flatkey 的自托管 LLM 每百万 token 成本指南获取可复现的成本模型,并使用GPU 云与模型 API 指南了解基础设施所有权与模型访问之间的决策边界。
NVIDIA H100 GPU 部署清单
在宣布服务就绪之前,请验证以下所有事项:
- [ ] 已记录精确的 H100 配置、显存、拓扑、CPU/RAM、存储和网络。
- [ ] 模型内存预算包括权重、KV 缓存、运行时工作空间、通信缓冲区和余量。
- [ ] 已在目标规格上测试驱动程序、CUDA、框架和容器镜像的兼容性。
- [ ] 单 GPU 以及(如相关)多 GPU 拓扑和集合通信测试均通过。
- [ ] 符合生产环境特征的追踪满足延迟、吞吐量、质量和错误目标。
- [ ] 可在一个运营视图中查看 GPU、互连、运行时、用户体验和成本信号。
- [ ] 已定义渐进式发布、回滚工件、检查点策略和事件负责人。
- [ ] 已将已完成工作成本与最可信的替代方案进行比较,而不只是比较 GPU 每小时价格。
H100 如何适配 AI GPU 选型
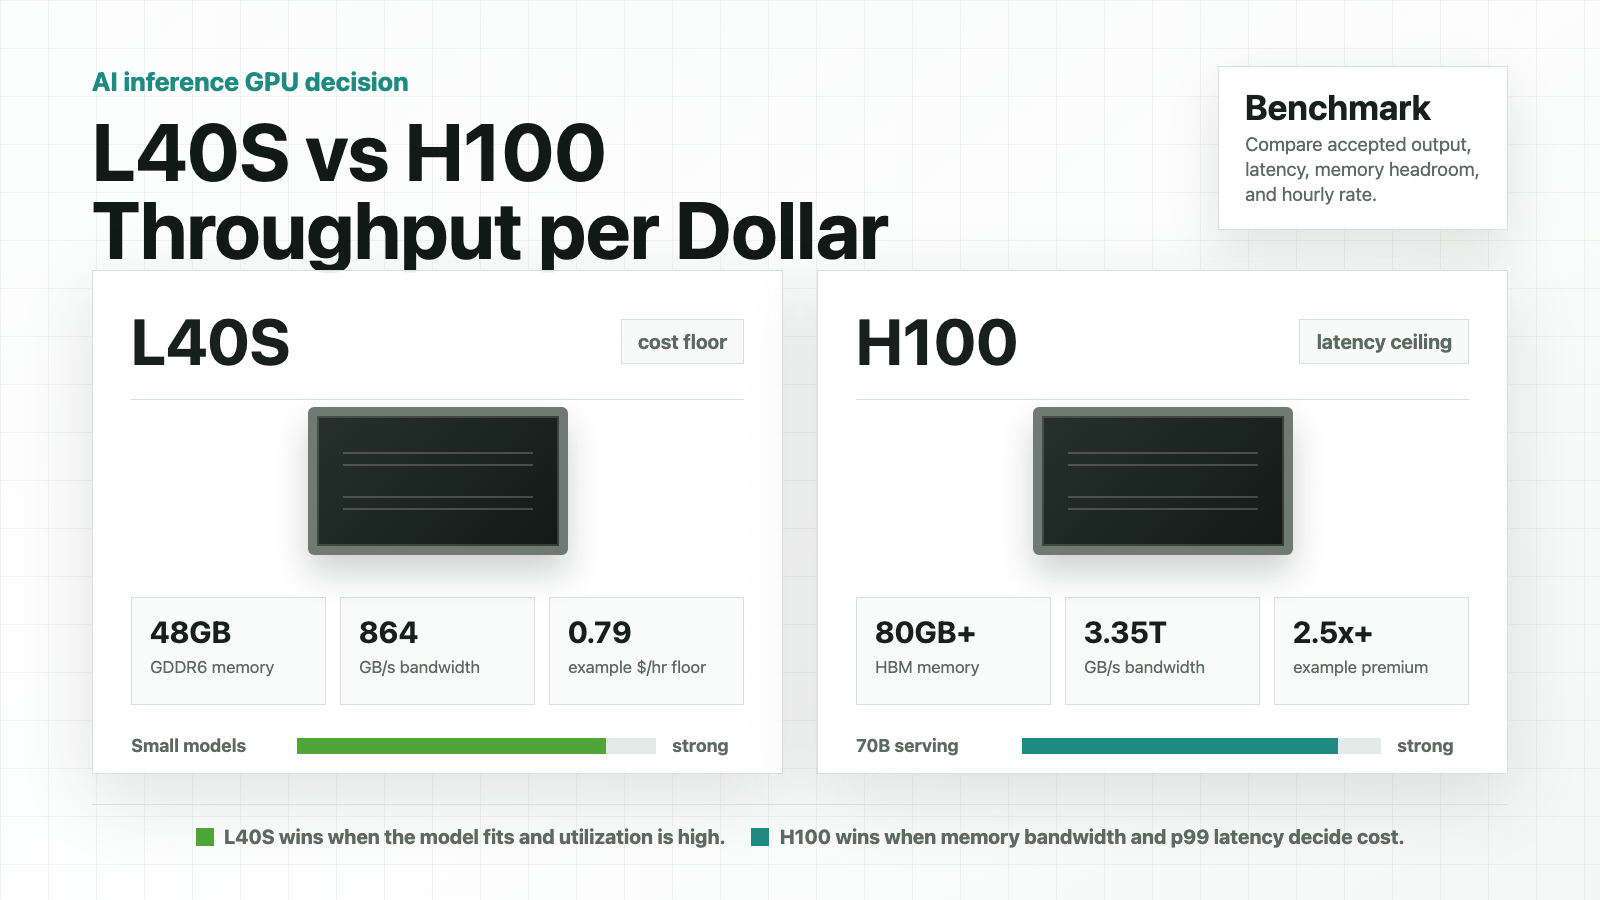
当工作负载可受益于 Hopper 时代的 Tensor Core 特性、高 HBM 带宽、多 GPU 拓扑,或部署需要控制运行时和数据流时,NVIDIA H100 GPU 是一个强有力的选择。它并非自动适合所有 AI 任务。当模型规模适中、需求呈突发性、团队无法运营 GPU 服务,或特定硬件优化不会改变产品结果时,更小型的加速器、更新的侧重内存的 GPU,或托管模型 API 可能更合适。
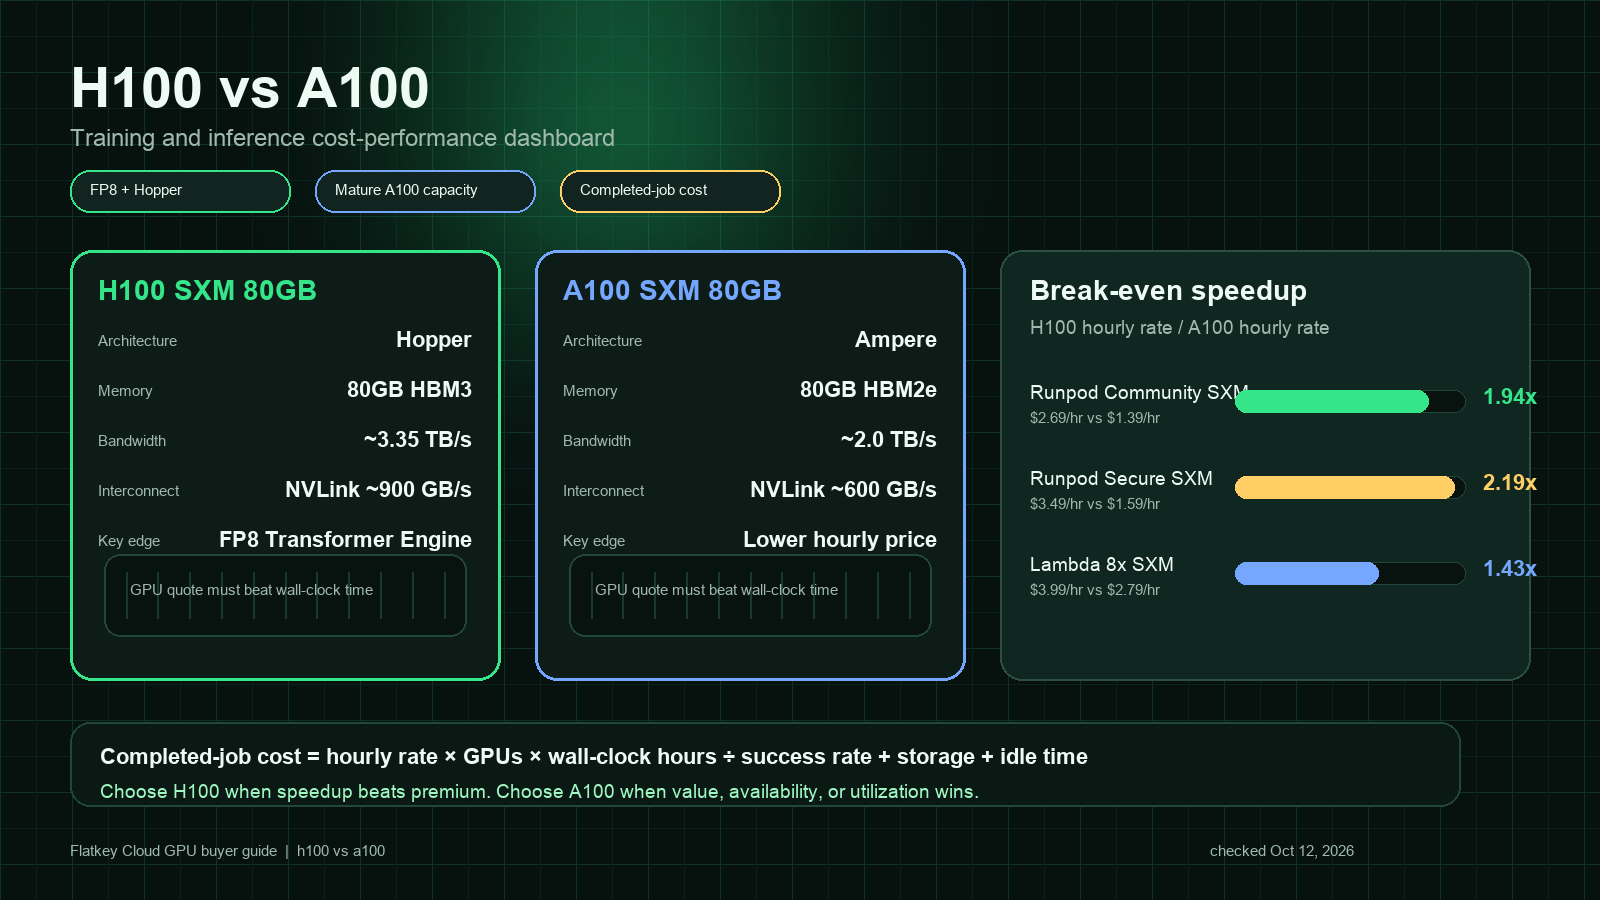
对于相关决策,在评估上一代产品时可比较 H100 与 A100;当更大的 HBM3e 容量可能改变推理适配性时,请阅读 H200 GPU 部署指南。
如需并排了解 H100 及其大内存同系产品,请阅读 H200 与 H100(2026)。
常见问题
NVIDIA H100 GPU 用于什么?
NVIDIA H100 GPU 用于 AI 训练、微调、LLM 推理、科学计算和其他加速工作负载。合适的配置取决于模型的内存占用、通信模式、精度、并发性和运营要求。
H100 SXM 与 H100 PCIe 或 H100 NVL 产品有何不同?
是的。外形规格、内存配置、NVLink 带宽、功耗范围、散热和系统拓扑可能各不相同。请阅读云服务产品的精确规格,而不要将“H100”视为完整的配置描述。
H100 有多少 GPU 内存?
NVIDIA 列出的 H100 SXM 配备 80 GB HBM3 内存,H100 NVL 配备 94 GB。正确的容量计算还必须包括运行时工作空间、KV 缓存、激活值或训练内存、通信缓冲区和安全余量。NVIDIA H100 规格
在云中运行 H100 工作负载需要 Kubernetes 吗?
不需要。对于单个且职责明确的工作负载,虚拟机可以是合适的起点。当需要调度、多租户、配额、可重复部署,或跨 GPU 工作节点的共享可观测性时,Kubernetes 会更有用。
对于 LLM 推理,我应该选择 H100 还是 H200?
应从内存和并发需求开始判断。如果目标上下文长度和 KV 缓存需要更多内存余量,H200 可能更合适;如果工作负载能够轻松容纳且基准测试满足 SLO,H100 部署可能已足够。应比较完整系统和已完成工作成本,而不是仅凭产品系列名称选择。
总结
只有当 NVIDIA H100 GPU 的架构与经过测量的工作负载及可靠的运营模型相结合时,它才能在生产环境中发挥价值。扩展部署前,请验证精确的云配置、模型内存预算、拓扑、运行时兼容性和验收指标。然后优化实际瓶颈——并按成功完成的工作比较成本,而不是根据 GPU 标签或孤立的每小时费率。
如果您仍在选择基础设施层,请使用 Flatkey 的AI GPU 选型指南,比较不同 GPU 系列和部署模型对工作负载的适配性。