
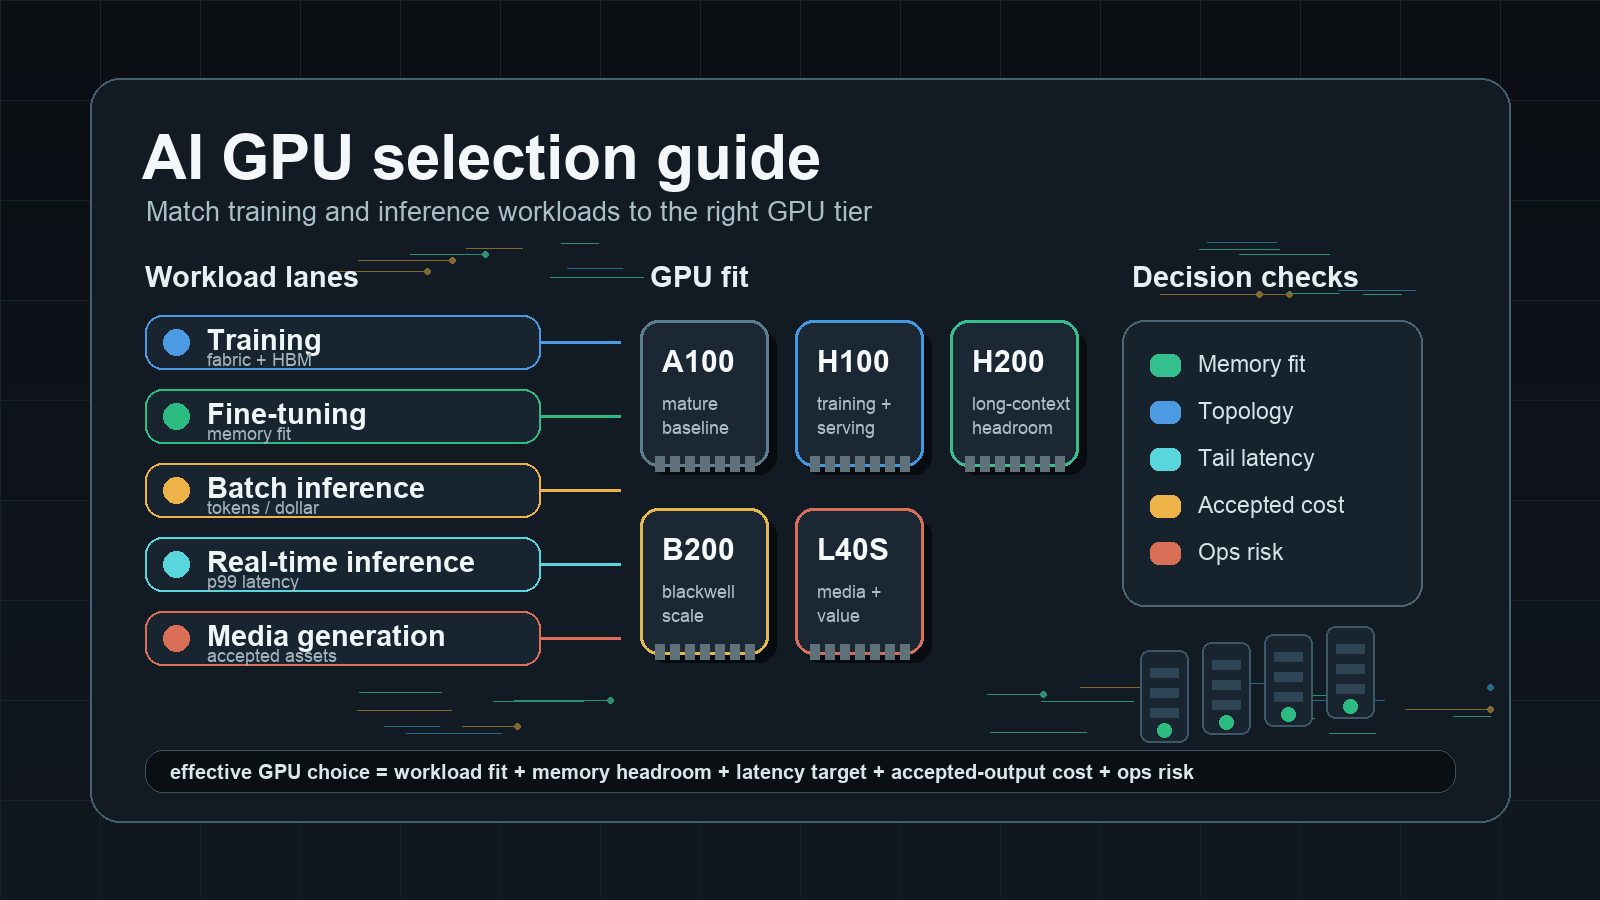
AI GPU 选型指南:为训练和推理工作负载匹配合适的 GPU
AI GPU 选型指南应从工作负载入手,而不是从最新加速器的名称开始。训练、微调、批量推理、实时推理、检索流水线、媒体生成以及评估任务会以不同方式对 GPU 施加压力。即使把错误的 GPU 放在费率卡上看起来很有吸引力,一旦把内存适配、网络拓扑、空闲时间、排队、服务栈工作量以及可接受的输出质量考虑进去,它仍可能表现不佳。
将这份 AI GPU 选型指南当作采购和架构检查清单来使用。它将常见 AI 工作负载与关键 GPU 特性对应起来,说明何时 H100、H200、B200、A100、L40S、GB200 级系统以及本地 RTX 级 GPU 是合适选择,并提供一套基准测试计划,让购买决策始终围绕已完成的工作,而不是合成的峰值数字。
Flatkey 的实用规则:按每次完成训练运行的成本、每个可接受 token 的成本、每个可接受图像或视频的成本,以及你愿意承担的运营风险来选择 GPU。如果你只需要模型访问、治理、故障切换和一份统一的使用台账,那么在承诺购买硬件之前,先比较 GPU 租赁与模型/API 路线。
AI GPU 选型指南快速答案
在比较服务商报价之前,先从这个矩阵开始。
| 工作负载 | 通常优先考虑 | GPU 方向 | 注意事项 |
|---|---|---|---|
| 预训练或大规模训练 | 多节点互联、HBM 容量、内存带宽、BF16/FP8 吞吐、检查点 I/O | H100/H200、B200/GB200 级系统、托管训练集群 | 每小时价格是次要因素,已完成运行时间和重启风险更重要 |
| 全参数微调 | 内存余量、优化器状态适配、张量并行、存储局部性 | H100、H200、B200,小模型可用 A100 | VRAM 不足可能迫使采用更慢的分片方式或更小的批量大小 |
| LoRA/QLoRA 微调 | VRAM 适配、CUDA 兼容性、每美元吞吐量 | A100、L40S、H100、H200,小任务可用高端本地 GPU | 数据集和上下文长度可能改变内存答案 |
| 批量 LLM 推理 | 内存适配、批处理效率、每美元 token 数、排队容忍度 | 根据模型大小选择 L40S、A100、H100、H200、B200 | 较低利用率可能抵消更便宜的 GPU 费率 |
| 实时 LLM 推理 | p95/p99 延迟、KV cache 容量、流式稳定性、服务框架支持 | 大型或长上下文模型用 H100/H200/B200;较小模型用 L40S/A100 | 尾延迟和重试比峰值 tokens/sec 更重要 |
| 嵌入和重排序 | 每美元吞吐量、CPU/GPU 平衡、批量大小、服务简洁性 | L40S、A100、更小的云 GPU,低流量时有时用 CPU | 低流量场景中 GPU 过度配置很常见 |
| 图像和视频生成 | VRAM、媒体内核、存储吞吐量、排队容忍度 | L40S;更重的流水线用 H100/H200/B200;创作者本地工作站可用 RTX 级 | 端到端可接受的图像/片段成本比原始渲染速度更重要 |
| 评估和合成数据 | 突发容量、成本控制、模型多样性 | 抢占式/市场型 GPU、批处理 API,或模型/API 路线 | 避免为偶发峰值持有闲置容量 |
这个快速答案有意不是“买最快的 GPU”。对于企业 AI 团队而言,最佳 GPU 是那种与模型、上下文长度、延迟目标、并发量、数据边界以及团队运营模式相匹配的 GPU。
步骤 1:对工作负载进行分类
任何 AI GPU 选型指南的第一步都是工作负载分类。没有它,后续所有比较都会退化成一场通用加速器之争。
每一次 GPU 讨论都应从工作负载简报开始。在向供应商索取报价之前,把它写下来。
| 字段 | 需要记录的内容 |
|---|---|
| 工作负载类型 | 训练、微调、批量推理、在线推理、媒体生成、嵌入、评估或笔记本 |
| 模型形态 | 参数量、架构、精度、量化、上下文窗口、多模态和分词器行为 |
| 请求形态 | 平均和 p95 输入 token、输出 token、图像尺寸、视频长度、批量大小、并发会话数或每个作业的记录数 |
| 成功单位 | 完成的训练运行、可接受的补丁、可接受的响应、可接受的 token、可接受的图像、可接受的片段或可接受的记录 |
| 延迟目标 | 离线、分钟级、秒级、亚秒级、p95/p99 要求或流式要求 |
| 运行周期 | 始终在线、定时批处理、季节性突发、实验性或开发者笔记本 |
| 运营边界 | 公有云、私有网络、专用集群、本地部署、数据驻留或托管 API |
| 工具链 | vLLM、SGLang、TensorRT-LLM、Triton、Ray、Slurm、Kubernetes、ComfyUI 或供应商托管端点 |
如果你无法填写这张表,就先暂停 GPU 选型。此时你购买的仍只是可能性,而不是容量。
步骤 2:选择正确的决策指标
AI GPU 选型指南的第二步是选择分母。一个好的分母会把 GPU 决策与已完成的工作联系起来,而不是与供应商的规格表联系起来。
峰值 FLOPS、Tensor Core 数量和每小时 GPU 价格都是有用的输入,但它们不是决策指标。应使用与业务产出挂钩的分母。
| 工作负载 | 更好的指标 |
|---|---|
| 训练 | 达到目标评估分数的已完成训练运行成本 |
| 微调 | 每个被接受的微调检查点成本 |
| 在线推理 | 在 p95/p99 延迟目标下每个被接受响应的成本 |
| 批量推理 | 每条被接受记录或每个被接受输出 token 的成本 |
| 代码代理 | 每个被接受任务、被接受补丁或已解决问题的成本 |
| 图像生成 | 质量过滤后每张被接受图像的成本 |
| 视频生成 | 每个被接受秒数或被接受片段的成本 |
| 评估 | 每套已完成评估套件的成本以及回答所需时间 |
使用这个基础公式:
effective_unit_cost =
  all_in_workload_cost
  / accepted_outputs_after_retries_failures_and_quality_filters
对于训练:
training_run_cost =
  gpu_hours
  + storage
  + network
  + checkpointing
  + failed_run_waste
  + platform_labor
对于推理:
inference_cost_per_accepted_output =
  gpu_compute
  + storage
  + serving_stack
  + idle_capacity
  + retry_waste
  + observability
  + platform_labor
  / accepted_outputs
这就是 GPU 选择会发生变化的地方。一个在吞吐量基准测试中胜出的 GPU,如果需要昂贵的拓扑、运行利用率低、无法满足延迟目标,或者迫使增加运维工作,也可能落败。
训练 GPU 选型
对于训练,AI GPU 选型指南应当像集群指南一样发挥作用。单个 GPU 很重要,但部署位置、互联、存储和重启行为往往决定已完成运行的成本。
训练需要大显存、高内存带宽、高速 GPU 互联、稳定的多节点部署以及可靠的检查点。它比推理更不宽容,因为一个故障节点就可能浪费数小时甚至数天的算力。
训练中最重要的因素
- HBM 容量:模型参数、梯度、优化器状态、激活、序列长度和批大小都会争夺显存。
- 内存带宽:大型矩阵运算和优化器步骤可能受带宽限制。
- 互联:NVLink、NVSwitch、InfiniBand、RoCE、EFA 或供应商特定的 AI fabric,都会决定扩展是否高效。
- 精度支持:只有当你的框架和模型配方能安全使用 BF16、FP8 及更新的低精度路径时,它们才真正重要。
- 存储和检查点 I/O:检查点写入时间和恢复时间都是已完成运行成本的一部分。
- 部署可靠性:散落在薄弱 fabric 上的合适 GPU,并不等同于一个连贯的训练集群。
训练 GPU 方向
当你需要经过验证的 Hopper 级训练支持和广泛的框架成熟度时,使用 H100 或 H200。H200 的 HBM 容量和带宽都比 H100 更高,这对内存密集型训练和微调很有帮助。当工作负载能够受益于 Blackwell 级吞吐量、更低精度路径,并且供应商确实能交付你所需的拓扑、框架支持和验收测试时,使用 B200 或 GB200 级系统。如果模型较小、训练配方成熟、预算受限,或可用性比峰值性能更重要,则使用 A100。
不要仅凭单一基准测试来选择训练 GPU。运行你实际的配方或接近的代理方案。衡量达到目标评估分数所需时间、重启行为、检查点时间和总成本。H100 对比 A100 以及 H200 对比 H100 的决策,通常是已完成运行层面的决策,而不是按小时费率的决策。
相关延伸阅读:H100 vs A100、H200 vs H100、B200 vs H200,以及 B300 vs B200。
微调 GPU 选型
微调介于训练和推理之间。完整微调的行为更像训练,而 LoRA 和 QLoRA 如果模型大小、上下文长度、批大小和精度得到控制,则可以运行在更小的硬件上。
完整微调
对于完整微调,优先考虑显存和拓扑。GPU 必须能够容纳训练状态,或者高效地对其进行分片。H100、H200、B200,以及多 GPU A100 集群,都是常见方向,具体取决于模型大小和预算。H200 和 B200 级 GPU 可以降低内存密集型任务的分片压力,但前提是供应商栈和框架版本已经准备就绪。
需要询问的问题:
- 你必须微调的最大模型和上下文长度是多少?
- 优化器状态是完全加载、分片、卸载还是量化的?
- 该任务是否需要张量并行、流水线并行、FSDP、DeepSpeed 或其他分布式方法?
- 数据集是否位于 GPU 所在区域本地?
- 一次失败的检查点代价有多高?
适配器微调
对于 LoRA、QLoRA、指令微调和较小的领域适配,答案可以更灵活。A100、L40S、H100、H200 以及本地 RTX 级 GPU 都可能适合工作流的不同部分。风险在于认为一个小型演示就意味着生产任务也能放得下。更长的上下文、更大的批大小、更多示例以及验证运行,都可能把任务推向不同的类别。
这里很适合运行一个两阶段基准测试:先验证内存是否能装下,再验证到检查点的时间以及每个被接受的微调模型的成本。
LLM 推理 GPU 选型
对于推理,AI GPU 选型指南应将内存适配与延迟适配区分开来。GPU 可能可以加载模型,但仍然达不到生产环境的 p99 目标。
推理并不是单一工作负载。合适的 GPU 会因模型大小、上下文长度、并发数、延迟目标,以及请求是批处理还是实时而变化。
首先要看内存是否适配
对于 LLM 推理,GPU 显存必须同时容纳模型权重和 KV cache,并为服务框架留出足够空间。长上下文和高并发会让 KV cache 成为主要的内存压力来源。一个能在单用户场景下运行模型的 GPU,到了生产级并发下可能就不行了。
使用这个检查清单:
- 按你的精度计算的权重大小:FP16、BF16、FP8、INT8、INT4,或其他量化格式。
- 上下文窗口和预期的 p95 输入长度。
- 输出长度和流式行为。
- 并发会话数和批大小。
- KV cache 策略、前缀缓存和驱逐行为。
- 服务框架开销。
- 为峰值和碎片化预留的安全余量。
如果内存很紧张,更大显存的 GPU 可能会胜过理论上更快但显存更小的 GPU,因为它避免了分片、卸载或较低质量的量化。
实时推理
实时推理关注的是 p95 和 p99 延迟,而不仅仅是平均吞吐量。对于大模型、长上下文以及对延迟敏感的工作负载,H100、H200 和 B200 级 GPU 通常更适合。对于较小模型、较低并发,或者 p99 目标更宽松的工作负载,L40S 和 A100 可能更具成本效益。
测量以下指标:
- 首 token 时间。
- token 间延迟。
- 端到端 p95/p99 延迟。
- 每张 GPU 的每秒 token 数。
- 每美元可接受的 token 数。
- 突发流量下的错误率。
- 在速率限制、OOM 或部署期间的重试放大效应。
关于服务栈选择,请参考 vLLM vs SGLang 和 vLLM deployment guide。
批处理推理
批处理推理可以用延迟换吞吐量,这也会带来更多 GPU 选择。只要模型能装下且利用率足够高,L40S、A100、H100、H200 和 B200 都可能适合。决定性指标通常是整个批处理窗口内每美元可接受的输出数。
如果可以控制重试行为,批处理工作负载也很适合使用 spot、预留窗口或 serverless GPU 容量。如果同一批任务能够交给模型 API 且运维负担更低,请使用 GPU cloud vs model API 工作表对两种路径进行比较。
媒体生成 GPU 选型
图像和视频生成的行为通常与文本推理不同。VRAM、模型流水线复杂度、存储 I/O 和排队容忍度,比对话延迟更重要。
L40S 往往对图像和较小的媒体工作负载很有吸引力,因为它具有较强的推理和图形特性,而且采购层级比 H100 级 GPU 更低。当工作负载更重、更大、多模态或对延迟有更严格约束时,H100、H200 和 B200 就更相关了。本地 RTX 级工作站对创作者、原型验证和低量流水线很有用,但生产团队仍然需要排队、存储、重试和可观测性。
请使用每张被接受图片或片段的成本,而不是原始渲染时间:
media_accepted_cost =
  gpu_cost
  + storage
  + failed_renders
  + moderation_or_quality_filtering
  + queue_overhead
  + operator_review
  / accepted_assets
如果你的团队只是需要访问多个图像或视频模型,那么模型/API 路线可能比运行 GPU 媒体流水线更简单。请像对文本工作负载那样使用同样的采购标准:按每个被接受结果的成本,而不是只看标价。
GPU 型号速查表
将这张表作为起点,然后在官方提供商页面上核实当前规格和可用性。不要把它当作价格表。
| GPU 家族 | 实际角色 | 最适配信号 | 常见注意事项 |
|---|---|---|---|
| NVIDIA A100 | 训练和推理的成熟基线 | 现有方案、40GB/80GB 版本、广泛的云可用性、预算敏感型工作负载 | 较老一代;相比 H100/H200/B200,内存带宽和新的精度路径更低 |
| NVIDIA H100 | Hopper 级训练和推理主力 | 较强的框架成熟度、FP8 Transformer Engine 支持、高内存带宽、NVLink/NVSwitch 选项 | 供应和价格仍可能受限;对于超长上下文/高并发推理,内存可能偏紧 |
| NVIDIA H200 | 更大内存的 Hopper 选项 | 相比 H100 具备更大的 HBM 容量和带宽;适合长上下文推理和内存密集型任务 | 可用性和价格因情况而异;应针对你的具体工作负载与 H100 进行基准对比 |
| NVIDIA B200 | Blackwell 级加速器 | 重负载训练和推理、更低精度的新路径、大内存和高带宽 | 需要软件栈就绪、供应商可用性以及拓扑验证 |
| NVIDIA GB200 / 机架级系统 | 大规模训练和高密度推理 | 集群级任务,其中系统架构与 GPU 芯片同样重要 | 采购和运维是系统层面的决策,而不是单卡决策 |
| NVIDIA L40S | 成本敏感型推理和媒体处理 | 48GB 级内存、图像/视频管线、更小的 LLM 推理、批处理任务 | 在大规模训练或严格的 p99 LLM 推理上,不能作为 H100/H200 的通用替代品 |
| RTX 级本地 GPU | 本地实验和创作者工作流 | 原型验证、小模型、私有工作站迭代 | 内存有限、数据中心运维能力较弱,本身并不构成生产集群 |
这张表揭示了一个重要的采购事实:GPU 型号只是答案的一部分。节点形态、存储、调度器、互连、配额模型和支持质量,都会决定 GPU 是否真正有用。
采购检查清单
在购买或租用之前,向供应商索取以下细节。
硬件与拓扑
- 确切的 GPU 型号、显存容量、节点形态以及每节点 GPU 数量。
- 节点内和节点间的互连。
- CPU、RAM、本地 NVMe、存储带宽和网络带宽。
- 区域、可用区、放置组、机架或专用集群假设。
- GPU、节点、存储和网络设备故障后的更换流程。
软件栈
- 驱动、CUDA、cuDNN、NCCL、容器运行时以及受支持的框架版本。
- Kubernetes、Slurm、托管端点或裸机访问模式。
- vLLM、SGLang、TensorRT-LLM、Triton、Ray 或媒体管线支持。
- GPU 利用率、显存、排队等待、延迟、错误和支出的可观测性字段。
- 升级和回滚流程。
商业模式
- 按需、抢占式、预留、市场、专用集群、私有云或托管端点。
- 最低承诺、取消权、超额费率和支持等级。
- 存储、出站流量、快照、公网 IP、负载均衡器和私有网络成本。
- 使用导出格式和账单粒度。
- 闲置容量是否计费,以及关停自动化如何工作。
安全与治理
- 网络边界、VPC/VNet 模型、私有端点支持和出站策略。
- IAM、密钥管理、审计日志、支持访问和事件通知。
- 数据存储、检查点保留、备份、删除和法律保全。
- 合规证明和供应商审查支持。
- 按团队预算、配额、标签以及 chargeback/showback 支持。
这份清单适用于公有 GPU 云、私有 GPU 云和 GPU 集群租赁。承诺越深,你应要求的证据就越多。
基准测试计划:如何在承诺前进行测试
AI GPU 选型指南的这一部分应该成为你的采购证据。保存输入、输出和验收标准,以便财务和平台团队日后复核该决策。
运行一个看起来像你实际工作负载的基准测试。不要只依赖公开的基准表。
阶段 1:显存适配测试
- 加载完全相同的模型,或最接近的代理模型。
- 使用预期的精度和量化方式。
- 设置目标上下文长度和批大小。
- 运行具有代表性的提示词或记录。
- 记录峰值显存、碎片化、OOM 率以及安全余量。
阶段 2:吞吐量与延迟测试
- 测试稳定流量和突发流量。
- 测量 p50、p95 和 p99 延迟。
- 测量流式 LLM 工作负载的首 token 时间。
- 测量 tokens/sec、images/hour、clips/hour 或 records/hour。
- 记录被接受的输出,而不仅仅是生成的输出。
阶段 3:故障与运维测试
- 终止一个 worker、排空一个节点、重启服务栈,并模拟一次错误部署。
- 验证训练和微调的检查点恢复。
- 检查冷启动时间和模型加载时间。
- 确认平台、安全和财务团队都能获取日志和指标。
- 验证成本归因在重试和故障后仍然有效。
第4阶段:财务归一化
为每个候选项创建一行:
| 候选项 | GPU 成本 | 存储/网络 | 平台人力 | 故障浪费 | 被接受的输出 | 有效单位成本 | 备注 |
|---|---|---|---|---|---|---|---|
| Provider A H100 | 来自报价输入 | 增加经来源核实的额外费用 | 估算 | 实测 | 实测 | 计算得出 | 包含 p95 延迟 |
| Provider B H200 | 来自报价输入 | 增加经来源核实的额外费用 | 估算 | 实测 | 实测 | 计算得出 | 包含内存余量 |
| Model/API route | 来源核实的 API 成本 | 网关/运维成本 | 较低的运维估算 | 实测重试 | 实测 | 计算得出 | 包含质量验收 |
这将 AI GPU 选型指南转化为一份财务、平台和产品都可以审阅的决策记录。
租用、预留、购买,还是使用模型 API?
本 AI GPU 选型指南的最后一步,是决定容量应当租用、预留、购买,还是通过模型 API 避免使用 GPU。
GPU 模型选择和容量模型选择是两个不同的决策。
| 场景 | 更好的起点 |
|---|---|
| 需求不确定、模型变化频繁,或原型阶段 | 模型 API 或短期租用 |
| 波动性的实验和评估任务 | 现货/市场 GPU 或批处理模型 API |
| 在单一模型上的稳定高量推理 | 预留 GPU、专用端点,或承诺型集群 |
| 具有拓扑要求的多节点训练 | 专用训练集群或预留高速互联 |
| 严格的私有网络或硬件隔离 | 私有 GPU 云或专用集群 |
| 需要多个官方模型、一个账单和故障切换 | 由 Flatkey 管理的模型/API 路由 |
如果支持 GPU 的论据主要是“我们需要访问 AI 模型”,那就从模型/API 路由开始。如果论据是“我们需要控制拓扑、运行时、权重、数据边界或自定义内核”,那就保留 GPU 路径。这个区别很重要,因为 GPU 基础设施意味着调度器、运行时、安全、FinOps 和事故责任都由你来负责。
Flatkey 可帮助处理该决策中的 API 侧:一个密钥、一个余额、一张账单、使用台账控制,以及官方模型/工具路由。当硬件控制才是要求时,它不是硬件控制的替代品;当真正的需求是受管控的模型访问和成本可见性时,它是更简单的替代方案。
GPU 选型中的常见错误
错误 1:按小时费率选择
小时费率忽略了利用率、重试、空闲时间、存储、网络、支持和工程师时间。应使用已完成工作负载成本。GPU 租用价格指南涵盖了隐藏成本项。
错误 2:把显存匹配当作是/否问题
在某个提示长度或 batch size 下显存足够,并不能证明生产环境也足够。长上下文、高并发、模型切换以及服务框架开销都可能改变答案。
错误 3:忽略互联
对于多 GPU 和多节点任务,拓扑是 GPU 的一部分。一个更便宜但放置不佳的 GPU 池,可能不如一个更昂贵但拓扑一致的集群。
错误 4:基准测试生成输出,而不是被接受的输出
AI 工作负载包含质量过滤、安全过滤、重试、失败的生成、失败的补丁以及失败的评测。应测量被接受输出的成本。
错误 5:忘记平台责任
总得有人负责驱动、CUDA、容器、模型服务器、自动扩缩容、配额、日志、告警、事故和支出报告。如果没有这样的团队,就要把这部分计入成本。
错误 6:只为今天的模型购买
模型选择会变化。上下文窗口会变大。量化会改进。供应商可用性也会变化。保持决策记录的灵活性,避免基于某一个模型会一直占主导地位的假设做承诺。
需要核查的官方来源
对于波动性强或供应商特定的细节,请使用官方页面:
- NVIDIA H100 概览,用于 Hopper 代 GPU 上下文:NVIDIA H100 Tensor Core GPU。
- NVIDIA H200 概览,用于更大 HBM3e 内存和带宽上下文:NVIDIA H200 Tensor Core GPU。
- NVIDIA Blackwell/DGX B200 和 GB200 资料,用于 Blackwell 系统上下文:NVIDIA DGX B200 和 NVIDIA GB200 NVL72。
- NVIDIA A100 概览,用于成熟的 Ampere 基线上下文:NVIDIA A100 Tensor Core GPU。
- NVIDIA L40S 页面,用于推理和图形/媒体工作负载上下文:NVIDIA L40S。
- NVIDIA MIG 文档,适用于对受支持的 GPU 进行分区:NVIDIA Multi-Instance GPU User Guide。
- 用于运行时适配的服务框架文档:vLLM OpenAI-compatible server、SGLang documentation,以及 NVIDIA TensorRT-LLM。
- 查看供应商报价和定价页面,以获取当前可用性和成本。将你复制到采购表中的每个价格都要加上时间戳。
常见问题
哪种 GPU 最适合 AI 训练?
最适合 AI 训练的 GPU 取决于模型大小、训练方案、内存需求、互连、检查点行为,以及达到目标评估分数所需的时间。H100、H200、B200 和 GB200 级系统是大规模训练任务的强有力候选,而 A100 对于较小或预算敏感的工作负载仍然可行。在选择之前,应基于完整运行的成本进行基准测试。
哪种 GPU 最适合 LLM 推理?
最适合 LLM 推理的 GPU 是那种能够容纳模型权重和 KV 缓存,同时满足 p95/p99 延迟和可接受 token 成本目标的 GPU。H100、H200 和 B200 适合大型或长上下文工作负载。L40S 和 A100 对于较小模型、批量推理以及更宽松的延迟目标可能更高效。有关推理的具体计算,请参阅更深入的 best GPU for LLM inference 指南。
H200 总是比 H100 更好吗?
不是。与 H100 相比,H200 提供更大的内存余量和带宽,这有助于内存密集型推理和训练。但更优的选择取决于价格、可用性、框架成熟度、批大小、延迟,以及工作负载是否真的受内存限制。如果 H100 以更低的有效成本满足目标,那么 H100 仍然可能胜出。
什么时候应该选择 L40S 而不是 H100?
当模型可以装下、延迟目标适中、媒体/推理吞吐量每美元更重要,并且 H100 级容量会被低效利用时,应选择 L40S。当更大的模型、更严格的 p99 延迟、训练或高并发推理需要更强的数据中心加速器性能时,应选择 H100。
我应该租用 GPU 还是使用模型 API?
当你需要硬件控制、自定义运行时、私有拓扑,或者在稳定模型上保持持续利用率时,租用 GPU。当前需求不确定、模型经常变化、前沿模型访问很重要,或者你的团队比起硬件控制更需要治理、回退、账本和一张发票时,就使用模型 API。可参考 GPU cloud vs model API 进行比较。
如何避免 GPU 购买过量?
通过对精确工作负载进行基准测试、衡量可接受输出、将空闲时间和运维成本纳入考虑,并先测试更小规模或托管替代方案来避免过度采购。只有在流量、模型选择和利用率已经得到证明之后,再进行预留或购买。
结论
这份 AI GPU 选型指南不是对各类加速器的排名,而是一种让 GPU 决策更具说服力的方法。先从工作负载出发,选择与业务一致的指标,验证内存适配,测试吞吐量和尾延迟,把运维和故障浪费也纳入计算,并在签约前将其与模型/API 路线进行比较。
对于许多团队来说,正确答案是混合方案:对于真正需要硬件控制的工作负载使用 GPU,对于溢出流量、前沿模型、回退、使用账本以及不应运行服务栈的团队使用受 Flatkey 治理的模型/API 访问。最终获胜的 GPU 选择,是以合适的成本交付被接受的工作,同时不迫使你的团队承担它并不需要的基础设施。


