NVIDIA H100 GPU:アーキテクチャ、性能、クラウドデプロイガイド
NVIDIA H100 GPUは、AIトレーニング、高スループット推論、テクニカルコンピューティング向けに設計されたHopper世代のデータセンターアクセラレータです。クラウドにおける価値は、見出しとなるFLOPS値だけでは決まりません。重要なのは、そのメモリ容量、メモリ帯域幅、精度サポート、GPU間ファブリック、運用モデルが、実行する必要のあるモデルとサービスに適合するかどうかです。
AI開発者またはMLインフラストラクチャエンジニアにとって、NVIDIA H100 GPUの選定には3つの層があります。
- モデル、KVキャッシュ、オプティマイザ状態、ワークスペースは、安全な余裕を持って収まるか。
- ワークロードには1基のGPU、密結合されたマルチGPUノード、または分散クラスターのどれが必要か。
- 本番環境で計測可能な状態にした後、デプロイメントはレイテンシ、スループット、信頼性、コストの目標を満たせるか。
本ガイドでは、仕様書をこうしたデプロイメントの選択に置き換えて解説します。検証されていないプロバイダー価格のスナップショットではなく、現在確認可能なハードウェアの事実と、再現性のあるクラウド展開プロセスに焦点を当てます。
NVIDIA H100 GPUの設計対象
NVIDIA H100 GPUは、NVIDIA Hopperアーキテクチャに基づいています。Hopperでは、第4世代Tensor Core、FP8をサポートするTransformer Engine、H100 SXM構成のHBM3メモリ、NVLink、Multi-Instance GPU(MIG)機能が導入されました。これらの機能が重要な理由はそれぞれ異なります。
- Tensor CoreとTransformer Engineは、AIフレームワークまたは推論エンジンで利用できる混合精度パスに影響します。
- HBMの容量と帯域幅は、モデルの重み、アクティベーション、KVキャッシュが収まるかどうか、およびメモリバウンドな処理でデータをどの程度迅速に移動できるかに影響します。
- NVLinkとシステムトポロジは、ワークロードが複数のGPUにまたがる場合の通信コストに影響します。
- MIGでは、対応GPUを分離されたインスタンスに分割し、小規模で互換性のあるワークロードに利用できます。
H100製品ファミリーは、単一のクラウド構成ではありません。オファーを比較する前に、H100 SXMシステム、H100 NVL構成、または別のH100 PCIeベースのオファーのどれを見ているかを確認してください。フォームファクターとインターコネクトによって、適切な並列化、スケジューリング、ベンチマーク計画は変わり得ます。
NVIDIA H100 GPUアーキテクチャ:デプロイメントに関連する事実
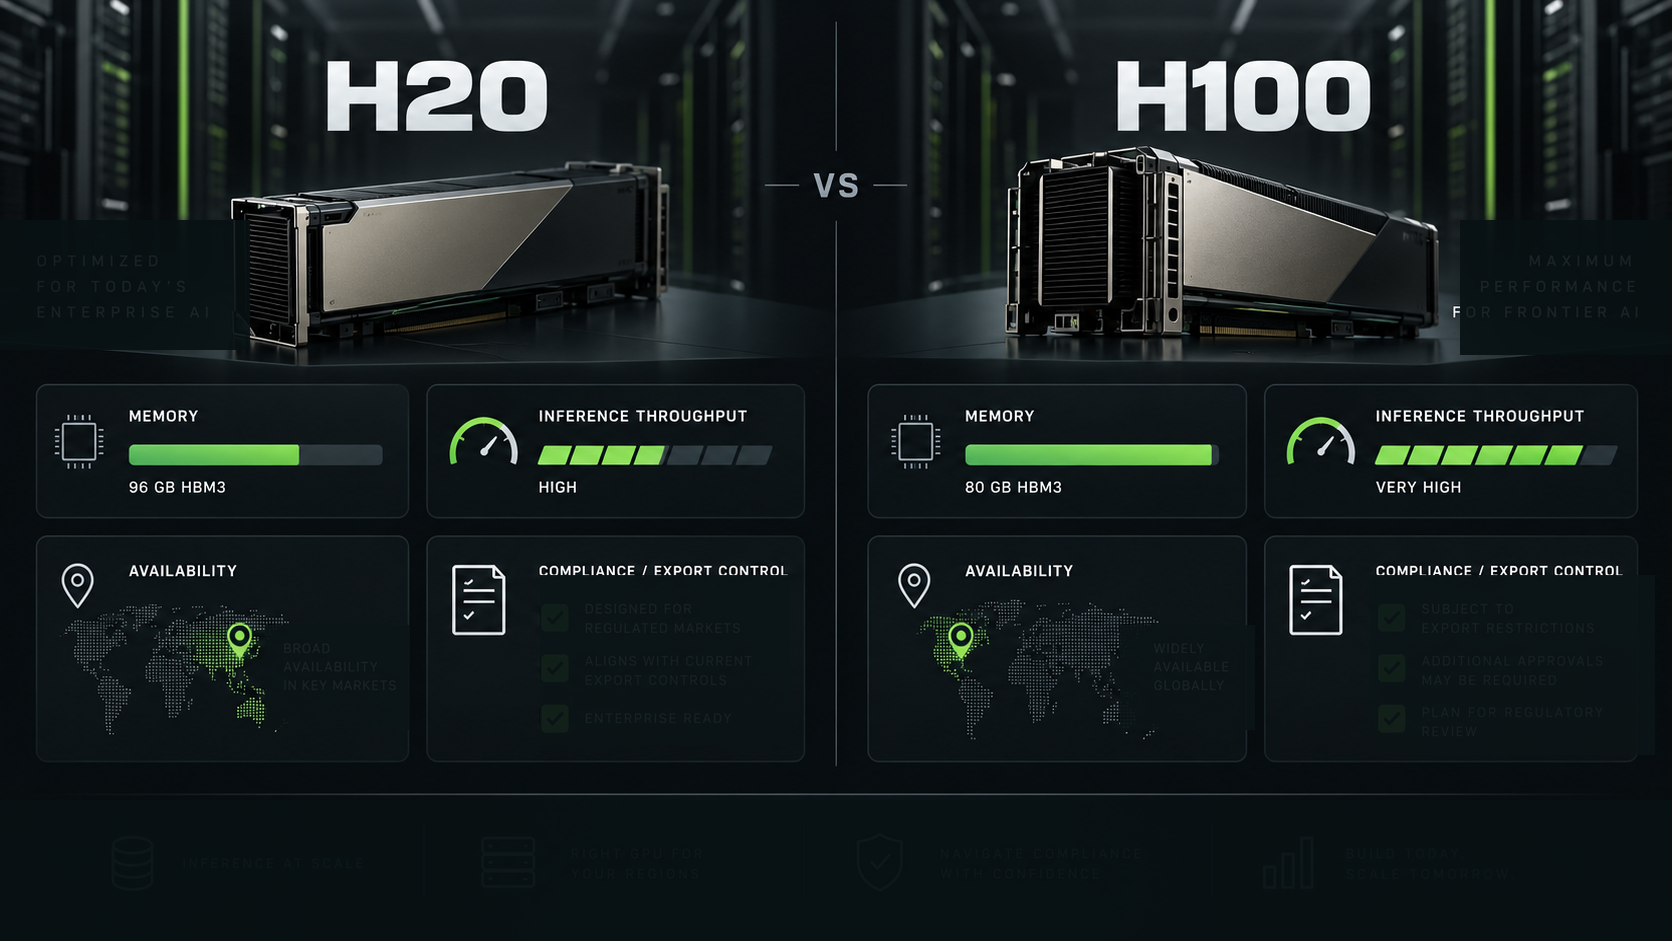
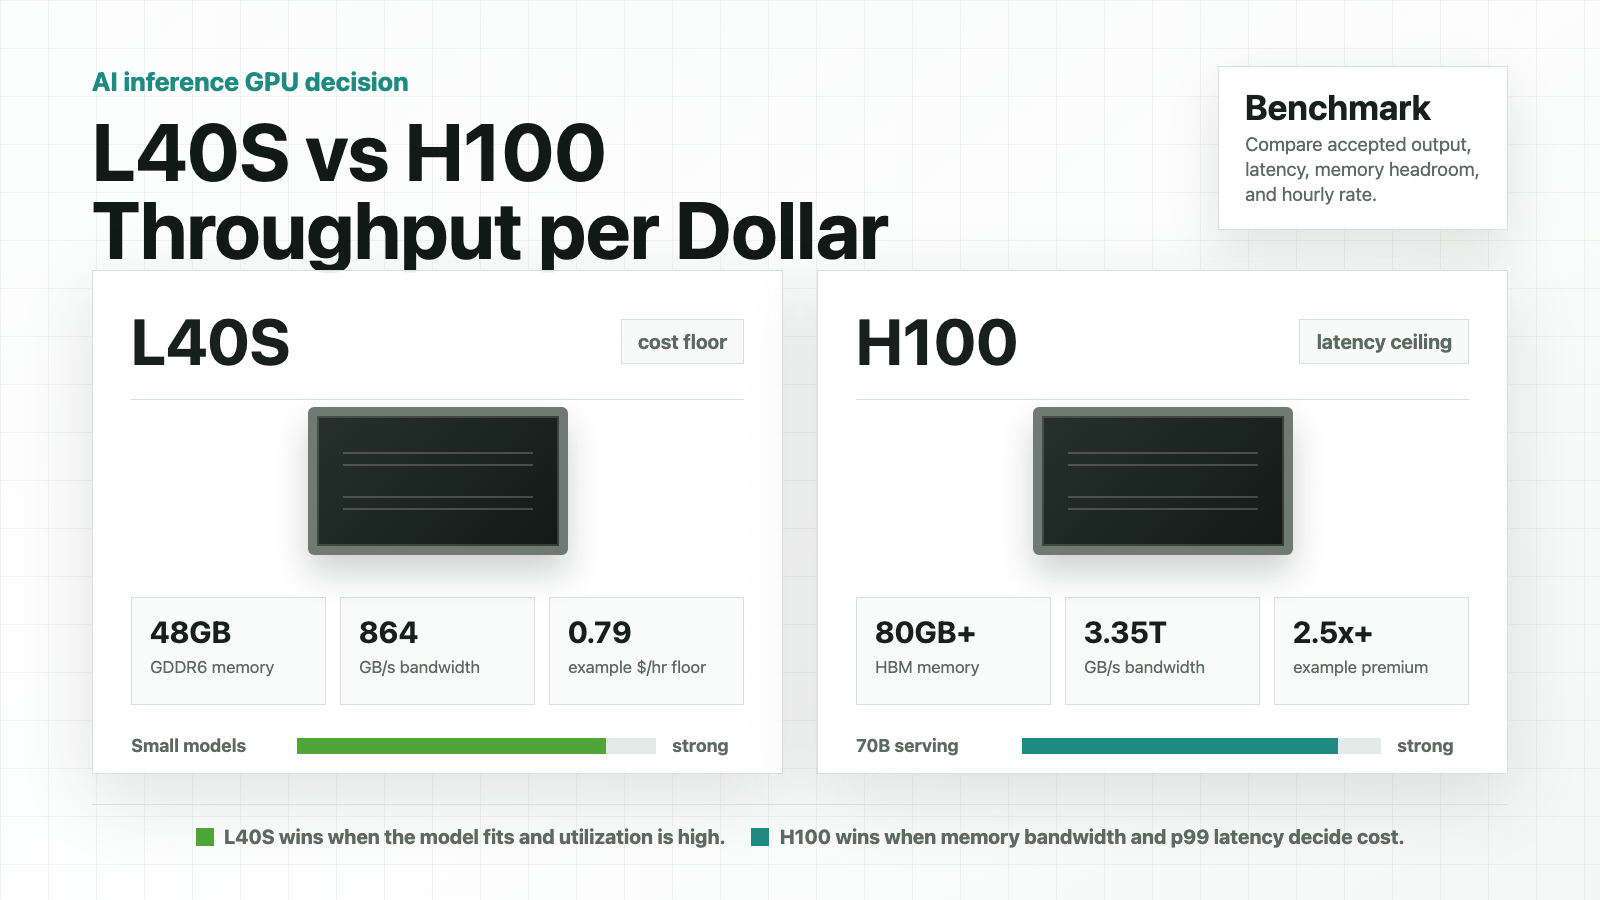
NVIDIAはH100 SXMについて、80 GBのHBM3メモリ、3.35 TB/sのGPUメモリ帯域幅、最大900 GB/sのNVLink帯域幅、最大7つの10 GB MIGインスタンスを記載しています。NVIDIAはH100 NVLを別途、94 GBのメモリ、3.9 TB/sの帯域幅、最大600 GB/sのNVLink帯域幅、デュアルスロットの空冷PCIeフォームファクターとして記載しています。これらは製品構成上の事実として扱い、すべてのクラウドリスティングで同じトポロジまたは使用可能容量が提供される保証とは見なさないでください。デプロイ前に、正確なインスタンス構成を確認してください。 NVIDIA H100製品仕様
| 機能 | クラウドデプロイメントで重要な理由 | 導入を決定する前に確認すべきこと |
|---|---|---|
| HBM容量 | 重み、KVキャッシュ、アクティベーション、ワークスペース、およびフラグメンテーションの余裕に利用できる領域の大きさを決定します。 | GPUごとの正確なVRAM、ランタイム起動後の使用可能メモリ、目標コンテキスト長におけるKVキャッシュ使用量のピーク。 |
| HBM帯域幅 | メモリバウンドな推論およびトレーニングフェーズで重要になることがよくあります。 | 意図するバッチサイズ、シーケンス長、精度でのワークロード固有のtokens/secまたはsteps/sec。 |
| Tensor CoreとFP8サポート | モデル、フレームワーク、品質目標が対応している場合に、効率的な精度パスを実現できます。 | サポートされる精度パス、キャリブレーションまたは量子化プロセス、品質劣化の判定基準。 |
| NVLink / NVSwitchトポロジ | テンソル並列、パイプライン並列、またはデータ並列のワーカー間で大きなテンソルを交換する場合に重要です。 | GPU数、nvidia-smi topo -mの出力、ファブリックの健全性、集合通信テストの結果。 |
| MIG | 互換性のある小規模ワークロードでは使用率を改善できますが、リソースサイジングと分離境界が変わります。 | 対応プロファイル、スケジューラでの公開状況、監視ラベル、各テナントがGPU全体を必要とするかどうか。 |
NVIDIAのHopperアーキテクチャの詳細は、これらの要素が一体となる理由を示しています。第4世代Tensor CoreにはFP8とTransformer Engineが追加され、H100 SXMはHBM3と3 TB/sを超えるメモリ帯域幅を組み合わせています。 NVIDIA Hopperアーキテクチャの概要
ピーク演算性能をデプロイメントの見積もりに使わない
ピークTensor Coreスループットはハードウェア比較には有用ですが、アプリケーションのSLAではありません。本番環境における実測性能は、モデルアーキテクチャ、精度、バッチサイズ、シーケンス長の構成、カーネル選択、キャッシュ、データロード、通信オーバーヘッド、サービスレベルのレイテンシ制限に左右されます。
新規のNVIDIA H100 GPUデプロイメントでは、まずワークロードの受け入れテストを定義してください。LLMサービスの場合、一般的には初回トークンまでの時間、トークン間レイテンシ、エンドツーエンドのp50/p95レイテンシ、受理された出力トークン数/秒、キュー待機時間、エラー率、品質チェックが含まれます。トレーニングでは、ステップあたりの時間、サンプル数/秒、チェックポイント時間、収束挙動、all-reduceの健全性を追跡します。
クラウド契約を選ぶ前にH100トポロジを選ぶ
同じアクセラレータでも、デプロイ方法は大きく異なります。GPU名ではなく、通信パターンから検討を始めましょう。
| デプロイパターン | 通常適しているケース | 主な設計上の懸念事項 |
|---|---|---|
| H100 GPU 1基 | モデルが1台のデバイスに収まる場合、またはスケールアウト前に推論サービスを検証する場合。 | メモリ収容性、リクエスト同時実行数、永続ストレージ、クリーンなベースラインベンチマーク。 |
| 1ノード内のGPU 2~4基 | モデルまたはバッチでシャーディングが必要だが、1台のホストに完全なサービングまたはトレーニンググループを収容できる場合。 | トポロジー、集団通信、CPU/RAMバランス、障害復旧。 |
| HGXスタイルのノード内のH100 SXM GPU 4~8基 | 密結合されたマルチGPUドメインのメリットを得られるワークロード。 | NVLink/NVSwitchの可視性、NCCLの検証、データ局所性、協調ロールアウト。 |
| 複数ノード | ジョブが1ノードに収まらない、または1ノードで提供できる以上の総スループットが必要な場合。 | ネットワークファブリック、ストレージスループット、チェックポインティング、ランク配置、障害分離。 |
| MIG分割済み容量 | 複数の互換性のある小規模ワークロードが、それぞれフルデバイス容量を必要とせずに物理GPUを共有できる場合。 | プロファイルのサイジング、スケジューラポリシー、テナント分離、スライスごとの可観測性。 |
シングルGPU VM上のNVIDIA H100 GPUは、実運用に向けた妥当な最初のステップになり得ます。マルチGPU H100デプロイメントはシステムとして扱う必要があります。ホストトポロジー、インターコネクト、ネットワーク、CPU、ストレージ、ソフトウェアスタック、スケジューラはいずれも結果に影響します。より広範なハードウェアシステムの視点については、FlatkeyのGPUサーバーデプロイメントガイドを参照してください。
実践的なクラウドデプロイメントワークフロー
1. プロビジョニング前にワークロード概要を作成する
ベンチマークを再現可能にする情報を記録します。
- モデル名、リビジョン、パラメータ数、精度。
- 目標コンテキスト長、入力/出力の構成、同時実行プロファイル。
- トレーニング、ファインチューニング、バッチ推論、またはオンラインサービングの目的。
- レイテンシSLO、スループット目標、品質または精度のゲート。
- 必要なリージョン、データ境界、永続ストレージ、ネットワーク公開、目標復旧時間。
LLM推論では、モデル重みのみの計算ではなく、予算としてメモリを見積もります。
必要なGPUメモリ = モデル重み + 目標同時実行数におけるKVキャッシュ
                    + ランタイムワークスペース + 通信バッファ
                    + フラグメンテーションとロールアウト時の変動に備える安全マージン
適切な値は、代表的な負荷テストから得られます。正常に起動するモデルでも、KVキャッシュが増大すると、同時実行数または長いコンテキストに関する目標を満たせなくなることがあります。
2. アクセラレータのラベルだけでなくインスタンスを確認する
容量を予約する前に、クラウドオファーの正確な詳細を確認します。
- H100のバリアント、GPU数、デバイスあたりのVRAM。
- GPU間トポロジー、およびリストがNVLinkまたはNVSwitchバックのノードを公開しているかどうか。
- CPUコア数、ホストRAM、ローカルNVMe、ネットワークインターフェース。
- ドライバ、CUDA、コンテナランタイム、フレームワークの互換性。
- 容量が専有、割り込み可能、または回収ポリシーの対象であるかどうか。
- スナップショット、チェックポイント、プライベートネットワーキング、メトリクスのエクスポートの仕組み。
新しいGPU構成は完成済みの設計ではなく、仮説として扱います。トラフィックを移行したり長期予約を確約したりする前に、小規模な事前検証を実行してください。
3. ハードウェアとファブリックを検証する
最低限、オペレーティングシステム、コンテナランタイム、ワークロードが想定どおりのデバイスを認識できることを確認します。マルチGPUノードでは、トポロジーを記録し、トレーニングまたはサービングエンジンが使用する集団通信パスをテストします。
nvidia-smi
nvidia-smi topo -m

# ワークロードで使用するCUDA互換イメージ内で実行します。
nvidia-smi --query-gpu=name,memory.total,driver_version --format=csv
マルチノードジョブでは、受け入れテストを実際のネットワークパス、ランク配置、ストレージ読み取り、チェックポイント書き込み、再起動時の動作まで拡張します。GPUインベントリが正常であるだけでは、分散ジョブがスループットを維持できることの証明にはなりません。
4. 運用上の問題を解決する場合にのみKubernetesを使用する
Kubernetesは、複数のチームまたはサービスでスケジューリング、クォータ、分離、再現可能なロールアウト、クラスタ全体の可観測性が必要な場合に有用です。慎重に管理された1台のVMには必須ではありません。
Kubernetesデプロイメント向けに、NVIDIAのGPU Operatorは、NVIDIAドライバ、Container Toolkit、デバイスプラグイン、GPU Feature Discovery、DCGMベースのモニタリング、その他の関連GPUコンポーネントを自動化します。デフォルトのインストールでは、GPUワーカーにMIG Managerもデプロイされます。インストール前に、最新のサポートマトリックスとインストール前提条件を確認してください。マネージドKubernetesサービスでは、スタックの一部がすでに提供されている場合があります。NVIDIA GPU Operatorドキュメント インストールガイド
最小限のデバイスリクエストは、意図的にシンプルです。
resources:
  limits:
    nvidia.com/gpu: 1
そのリクエストは始まりにすぎません。ワークロードを本番運用可能と見なす前に、ノード選択ポリシー、toleration、リソースクォータ、イメージ互換性チェック、永続ボリュームの動作、サービスレベルのメトリクスを追加してください。マルチノード運用を構築する場合は、FlatkeyのKubernetes GPUクラスターガイドで、計画すべきプラットフォームレベルの制御について解説しています。
5. 推論またはトレーニングスタックを意図的に選択する
H100ハードウェアが適切なランタイムを選んでくれるわけではありません。モデルと運用上の制約をサポートするサービングスタックを使用し、本番に近いトラフィックで検証してください。たとえばTensorRT-LLMは、NVIDIA GPU上で最適化されたLLM推論のためのAPIとランタイムを提供します。ただし、その性能はモデル、精度、バッチポリシー、レイテンシ目標に基づいて測定する必要があります。TensorRT-LLMドキュメント
本番推論のロールアウトでは、以下を実施します。
- 1つのレプリカと代表的なリクエストトレースから開始します。
- 品質、レイテンシ、スループット、メモリ、キューイング、エラー時の挙動を測定します。
- 精度、最大バッチ、コンテキスト上限、テンソル並列性、レプリカ数など、変更する要素は一度に1つだけにします。
- ドライバー、ランタイム、モデル、トポロジーを変更した後は、同じテストを繰り返します。
- トラフィックを段階的に移行し、最後に正常だったアーティファクトを用いたロールバック経路を維持します。
6. NVIDIA H100 GPUをサービスの一部として計測する
ハードウェアとアプリケーションの両方のシグナルを監視してください。NVIDIA H100 GPUがフルに使用されていることは、健全なバッチ処理、停止したリクエストパス、または別の場所のボトルネックを示している可能性があります。解釈には、その横にサービスメトリクスが必要です。
| レイヤー | 監視すべきシグナル |
|---|---|
| GPU | 使用率、割り当て済み/予約済みメモリ、消費電力、温度、クロック、ECC/Xidイベント、MIGプロファイル。 |
| ファブリック | GPUトポロジー、集団通信の所要時間、ネットワーク再送、ランク間の不均衡。 |
| ランタイム | キュー深度、バッチサイズ、キャッシュ使用率、OOM/再起動、リクエストキャンセル、モデルロード時間。 |
| ユーザー体験 | 最初のトークンまでの時間、トークン間レイテンシ、p50/p95エンドツーエンドレイテンシ、成功したリクエスト、品質評価。 |
| コストとキャパシティ | 課金対象インスタンス時間、ストレージ/ネットワーク料金、アイドル時間、課金時間帯の使用率、完了した成功作業。 |
ユーザーに見える症状を中心にアラートを定義してください。たとえば、p95の最初のトークンまでの時間が継続的に悪化し、かつキューが増大している場合にアラートを出し、その後GPUおよびファブリックのテレメトリを使用して原因を調査します。単純な使用率アラートだけでは十分であることはほとんどありません。
パフォーマンス最適化:安全な作業順序
NVIDIA H100 GPUサービスが目標を達成できない場合は、次の順序で最適化します。
- 目標を確認します。問題はレイテンシ、スループット、完了タスクあたりのコスト、品質、それとも信頼性のどれですか?
- ベースラインを検証します。同じモデル、イメージ、ドライバー、トポロジー、同時実行数で、同じトレースを再実行します。
- 制約となるリソースを見つけます。VRAM、メモリ帯域幅、コンピュート、CPUトークナイゼーション、PCIe/NVLink通信、ネットワーク、ストレージ、またはキューイングポリシーが原因である可能性があります。
- 変数を1つ変更します。例として、バッチポリシー、最大コンテキスト、テンソル並列度、精度、レプリカ数、キャッシュ構成があります。
- 機能および品質ゲートを再実行します。タイムアウトが増加したり、許容範囲を超えてモデル品質が変化したりするなら、出力が速くなっても改善とは言えません。
- 運用範囲を文書化します。設定、測定結果、およびその結果を有効にした条件を記録します。
このアプローチにより、実際のボトルネックが過大なコンテキストポリシー、CPUに制約されたリクエストパス、または不適切なトラフィック分割であるにもかかわらず、すぐにGPUを増やしてしまう一般的な誤りを防げます。
脆弱な時間単価比較に頼らないコスト管理
クラウドH100の価格、可用性、課金条件は、プロバイダー、リージョン、コミットメント、キャパシティタイプによって異なります。古い料金表を判断基準にするのではなく、完了した作業を比較してください。
成功結果あたりのコスト =
  (GPUインスタンス時間 + ストレージ + ネットワーク + 運用オーバーヘッド)
  / 同じ測定期間内の成功結果数
推論サービスでは、「成功結果」を正確に定義してください。受理されたトークン、完了したリクエスト、生成された画像、評価済みドキュメント、または品質およびSLOゲートを満たす別の出力が該当します。課金されるアイドル時間と再試行も含めます。製品にGPUレベルの制御が不要な場合は、その数値をマネージドモデルAPIの代替案と比較してください。
再現可能なコストモデルについてはFlatkeyのセルフホストLLMの100万トークンあたりコストガイドを、インフラストラクチャ所有とモデルアクセスの判断境界についてはGPUクラウドとモデルAPIの比較ガイドを参照してください。
NVIDIA H100 GPUデプロイチェックリスト
サービスの準備が整ったと宣言する前に、以下をすべて確認してください。
- [ ] H100の正確な構成、VRAM、トポロジー、CPU/RAM、ストレージ、ネットワークが文書化されている。
- [ ] モデルのメモリ予算に、重み、KVキャッシュ、ランタイムワークスペース、通信バッファ、ヘッドルームが含まれている。
- [ ] ドライバー、CUDA、フレームワーク、コンテナイメージの互換性が、対象の構成でテストされている。
- [ ] 単一GPU、および該当する場合はマルチGPUのトポロジーと集団通信テストに合格している。
- [ ] 本番環境に近いトレースが、レイテンシー、スループット、品質、エラーの目標を満たしている。
- [ ] GPU、ファブリック、ランタイム、ユーザー体験、コストのシグナルを、1つの運用ビューで確認できる。
- [ ] 段階的なロールアウト、ロールバック用アーティファクト、チェックポイント戦略、インシデント担当者が定義されている。
- [ ] 完了した作業あたりのコストを、時間あたりのGPU価格だけでなく、最も信頼性の高い代替案と比較している。
AI GPU選定におけるH100の位置づけ
NVIDIA H100 GPUは、ワークロードがHopper世代のTensor Core機能、高いHBM帯域幅、マルチGPUトポロジー、またはランタイムとデータフローの制御を必要とするデプロイメントから恩恵を受ける場合に適しています。ただし、すべてのAIタスクに自動的に最適な選択肢となるわけではありません。モデルが小規模である場合、需要が断続的である場合、チームがGPUサービスを運用できない場合、またはハードウェア固有の最適化が製品成果を変えない場合は、より小型のアクセラレーター、新しいメモリ重視のGPU、またはマネージドモデルAPIの方が適していることがあります。
関連する判断については、前世代を評価する場合はH100 vs. A100を比較し、より大きなHBM3e容量が推論への適合性を変える可能性がある場合はH200 GPUデプロイメントガイドをお読みください。
H100と、より大容量メモリを搭載した兄弟モデルを並べて比較するには、H200 vs H100 (2026)をお読みください。
よくある質問
NVIDIA H100 GPUは何に使用されますか?
NVIDIA H100 GPUは、AIトレーニング、ファインチューニング、LLM推論、科学技術計算、その他の高速化ワークロードに使用されます。適切な構成は、モデルのメモリフットプリント、通信パターン、精度、同時実行性、運用要件によって異なります。
H100 SXMは、H100 PCIeまたはH100 NVLの提供形態と異なりますか?
はい。フォームファクター、メモリ構成、NVLink帯域幅、電力枠、冷却、システムトポロジーは異なる場合があります。「H100」を完全な構成説明として扱うのではなく、クラウド提供サービスの正確な仕様を確認してください。
H100のGPUメモリ容量はどのくらいですか?
NVIDIAは、H100 SXMには80 GBのHBM3メモリ、H100 NVLには94 GBを搭載すると記載しています。適切な容量計算には、ランタイムワークスペース、KVキャッシュ、アクティベーションまたはトレーニング用メモリ、通信バッファ、および安全マージンも含める必要があります。NVIDIA H100 specifications
クラウドでH100ワークロードを実行するにはKubernetesが必要ですか?
いいえ。明確な担当者がいる単一のワークロードでは、VMが適切な出発点となる場合があります。GPUワーカー間でスケジューリング、テナンシー、クォータ、再現可能なデプロイメント、または共有の可観測性が必要になると、Kubernetesの有用性が高まります。
LLM推論にはH100とH200のどちらを選ぶべきですか?
まず、メモリと同時実行性の要件から検討してください。目標とするコンテキスト長とKVキャッシュにより多くのメモリヘッドルームが必要な場合はH200の方が適している可能性があります。一方、ワークロードが十分な余裕を持って収まり、ベンチマークがSLOを満たす場合は、H100のデプロイメントで十分なことがあります。ファミリー名だけで選ぶのではなく、システム全体と完了した作業あたりのコストを比較してください。
結論
NVIDIA H100 GPUが本番環境で有用になるのは、そのアーキテクチャが計測済みのワークロードと信頼性の高い運用モデルに結び付けられている場合に限られます。スケールアウトする前に、正確なクラウド構成、モデルのメモリ予算、トポロジー、ランタイム互換性、受け入れ指標を検証してください。その後、実際のボトルネックを最適化し、GPUのラベルや単独の時間料金ではなく、正常に完了した作業に基づいてコストを比較してください。
インフラストラクチャ層をまだ選定中の場合は、FlatkeyのAI GPU選定ガイドを使用して、GPUファミリーとデプロイメントモデルをまたいだワークロード適合性を比較してください。