构建 Kubernetes GPU 集群并不等同于给几个工作节点挂载 GPU。对于 AI 训练和推理,Kubernetes 必须能够安全地暴露加速器,将作业调度到正确的节点,对稀缺容量进行排队,使数据集和模型权重与计算资源保持足够接近,并告知运维人员昂贵的运行为何失败。
实用原则是:先构建能够验证工作负载的最小 Kubernetes GPU 集群,只有在调度器、驱动程序、网络、存储、可观测性和成本模型均通过验收测试后再进行扩展。一个无法解释排队时间、GPU 利用率、检查点恢复时间和故障原因的集群,尚不能算是生产基础设施。
本指南将介绍用于 AI 训练和推理的 Kubernetes GPU 集群的架构和运营模型。内容涵盖节点设计、GPU 暴露、排队、工作负载 API、可观测性、实用的 Kubernetes GPU 集群图、管理工具,以及在租用或预留容量前应向供应商提出的问题。
如果产品只需要模型输出,请先比较模型 API 或托管推理方案。如果您需要自定义权重、放置控制、私有服务、分布式训练或可重复的基准测试所有权,Kubernetes GPU 集群可以成为合适的控制平面。
Kubernetes GPU 集群快速解答
生产级 Kubernetes GPU 集群包含六个层面:
| 层 | 负责内容 | 投入生产前需验证的内容 |
|---|---|---|
| GPU 节点 | GPU 型号、GPU 内存、CPU/RAM、本地 NVMe、NIC、节点镜像、驱动程序、容器运行时 | 节点规格应匹配训练或推理工作负载,而不只是匹配宣传的 GPU SKU。 |
| GPU 暴露 | 设备插件、GPU Operator、动态资源分配、MIG 或共享策略 | Pod 能够以可预测的方式请求加速器,且不会意外使用错误的设备。 |
| 调度和队列 | Kubernetes 调度器、Kueue、Volcano、Ray、Kubeflow、自定义 Operator | 作业获得公平等待,抢占策略明确,团队能够解释排队时间。 |
| 网络和存储 | 节点内的 NVLink/NVSwitch、节点间的 InfiniBand/RoCE/EFA 或以太网、对象存储、共享文件系统、检查点路径 | 分布式作业可以扩展和恢复,且不会让 GPU 因等待数据而闲置。 |
| 可观测性 | DCGM、Prometheus、日志、事件、追踪、队列指标、成本标签 | 运维人员可以按工作负载查看利用率、内存、功耗、故障、所有者和支出。 |
| 安全和治理 | RBAC、命名空间、配额、镜像策略、密钥、网络策略、审计日志 | 在集群成为共享基础设施之前,多租户访问已得到控制。 |
关键设计问题不是“ Kubernetes 能运行 GPU 吗?”它可以,只要具备正确的设备插件和节点设置。更难的问题是:您的 AI 基础设施 Kubernetes GPU 集群能否在真实数据、真实用户、真实故障和真实预算约束下,让 GPU 持续发挥价值。
Kubernetes GPU 集群图
在选择工具之前,请将此 Kubernetes GPU 集群图作为评审模型:
                 开发人员 / CI / 笔记本 / API 流量
                                  |
                                  v
        +--------------------------------------------------+
        | Kubernetes 控制平面                              |
        | API 服务器、调度器、RBAC、准入控制、密钥          |
        +--------------------------------------------------+
                                  |
                 +----------------+----------------+
                 |                                 |
                 v                                 v
        +------------------+              +------------------+
        | 队列层           |              | 平台附加组件     |
        | Kueue / Volcano  |              | GPU Operator,    |
        | 配额、队列组、   |              | 设备插件、       |
        | 资源类型         |              | DCGM exporter    |
        +------------------+              +------------------+
                 |                                 |
                 +----------------+----------------+
                                  |
                                  v
        +--------------------------------------------------+
        | GPU 工作节点池                                   |
        | H100/H200/B200/A100/L40S 等、CPU、RAM、NVMe、    |
        | NIC、CUDA/运行时、标签、污点、拓扑               |
        +--------------------------------------------------+
                 |                 |                 |
                 v                 v                 v
        训练作业            推理服务             批处理作业
        PyTorch/JAX         vLLM/SGLang/Triton    Ray/Kubeflow
                 \                 |                 /
                  \                |                /
                   v               v               v
        +--------------------------------------------------+
        | 网络和数据路径                                   |
        | 高速网络、对象存储、共享文件系统、                |
        | 模型缓存、检查点、日志、指标、备份               |
        +--------------------------------------------------+
该图刻意保持简洁。真实的 kubernetes gpu cluster architecture 还会加入负载均衡器、私有镜像仓库、服务网格边界、IAM、制品存储、实验跟踪和计费导出。该图的作用是促成一个关键讨论:每一层由谁负责应对各类故障模式?
第 1 步:确定 Kubernetes 是否是合适的 GPU 控制平面
当您的 AI 平台需要容器原生部署、API 驱动的自动化、多租户命名空间、服务端点、策略控制,以及与现有云原生可观测性集成时,Kubernetes 非常适合。
它通常适用于:
- 需要发布、自动扩缩容边界、路由和服务健康检查的在线推理服务。
- 以 Jobs、Ray 工作负载或自定义 Operator 形式运行的批量推理或嵌入工作负载。
- 团队希望使用共享基础设施而非各自独立 GPU 机器的微调和训练工作负载。
- Notebook、训练作业、模型服务和配套服务共享同一运行模型的混合平台。
- 已经运行 Kubernetes,并能够扩展现有身份、CI/CD、镜像仓库、日志和策略系统的团队。
当团队只需要偶尔进行研究访问、一次性的 HPC 风格批处理作业,或简单的 SSH 驱动训练时,Kubernetes 可能不是合适的首选。在这些情况下,Slurm、托管训练服务、托管 Notebook 环境或直接租用 GPU,可能更快地产出有用结果。
在构建 kubernetes gpu cluster 之前,先明确工作负载边界:
| 问题 | 重要原因 |
|---|---|
| 工作负载是训练、批量推理、在线推理、Notebook,还是混合型? | 答案会改变调度、存储、网络和可用性要求。 |
| 作业需要完整 GPU、MIG 切片,还是分时共享访问? | GPU 共享会改变隔离性、计量方式和性能可预测性。 |
| 工作负载是单节点还是多节点? | 多节点训练不仅需要 GPU 可用性,还需要进行网络和放置测试。 |
| 数据集、检查点和模型权重有多大? | 数据传输可能成为 GPU 成本的主要部分。 |
| 业务分母是什么? | 应使用已完成的训练运行、已接受的推理输出、已生成的媒体作业或客户请求,而非仅使用原始 GPU 小时数。 |
对于更广泛的系统设计,请将此实施计划与您的 gpu cluster architecture 评估关联起来:计算、网络、存储和控制平面必须协同设计。
第 2 步:围绕工作负载形态设计 GPU 节点池
kubernetes gpu cluster 应具有经过审慎规划的节点池,而不是随意混合各种加速器机器。
对于每个节点池,请明确:
- GPU 型号和显存容量。
- 每个节点的 GPU 数量。
- 在相关情况下,PCIe、SXM、NVLink、NVSwitch 或其他拓扑细节。
- CPU 型号、CPU 数量、RAM 和 NUMA 布局。
- 本地 NVMe 容量和吞吐量。
- NIC 数量、NIC 速率和网络类型。
- 操作系统镜像、内核、驱动程序、CUDA、容器运行时和补丁流程。
- Kubernetes 标签、污点、容忍和拓扑标签。
- 工作负载使用完整 GPU、MIG、时间切片还是其他共享模式。
除非有充分理由将其合并,否则应将训练和推理需求分开。训练最关注的可能是 all-reduce 性能、检查点带宽和组调度。在线推理则可能更关注冷启动时间、模型缓存局部性、尾延迟和发布安全性。
一种实用的节点池命名模式是:
gpu-pool:
  accelerator: h100-80gb
  topology: 8gpu-sxm-nvlink
  fabric: infiniband
  workload: distributed-training
  sharing: full-gpu
这些标签不仅是文档说明。它们会成为调度选择器、配额维度、成本标签和调试上下文。
第 3 步:使用正确的 Kubernetes 机制公开 GPU
Kubernetes 通过专用资源机制调度 GPU。常见的基础方案是供应商提供的 设备插件,它向 kubelet 通告 GPU 资源,以便 Pod 能将其作为扩展资源进行请求。Kubernetes 在其 GPU 调度指南中说明了请求模型和节点选择约束。NVIDIA 的 Kubernetes 设备插件是 NVIDIA GPU 的标准方案,而 NVIDIA GPU Operator 则打包了多个运维组件,包括驱动程序和运行时管理、设备插件部署、MIG 管理以及 GPU 遥测。
对于许多团队,首个生产路径是:
node image + kernel prerequisites
  -> NVIDIA driver and container runtime
  -> NVIDIA GPU Operator
  -> Kubernetes device plugin
  -> DCGM exporter metrics
  -> workload namespaces and quotas
Kubernetes 动态资源分配对于评估更丰富设备分配模型的团队也很重要。DRA 围绕资源声明和设备类进行设计;当简单的扩展资源请求无法表达足够的放置或设备特定要求时,这会很有用。应将其视为一项审慎的平台选择:驱动程序、Kubernetes 版本、工作负载 API 和可观测性方案都应一并测试。
实际决策如下:
| 需求 | 要评估的 Kubernetes 机制 |
|---|---|
| 基本的整卡 GPU Pod 调度 | 设备插件和 nvidia.com/gpu 风格的扩展资源。 |
| NVIDIA GPU 生命周期管理 | NVIDIA GPU Operator。 |
| GPU 遥测 | DCGM exporter 加 Prometheus/Grafana 或您的可观测性技术栈。 |
| 表达能力更强的设备声明 | Kubernetes 动态资源分配。 |
| GPU 分区 | 在支持的情况下使用 MIG,并明确其隔离性和性能方面的注意事项。 |
| 分时共享的开发访问 | 仅在明确隔离和配额规则后,采用时间切片或平台策略。 |
不要向应用团队隐藏这一层。他们需要知道 Pod 获得的是整块加速器、MIG 切片还是分时共享设备,因为性能和调试假设会随之改变。
第 4 步:在团队争抢 GPU 之前添加队列层
默认 Kubernetes 调度器本身并不是一个完整的多租户 AI 队列。AI 团队通常需要工作负载准入、公平共享、配额、抢占策略,以及了解作业为何正在等待的可见性。
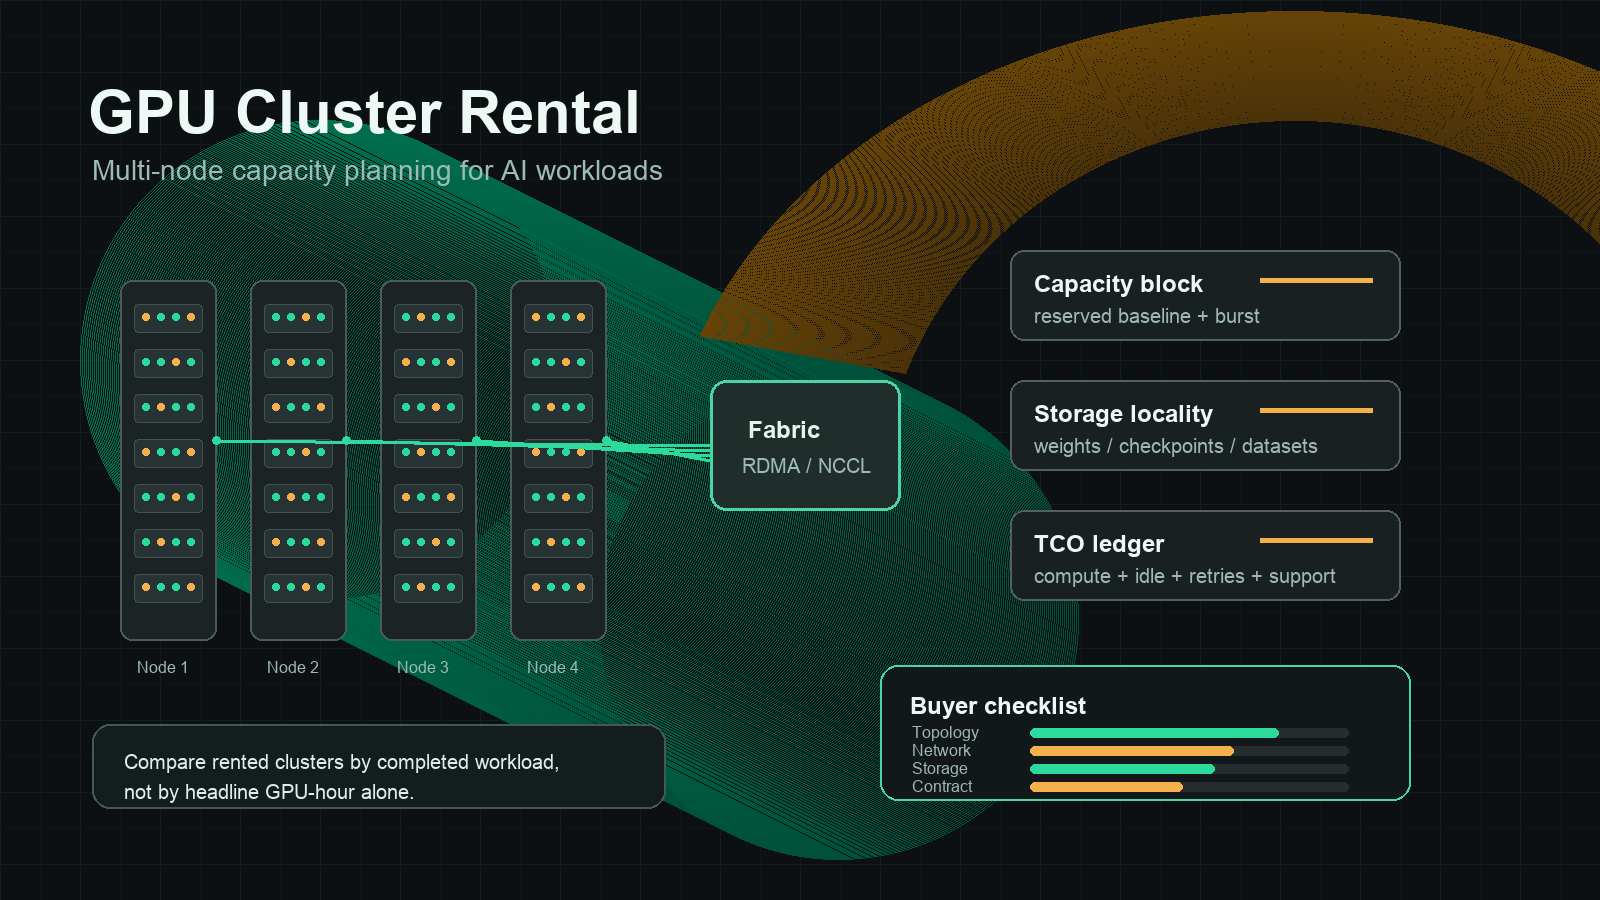
当批处理和 AI/ML 排队很重要时,Kueue 是值得评估的 Kubernetes 原生项目。其核心概念包括工作负载、本地队列、集群队列、群组和资源类型。这使平台团队能够对稀缺的 GPU 池进行建模,并决定在资源可用时准入哪些作业。
Volcano 是另一种适用于 AI、大数据和 HPC 风格工作负载的 Kubernetes 批处理调度选项。其组调度器采用全有或全无的最小 Pod 条件,对于分布式作业而言值得评估;否则,这类作业会在等待对等节点时浪费已部分分配的 GPU。
对于AI 基础设施 Kubernetes GPU 集群,请以书面形式定义队列策略:
| 策略 | 需要做出的决策 |
|---|---|
| 准入 | 哪些作业可以进入队列,需要哪些元数据? |
| 公平共享 | 如何在团队、项目或环境之间分配 GPU? |
| 优先级 | 哪些生产推理或上线关键型训练作业可以插队? |
| 抢占 | 作业能否被驱逐,以及驱逐前如何要求完成检查点保存? |
| 资源类型 | 哪些 GPU 池可以互换,哪些不可以? |
| 回填 | 在大型分布式任务等待期间,较小的作业能否运行? |
| 可见性 | 用户无需询问平台工程师,能否看到队列位置和被拒绝的原因? |
队列策略是一种成本控制机制。没有它,最强势的团队就可能消耗最昂贵的容量,而较小的作业则只能等待,或被转移到不受管理的影子基础设施中。
第 5 步:为训练和推理选择工作负载 API
当应用团队能够提交工作负载,而无需每次都手写底层 Pod 规范时,Kubernetes GPU 集群最有价值。
对于训练,请评估:
- 适用于简单单节点运行的原生 Kubernetes Jobs。
- 适用于跨框架分布式训练工作流的 Kubeflow Trainer。
- 用于分布式 Python、批量推理和服务模式的 Ray 和 KubeRay。
- 在需要组调度或队列准入时使用 Volcano 或 Kueue 集成。
- 仅当平台拥有通用工具未覆盖的稳定内部模式时,才使用自定义 Operator。
对于推理,请评估:
- 适用于简单服务的 Deployments 或 StatefulSets。
- 根据模型和性能目标选择 vLLM、SGLang、Triton 或 TensorRT-LLM 服务容器。
- 当团队需要模型生命周期抽象时,使用 KServe 或其他模型服务层。
- 基于队列深度、延迟、GPU 内存和请求组合制定水平与垂直扩缩容规则。
- 为对延迟敏感的生产流量和批处理工作负载设置独立的节点池。
一开始应保持工作负载 API 简单朴素。一个包含标签、资源请求、存储挂载和日志导出的清晰 Job 模板,优于一个无人能够调试的复杂平台。
第 6 步:验证网络和存储路径
能正常运行的演示与生产级Kubernetes GPU 集群 AI 基础设施之间的差异,往往会在网络和存储测试中显现。
对于分布式训练,请验证:
- 跨节点放置。
- 在每个目标节点之间的 NCCL all-reduce 行为。
- 网络错误、重传、拥塞以及节点间差异。
- 驱动程序、CUDA、NCCL 和容器镜像版本。
- 安装生产容器镜像后的性能,而不仅仅是在干净的基准测试镜像上的性能。
对于存储,请验证:
- 数据集暂存时间。
- 模型权重下载和缓存预热。
- 检查点写入频率和持续时间。
- 节点或 Pod 故障后的恢复时间。
- 并发作业下共享文件系统的行为。
- 对象存储区域、出口流量和生命周期规则。
一个最小验收测试如下所示:
1. Submit a queued training job with the production container.
2. Pull the real dataset sample and base model weights.
3. Run a multi-node communication benchmark if the workload is distributed.
4. Train or fine-tune for a fixed window.
5. Write a checkpoint, delete a pod, and restore from checkpoint.
6. Export GPU, network, storage, queue, and cost labels.
7. Compare useful work against the model/API or GPU rental baseline.
应在进行长期预留或高额投入之前运行此测试。在基准测试期间发现网络互连薄弱或检查点路径缓慢,比在发布窗口期间发现这些问题成本更低。
Kubernetes GPU 集群管理工具
kubernetes gpu cluster management tools 这一短语涵盖多种不同工作。在确定工具所执行的工作之前,不要购买或安装工具。
| 管理需求 | 待评估的工具或项目 | “良好”的表现 |
|---|---|---|
| GPU 生命周期 | NVIDIA GPU Operator、设备插件、节点镜像自动化 | 驱动程序、运行时、设备暴露和遥测在各节点之间均可重复配置。 |
| 排队 | Kueue、Volcano、Ray 作业提交模式 | 用户可以清晰地看到已准入、等待中、运行中、失败和已完成状态。 |
| 训练工作流 | Kubeflow Training Operator、Ray、原生 Jobs | 分布式作业可重复执行,且无需每次都编写定制的 Pod YAML。 |
| 推理服务 | vLLM、SGLang、Triton、KServe、Deployments | 发布、健康检查、延迟和模型缓存行为均可见。 |
| 可观测性 | DCGM exporter、Prometheus、Grafana、日志、追踪、Kubernetes 事件 | GPU 指标与作业、团队、模型和成本标签关联。 |
| 策略 | RBAC、ResourceQuota、LimitRange、准入控制、镜像策略、网络策略 | 在不妨碍正常开发的前提下约束多租户访问。 |
| 成本分摊 | 命名空间标签、工作负载标签、用量导出、计费仪表板 | 财务部门可以将支出映射到团队、环境、模型和已接受的输出。 |
避免采用仅报告已分配 GPU 小时数的平台。有效的管理应显示 GPU 为什么处于空闲状态、哪些失败作业消耗了容量,以及推理输出或训练里程碑是否证明了这笔支出的合理性。
CoreWeave Kubernetes GPU 集群问题
有些团队会搜索 coreweave kubernetes gpu cluster,因为他们希望以 Kubernetes 原生方式访问云端 GPU 容量,而不是使用通用虚拟机。将这个经过供应商修饰的查询视为尽职调查提示:对于 CoreWeave 或任何类似的 GPU 云服务提供商,在提交生产工作负载之前,请验证确切的 Kubernetes 访问模型、节点池控制、Operator 兼容性、配额导出和支持边界。
对任何提供商都应执行同样的尽职调查:
| 问题 | 重要原因 |
|---|---|
| 所请求区域实际可用的 GPU SKU 和节点规格是什么? | 营销宣传的库存与可分配容量并非一回事。 |
| 预留或池内的节点是否同构? | 混合节点可能破坏性能假设。 |
| GPU 节点之间使用何种网络互连? | 多节点训练依赖于放置策略和网络行为。 |
| 谁负责驱动程序、CUDA 和 Kubernetes 升级? | 升级边界会影响停机时间和可复现性。 |
| 您能否运行 GPU Operator、Kueue、Volcano、Ray 或所需的 Operator? | 托管 Kubernetes 仍需要平台兼容性。 |
| 配额、用量导出和标签如何公开? | 财务和平台团队需要成本归因。 |
| 分布式运行失败时的支持路径是什么? | 在生产环境之前,您需要日志、节点标识和升级支持渠道。 |
| 数据、模型权重和检查点的迁出路径是什么? | 迁移成本应纳入架构决策。 |
提供商的 Kubernetes 并不会消除验收测试的必要性。它改变的是您直接运维哪些层,以及通过服务级证据验证哪些层。
安全与多租户检查清单
GPU 集群通常会很快成为共享基础设施。在第二个团队开始使用集群之前,就需要完成安全设计。
最低限度的控制措施:
- 按团队、环境或工作负载边界划分命名空间。
- 将 RBAC 与您的身份提供商绑定。
- 为 GPU、CPU、内存和存储配置 ResourceQuota 和 LimitRange。
- 针对特权 Pod、主机挂载、主机网络和设备访问制定明确策略。
- 密钥管理与轮换。
- 私有镜像仓库策略、签名、扫描或准入检查。
- 针对出站流量、数据集访问和服务边界的网络策略。
- 针对作业提交、密钥访问、镜像使用和管理操作的审计日志。
- 针对本地 NVMe、临时卷、检查点、日志和失败作业的数据清理规则。
如果集群处理客户数据或专有模型权重,请将工作节点视为敏感基础设施。具有 GPU 访问权限的 Pod 也可能拥有高价值数据访问权限、模型工件和凭据。
可观测性与成本模型
生产环境的kubernetes gpu cluster需要同时具备三种视图:
- 平台视图:节点健康状况、GPU 健康状况、网络、存储、队列状态、Kubernetes 事件。
- 工作负载视图:作业所有者、镜像、模型、数据集、运行时、重试次数、退出原因、输出质量。
- 财务视图:已分配的 GPU 时间、有效 GPU 时间、空闲时间、失败作业消耗、每个被接受单位的成本。
至少跟踪:
- GPU 利用率、GPU 内存、功耗、温度和错误事件。
- Pod、作业、命名空间、节点池、模型和团队标签。
- 队列等待时间和准入原因。
- 训练吞吐量、检查点持续时间和恢复时间。
- 推理延迟、吞吐量、批量大小、缓存命中率和错误率。
- 存储吞吐量和对象存储传输时间。
- 节点故障、驱逐、抢占和重试。
然后标准化成本:
effective_kubernetes_gpu_cluster_cost =
  (compute + network + storage + support + idle + failed_runs + operations)
  / accepted_workload_units
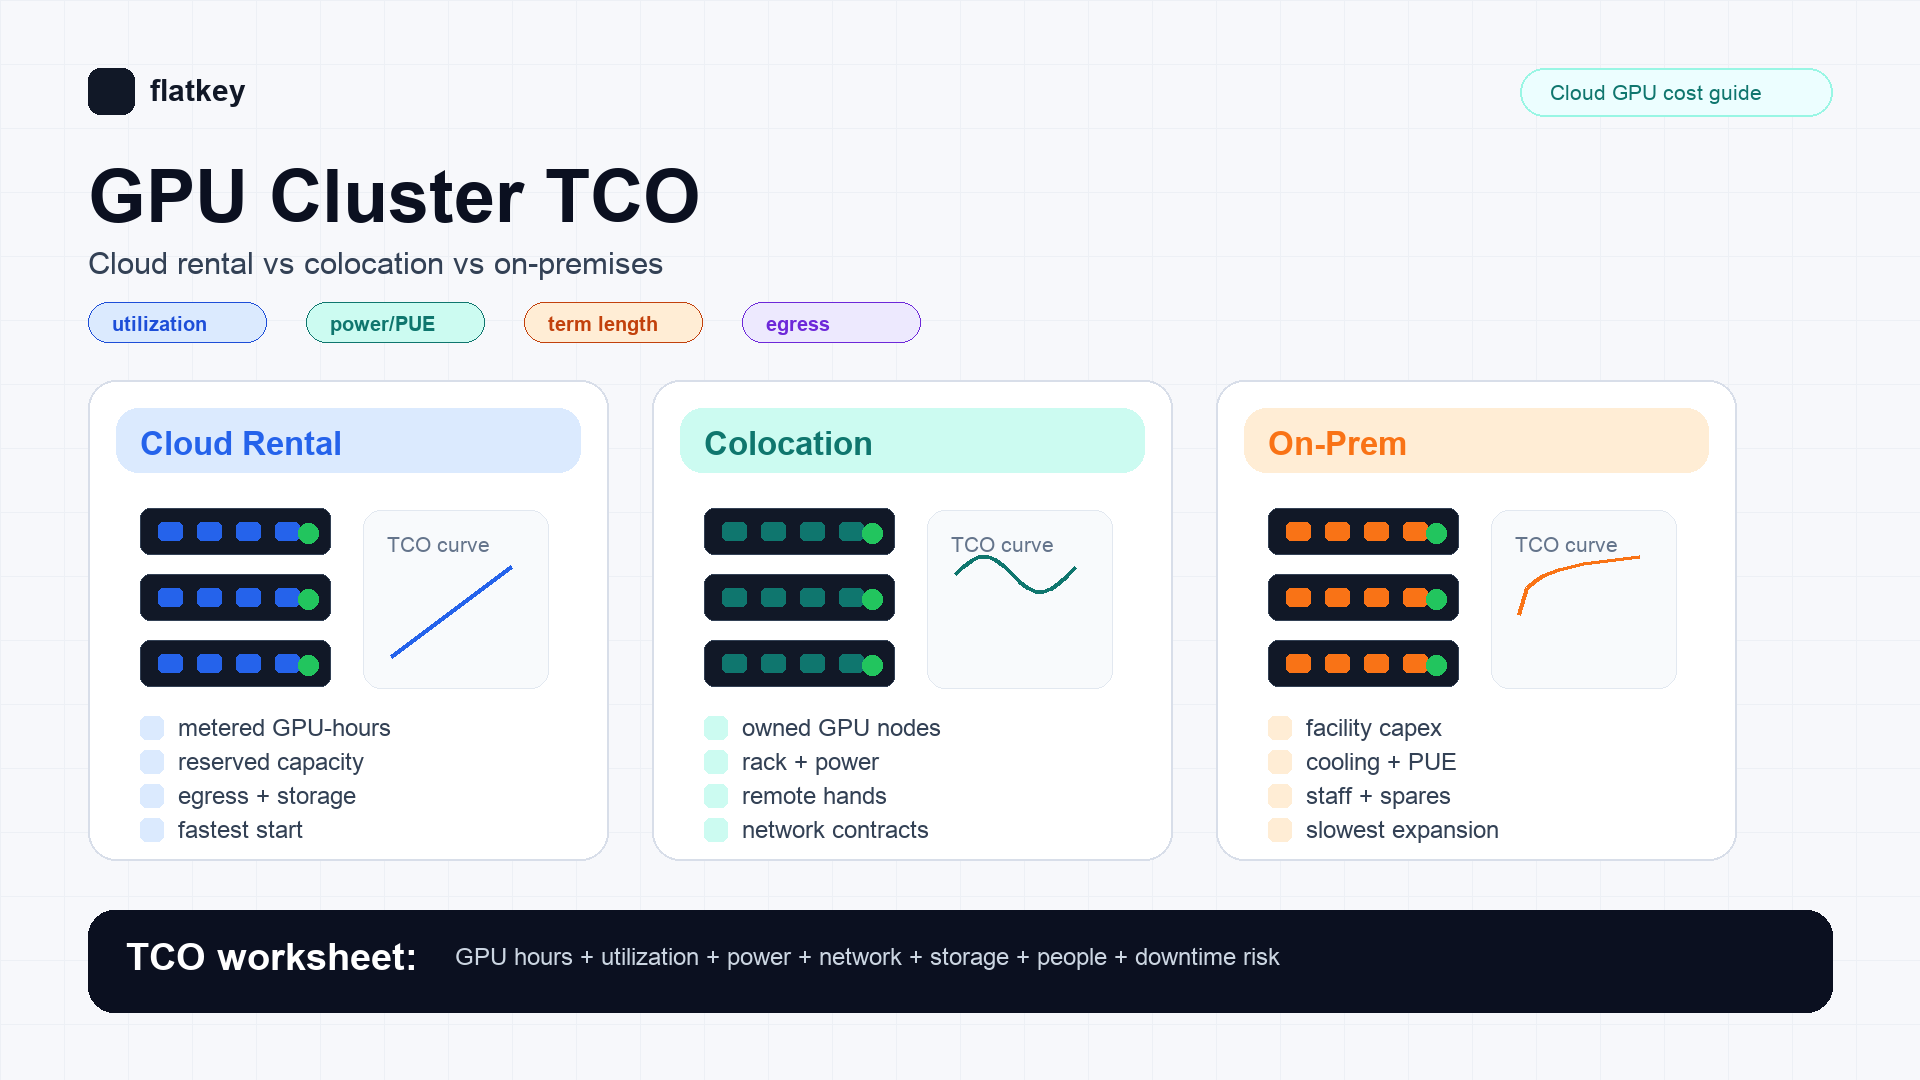
分母应与业务相匹配:已完成的训练运行、被接受的模型输出、生成媒体作业、索引批次或客户请求。如需更深入的成本框架,请使用 GPU cluster TCO 工作表,并在扩展集群前与 GPU cloud vs model API 进行比较。
实施检查清单
将此作为第一个生产环境切片的构建顺序:
| 阶段 | 交付物 | 通过条件 |
|---|---|---|
| 工作负载简介 | 一页式工作负载规格说明 | 团队就模型、框架、数据、规模、SLA 和成本分母达成一致。 |
| 节点池 | GPU 节点规格和标签 | 节点规格、拓扑、驱动程序、运行时和升级策略均已记录。 |
| GPU 暴露 | 已安装设备插件或 GPU Operator | Pod 可以请求 GPU,且 DCGM 指标可见。 |
| 排队 | Kueue、Volcano 或已记录的调度策略 | 用户可以提交作业并查看队列/准入状态。 |
| 存储 | 数据集、模型缓存、检查点和日志路径 | 在强制发生 Pod 或节点故障后,恢复测试通过。 |
| 网络 | 网络互连测试和生产流量测试 | 分布式基准测试或推理路径满足工作负载阈值。 |
| 安全性 | RBAC、命名空间、配额、密钥、镜像策略 | 新团队无需 cluster-admin 访问权限即可完成接入。 |
| 可观测性 | 仪表板和使用情况导出 | 运维人员可以回答哪些人使用了哪些 GPU,以及作业为何失败。 |
| 验收 | 端到端工作负载运行 | 有效输出优于或能够证明采用模型/API 或租用基准的合理性。 |
在这份检查清单变得枯燥之前,不要将规模从 8 张 GPU 扩展到 80 张 GPU。枯燥才是目标:可重复的作业提交、可预测的放置、已知的故障恢复、可见的成本以及清晰的所有权。
常见错误
- 在证明数据传输和检查点恢复能力之前就购买 GPU 容量。
- 将设备插件当作整个平台。
- 在没有优先级和隔离规则的情况下,在同一节点池上混合训练和生产推理。
- 允许每个团队编写独特的 Pod 规格,而没有通用标签。
- 只跟踪已分配的 GPU 时间,而不跟踪有效工作。
- 直到集群已经过载才制定队列策略。
- 假设托管 Kubernetes 就意味着托管 AI 基础设施。
- 在干净镜像上运行基准测试,却在不同镜像上运行生产环境。
- 忘记为数据集、权重、检查点和日志规划退出路径。
这些错误代价高昂,因为它们消耗稀缺的 GPU 时间,却无法产出被接受的工作成果。
常见问题
什么是 Kubernetes GPU 集群?
Kubernetes GPU 集群是一个 Kubernetes 集群,其具备 GPU 能力的工作节点、设备暴露、调度策略、存储、网络和可观测性均已配置,因此 Pod 和作业可以使用加速器执行训练、推理、批处理或研究工作负载。
我需要 NVIDIA GPU Operator 吗?
不一定,但许多基于 NVIDIA 的 Kubernetes GPU 平台会评估它,因为它将驱动程序、运行时、设备插件、MIG 和遥测组件打包为由 Operator 管理的工作流。一些托管服务提供商会为您处理该技术栈的部分内容,因此请在自行安装前确认责任边界。
Kubernetes GPU 集群是否需要 Kueue?
并非每个集群都需要 Kueue,但当稀缺的 GPU 容量需要在团队或批量 AI 作业之间共享时,值得对其进行评估。没有队列层时,用户往往难以了解作业为何等待,或者配额为何被拒绝。
Kubernetes 能运行多节点训练吗?
可以,但多节点训练需要的不只是 GPU 调度。您还需要考虑放置策略、高速网络验证、兼容的容器、检查点机制,以及通常需要的队列或组调度行为。在投入大量容量之前,请测试确切的节点池和生产镜像。
推理和训练应共用同一个 GPU 集群吗?
可以,但前提是具备清晰的节点池、优先级规则、配额和隔离机制。生产推理通常具有延迟和可用性要求,这些要求会与大型训练作业产生冲突。除非您能够证明共享策略在负载下可行,否则应从分离部署开始。
何时应使用模型 API 而不是 Kubernetes GPU 集群?
如果您只需要模型输出、模型组合经常变化、利用率较低,或团队尚未准备好运维 GPU 驱动程序、队列、存储、监控和事件响应,请优先使用模型 API。当控制能力、隐私、自定义权重或工作负载的经济性足以证明运维负担合理时,再构建集群。
官方参考资料
- Kubernetes:调度 GPU
- Kubernetes:设备插件
- Kubernetes:动态资源分配
- Kubernetes:将 Pod 分配到节点
- NVIDIA GPU Operator
- NVIDIA:安装 GPU Operator
- NVIDIA:安装 DCGM Exporter
- Kueue 概念
- Volcano 组调度
- Kubeflow Trainer 概述
最终结论
当 Kubernetes 能够让您的 AI 基础设施在放置、可重复性、安全性、可观测性和成本方面,比临时搭建的 GPU 机器或托管 API 提供更好的控制能力时,构建 Kubernetes GPU 集群 是值得的。应从范围有限的工作负载开始,验证节点池,清晰地暴露 GPU,在资源争用开始前加入队列,并衡量有效产出而非原始 GPU 分配量。
如果集群在已接受的工作量方面无法胜过更简单的 GPU 租用方案或模型/API 路径,就不要扩展它。如果能够胜出,Kubernetes 就会成为控制平面,将稀缺的加速器转化为共享的 AI 平台。